


一个 Windows 图形化工具,用来回答一个防御性问题:
这个站点(或这几个环境)有没有对抗"资源消耗型攻击"的能力——限速、WAF、人机挑战、 连接治理、过载保护。
自用工具,不对外分发。 只用于本人搭建的测试环境与已授权目标。
版本演进
| 版本 | 变化 |
|---|---|
| v1.0 | 单目标、有界低强度探测(速率 ≤50 req/s、并发 ≤32) |
| v1.1 | 去掉阻塞性强度上限(速率/时长填 0 即不限制);引擎改为 asyncio + 长连接复用,消除高并发下的本地端口耗尽 |
| v1.2 | 多环境探测:目标区每行一个 URL,一次跑完并产出横向对比报告;新增主机名校验 |
| v1.3 | 修复「按钮跑到屏幕外」;新增强度档位预设;新增流量统计 |
| v1.4 | 修复「设 0 却仍被限制在 20000 请求」(0 现在是真·不限);新增流量上限停条件;无停止条件时进度条转为滚动模式;事件加运行标识,避免上一轮残留事件收尾新运行 |
1. 快速开始(Windows)
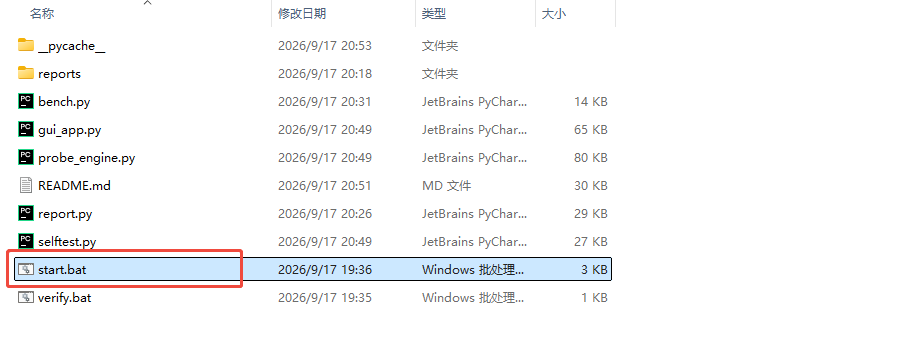
start.bat          → 启动图形界面
verify.bat         → 跑全部自检(引擎 101 项 + 界面 53 项)
python gui_app.py :: 启动界面
python gui_app.py --smoke :: 只验证界面能否正常构建
python gui_app.py --e2e :: 端到端自检(布局/档位/流量/多目标)
python selftest.py --demo :: 引擎自测,并产出样例报告
python bench.py :: 吞吐量基准(引擎对比)
python bench.py --cpu :: 分别测客户端与靶站的 CPU 核占用
python bench.py --scale 4 :: 多进程叠加测试依赖:仅 Python 标准库,无需 pip install。要求 Python ≥ 3.10。
⚠ 已知环境坑:
python命令可能指向没有 tkinter 的解释器本机实测:
C:\Users\XiaoZou\.workbuddy\binaries\python\versions\3.13.12\python.exe
不带 tkinter,直接跑gui_app.py会报ModuleNotFoundError。start.bat已内置规避:按候选清单逐个执行python -c "import tkinter"探活,
只接受真正带 tkinter 的解释器。手启请用系统版%LOCALAPPDATA%\Programs\Python\Python312\python.exe。
界面布局(v1.3 修过一次严重的可见性 bug)
┌─ 标题 ──────────────────────── [开始探测] [中止] [生成HTML报告] [导出CSV] ─┐  ← 固定在顶部
├─ 左栏(可滚动)──────────────┬─ 实时统计(两行,含流量)───────────────┤
│  目标(多行 URL + 并行开关) │  达成req/s 已发送 正常 被限流 错误 延迟      │
│  强度档位(低/中/高/极高)   │  流量速率 累计流量 上行 下行 峰值 进度      │
│  探测参数(含模式)          │ ─────────────────────────────────────── │
│  额外路径                   │  [ 日志 ][ 逐请求明细 ][ 结论/对比 ]       │
│  使用说明                   │                                        │
└─────────────────────────────┴────────────────────────────────────────┘
v1.2 及以前,窗口固定 1240×880,运行控制按钮放在左栏最底部。
在小屏或高缩放比下,按钮会被挤出可见区域——测试跑起来后找不到结束按钮。
v1.3 三处修正:① 窗口尺寸按winfo_screenwidth/height自适应;
② 运行控制按钮移到顶部固定区;③ 左栏改为可滚动容器(只在指针位于左栏时接管滚轮)。
2. 多环境探测(多 URL)
2.1 怎么用
「目标」区每行填一个 URL:
https://www.example.com/
https://staging.example.com/
http://192.168.1.12:9870/解析失败的行会被显式列出并排除(不会静默丢掉)。一次运行产出一份多环境对比报告。
2.2 串行 vs 并行(最关键的取舍)
「同时执行(并行)」是个勾选框,默认不勾 = 串行:
| 串行(默认,推荐) | 并行(勾选「同时执行」) | |
|---|---|---|
| 执行方式 | 逐个目标跑完整强度 | 所有目标同时受测 |
| 单目标强度 | 吃满你配置的强度 | 被分摊到各目标 |
| 横向对比 | 有效(条件一致) | 失真(达成速率不可比) |
| 总耗时 | 目标数 × 单目标时长 | ≈ 单目标时长 |
| 适用 | 「哪个环境的防护最弱」 | 「所有环境同时扛不扛得住」 |
要对比就用串行;要同时压就用并行。 两种模式的报告与结论里都会显式标注执行方式。
2.3 对比报告结构
一、总体结论      → 最高风险 + 自动判定「防护能力不一致」(部分环境有、部分没有)
二、横向对比总表   → 目标 × 风险/请求数/限流次数/首次限流位置/5xx/连错/达成速率/上下行字节/流量/结论
三、防护维度对照   → 目标 × 5 个防护维度(✓ 观察到 / — 本次未观察到)
四、风险指数排序   → 横向条形图,一眼看出该先查哪个环境
五、各目标详细结论 → 每个目标的分级发现 + 流量 + 逐请求时间线
六、配置快照 → 所有目标共用同一套参数,保证可比性总体风险取各目标最大值(木桶原理)。各目标风险差异 ≥30 分时,提示"配置在不同环境之间不一致"。
2.4 主机名校验
parse_target 会给缺协议的输入补 http://,这曾导致「这不是一个URL」被当作主机名。
现在解析阶段就拒绝:这不是一个URL(无点号)、http://srm(单标签主机)、hello world(含空格)、https://(无主机)。localhost、IP(v4/v6)、含点域名(含 IDN 中文域名)正常接受。
3. 强度档位(v1.3 新增)
档位下拉框 + 「套用」按钮,一键把参数填成预设值:
| 档位 | 速率 | 并发 | 总请求数 | 时长 | 说明 |
|---|---|---|---|---|---|
| 低 | 5 req/s | 8 | 2000 | — | 轻度探测,常规巡检 |
| 中 | 100 req/s | 64 | 20000 | — | 能触发多数站点的限速阈值 |
| 高 | 不限速 | 128 | 不限 | 60 秒 | 会给目标带来明显负载 |
| 极高 | 不限速 | 512 | 不限 | 120 秒 | 可能影响目标可用性 |
| 自定义 | 手工填 | 手工填 | 手工填 | 手工填 | 改动任一参数会自动切回这里 |
界面上会实时显示实际判定档位(由速率/并发推导),以及当前的串行/并行方式与目标数。
调参节奏
并发按 8 → 32 → 64 → 128 → 256 逐级升,每级跑 30~60 秒,看报告里
"首次限流出现在第几个请求"和达成速率的变化拐点。拐点就是防护开始生效的地方。
别一上来就堆并发。本机实测:并发超过约 512 后吞吐反而下降(单机回环栈饱和),
真实环境还叠加出口带宽与 NAT 端口限制。并发不是越大越好,够触发阈值就行。
4. 流量统计(v1.3 新增)
界面第二行统计栏实时显示,报告与 CSV 里也都有:
| 指标 | 含义 | 口径 |
|---|---|---|
| 上行(请求) | 请求行 + 请求头 + body 的字节数 | 全量累加(每次请求的实际序列化长度) |
| 下行(响应) | 响应体字节数 | 取目标声明的 Content-Length;受 max_body_drain(默认 512KB)限制,不做全量传输 |
| 累计流量 | 上行 + 下行 | 全量 |
| 当前流量速率 | 3 秒滑动窗口的字节速率 | 显示 KB/s,状态栏同时给出 Mbps |
| 峰值速率 | 本次运行中的最高瞬时速率 | 用于判断是否触到出口带宽 |
| 平均每请求流量 | 总字节 ÷ 请求数 | 用来估算"打满 N 分钟会产生多少流量" |
为什么下行是"声明值"而不是"实际传输值":为了不把目标整站拉下来、也不把自己的
出口带宽吃光,引擎默认只排空 512KB 以内的响应体,超出部分读一小段做特征匹配后就丢弃连接。
所以下行统计的是目标声明的响应体大小(也就是"如果全量下载会有多少流量"),
这个口径更适合评估"攻击者会产生多大流量"。
5. Python 的并发上限到底在哪(实测答疑)
有个常见疑问:"Python 是高级语言,执行效率低,所以并发数量有限?"
我用 bench.py 做了三组实测,结论是:在这个场景下,"Python 效率低"基本不成立。
真正卡住的是「单进程 = 一颗核」+ 单机单 IP 的物理资源。
实验一:客户端单独打一个独立进程的靶站
| 并发 | 客户端 req/s | 客户端核占用 | 靶站核占用 | 客户端每请求 CPU |
|---|---|---|---|---|
| 32 | 24,429 | 0.38 | 0.13 | 41 µs |
| 128 | 23,983 | 0.37 | 0.17 | 42 µs |
| 512 | 21,029 | 0.37 | 0.02 | 48 µs |
| 1024 | 19,653 | 0.34 | 0.01 | 51 µs |
(本机 24 逻辑核,回环环境)
关键读数:客户端只用了 0.38 核就跑出 24,429 req/s。按此折算,
单核理论处理能力约 64,000 req/s(每请求约 15.6 µs CPU 时间)。
离"跑满一颗核"还差得远——瓶颈完全不在 Python 客户端。
而且注意:并发从 32 加到 1024,吞吐下降了(24.4k → 19.7k),
但 CPU 占用几乎没变(0.38 → 0.34 核)。加并发没多花 CPU,反而更慢,
说明限制在别处(回环网络栈 + 单线程服务端的串行处理),不是解释器效率。
实验二:客户端 + 靶站挤在同一个进程里
| 场景 | 达成 req/s |
|---|---|
客户端与靶站同进程(即 bench.py 默认表) | ~14,700 |
| 客户端独打独立进程的靶站 | 24,429 |
同一个客户端,仅仅因为靶站挪到了另一个进程,吞吐就涨了 66%。
这说明我上一轮的判断是错的——我曾把 ~14.5k req/s 当成"Python 单核极限",
实际那是客户端和服务端在同一进程里抢同一颗核(GIL)的结果。
实验三:多进程叠加
 1  个进程:    14,709 req/s
 4  个进程:    52,392 req/s(各进程 13,046 / 13,132 / 13,112 / 13,103)
叠加倍率:3.56×(理论上限 4×)近线性叠加。说明限制确实是单进程层面的,多开进程就能叠加利用多核。
结论
| 说法 | 是否正确 | 实测依据 |
|---|---|---|
| "Python 高级语言效率低,所以并发有限" | 基本不成立 | 0.38 核跑 24.4k req/s,单核理论 ~64k req/s |
| "GIL 限制了并发" | 部分成立,但含义不同 | GIL 不阻止 I/O 并发(等网络时释放);它的真实影响是一个进程最多用一颗核——所以要吃多核必须多进程(实测 3.56× 近线性) |
| "线程模型开销大" | 曾经成立 | v1.0 用 threading + 每请求新建连接:每线程 ~8MB 虚拟栈 + 内核调度 + 本地端口耗尽(本机仅 13977 个)、TIME_WAIT 堆积 → 只能跑 ~960 req/s,并发越高错误率越高 |
| "单机单 IP 是硬上限" | 成立 | 临时端口、出口带宽、RTT(吞吐 ≈ 并发 ÷ RTT)、per-source 限速 |
所以对你打真实站点来说:瓶颈几乎总是 RTT × 单 IP 限速 × 出口带宽,
而不是 Python 快不快。想再往上走只有两条路——多进程(同一台机器多核叠加,实测近线性)
或分布式(多机多 IP,本工具不提供)。
想自己复现这三组实验:
python bench.py(默认表)、python bench.py --cpu、python bench.py --scale 4
6. 两种引擎
| 引擎 | 连接模型 | 本机回环实测 | 适用 |
|---|---|---|---|
| async(默认) | asyncio + 长连接复用,并发数 = 常驻连接数 | 客户端 0.38 核跑 24,429 req/s,0 错误 | 除慢连接外的所有场景 |
| thread | 每请求新建一条 TCP 连接(v1.0 的实现) | ~960 req/s | 仅作低强度对照 |
为什么要重写:v1.0 每请求新建连接,打到约 4000 req/s 时开始大面积失败,
错误是 OSError [WinError 10048] 每个套接字地址只允许使用一次——
本机动态端口范围只有 13977 个,连接关闭后端口进 TIME_WAIT,池子被吃干。
改成常驻连接复用后:不再消耗端口,也不再每请求重做 TCP/TLS 握手。
7. 三种探测模式
| 模式 | 做什么 | 判断什么 | 档位预设下的参数 |
|---|---|---|---|
常规并发探测standard | 受控速率(不限速时尽力而为)并发请求,记录状态码、延迟、响应头与特征 | 限速(429/420/509)、WAF 指纹、人机挑战、压力下是否优雅降级 | 中档:100 req/s / 并发 64 / 20000 请求 |
缓存绕过探测cachebust | 每请求附加随机查询参数(?_probe=xxxx),绕过 CDN 边缘缓存 | 源站自身是否有限速,排除"打在缓存上"造成的假象 | 同上 |
慢连接占用探测slowconn | 建立若干连接,只发不完整请求头并持续保活,期间每 2 秒发一次"金丝雀"正常请求 | 服务端是否回收不完整请求的连接(Slowloris 防护);少量慢连接是否拖垮整体可用性 | 50 条 / 保持 30 秒 |
慢连接有两个子变体:
headers(只发部分请求头)与body(声明 1MBContent-Length但极慢地发 body)。
8. 参数说明
| 参数 | 含义 | 填 0 的含义 |
|---|---|---|
| 总请求数/目标 | 停止条件之一 | 不按请求数停 |
| 持续秒数/目标 | 停止条件之一(两者任一满足即停) | 不按时间停 |
| 流量上限 MB | 第三个停止条件:累计流量(上行+下行)超过即停 | 不限流量 |
| 速率 req/s | 全局节拍(异步精确节拍器 / 令牌桶) | 不限速 |
| 并发连接 | 常驻连接数(异步引擎下即连接池大小) | — |
| 超时 s | 单请求超时(含建连与读响应) | — |
| 慢连接数 / 保持秒数 | 仅慢连接模式 | — |
| User-Agent | honest(默认,如实声明工具身份)/ chrome / curl / 空 | — |
| 引擎 | auto(默认走 async)/ async / thread | — |
| 连接复用 | 默认开启。关掉会退回 v1.0 的行为,高并发下会端口耗尽 | — |
| 忽略证书错误 | 允许自签名证书(内网系统常用) | — |
| 额外探测路径 | 每行一条,与目标路径轮换;所有目标共用 | — |
多目标模式下,强度参数是单目标的强度:串行时每个目标都吃满,并行时被分摊。
9. 怎么读报告
9.1 单目标报告
一、结论          → 风险指数 0-100 + 一句话结论 + 固定结论边界声明
二、防护能力对照表 → 7 个防护维度 × 观测结果 × 证据
三、逐请求时间线   → 每根色条 = 一个请求;红=限流 橙=4xx 深红=5xx 紫=连接层错误
四、量化指标       → 状态码分布、实测达成速率、连接复用、**上下行流量与速率**、延迟分位数
五、发现明细       → 按严重度分级,每条带可核对的原始数值
六、逐请求明细     → 前 300 条(高强度下为抽样)
七、探测配置快照   → 参数全留痕,报告可复现、可交接
9.2 判定逻辑(信号 → 结论)
| 观测到的信号 | 判定 | 报告措辞 |
|---|---|---|
429 / 420 / 509,或 503 + Retry-After | 存在主动限速 | 「观察到主动限速 / 阻断能力」+ 首次触发位置 |
| 403 且响应含 WAF/挑战特征 | 存在主动阻断 | 「HTTP 403 + 防护特征」 |
响应头含 cf-ray / x-sucuri-id / akamai-grn / x-iinfo 等 | 存在防护/CDN 组件 | 「识别到防护 / CDN 组件指纹」(旁证,不等于配置正确) |
| 响应体匹配挑战页/人机验证特征 | 存在挑战机制 | 「观察到人机验证 / 挑战页」 |
| 慢连接被服务端提前回收 | 有连接层治理 | 「观察到连接层治理能力」 |
| 慢连接在保持期内始终未回收 | 高优先级脆弱点 | 「慢连接长时间未被回收」 |
| 5xx 占比 ≥ 10% | 缺乏优雅降级 | 「出现服务端错误响应」 |
| 连接层错误占比 ≥ 5% | 结合延迟曲线判断;含 WinError 10048 则判定为测试机自身限制并提示 | 「出现连接层错误」 |
| P95 ≥ 300ms 且 P95/P50 ≥ 5 倍 | 长尾明显 | 「延迟分布显著劣化」 |
| 以上都没有(且请求数 ≥ 20) | 无法下"无防护"结论 | 「本次强度内未观察到速率限制」 |
风险指数:基线 50 → 正向证据减分、脆弱证据加分 → 钳制 0~100。<25 风险较低|25-44 低风险|45-64 中风险|≥65 高风险。多目标时取各目标最大值。
9.3 三条容易误读的规则(都是踩过坑加固的)
- "未观察到" ≠ "不存在"。 目标全程正常响应时措辞固定为"本次强度内未观察到防护被触发……不能据此认定其无防护"。
- 延迟只看比值不够。 早期版本只看 P95/P50 比值,在毫秒级的快速源站上产生假阳性。现在同时要求 P95 ≥ 300ms。
- "暂时没被打垮" ≠ "有防护"。 慢连接泄漏但金丝雀请求仍成功时,不会给正向加分,而是单独出一条中优先级条目。
10. 高强度下的内存与采样
| 数据 | 口径 |
|---|---|
| 请求计数、状态码分布、限流次数、延迟分位数、流量字节 | 全量(原子计数器) |
| 「逐请求明细」表与报告第六节 | 抽样:前 result_cap 条(默认 20000)+ 全部"有信息量"的样本(限流/错误/4xx+,上限 5000) |
触发采样时报告与界面都会标注。界面实时统计始终读聚合值,看到的数字永远是全量口径。
另外,界面明细表不依赖"每个请求推一个事件"——7,500 req/s 下那会让事件队列无限积压
(实测单次只能消费 2 万个,done 事件永远读不到)。现在引擎只写收集器,
界面按序号增量拉取,内存与延迟恒定。
11. 自测与证据
verify.bat 一键跑完。自测是在本地起行为已知的模拟靶站,看引擎判断是否与事实一致:
| 用例 | 输入 | 期望 | 实测 |
|---|---|---|---|
| 0 | 未授权 | 拒绝执行 | 抛 PermissionError ✅ |
| 1 | 参数填 10^15 | sanity 钳制;0 保持"不限制" | 并发→100000,速率 0 保持不限速 ✅ |
| 1b | 这不是一个URL / http://srm / hello world / https:// | 全部拒绝 | 4 类非法输入全部拒绝;localhost/IP/域名放行 ✅ |
| 1c | 两个靶站(无防护 + 限速),串行 + 并行各跑 | 对比表 + 不一致判定 | 60 分 vs 5 分;weakest 指向无防护那个 ✅ |
| 2 | 无防护 keep-alive,400 请求 | 「未观察到」而非「无防护」 | 复用 384 次,6,666 req/s,风险 60 ✅ |
| 2b | 流量统计 | 上/下行 > 0、合计 = 上行+下行、速率已算 | 上行 ≈ 268 B/请求,量级合理 ✅ |
| 3 | 前 10 个正常,之后 429 + CF 挑战页 | 识别限速 + 指纹 + 挑战页 | 限流 20 次,首次在第 11 个请求 ✅ |
| 4 | 6000 请求 + 明细上限 400 | 统计全量、明细抽样、内存受控 | 统计 6000/6000,仅存 400 条 ✅ |
| 5 | 仅给时长不给请求数 | 按时长停止 | 2.00 秒准时结束,发出 16931 个请求 ✅ |
| 5b-a | 三项停止条件全为 0 | 不自行结束,靠手动中止 | 1.21 秒被中止,期间发出 8,760 请求,日志提示「无停止条件」 ✅ |
| 5b-b | 流量上限 50 KB | 自动停止且不被标记为手动中止 | 在 55,550 B / 275 请求处自动停止,耗时 0.05s,aborted=False ✅ |
| 6 / 7 | 慢连接永不回收 / 1.5 秒回收 | 报「高」/ 报「观察到治理」 | 70 分 / 25 分,且识别"正常请求不受影响" ✅ |
| 8 / 9 | 报告渲染 | 单目标与多目标报告结构完整 | 含流量列、总表、维度矩阵、排序图、边界声明 ✅ |
当前状态:引擎 101 项断言、界面 53 项断言,全部通过(0 失败)。
界面端到端真实驱动(含 v1.3 新增项):
- 布局可见性回归:窗口不超出屏幕;「开始探测 / 中止 / 生成报告 / 导出CSV」四个按钮
winfo_ismapped()为真且下边缘都在窗口内(这正是 v1.2 那个"找不到结束按钮"的 bug) - 档位预设:套用「中」→ 速率 100 / 并发 64;套用「极高」→ 不限速 / 并发 512;
手工改参数后自动切回「自定义」 - 流量统计:上下行 > 0、界面标签非零、报告含流量列与合计流量
- 多目标解析与非法行排除 → 串行实跑两目标 → 跨目标合计 → 明细表 → 并行执行 → 中止机制
样例报告(自测产出,可直接打开看版式):
reports/sample-multi-compare.html—— 多环境对比(总表/维度矩阵/风险排序/流量列)reports/sample-protected-site.html—— 有限速的目标,风险指数 5reports/sample-slowloris-vulnerable.html—— 慢连接脆弱,风险指数 70reports/sample-highload-sampled.html—— 6000 请求 + 显式采样标注
12. 文件清单
| 文件 | 职责 |
|---|---|
probe_engine.py | 探测引擎:两种引擎、三种模式、指纹库、限速器、结果收集器(含流量计数)、结论生成、多目标编排。不含界面代码,可被其他程序调用 |
report.py | 报告渲染:单目标 build_html + 多目标对比 build_multi_html(内联 SVG 时间线与风险排序图) |
gui_app.py | Tkinter 界面:多 URL 目标区、强度档位、流量统计、串行/并行、可滚动左栏与固定按钮区。含 --smoke / --e2e |
selftest.py | 离线自测(模拟靶站 + 101 项断言)。--demo 额外产出样例报告 |
bench.py | 基准测试:引擎对比、--cpu 核占用分析、--scale 多进程叠加 |
start.bat / verify.bat | 启动器(含解释器探活)/ 一键自检 |
reports/ | 报告输出目录 |
作为库调用
from probe_engine import ProbeConfig, run_probe

cfg = ProbeConfig(
    target="https://your-site.com/",
    mode="standard", engine="async",
    total_requests=0, duration=60,   # 跑 60 秒
    rate=0, concurrency=128,         # 不限速
    keepalive=True,
    authorized=True,                 # 库调用必须显式声明;默认 False 直接拒绝执行
)
report = run_probe(cfg)
fl = report.summary["flood"]
print(report.risk_score, report.verdict)
print(f"达成 {fl['achieved_rps_ok']:,} req/s|"
      f"上行 {fl['bytes_up']:,} B|下行 {fl['bytes_down']:,} B|"
      f"{fl['traffic_kbps']:,.1f} KB/s ≈ {fl['traffic_mbps']:.3f} Mbps")
多目标:
from probe_engine import ProbeConfig, run_multi_probe, export_multi_csv
from report import build_multi_html

base = dict(mode="standard", engine="async", total_requests=0, duration=60,
            rate=0, concurrency=64, authorized=True)
cfgs = [ProbeConfig(target=u, **base) for u in
        ("https://prod.example.com/", "https://staging.example.com/")]
multi = run_multi_probe(cfgs)            # 默认串行;parallel=True 走并行
print(multi.verdict, "最弱环境:", multi.weakest)
for row in multi.comparison:
    print(row["target"], row["risk_score"], row["throttled"],
          row["bytes_total"], row["traffic_kbps"], row["flags"])
build_multi_html(multi, "compare.html")
export_multi_csv(multi, "compare.csv")
13. 常见问题
Q:我打开还是旧界面 / 找不到按钮?
先确认标题栏版本号是 v1.3。如果还是 v1.1/v1.2,说明进程是旧代码启动的,
关掉窗口重新双击 start.bat。v1.3 已把运行控制按钮固定在顶部、窗口按屏幕自适应,
不会再出现按钮被切到屏幕外的情况。
Q:多环境该用串行还是并行?
要对比哪个环境防护最弱 → 串行(默认)。要同时验证所有环境扛不扛得住 → 勾选
「同时执行(并行)」,但要知道负载被分摊、单目标速率下降。
Q:为什么下行流量显示的是"声明值"?
为了不把目标整站拉下来、也不吃光自己的出口带宽,超过 max_body_drain(默认 512KB)的
响应体只读一小段做特征匹配就丢弃。统计的是目标声明的 Content-Length,
即"全量下载会有多少流量"——这个口径更适合评估"攻击者会产生多大流量"。
Q:http://srm 这种内网单标签主机名填不进去?
校验要求是域名、IP 或 localhost。内网主机请写 http://192.168.1.12/ 或 http://srm.local/。
Q:我把总请求数填 0 了,为什么还是停在 20000?
这是 v1.3 的 bug,v1.4 已修。 当时为了「防止无限跑到停不下来」在引擎里兜底成了 20000,
但界面上明明写着「0=不限」——界面在骗人。现在三项停止条件全填 0 就是真·不限,
一直跑到你点「中止」。若不想手动盯着,把「流量上限 MB」设一个非 0 值即可自动停。
Q:流量上限的精度如何?
检查是在每个请求发出前进行的,所以实际停止时可能略微超出设定值——
超出的上限约为 每请求字节 × 并发数(例如 150 B × 64 并发 ≈ 10 KB)。
实测:设 50 KB 时在 55,550 B / 275 请求处停止。
Q:跑完显示"未观察到防护被触发",是不是这个站没防护?
不是。 只说明在你设定的强度/时长内没触发阈值。要更确信:升档位、拉长时长、
或改用「缓存绕过」模式打源站。若目标前置 CDN,standard 模式可能一直命中缓存。
Q:内网自建系统(自签名证书)怎么测?
勾选「忽略证书错误」,地址写 https://192.168.1.12/ 即可,慢连接模式同样支持。
Q:控制台中文乱码?start.bat 已内置 chcp 65001 + PYTHONUTF8=1。
Q:跑很久会不会吃爆内存?
不会。统计走计数器(含流量字节),明细有上限,触发采样时报告与界面都会标注。
14. 链接
分享内容:dos-resilience-tester.rar 分享链接:https://ug.link/xiaozou/filemgr/share-download/?id=230fe5880b0344989d686b43e20856e8 访问密码:lEo4
Comments NOTHING