



你照着网上那篇教程,把 DDR5 的频率拉到 6000,时序压到 30-36-36,然后打开 AIDA64 跑一遍。读 90267 MB/s,写 92818 MB/s,复制 89011 MB/s,延迟 66.6 纳秒。这个成绩看着挺舒服,你大概会觉得内存这块已经调完了。
然后你想再往前推一点。频率改到 6400,开机蓝屏;退回来把 CL 压到 28,还是蓝屏;想着是不是电压不够,往上加一档,照样蓝屏。这时候教程已经翻到底了,下面没有了,你只能去论坛问,得到的回答基本是同一句:体质问题,换套条子吧。
造成这种情况的并不是体质。而是这台电脑的 BIOS 里面,跟内存时序有关的设置还有三十多项,你从头到尾一个都没点开过——不知道它是什么意思,自然也不会想到去设它。
还是同一对条子、还是 6000 这个频率、CL 也还是 30,只是把那些没人管的参数挨个填一遍,AIDA64 的延迟就能再往下走几个纳秒,复制带宽也能再涨几个百分点。这些参数在 BIOS 里被分成两档,一档叫次级时序,一档叫三级时序,玩家平时懒得区分,统一管它们叫小参。
网上讲内存超频的文章,九成都停在 CL、tRCD、tRP 这三个数上就不往下走了。原因倒不是小参不重要,而是要把小参讲清楚,得先花很大篇幅讲内存内部是怎么工作的,写起来太费劲,读的人也容易看不下去。所以这篇文章换个顺序,先从内存到底怎么读出一个数讲起,把底子铺好了,再回来看那些参数。不过在开始之前,结论可以先说在前面:你要是没耐心看推导,记住下面三条也够用:
- 小参其实分两档。次级时序管的是两次操作之间要空多久,三级时序管的是某个特定方向上连续访问的间隔。第二档在日常使用里基本不用碰,碰了也感觉不到。
- 真正值钱的只有三项:tREFI、tRFC、tFAW。剩下的参数按顺序往后排,收益一项比一项薄,可是把系统搞崩的概率并不会跟着变小。
- 调节顺序比下手的力度重要。先把频率定死,再去动主时序;主时序定下来之后,才有资格去动 tREFI 和 tRFC。顺序要是反了,你前面调了半天,后面一动框架就全白费了。
先看一眼这组数字
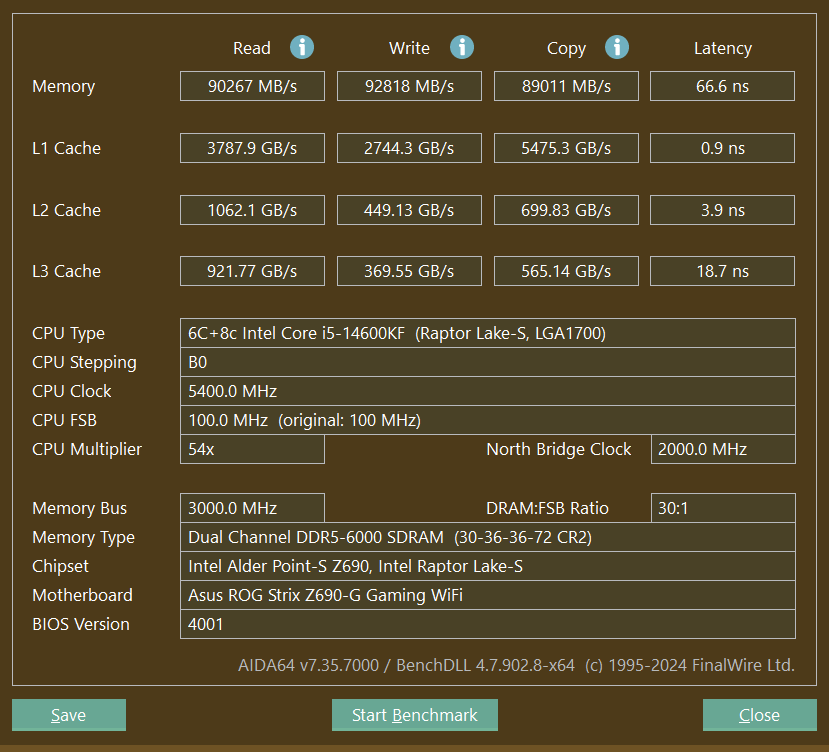
这张图里最值得看的地方其实不是上面那些读写带宽,而是中间那行 Memory Type。它写的是 DDR5-6000 (30-36-36-72),前一个数是等效传输率,括号里那四个才是真正的时序。
括号里一共四个数:CL 30、tRCD 36、tRP 36、tRAS 72。厂商之所以只在这一行放这四个,是因为他们很清楚绝大多数用户也只认识这四个,多写了反而没人看。
先把这几个名字认全,后面会反复用到。CL 是 CAS Latency,一般译作列地址选通延迟;tRCD 是 RAS to CAS Delay,行地址到列地址之间的延迟;tRP 是 RAS Precharge,预充电要花的时间;tRAS 是 RAS Active Time,一行被激活之后到允许关闭之间的最短时间。这几个缩写都是从内存内部的信号名和动作名来的,你记不住全称也没关系,但有一点要搞清楚:它们描述的是命令与命令之间要隔多久,不是四个各自独立的速度指标。
这些参数平时存在内存条上的一颗小芯片里,那是颗 EEPROM,行内叫 SPD(Serial Presence Detect,串行存在检测)。厂商出厂前会把默认参数写进去,顺带再写几套预设方案,其中一套就是所谓的 XMP(Extreme Memory Profile,极致内存配置文件)。你进 BIOS 打开 XMP,主板就会照着这套预设把频率、电压、时序一次性填好,整个过程你什么都不用管。
再看下面那行:Memory Bus 3000 MHz,DRAM:FSB Ratio 30:1。这里的 3000 指的是内存 I/O 时钟跑在 3000 兆赫,而 DDR 的意思是双倍数据率,一个时钟周期里上下沿各传一次数据,所以等效下来是 6000 MT/s,也就是每秒 6000 兆次传输。平时大家嘴上说的「6000 频率」,指的就是这个等效传输率,并不是说时钟真的跑到 6000 兆赫。新手最容易在这里绕不出来:要么把 3000 当成 6000,要么反过来以为 6000 就是 6000 兆赫的时钟。
这里有个对不上的地方值得说一句。图上的 72 和 BIOS 里写的 76 不是一个数。BIOS 的 XMP 下拉框标的是 DDR5-6000 30-36-36-76-1.35V,下面 DRAM RAS# ACT Time 那一栏填的也是 76。也就是说这套 XMP 档案本来标的就是 76,AIDA64 显示的那个 72,是它从 SPD 的时序表里另外读出来的一个字段,两边压根不是同一份数据源。差个几拍是常事,判断的时候以 BIOS 里实际生效的值为准。
延迟 66.6 纳秒。这个成绩在同档次的 DDR5 里算正常,谈不上好也谈不上差。对比一下 DDR4 时代,3600 CL16 能压到 55 纳秒上下。DDR5 天生就慢一截,原因有三个:频率虽然高了,时序却松得多;刷新开销也更大;另外中间还隔着一层 Gear 2 的时钟转换——Intel 平台从 12 代酷睿开始,在 DDR5 上默认让内存控制器和内存按 1:2 的时钟比工作,多一道转换环节,就多一份开销。而这四个数,只不过是你 BIOS 里跟内存时序有关的四十多项设置中的前四项而已。
一、内存到底是怎么读出一个数的
一根条子,四层抽屉
这一节得先弄明白,因为后面所有参数都挂在它上面。这块要是没搞清楚,看参数就只能是死记硬背——别人说压到 8 你就填 8,出了问题也不知道该往哪儿找。
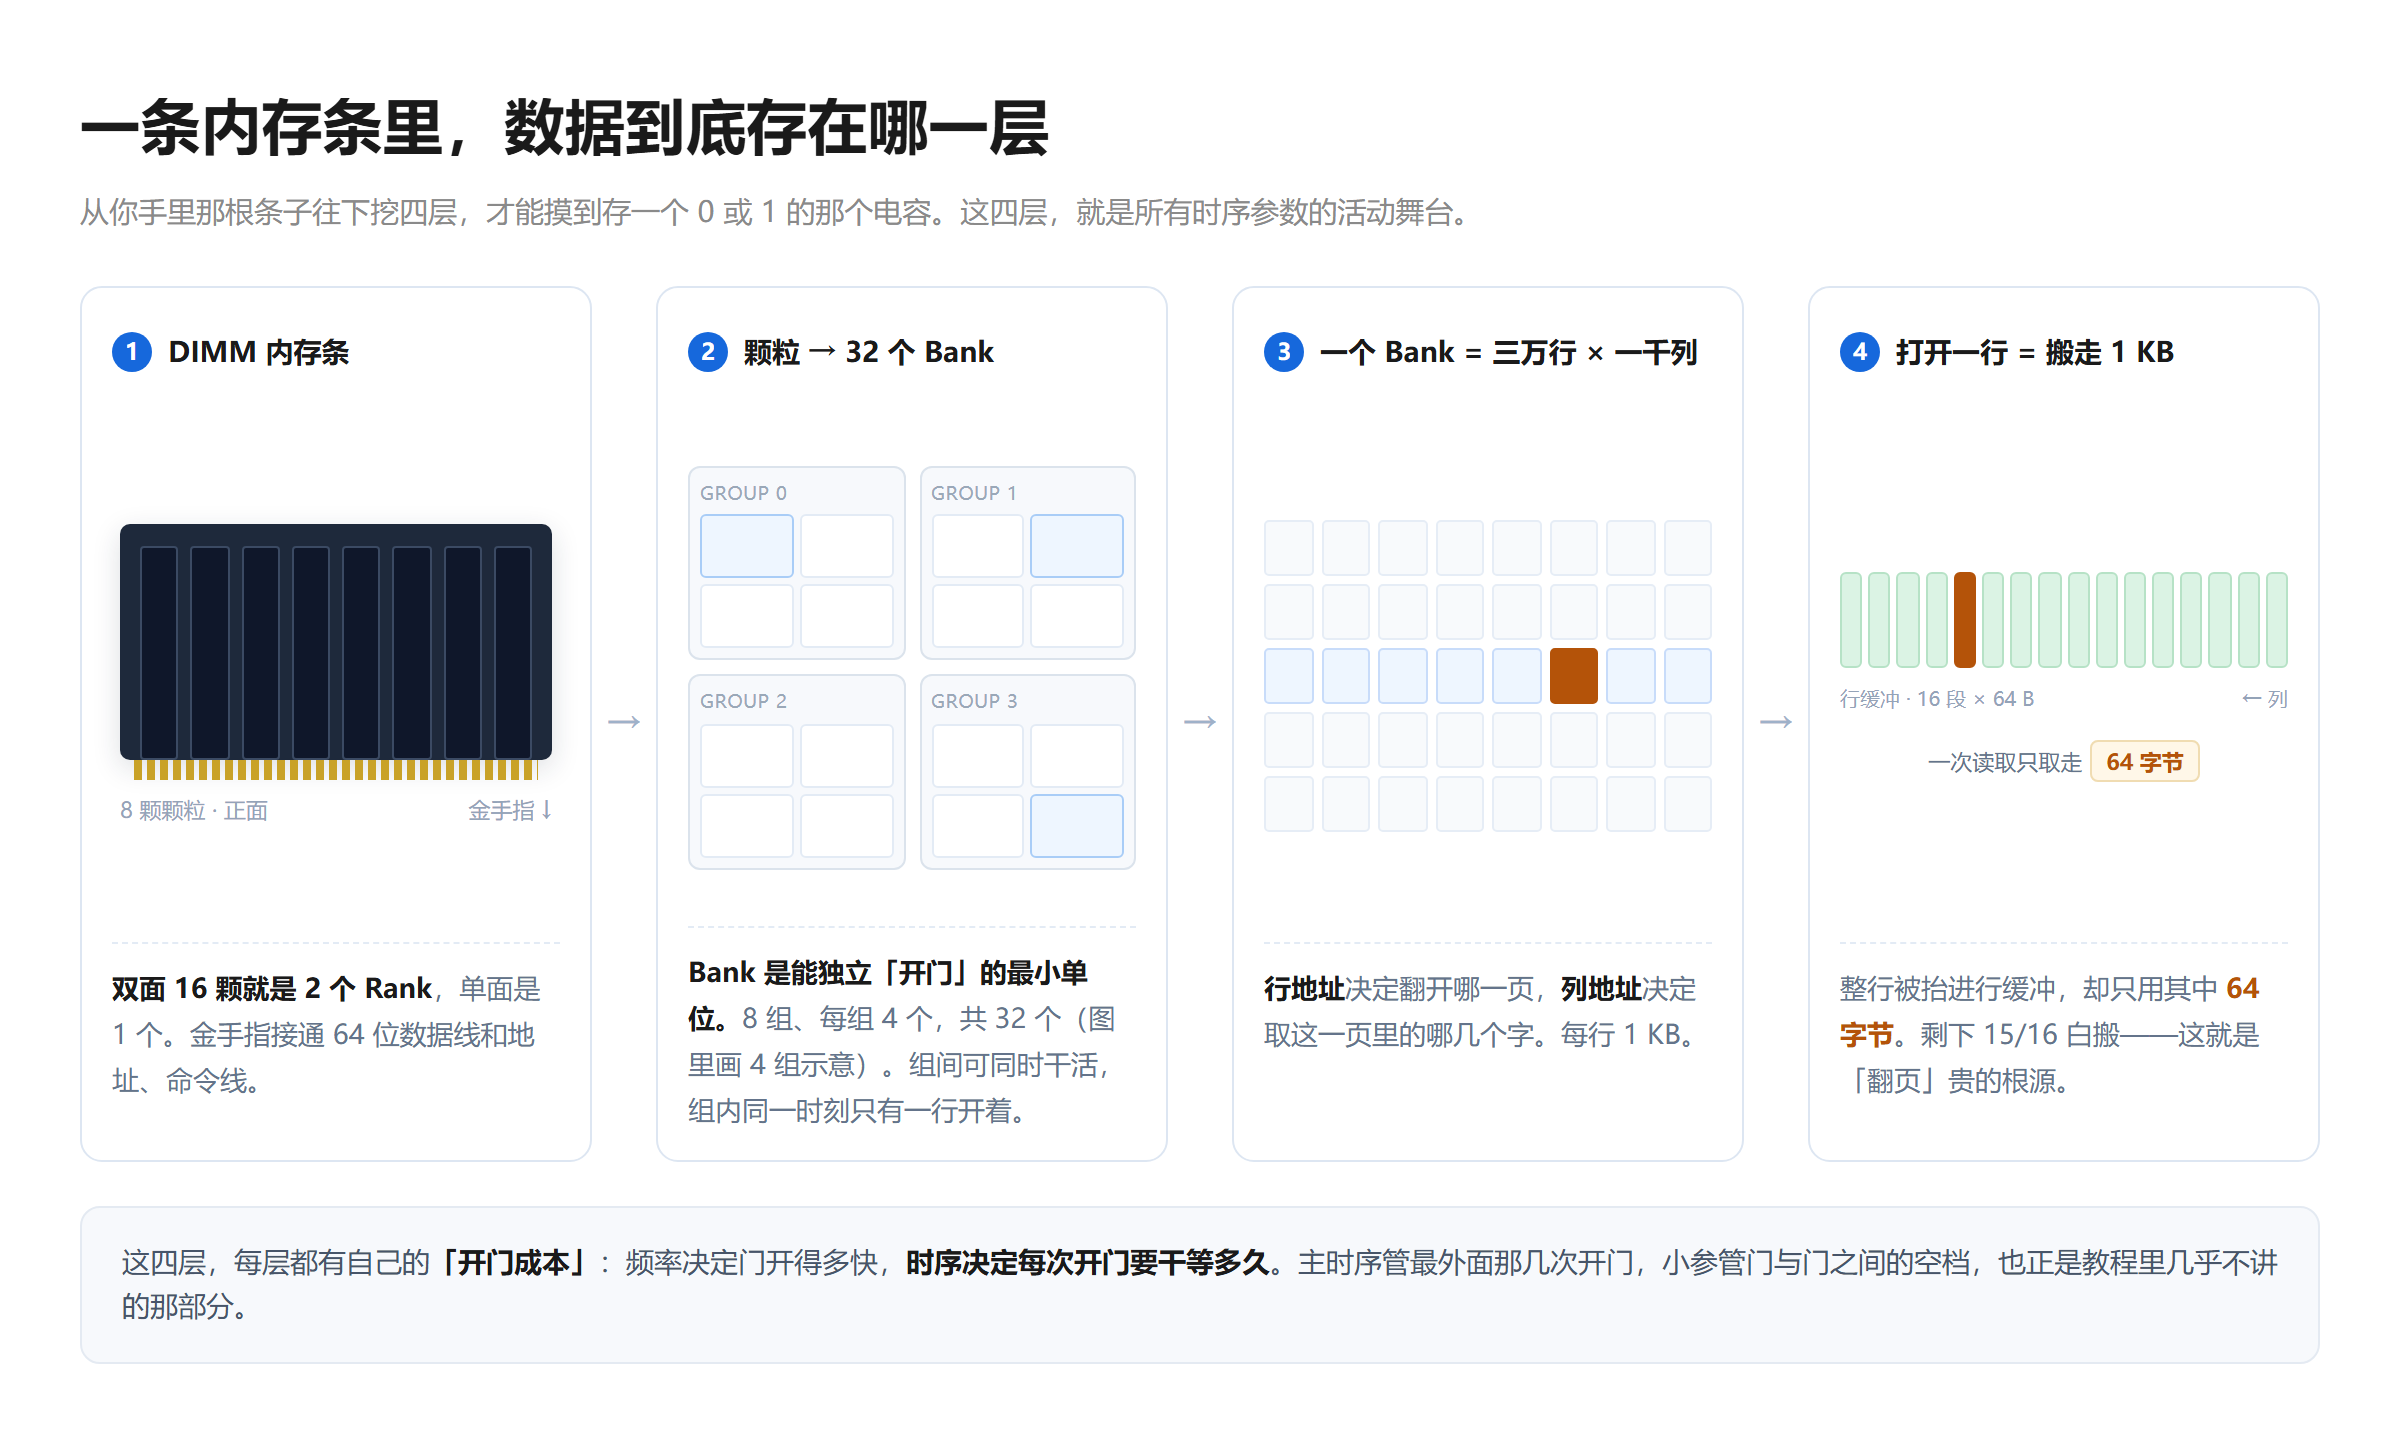
内存条插进主板以后,金手指接通的是三组线:一组 64 位宽的并行数据通道,也就是常说的 DQ 总线;一组独立的地址线;还有一组独立的命令线。CPU 需要某个数据的时候,先把地址和命令沿这两组线发下去,内存再一层一层往里找。
- 第一层是 Rank。一条双面内存通常是 2 个 Rank,单面是 1 个(少数单面双 Rank 的条子算例外)。Rank 不是一个物理意义上的「一堆颗粒」,它指的是被同时选中、一起干活的那一组颗粒。同一个 Rank 里的颗粒共享地址线,你给一个地址,它们会一起响应。
- 第二层是 Bank。一颗颗粒内部有 32 个 Bank,分成 8 个 Bank Group,每组 4 个。Bank 是能够独立「开门」的最小单位,这点很关键:不同的组之间可以同时干活,但具体到某一个 Bank,同一时刻只允许有一行处于打开状态。
- 第三层是行和列。一个 Bank 就是一张表格,三万两千多行,每行能存下 1 KB。行地址决定翻到哪一页,列地址决定从这一页里取哪几个字。
- 第四层就是电容本身。每一个电容存一个比特,充上电是 1,放掉是 0。问题是电容会漏电,所以每隔几微秒就得重新充一遍,这个动作叫刷新,后面会单独拿一节来讲它。
这里先记住一个比例:一次读取只拿走 64 字节,可内存却要把整整一行 1 KB 全搬进缓冲区。搬进来的一千多字节里,有十六分之十五是一次性的浪费。后面讲的所有「翻页成本」,其实都是从这十六比一的浪费里长出来的。
一次读取的六步
下面这个动画把一次读取的完整过程拆了下来。左边那块是内存控制器,右边是一个 Bank 的存储阵列,右下方那条长条是行缓冲。
- 第一步是 ACT,也就是把行打开。内存控制器发出 ACT(ACTIVATE,激活)命令,命令里带着行地址 R2,行解码器收到之后,就把第 2 行整行抬起来,让它和后面的感测电路接通。
- 第二步,整行被搬进行缓冲。这一行里的 8 个格子会被整排读出来放进缓冲。缓冲也叫感应放大器,它干的活就是把每个格子里那点微弱的电荷差放大成明确的 0 或者 1,不然后面根本判断不出来。搬完了,这一行才算是真正「打开」了。
- 第三步是等,等的时间就是 tRCD。行开了并不代表马上能读,还得再等 36 个时钟周期,换算成时间差不多 12 纳秒。
- 第四步是 CAS,用来选列。控制器接着发 CAS(Column Address Strobe,列地址选通)命令,这次带的是列地址 C5。命令到了之后,行缓冲里只有第 5 格被选中输出,剩下那七格就白搬了。
- 第五步又是等,等的是 tCL。从列被选中,到数据真正出现在 DQ 引脚上,中间还要 30 个周期,差不多 10 纳秒。
- 第六步,数据回传。数据顺着 DQ 总线回到内存控制器,这一次读取才算结束。
把上面这几段加起来:1 + 36 + 1 + 30 = 68 个周期,按 6000 的频率折算下来是 22.7 纳秒(周期怎么换算成纳秒,后面单独一节讲)。这是一次「冷启动」读取要花的全部时间。你可以留意一下,这 68 拍里除了最后几拍在传数据,剩下 66 拍全部是在等。
不过真正有意思的是接下来会发生什么。假如你紧接着要读的格子还在 R2 这一行里,那就不用再走一遍 ACT 和 tRCD 了——行还开着,直接发 CAS 选列就行。两次之间只隔一个 tCCD(Column to Column Delay,同一行里连读两格的间隔),几拍就能出一个数。
反过来,要是你要的格子不在 R2 上,那就麻烦了。得先把当前这行关上,这个动作叫预充电(PRE,Precharge),做法是把整行的位线拉回中间电压,这样下一行才有干净的基准可用,耗时就是 tRP;关完之后才能去开另一行,又是一遍 ACT 加 tRCD 的等待。这一关一开,几十个周期就没了。
换一行的代价有多大
下面这个动画并排放了两条时间轴,两条用的是同一个刻度,可以直接比长短。上面一条一直待在同一个行里,下面一条每读一个数就换一次行。
上面那条,四个格子都落在 R2 这一行里。第一个格子和前面一样走完整流程,后面三个就等于搭了便车,只要发 CAS 选列,总共用掉 91 个周期。
下面那条就惨了,四个格子分散在四个不同的行上。每读一个,都得先把当前这行关上(tRP 36 拍),再开一行新的(ACT 命令本身 1 拍,加上 tRCD 还要等 36 拍),最后再等数据出来(tCL 30 拍)。一组下来是 103 个周期,四组就是 412 个周期。91 对 412,差了 4.5 倍。
这个差距不是算出来的理论值,是内存的物理结构决定的,你换什么牌子的条子都一样。这也解释了为什么游戏这类中低并发的负载对内存延迟特别敏感——它们的访问模式本来就零散,几乎每读一个数都在换行,换行的成本全都要照付。
决定「换一行到底有多贵」的那些参数里,tRP 和 tRCD 属于主时序,tFAW、tRRDS、tRRDL 属于小参。还有一个 tRC,它是 tRAS 加 tRP 算出来的派生值,绝大多数 BIOS 里你根本改不了它,改了 tRAS 和 tRP,它自己会跟着变。频率在这里只决定每一拍有多长,而这些参数决定的是总共要等多少拍,两件事是分开的。
周期、纳秒、频率,三个数说的是同一件事
这里有一个换算必须记牢,不然后面所有讨论都建立在流沙上:时序里的那些数字,单位是时钟周期,不是时间。玩家口头习惯把周期叫「拍」,后面这两个词会混着用,说的是同一件事。要把周期换成真实的时间,公式是:周期数 × 2000 ÷ 数据速率(MT/s)。
按这个公式,DDR5-6000 一个周期是 2000 ÷ 6000 = 0.333 纳秒。CL 30 就是 30 × 0.333 = 10 纳秒,CL 36 是 12 纳秒。同样算一遍 DDR5-8000,一个周期变成 0.25 纳秒,这时候 CL 38 也只有 9.5 纳秒,比 6000 下 CL30 的 10 纳秒还要快一点。
这就解释了一个很多人都碰到过的困惑:为什么把频率从 6000 拉到 8000,AIDA64 的延迟不但没降反而涨了。原因是他拉频率的时候,时序被迫跟着放松,CL 从 30 变成 40,40 × 0.25 还是 10 纳秒,跟原来打平;而 Gear 2 那层时钟转换的开销、还有刷新的开销,都随着频率一起变大了,算下来净结果是退步。
也就是说,拉频率涨的是带宽,延迟是另外一回事。这两件事经常互相打架,而小参值不值得调,根子就在这里。
二、主时序:教程讲到的那四个数
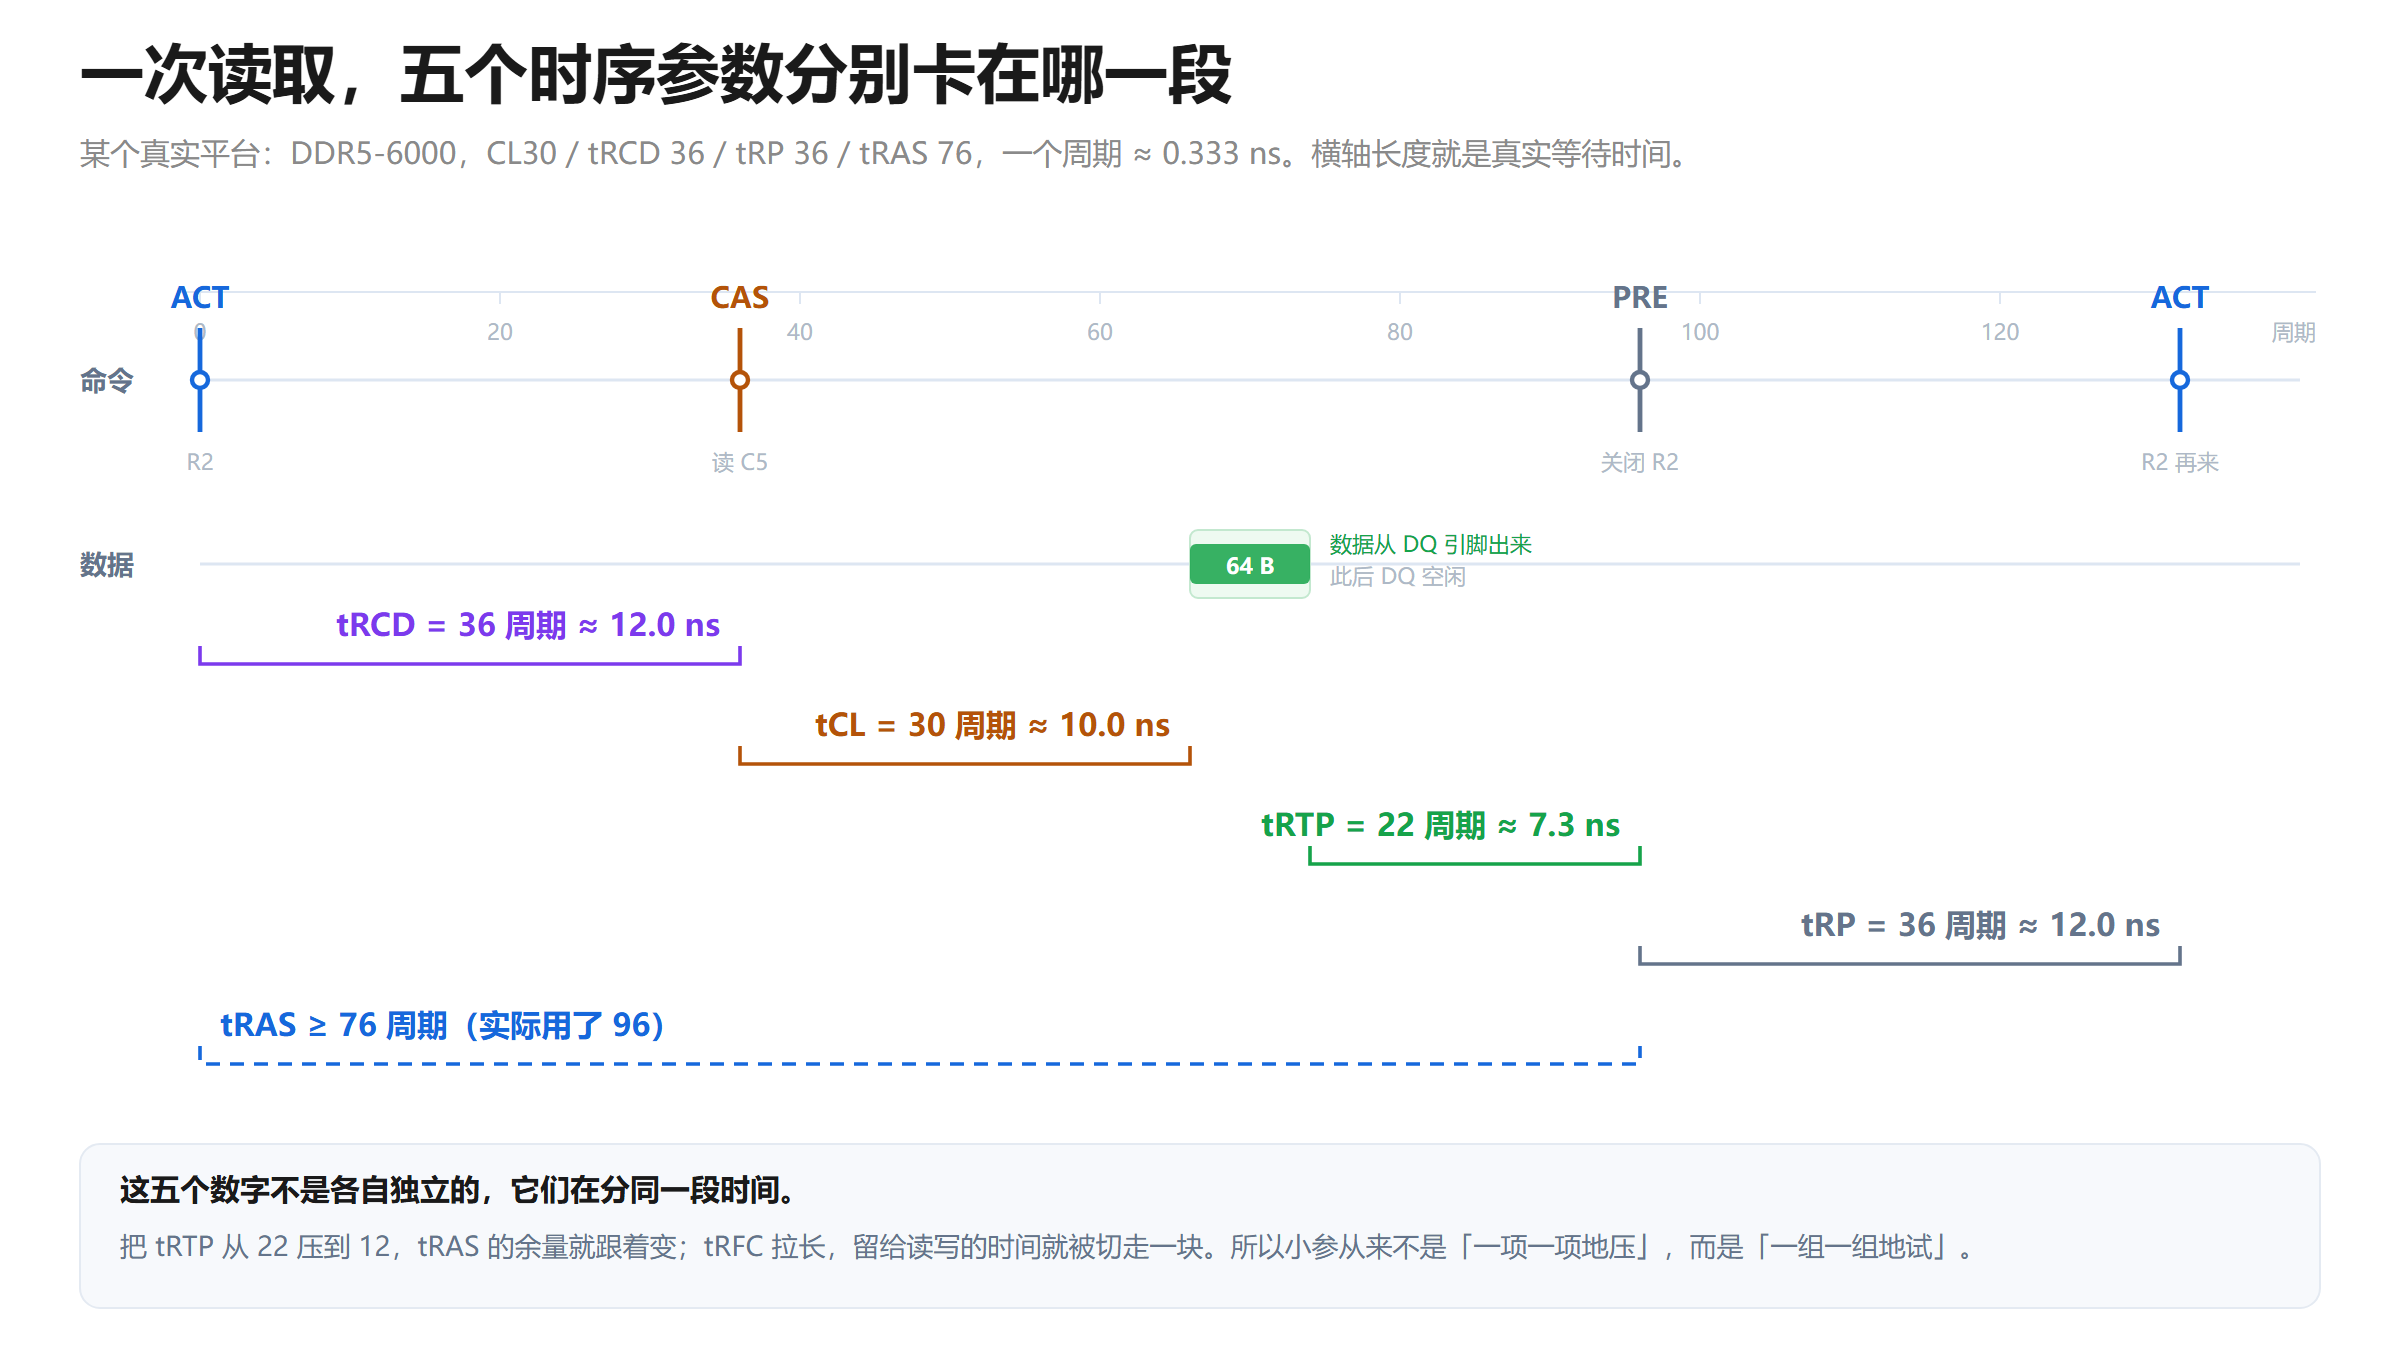
这张图把一次「打开、读、关上、再打开」的全过程摊平在时间轴上,五个参数各自卡在某一段上。四个主时序都在里面,另外还多画了一个 tRTP——它其实属于次级时序,但它和 tRAS 首尾咬在一起,不把它放进来就说不清 tRAS 到底管的是什么。
- tRCD 36:从 ACT 到 CAS 之间的那段等待,也就是行打开之后还要过多久才能选列。
- tCL 30:从 CAS 发出,到数据真正出现在引脚上要过多久。
- tRTP 22:数据读完,到允许开始预充电之间的间隔。
- tRP 36:预充电本身要花多久,说白了就是关一扇门需要的时间。
- tRAS 76:一行从打开到允许关闭之间的最短时间。注意这一次实际用了 96 拍,因为 tRTP 22 把它拖长了——76 是个下限,不是每次都会精确执行到的值。
横向看过去,这几条线段是首尾相接的。它们分的是同一段时间,而不是五个各自独立的数字。所以你把 tRP 单独从 36 压到 32,留给 tRTP 的余量就跟着变了;再往下压另一个小参,发现分数没动,八成是瓶颈早就换到下一段去了,跟你这一次改的那个参数没什么关系。
为什么教程都停在这里
原因有三个,而且一个比一个现实。说到底,教程作者和读者想要的东西并不完全一样:作者要的是不出错、可复制,读者要的是立刻能看到效果。
- 这四个数直接对应延迟。改完立刻就能在 AIDA64 上看到变化。你改 tFAW 未必看得出差别,改 CL 就一定看得出来,写教程的人当然更愿意讲能看到效果的东西。
- 这四个数在所有平台上名字都一样。照抄别人作业很方便。小参就不行了,名字在 Intel 和 AMD 上不一样,在 DDR4 和 DDR5 上也不一样,抄过来经常对不上号。
- 第三点也是最要命的。主时序调错了当场蓝屏,你立刻就知道了;小参调错了可能三天之后才崩。写教程的人不敢教,因为教错了要担责任;看教程的人也不知道自己错在哪,只能认栽。
「能开机」和「稳定」之间隔着一条很宽的沟。主时序掉进沟里,一般当场就蓝屏给你看;小参掉进沟里,系统还能正常跑,只是偶尔出一次你根本想不到的错误。
三、小参:教程没讲的那一半
先把 BIOS 打开,看看小参长什么样
光说概念没意思,直接来看真实的数值。下面这些是这台机器(i5-14600KF、ROG STRIX Z690-G、DDR5-6000 16G×2)在 XMP 打开、其余全部保持 Auto 的状态下,从 BIOS 里读出来的值。
你如果自己打开 BIOS 对照,会发现每个参数后面都跟着 CHA、CHB 两列,那是两个通道各自训练出来的结果。一般情况下两边是一样的,偶尔会差一两拍;要是差得比较多,说明两条通道的体质不太齐,取更保守的那个值用。下面为了写得简洁,只写一个数的地方就表示两边相同。
主时序(Primary Timings)
DRAM CAS# Latency:30,就是 CLDRAM RAS# to CAS# Delay Read:36,tRCDDRAM RAS# to CAS# Delay Write:36,写方向的同一个参数,tRCDWDRAM RAS# PRE Time:36,tRPDRAM RAS# ACT Time:76,tRAS
次级时序(Secondary Timings)
DRAM RAS# to RAS# Delay S:8,tRRDSDRAM RAS# to RAS# Delay L:15,tRRDLDRAM FOUR ACT WIN Time:32,tFAWDRAM REF Cycle Time:480,tRFCDRAM REF Cycle Time 2:480,tRFC2DRAM REF Cycle Time Same Bank:390,tRFCSBDRAM Refresh Interval:5851,tREFIDRAM READ to PRE Time:22,tRTPDRAM Write Latency:28,tCWLDRAM CKE Minimum Pulse Width:23,tCKE
上面没展开的还有 tWR(DRAM WRITE Recovery Time,写完成到允许预充电之间的间隔)和 tWTRS、tWTRL(WRITE to READ Delay S/L,写完到能读之间的间隔)。这几个参数在这块主板上默认交给训练算法处理,所以在 BIOS 里显示的是 Auto。
顺便说清楚一件事:BIOS 里写「Auto」不等于这个参数没有值。它的意思是这个数没有写死,而是每次开机由训练算法现场算出来的。你在 BIOS 里看到的那些 Auto 项,实际都在按训练结果跑。想自己接管也很简单,直接把 Auto 改成数字就行;只有少数跟刷新相关的项,要先在上一级菜单里把时序模式从 Auto 切成 Manual,否则你填了也不生效。
三级时序(Third Timings)
这一档有十六七项,名字看着乱,其实都是一个套路:tRDRD_sg、tWRWR_dg、tWRRD_dr。读法可以拆成两段:前半段说的是「从什么操作到什么操作」(RD 是读、WR 是写),后面的后缀说的是「这两个操作落在什么地址关系上」。sg 是同 Bank Group,dg 是跨 Bank Group,dr 是跨 Rank,dd 是跨 DIMM,也就是两根条子之间。
tRDRD_sg:16,同组连续读tRDRD_dg:8,跨组连续读tWRWR_sg:32,同组连续写tWRWR_dg:8,跨组连续写tWRRD_sg:70,同组写转读tWRRD_dg:48,跨组写转读- 另有
tRDWR_sg20、tRDWR_dg20、tRDRD_dr14、tRDRD_dd16,以及tWRPRE125——写恢复到预充电的合并值,等于把 tWR 和 tRP 揉成了一项,动它等于同时改两个参数。
这组数字摆在一起,本身就说明了不少问题。先看 tRDRD_sg 是 16,而 tRDRD_dg 只有 8。同样都是连续读,落在同一个 Bank Group 里要隔 16 拍,换到别的组读只要 8 拍。这就是 Bank Group 交错真正的意义:让请求在不同的组之间轮转起来,把一个组的等待时间,藏在另一个组干活的时间里。颗粒的 Bank 越多、组越多,随机访问性能就越好,原因就在这里。
再看 tWRRD_sg 是 70,tWRRD_dg 是 48。写完再转去读,同一个组里要等 70 拍,跨组能省到 48 拍。写操作本来就比读慢,还得等写进去的数据真正进到电容里才算数,所以这一段是整个流程里最贵的空档。
还有 tFAW 32,正好等于 tRRDS 8 的四倍。这个关系不是巧合。JEDEC(制定内存标准的固态技术协会)规定,四个行激活的窗口,至少要容得下四次行到行的间隔。所以你要是只压了 tRRDS、没动 tFAW,其实等于没压——tFAW 没跟着降下来,后面那几个行激活照样得排队等着。
次级时序:两次操作之间的空档
如果说主时序管的是「一扇门从打开到关上要花多久」,那次级时序管的就是「两扇门之间要空多久」——这其实就是开头那句话的完整版。听起来都是些琐碎的小间隔,可它实际上决定了内存能不能把流水线跑满:每一段空档短一点,几十个请求叠在一起,就是很可观的一个差距。下面挑几个必须认识的逐个说。
- tRRDS 和 tRRDL,RAS to RAS Delay,连续激活两个不同行之间的最小间隔。带 S 的是同 Bank Group 内,带 L 的是跨 Group。把它压紧,随机访问就能排得更密。
- tFAW,Four Activate Window,四个行激活的窗口。说人话就是「一段时间之内最多能开几扇门」。它跟 tRRDS 是一对绑在一起的参数,下限就是 tRRDS 的四倍;主板要是填得比四倍还松,那就是白送出去的时间,可以放心往回收。
- tWTRS 和 tWTRL,Write to Read Delay,写完到能读之间的间隔。写比读慢,这段空档就是在等写进去的数据真正落进电容里。
- tWR,Write Recovery,写完成到允许预充电之间的间隔。要是压得太紧,电荷还没灌满电容就把行关掉了,这一笔写进去的数据就直接丢了。
- tRTP,Read to Precharge,读完成到允许预充电之间的间隔。这台机器上是 22 拍,折合 7.3 纳秒。这一项不是「你填多少就算多少」的,JEDEC 规定读完之后至少要等 7.5 纳秒才允许预充电,在 6000 这个频率下差不多就是 22 拍。换句话说它本来就贴着地板,往下压压不出东西来,只能往松了调。
- tCWL,CAS Write Latency,写命令发出到写数据上线之间的时间。读方向有 CL,写方向有 tCWL,这两个值不一定要相等。
- tCKE,CKE Minimum Pulse Width,时钟使能信号的最短脉宽。它管的是内存进出低功耗状态之间的最小间隔,跟读写路径没什么关系。日常超频根本不用碰它,写在这里只是为了你哪天在 BIOS 里撞见它的时候,不至于心里发慌。
- tRFC、tRFC2、tRFCSB,Refresh Cycle Time,单次刷新要停多久。这三个数对应三种不同的刷新模式:tRFC 是常规刷新,一次就刷完;tRFC2 是细粒度刷新(FGR)的 2 倍模式,把一次大刷新拆成两次小的来做,每次停的时间短了,但次数变多了;tRFCSB 是「同 Bank 刷新」,只刷一个 Bank,其余 Bank 照常干活。BIOS 里那个 Fine Granularity Refresh mode 就是切换这个的开关,默认 Auto 就是常规模式。日常要动的其实只有 tRFC 一个。
- tREFI,Refresh Interval,也就是两次刷新之间隔多久。tRFC 和 tREFI 这两个参数下面会单独开一节讲,因为它们在 DDR5 上最值钱,同时也最危险。
三级时序:收益最小、最容易翻车的一档
三级时序只在一种情况下才会生效:你连续读、连续写,或者读写交替,并且地址恰好落在对应的那种 Bank 关系上。日常负载里这种情形占比并不高,所以压紧它们的收益通常连 1% 都不到,很多时候在 AIDA64 上根本看不出差别。
可是失败率并不低。这类参数约束的是信号完整性和时序余量,压过头不会立刻崩,而是在某些特定的地址组合上悄悄出错。典型的表现就是跑分一路全绿,结果解压一个压缩包的时候突然报 CRC 校验错。所以结论很简单:三级时序是最后才考虑动的东西,而且完全可以永远不动。
哪些小参真值钱
下面按「改了之后你能不能感觉到」这个标准排个序。排在前面的并不是技术含量最高的,而是在日常负载里被碰到次数最多的。
| 参数 | 管什么 | 值不值得动 |
|---|---|---|
| tREFI | 刷新间隔,直接决定可用带宽 | 首选,收益最大 |
| tRFC | 单次刷新耗时 | 首选,配合 tREFI |
| tFAW | 一段窗口内最多开几行 | 值得,游戏帧率有感 |
| tRRDS tRRDL | 行到行的最小间隔 | 值得,跟 tFAW 一起动 |
| tWR | 写完到预充电 | 可以试,收益中等 |
| tRTP | 读完到预充电 | 可以试,收益中等 |
| tCWL | 写命令到写数据上线 | 可以试,收益中等 |
| tWTRS tWTRL | 写转读的间隔 | 可以试,风险中等 |
| tRDRD_* tWRWR_* | 同向连续访问 | 收益不到 1%,风险不低 |
注意比一下第一行和最后一行。第一项 tREFI 可能给你三五个百分点的带宽,最后那项 tRDRD_dd 只能给你零点二个百分点,甚至一点都没有;可是这两者把系统搞崩的概率是差不多的。
这张表只写了值不值得动,没写具体能压到多少。不是不想写,是这三个边界都跟你的硬件绑死了,别人抄不走,你也抄不来。
- tFAW 不能小于 tRRDS 的四倍。你要是填得比四倍还小,BIOS 不会报错也不会提醒你,它直接按四倍算,你以为自己压下去了,其实一点没动。
- tRFC 能压到多少,取决于你条子上的颗粒。海力士、三星、美光的下限差得挺多,24Gb 的颗粒又比 16Gb 高一档。网上抄来的数值,抄的是别人那对条子的颗粒,不是你这对的。
- tREFI 能拉到多高,看的是温度。3.9 微秒是常温下的标准值,再往上拉就等于在赌你的机箱风道好不好。赌输了它不会报错,只会出错。
所以真正划算的做法,不是把所有参数都压到极限,而是把表格前三行(tREFI、tRFC、tFAW)压到位,然后就停手。再往后压的那些,投入的时间和承担的风险已经完全不成比例。
四、刷新:最值得动、也最容易翻车的两个数
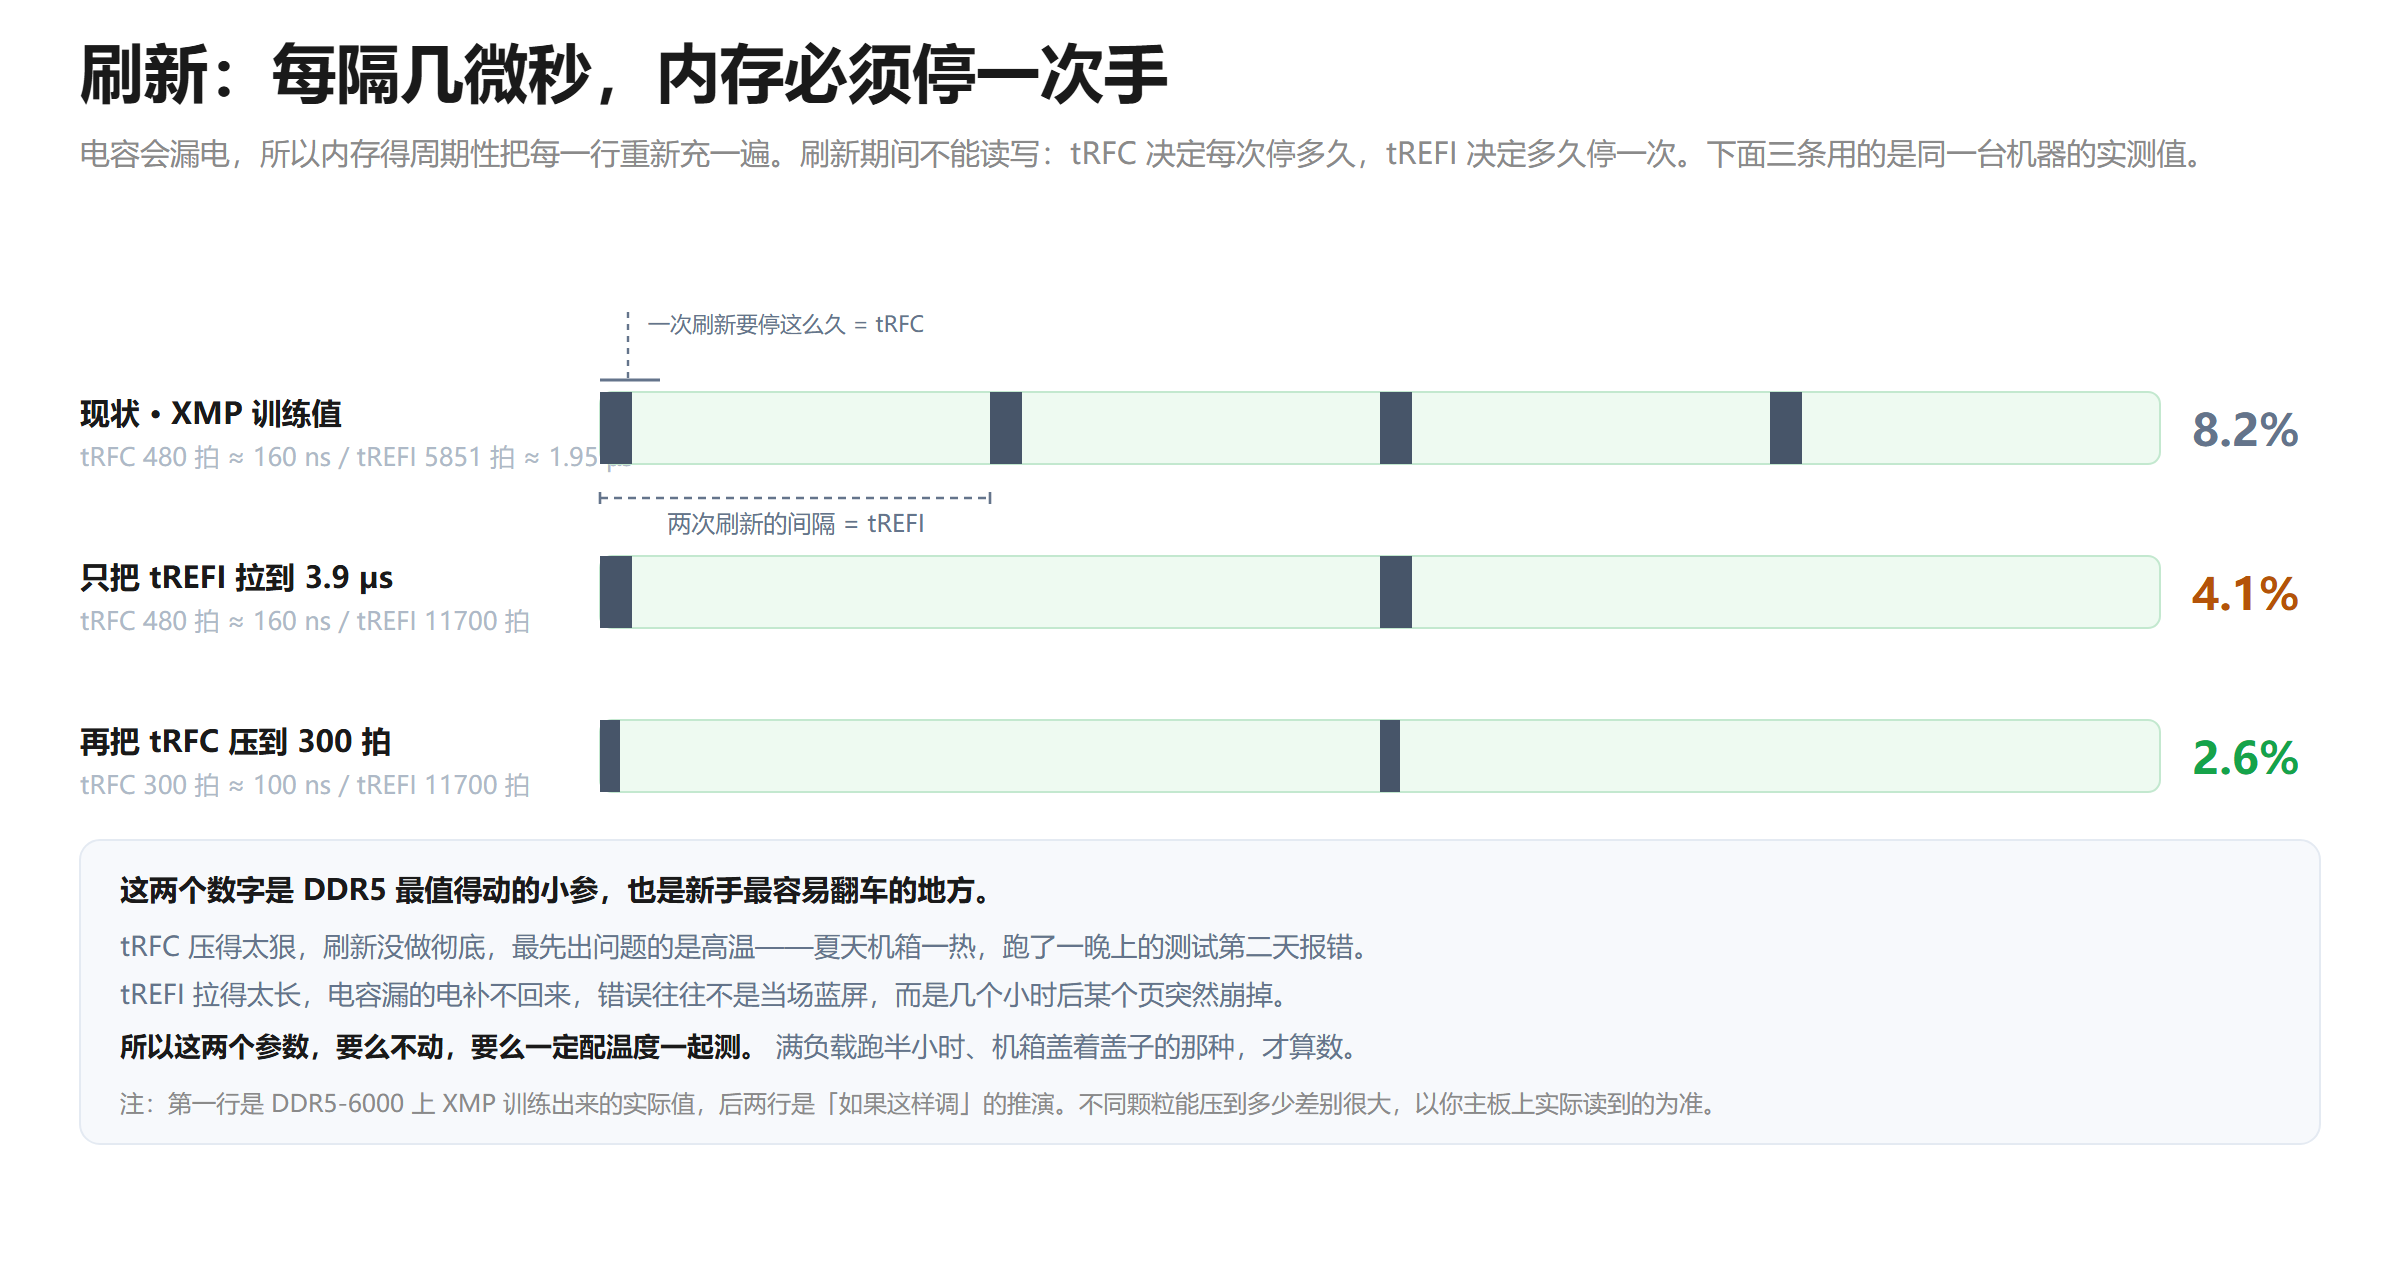
电容会漏电,这一点没有任何办法绕过去。所以内存必须周期性地把每一行重新充一遍,这个动作就叫刷新。而刷新进行的时候,那个 Bank 是没法读写的。这件事的代价由两个参数决定:tRFC 是一次刷新要停多久,tREFI 是多久停一次。
这台机器上,tRFC 是 480 拍,换算下来 160 纳秒;tREFI 是 5851 拍,换算下来 1.95 微秒。拿 160 除以 1950 等于 8.2%。也就是说,这颗颗粒有 8.2% 的时间是在刷新,这段时间它不干活。换算成带宽就好理解了:你花钱买的那部分理论带宽,有 8.2% 从来没有真正到手过。
把 tREFI 从 5851 拉到 11700(也就是 3.9 微秒,这正好是 JEDEC 在常温下的标准值),占用立刻掉到 4.1%。再把 tRFC 从 480 压到 300(100 纳秒),占用进一步降到 2.6%。
从 8.2% 到 2.6%,中间多出来的是 5.6 个百分点,这部分时间现在可以拿来读写了。落到分数上,AIDA64 的复制带宽能涨三到五个百分点,这个幅度在内存超频里已经算很大了。
顺便说一句,为什么这台机器的 tREFI 只有 5851,而不是 11700。1.95 微秒其实是 JEDEC 规定的「高温档」数值,内存温度超过 85 度的时候,DRAM 会自己切到这一档。主板出厂就按这个给,有可能是 XMP 里直接写死了,也有可能是开机时的温度读数触发了切换。不管是哪一种,这个值都偏保守,正好给你留了调整的空间。不过代价也是实打实的,主要有两条,而且都不容易在短时间内发现:
- tRFC 压过头的话,刷新做不彻底,电容充不满。刚开始不会有任何异常,等温度一上来就开始出错。典型场景是夏天机箱盖着侧板跑一小时游戏,然后蓝屏。
- tREFI 拉过头的话,两次刷新隔得太久,漏掉的那部分电补不回来。这种错误比 tRFC 引起的那种更阴,因为它不看负载,只看时间。很可能压测半小时全绿,然后你挂着下载去睡觉,凌晨三点它崩了。
这里还有一个很多人不知道的坑。上面说的那层温度保护,靠的是 DRAM 内部的温度传感器自己去改刷新率。可你一旦把 tREFI 填成固定值,这条自动通路就断了——温度上去了,刷新间隔还是原来那么大。所以只要动了 tREFI,就必须同时盯着内存温度。
DDR5 的条子上是带温度传感器的,AIDA64 和 HWiNFO 都能读到颗粒的温度(PMIC 的读数会更高一些,别拿它当判据)。跑测试的时候顺手看一眼,颗粒温度超过 55 度,就该考虑往回收一收了。
五、从零开始的调节顺序
这个顺序不是随便排的,它遵循一个原则:先把大框架定下来,再去修边角。因为框架一动,边角的余量就全变了,你之前调的那些活等于白干。
- 第一步,定频率。把频率定在你想要的那个档位上。AMD 平台还要额外确认一件事:FCLK(Infinity Fabric 时钟)和 UCLK(内存控制器时钟)跟内存频率是不是 1:1,一旦脱钩,延迟会明显变差。这一步不用追求极限,只求能稳定开机、过一轮基础测试就行。
- 第二步,四个主时序。CL、tRCD、tRP、tRAS。从 XMP 给的数值往下压,一次压 2,压到开不了机就退回来一档。这一步收益最大,也最容易感觉得到。
- 第三步,tREFI 和 tRFC。这两项是 DDR5 上性价比最高的。顺序上先拉 tREFI、再压 tRFC:因为占用率是 tRFC 除以 tREFI,tREFI 在分母上,先动它掉得更快。一步一步来,别一上来就填最大值。
- 第四步,tFAW 和 tRRDS、tRRDL。这三个要一起调,因为 tFAW 的下限就是四倍的 tRRDS。先把 tRRDS 定下来,tFAW 跟着它走。这一组对游戏帧率的影响,比在跑分里看到的更明显。
- 第五步,tWR、tRTP、tWTRS、tWTRL。这一组都跟读写切换有关。收益中等,风险也中等,慢慢磨就行。
- 第六步,tCWL 和三级时序。走到这一步,剩下的收益已经很薄了。tCWL 可以试一试,三级时序建议直接放弃。
每一轮只动一组参数,动完必须测一遍。这里的标准不是「能开机」,而是「跑完测试不报错」,这两件事差得很远。
什么时候该停手
下面三个信号,出现任何一个,就老老实实退回上一档,不要抱着「再压一点试试看」的念头硬撑。
- 测试报错,哪怕只有一个。内存错误不会自愈,报出第一个就说明它已经不稳了。
- WHEA 日志里出现已纠正错误(corrected error)。WHEA 是 Windows 记录硬件错误的地方,能写进这里,说明 CPU 已经纠正过一次内存错误了。别觉得纠错成功就没事,它其实等于告诉你:余量已经用光了。
- 同样的设置,冷机跑得动、热机跑不动。这是温度引起的不稳,比直接报错更危险,因为你日常使用的时候很难复现出来,一旦出问题也找不到规律。
测试工具方面,最常用的是 TestMem5 配 anta777 的 extreme 配置。anta777 是一个玩家自己做的测试配置,比软件自带的那套狠得多,一般起步就要跑一小时。y-cruncher 的 VT3 对内存控制器的压力很大,适合测高频。Karhu 是收费的,但确实省时间。
要说明一点:AIDA64 的跑分不算测试。它只跑十几秒,能证明的事情只有一件——这一秒没崩而已。
三个不会当场发作的坑
- 数据损坏。内存出错的后果不一定是蓝屏,更常见的情况是某个文件被悄悄写坏了,而你当时完全不知道。压测没测出来的那些错误,可能在几个月之后变成一张打不开的照片,或者一个装到一半就报错的安装包。
- 温度漂移。室温 25 度时调好的参数,到了夏天 32 度可能就不行了。DDR5 上这个现象尤其明显,因为 PMIC(电源管理芯片)也焊在条子上,跟颗粒一起发热,它一热,输出电压就开始飘。
- BIOS 版本。同一个参数在不同 BIOS 版本里,实际生效的值可能是不一样的,DDR5 的 tREFI 和 tRFC 尤其如此。所以刷完 BIOS 之后,之前验过的参数得重新验一遍。
最后
内存超频这件事,频率是最响的那个旋钮,主时序次之,小参几乎没有声音。可恰恰是这些没声音的参数,决定了你这台机器是「跑分好看」,还是用起来真的快。
回到开头那组数字:90267、92818、89011、66.6 纳秒。这是一份很规矩的成绩,开个 XMP、再稍微压一压主时序就能拿到。但它离这对条子的真实上限还有距离,差的那一截,就在 BIOS 里那三十几个没人给你讲过的参数上。
至于要不要去动这些参数,取决于你愿意在测试上花多少时间。如果只想装完机安安稳稳地用,XMP 加四个主时序已经足够了。要是你已经调到了瓶颈、心里又不甘心,那就从 tREFI 和 tRFC 开始,这两个是整堆参数里最有可能让你实实在在感觉到差别的地方。
三级时序就随它去吧,那点收益和你要承担的风险完全不成比例。真有那个时间,不如多打两把游戏。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING