





11 月初,Geekbench 数据库里出现了三颗 AMD 移动处理器的跑分记录,测试机是联想的工程样机,内部编号 LENOVO 22ETPF6DTA 这类形态。三颗芯片分别是 10 核、8 核、6 核,家族标识 AuthenticAMD Family 26,代号 Medusa Point。
数字确实好看:10 核样品的 Geekbench 7 单核 3100 分,比现役 16 核的 Ryzen AI MAX+ 395 高 28%;核显 OpenCL 22249 分,比同样 4 个 CU 的 Radeon 840M 高 85%。但这两个结论的分量不一样,后一个基本站不住。
先划清边界:所有成绩都来自工程样品,AMD 没有公布 Medusa Point 的任何规格,连这个名字都还是数据库里的字段,官方从未承认过。
测试平台与样品
信息最全的是 10 核那颗:样品编号 100-000001713-32_Y,配 64GB DDR5-5200,家族标识 Family 26 Model 129,Guru3D 读到的细节更具体一些——可用内存 55.58GB,等效 5188 MT/s,跑在四条通道上。
8 核和 6 核用的是另一套标识,Family 26 Model 224。同一个家族出现两个 Model 号,说明 10 核那颗和 8/6 核在固件里被当作不同的平台,爆料据此把它们分成 Medusa Point 1 和 Medusa Point 2/3。
核心配置
三颗都是 Zen 6 加 Zen 6c 的混合设计,比例相当悬殊:10 核是 4 个 Zen 6 配 6 个 Zen 6c,8 核是 2 配 6,6 核是 1 配 5,越往低端走,全功能核越少,密度核越多。
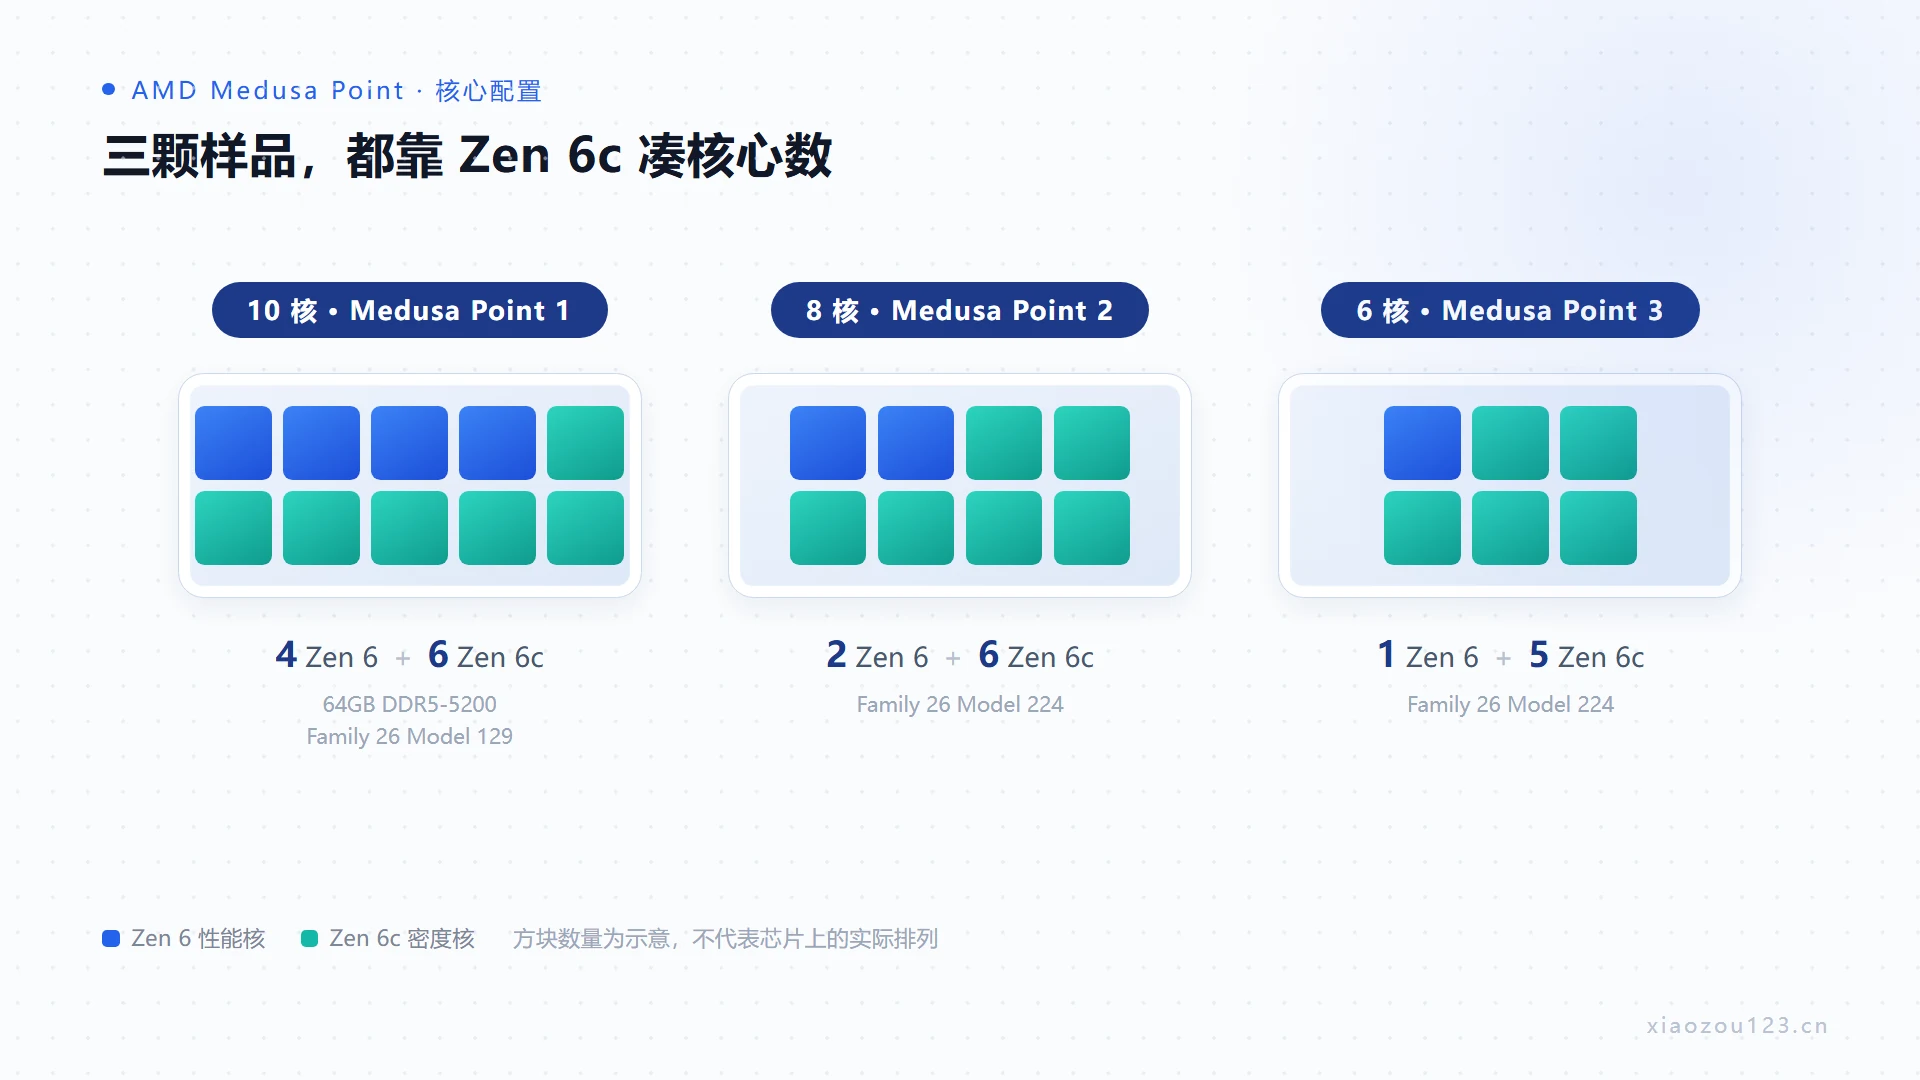
Zen 6c 是密度核,指令集跟 Zen 6 一致,但面积更小、频率更低,主要吃多线程吞吐这类活。AMD 从 Zen 4c 开始用这套思路,前两代主要给服务器和低功耗产品,这次直接放进主流移动产品线。换句话说,轻薄本上的「10 核」里,真正能冲高频的只有 4 个。
线程数上有一条记录写的是 20 线程,对应 10 核,说明两组核心都开了 SMT,而低配的 6 核按同样逻辑应是 12 线程,这一条没拿到独立验证。
| 样品 | 核心配置 | 家族标识 | GB7 单核 | GB7 多核 |
|---|---|---|---|---|
| Medusa Point 1 | 4 Zen 6 + 6 Zen 6c | Family 26 Model 129 | 3100 | 18313 |
| Medusa Point 2 | 2 Zen 6 + 6 Zen 6c | Family 26 Model 224 | 2913 | 15075 |
| Medusa Point 3 | 1 Zen 6 + 5 Zen 6c | Family 26 Model 224 | 2651 | 10670 |
CPU 成绩
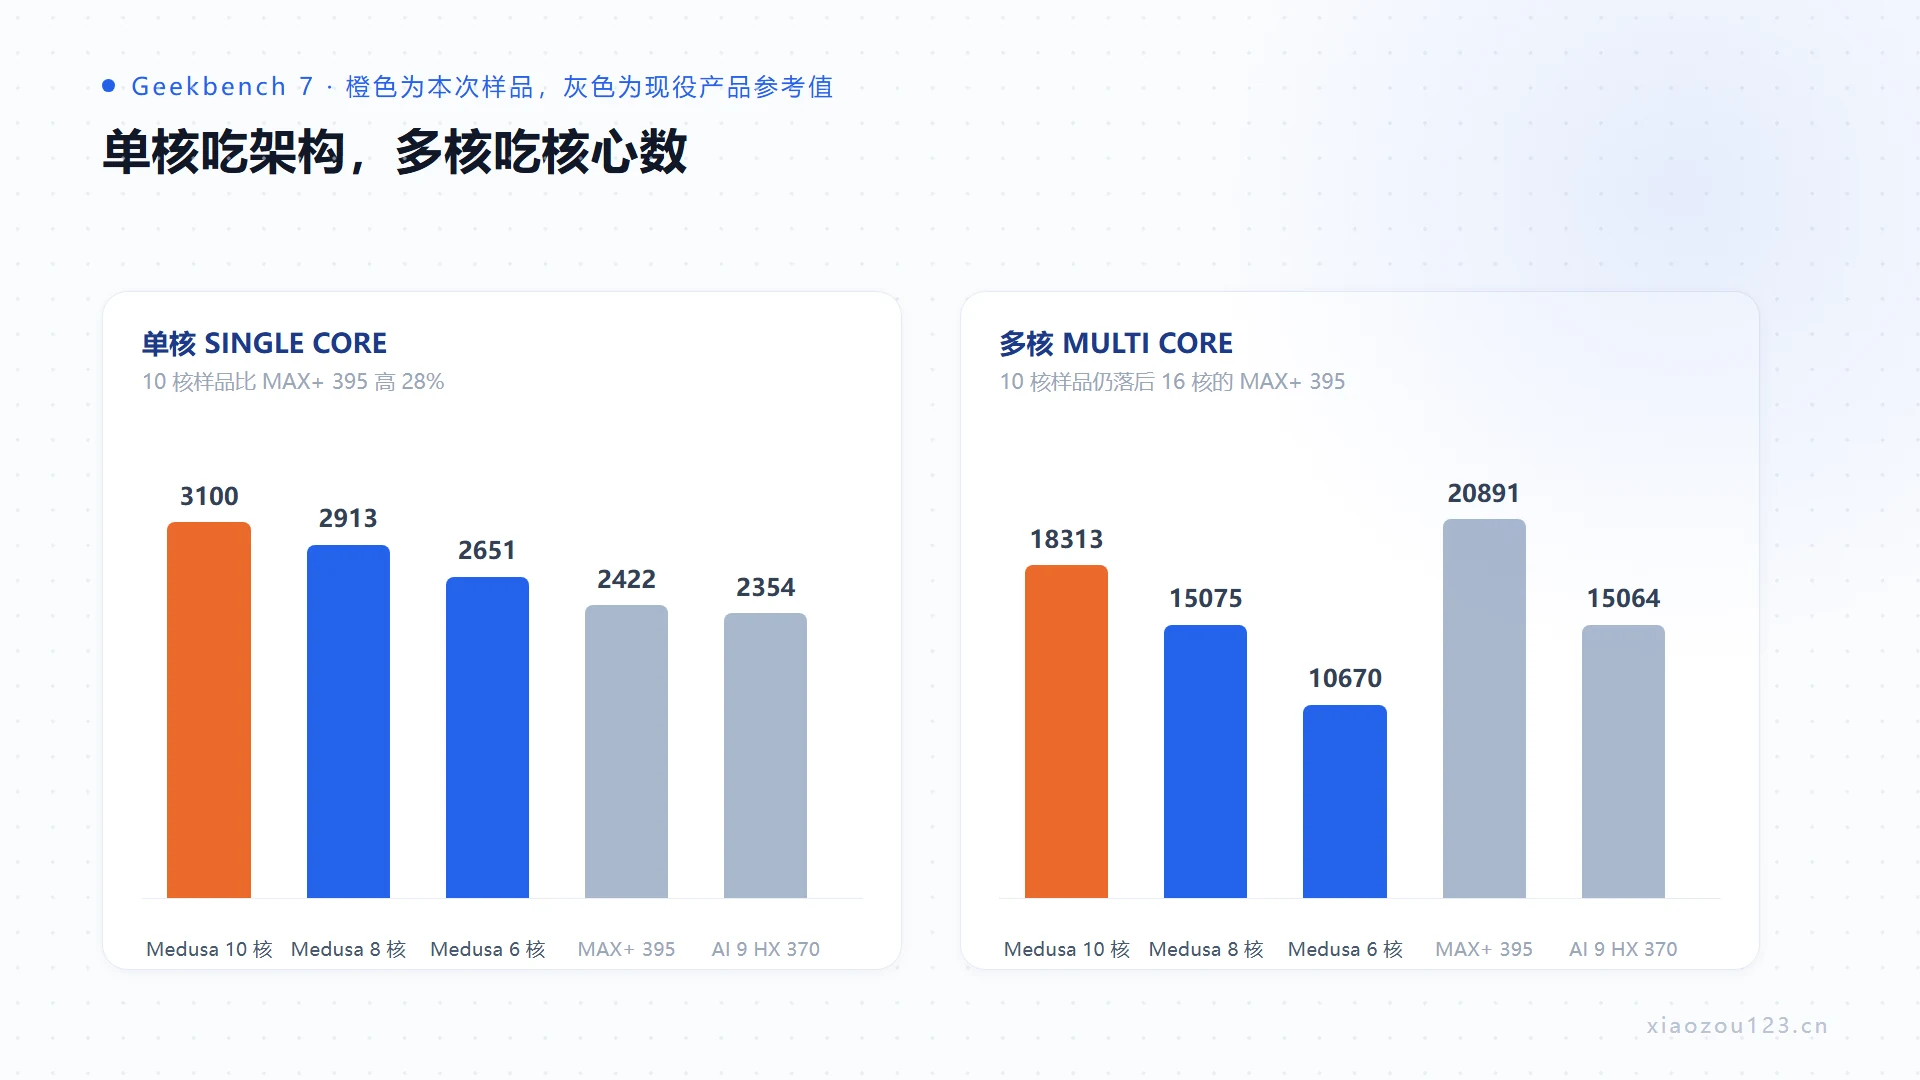
单核这一列是真的跨代。10 核样品比 12 核的 Ryzen AI 9 HX 370 高 32%,比 MAX+ 395 高 28%,而这两颗现役芯片的加速频率都在 5GHz 以上。样品的主频记录只有 2.0 到 2.4GHz 区间,还带着识别错误,等量产频率落地,差距只会更大。
放到整个移动平台里看,这个单核也不算天花板:高通 18 核的 Snapdragon X2 Elite 在 Geekbench 6 里拿到 3573 分,比 7 月底那颗 3329 分的样品高 7%。x86 阵营把单核追到 7% 以内,是近几年少有的距离。
多核就没那么夸张:10 核用更少的核心超过 HX 370 约 21.5%,但比 16 核的 MAX+ 395(20891 分)少 12%,8 核的 15075 分跟 HX 370 的 15064 几乎一样,6 核只有 10670 分、比 HX 370 低三成。核心数摆在那儿,多线程讨不到便宜。
Geekbench 6 里还有一组数:10 核样品单核 3407、多核 16826,单核比 MAX+ 395 和 HX 470 高 15%,多核领先 HX 470 约 6%,逼近 54W 下的 16 核 MAX+ 395。同一个芯片,Geekbench 6 和 7 的分数差这么多,这两个版本的分数不能横向对比,引用时得看清楚是哪一版。
核显与 RDNA 4m
核显被识别为 GFX1170,4 个计算单元,架构标为 RDNA 4m。这个名字看着像全新的,其实按目前披露的说法,它是把 RDNA 3.5 与 RDNA 4 的模块拼在一起的过渡形态,不是下一代的大改。AMD 的 HIP-RT 3.2.0 库里已经出现 gfx1170、gfx1171、gfx115E 三个 Medusa 相关标识,前两个归到 RDNA 4m,gfx115E 仍归 RDNA 3.5。
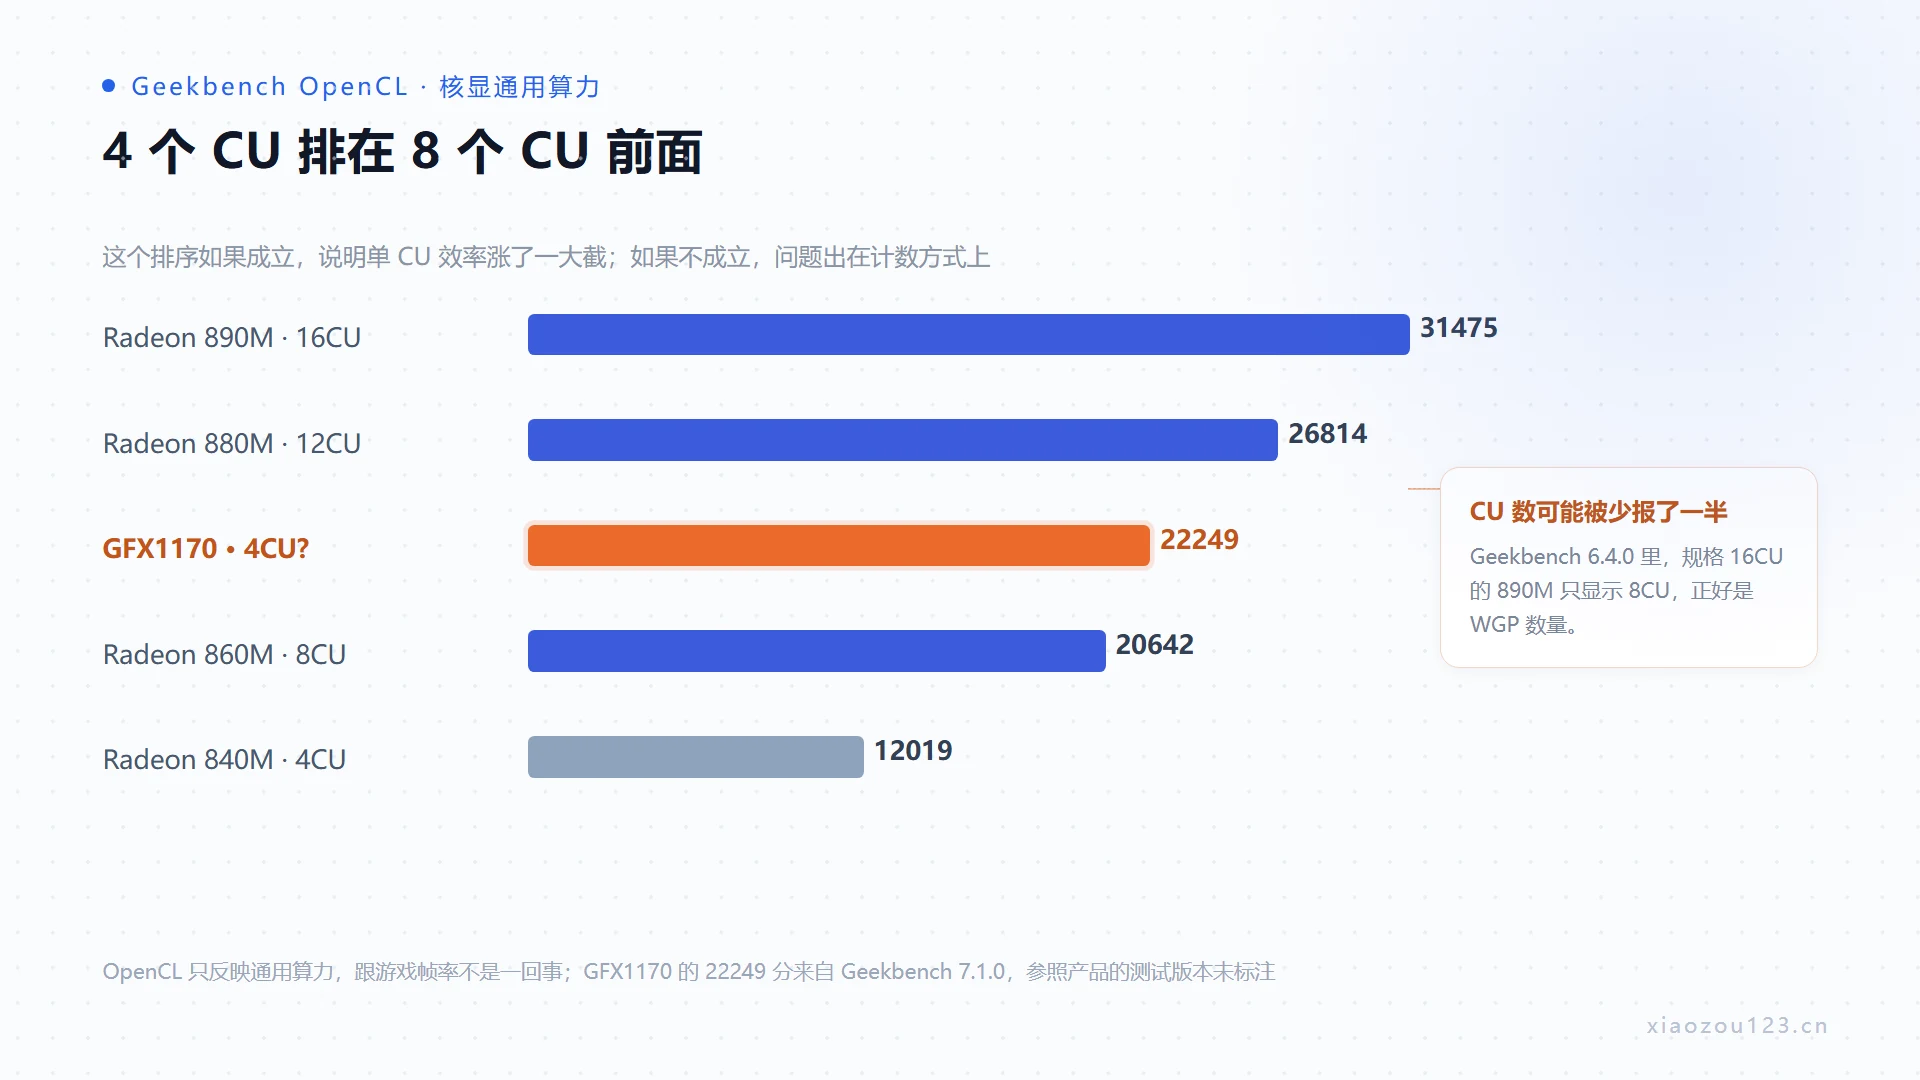
OpenCL 拿到 22249 分,放在同代产品里排一下就很清楚:4CU 的 Radeon 840M 是 12019,8CU 的 860M 是 20642,12CU 的 880M 是 26814,16CU 的 890M 是 31475,GFX1170 正好落在 860M 和 880M 之间,比同 CU 数的 840M 高 85%。
| 核显 | CU | 架构 | OpenCL |
|---|---|---|---|
| Radeon 890M | 16 | RDNA 3.5 | 31475 |
| Radeon 880M | 12 | RDNA 3.5 | 26814 |
| GFX1170 | 4(存疑) | RDNA 4m | 22249 |
| Radeon 860M | 8 | RDNA 3.5 | 20642 |
| Radeon 840M | 4 | RDNA 3.5 | 12019 |
核显结论的两处硬伤
第一处在 CU 计数。Geekbench 报出来的 Compute Units 未必等于厂商规格:Geekbench 6.4.0 有一条记录,规格 16CU 的 Radeon 890M 只显示 8CU,分数 30946、最高频率 2900MHz。RDNA 里两个 CU 组成一个 WGP,Geekbench 报的很可能就是 WGP 数量,那么 GFX1170 的「4」实际对应 8 个 CU。
如果真是 8CU,对比基准就变了:它不是拿一半的单元打赢 860M,而是同规格赢了 7.8%。「4 个 CU 打赢 8 个 CU」这个结论,成立与否全看计数口径。
第二处在测试版本。GFX1170 的 22249 分跑在 Geekbench 7.1.0 上,参照产品的 31475、26814、20642 都没标版本,其中 890M 的 31475 和 Geekbench 6 里那条 30946 很接近。两个大版本的分数不能直接横比,这张对比图有可能是两个版本混着拼的。
把两条合起来看,能确定的只有一件事:RDNA 4m 每个 CU 的效率比 RDNA 3.5 高,高多少要等同一版本、同一口径的对比。「4CU 打赢 8CU」现在只能算一个待验证的说法。
从样品到量产还有多远
这颗芯片不是 11 月才第一次出现。今年 3 月,一块 Plum-MDS1 评估板上的 10 核样品在 2.0GHz 下跑出 2300 / 13002;7 月同一颗样品(编号 100-000001713-33_N)涨到 3174 / 15092;7 月底的 Geekbench 6 记录到了 3329 / 16555,加速频率 5.37GHz,单核跟桌面 Ryzen 9 9900X 打平。
11 月这轮换成了成品形态的联想样机,分数回到 3100,原因大概率是换了 Geekbench 7——版本不同基准就不同,3xxx 和 2xxx 这两批数不能直接比。
几条记录之间还有对不上的地方:频率字段一条写基准 2.00GHz、最高 1.996GHz(最大值低于基准值,明显是识别错误),另一条写 2.40GHz;缓存一条 16MB L3,另一条 32MB。同属 Family 26 的两条记录,单核差 35%、多核差 41%。样品还在不同步的固件上跑,现在的分数能看趋势,不能看绝对值。
时间上,多家外媒预期 2027 年 CES 发布,归入锐龙 AI 500 系列,封装 FP10,功耗区间 28W 到 45W。这些还没有一条来自 AMD 官方。
待确认信息
- 10 核的配比:Wccftech、快科技都写 4 个 Zen 6 加 6 个 Zen 6c,但流传的示意图画成 6 加 4,两边对不上,数据库字段只给了总核数。
- 核显的 CU 数:Geekbench 显示 4,按 WGP 口径可能是 8,AMD 没有公布 GFX1170 的规格。
- 缓存容量:16MB 与 32MB 两种读数并存,另有 6 核 4MB、8 核 8MB 的说法,均未经交叉验证。
- 频率与功耗:样品的加速频率记录混乱,量产目标的 TDP 区间未知。
- 发布型号:锐龙 AI 500 的命名与 SKU 排布全是推测。
这轮爆料真正有价值的是两件事:Zen 6 的单核效率确实提上来了,RDNA 4m 每个 CU 的产出也确实更高。「4CU 打赢 8CU」这种说法好传播,但经不起把版本号和计数口径一起摊开,要下结论,等 2027 年 CES 的零售版。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING