

博客跑了两年多,内容攒了不少,但 SEO 这块一直是「能用就行」的状态。主题自带的标签、描述、内链这些,基本没管过。
前阵子折腾的时候顺手做了一轮体检,结果挖出来的问题比想象的多。既然开了头,就干脆系统性地做完,从体检、修复到回归验收走了一遍。
做之前我先把两份官方文档翻了一遍:Google 的 Search Central(搜索中心)和微软的 Bing Webmaster Guidelines(必应站长指南)。这两份文档的好处是它们不讲玄学,只讲搜索引擎实际怎么处理一个页面。所以下面的每一处改动,我都尽量附上官方原话——省得你我都在凭感觉猜。
(为安全起见,本文不涉及任何服务器信息和后台接入细节,只谈方法。)
第一步:先体检,别急着改
第一件事不是改东西,是先摸清楚现状。
我模拟搜索引擎爬虫的视角,把站上能爬到的页面全抓了一遍——文章、页面、分类归档、标签归档、日期归档、搜索结果页,一共六十多个 URL,逐项检查:
<title>有没有、长不长、重不重复<meta name="description">有没有、内容是什么canonical是否齐全sitemap.xml的结构和条目数robots.txt有没有误屏蔽- 结构化数据(JSON-LD)的节点是否完整
- 每个页面的
<h1>数量 - 图片的
alt属性
为什么一定要用爬虫视角? Google 在开发者文档里写过一句话,值得先记住:
Googlebot 对每个 URL 的处理,都像是它从你的站点上看到的第一个、也是唯一一个 URL。
换句话说,爬虫并不"理解"你的站点结构。它只能从一个 URL 出发,靠页面上的链接自己往外爬。你在浏览器里看到的那个完整站点,和爬虫看到的东西,可能完全不是一回事——官方文档也直说了:*Google 并不总是能看到你在浏览器里看到的一切*。
所以先以爬虫视角看一遍站点,比凭感觉改有用得多。很多时候我们以为的问题(比如"标题太长")不是真问题,而真正的问题藏在数据里,想不到。
走到一半发现,问题不在技术
体检完我列了个清单,但仔细一看,排名上真正的瓶颈不是技术配置,而是内容缺口。
举个最典型的:全站的文章描述。
meta description 是搜索结果里标题下面那段小字。官方文档对它的要求其实很明确。Google 在《面向 Web 开发者的 SEO 指南》里写:
确保每个页面都有描述性的标题和元描述。唯一的标题和元描述能帮助 Google 向用户展示你的页面如何切题,进而可能提升你的搜索流量。
必应站长指南说得更重,直接把它和索引可靠性挂钩:
标题标签和元描述缺失、重复或过短,可能降低索引可靠性、排名,以及被用于生成式结果和引用的资格。
体检发现:四十篇文章的描述全都在同一个位置被硬生生切断。
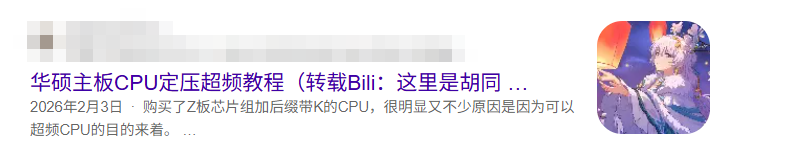
比如某篇文章的描述结尾停在「……玄戒(Xring)是小」,另一篇停在「……使用 IPv4+IPv6 双栈」,甚至有一篇的结尾直接是内核版本号。
为什么会这样
我当时用的是 Slim SEO 这款插件,就去翻了它的取值逻辑,发现它取描述有三级优先级:
- 你手写进 SEO 字段的描述
- 文章摘要
- 正文的前 160 个字符
那四十篇文章既没手写描述、也没设摘要,于是插件只能去截正文。截出来的东西自然一塌糊涂——先截到正文的第一个小标题(比如「前言」「一、引言」),然后在第 160 个字符处腰斩。
对照一下官方那两条要求,问题就很清楚了:机器截出来的描述既不唯一(大量文章的开头都是「前言」,相当于同一段模板),也谈不上描述性(末尾是半句话)。必应那条"过短/重复会降低索引可靠性",说的就是这种状态。
这不是插件故障,是内容缺口。
怎么修
给这四十篇手写描述,规则定死:
- 长度控制在 110–160 字
- 末尾必须是完整句子
- 开头直接进主题,不能拿「前言」这种小标题凑数
- 严格基于正文事实,不编造参数和结论
写描述这件事没法偷懒。我是一篇一篇读正文,提炼出核心内容再写的。不过有个好处:写的过程本身也是重新审视文章结构,有几篇自己都觉得开头写得拖沓。
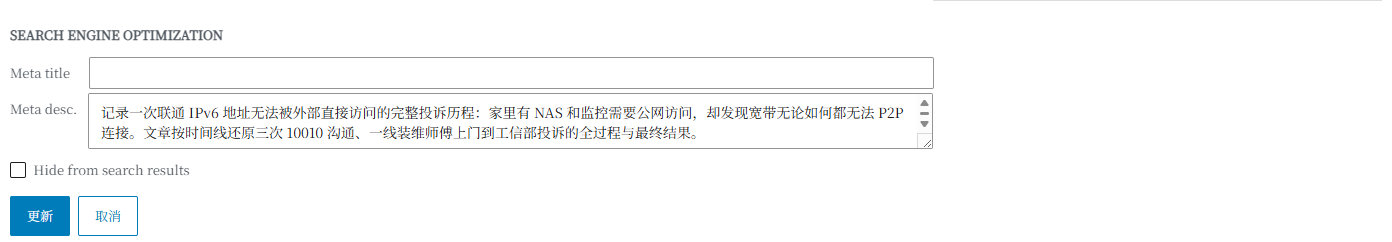
顺便说清一件事:我不会跟你说"描述写好了排名就会涨"。官方文档里没有这个承诺——Google 只把它定位成搜索结果里的一段说明文字。它真正影响的是用户点不点你,而这恰好是你还能控制的部分。
全站零标签,到三十个标签
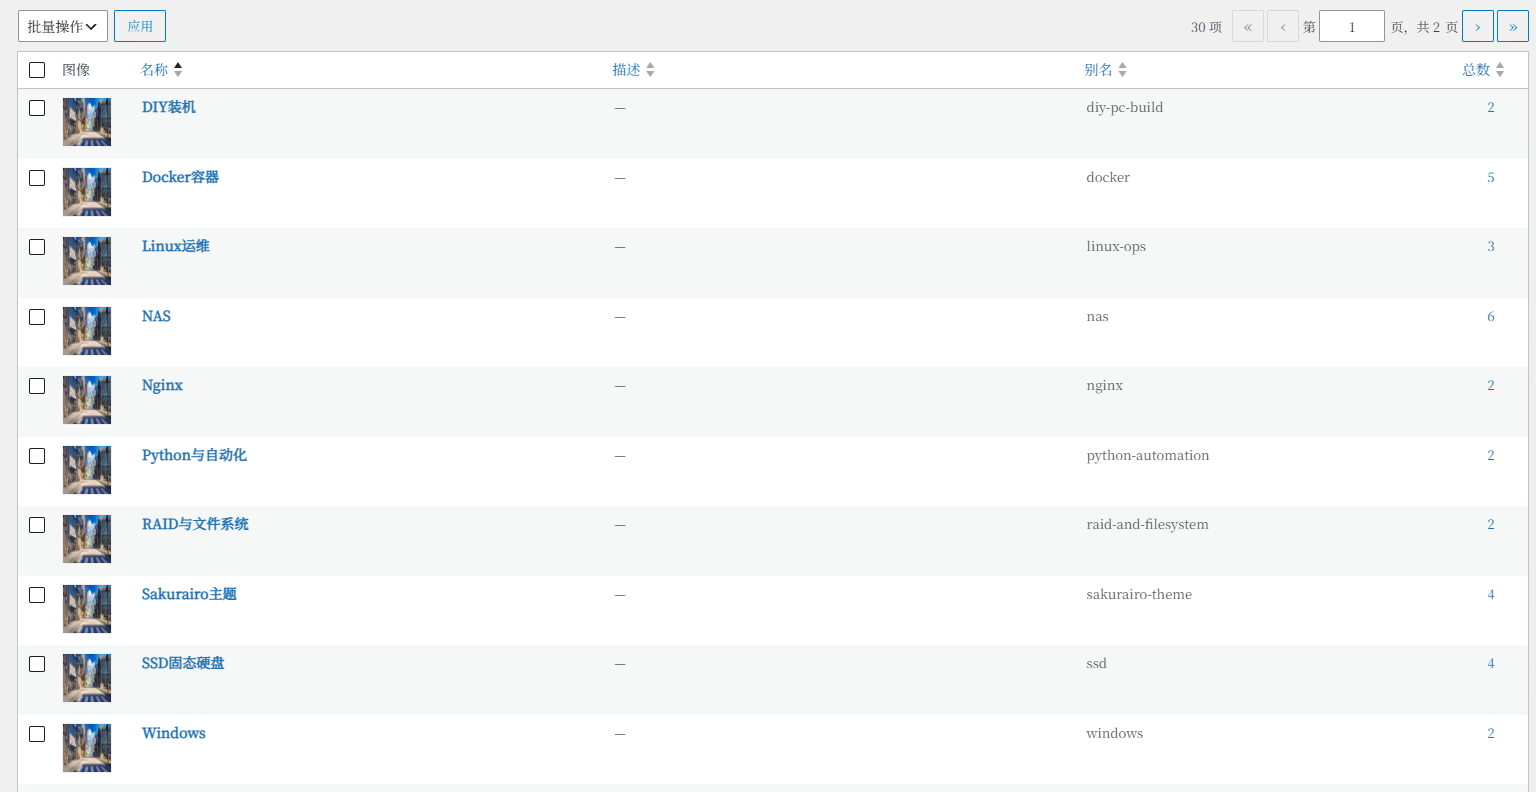
体检时还发现一个更意外的:全站一个标签都没有。
文章只挂了六个分类。分类是粗粒度导航,一篇讲「光猫拆解」的文章,和一篇讲「NAS 存储」的文章,会被扔进同一个「技术实践」分类里——搜索引擎看不出它们之间的关系。
标签到底是干嘛的
这里先澄清一个常见误解:标签不是关键词。
<meta name="keywords"> 这个 HTML 标签主流搜索引擎早就不参考了,这是事实。但 WordPress 的「标签」是另一回事——它是一个内容分类法(taxonomy),和「分类目录」同级别。
它不参与关键词匹配,它解决的是内容之间的关系:
- 内链结构:挂上标签后,每篇文章自动多出一条通往同主题文章的链接路径
- 主题聚类:搜索引擎判断「这个站在某个领域有没有成体系的内容」,看的是页面之间的链接关系,靠标签能把这些关系显性化
- 归档页:标签页本身可以当长尾落地页(但前提是内容够厚)
一个关键决策:标签页要不要索引
建完三十个标签后,有个选择题:标签归档页要不要让搜索引擎收录?
我的选择是不收录(noindex)。
理由很简单:文章还少,三十个标签里平均每个只有四篇左右,最少的只有两篇。这些归档页结构几乎一样,只是一列标题——典型的薄内容页面。
这不是我一个人的洁癖,官方文档里写得很清楚。Google 在《控制你分享给搜索的内容》这份文档里,专门为这种情况留了一段:
隐藏那些对你的受众价值较低的内容……允许这类内容被索引,可能对你的站点在 Google 搜索结果中的排名产生负面影响。
必应站长指南则从两个方向说了同一件事:
单薄的、堆广告的、或纯联盟内容的 URL,可能失去排名资格和可见性。
过多的低价值 URL、重复内容或抓取浪费,会直接限制索引、延迟发现,并降低重要内容的可见性。
注意后半句——它说的不是"这些页面自己排不上去",而是会拖累重要内容。这才是我把这三十个页面关在索引外的主要原因。
不索引 ≠ 切断
这是最容易搞错的地方。Google 对 noindex 的定义是:
noindex 这条规则告诉 Google 不要索引你的内容、不要让它出现在搜索结果里。你的内容仍然可以被其它网页链接和访问,用户也可以通过链接直接访问。
所以"不收录"和"不许链接"是两件独立的事。我给标签页设的是 noindex, follow:
| 指令 | 作用 |
|---|---|
noindex | 这页别进索引 |
follow | 但页面上的链接照常跟随 |
这样一来,标签页作为内链枢纽的作用完整保留(文章 → 标签 → 同主题文章这条路照走),只是它自己不去抢排名——这才是它该干的活。
那个流传很广的坑:robots.txt
顺便把另一个坑也补上官方依据。很多人以为"不想被收录就在 robots.txt 里 Disallow",Google 在开发者文档里明确否定了这种做法:
robots.txt 不是让网页从 Google 中消失的机制。 要让网页从 Google 中消失,请使用 noindex 规则,或者给页面加密码。
原因不复杂:robots.txt 挡住的是抓取。爬虫压根没抓到页面,自然也就看不到页面里的 noindex 标签——于是可能出现"你不想收录,它反而因为你没明说不收录而收录了"的尴尬结果。
Google 甚至在 2019 年的一篇官方博客里宣布,已经彻底停止支持 robots.txt 里的 noindex 规则——也就是说,你在 robots.txt 里写 noindex: /tag/,Google 根本不认。
同类做法官方也给过先例。在电商分页的最佳做法里,Google 建议:
为避免同一份列表的不同变体被索引,用 noindex 把这些不需要的 URL 排除出索引(也可以用 robots.txt 减少对特定 URL 模式的抓取)。
说的就是归档、筛选这类"同一批内容的另一种排列"。
什么时候可以把标签放出来
不是永远 noindex,是攒够了再放。我的标准是三条同时满足:
- 该标签积累到 8–10 篇以上文章
- 能为它写一段 100 字以上的独立描述(不是自动生成的)
- 该页面有实质内容,不只是一列标题
内链:主题没有的功能,自己写了个插件
标签解决了「文章之间的间接连接」,但还有一个更直接的问题:文章页之间没有互相推荐。
我看了一下主题(Sakurairo),它没有内置「相关文章」功能。装插件也不行——当时没法给站点装新插件。
官方对内链的态度比我以为的重
在动手之前,我先把官方文档关于链接的部分看了一遍,结果发现这件事的分量比我原本估计的高得多。
Google 在《链接最佳做法》里开篇就写:
Google 把链接当作判断页面相关性、以及发现新页面的信号。
开发者 SEO 指南则把"能被找到"写成了硬要求:
确保站点上每个页面,都能通过另一个可找到的页面上的链接到达。
必应站长指南也是同一个逻辑:
确保每个重要 URL 都能通过可抓取的内部链接到达。
强的内部和外部链接,有助于发现、权威性评估和引用资格。
而最具体的是锚文本这块,Google 直接给了正反例:
好的锚文本是描述性的、合理简短的,并且与你所在页面和所指向的页面都相关。
反例:
Click here to learn more/Read more/Learn more提示:试着只看锚文本本身(脱离上下文),检查它是否足够具体到能独立表达意思。
这三条基本决定了我后面插件该怎么写——锚文本必须有信息量,所以那三条内链用的都是目标文章的标题,而不是「阅读更多」。
于是走了条笨路
先把相关文章的块直接写进正文。
算法很简单:共享标签数 × 2 + 同分类 × 1,算分排序取前三条。效果还行,五十八篇文章每篇都能关联到同主题文章。
但这个方案有硬伤:它是静态的。写进正文就是死的——以后发了新文章,不会自动参与关联;想改规则,得把五十八篇全部重写一遍。
干脆写个插件
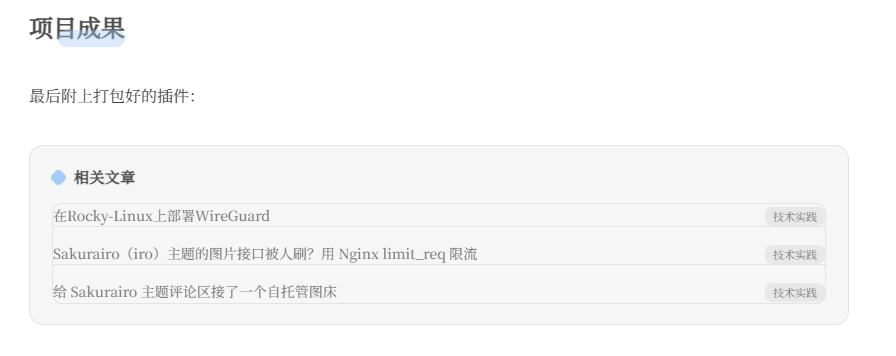
既然迟早要正规化,就自己做了一个插件,纯动态计算:
- 不碰数据库:
post_content一个字节都不改,每次访问实时算 - 新文章自动参与:发布后自动进关联池
- 后台可调:匹配权重、显示条数、插入位置都能改
- 带诊断工具:输入文章 ID,能看到它匹配到了哪几篇、各共享了几个标签和分类
实现上有两个细节是照着官方文档来的。一是必须输出真正的链接:
一般来说,只有当链接是一个带
href属性的 HTML 元素时,Google 才能抓取它。
用 JavaScript 事件模拟的"链接"不算数。所以插件输出的是标准 <a href>,不去玩花活。
二是锚文本用文章标题,天然满足那句"脱离上下文也能看懂"。
写完之后才发现一个性能坑。
第一版排序要按发布时间取 get_post_time(),而查候选文章时用了 fields => ids 参数——这个参数会让 WordPress 跳过 post 缓存预热。结果就是:候选池六十篇,光这一步就是六十次数据库查询。
站点小、数据库在本地,实测响应时间看着正常,功能上完全没暴露出来。但这是写法问题,查询次数会随文章数线性增长——以后文章多了就会难看。
修法是把候选文章一次性批量预热(_prime_post_caches),之后取标题、链接、时间全部走缓存。
Google 的开发者指南里有一句要求是"确保你的站点安全、快速、对所有人可访问"。速度这件事在设计阶段就得想,等它暴露出来通常已经晚了。
这个坑值得单独说一句:性能问题在数据量小的时候是测不出来的,只能靠代码逻辑判断。
一百四十九张图片的描述
图片的 alt 属性,写好了能带来图片搜索流量,写不好可能被判定作弊。
体检发现正文里有一百六十张图片的 alt 是空的,或者干脆写着「Image」这种占位符。
官方对这件事的表述很具体。Google 在链接文档里说:
当图片作为链接时,Google 会把
img元素的alt属性当作锚文本来用,所以务必给图片加上描述性的 alt 文本。
在《搜索要素》里,alt 更新和标题、正文标题、链接文字并列:
使用用户会用来搜索内容的词,并把这些词放在页面上显眼的位置——比如标题、主标题,以及 alt 文字、链接文字这类描述性位置。
必应强调的是另一面:别用图替代文字。
图片和视频应该强化页面上的主要文字,而不该是理解主题所需的唯一信息来源。为了支持理解(而不是替代文字),请提供:描述性文件名、alt 文本、说明文字或结构化数据。
这些必须一张一张看图
alt 的作用是「图片加载不出来时,用文字告诉用户这里是什么」。所以:
- 内容图(教程截图、产品特写)→ 必须描述具体内容
- 装饰图(分割线、纯图标)→ 正确做法是留空,硬塞关键词反而可能被判定作弊
那到底哪些是内容图、哪些是装饰图?只能一张张看图判断,没法靠文件名猜。
我最后处理了一百四十九张,每张都下载下来、看清楚内容再写描述。比如某篇安装教程里的二十几张截图,分别是键盘布局选择界面、LVM 卷组大小设置、镜像站点列表……这些描述只有看过图才写得准。
过程中的额外发现
看图的时候发现,有几篇文章的图片直接是 404——文件在服务器上已经不存在了。
顺藤摸瓜查下去:这些图片全部集中在某两个月份的目录里,而那些目录整个都不在了。基本可以确定是站点迁移时旧附件没搬过来,但正文还指着旧地址。
这类「裂图」比缺 alt 严重得多。Google 在移动优先索引的最佳做法里,专门把"重要图片缺失"和"重要图片被 robots.txt 挡住"列为常见错误——图片抓不到,图片搜索这条流量入口就直接没了,更不用说读者的阅读体验。
清点下来一共一百多张,集中在四篇文章里。这种问题只能靠补图或者改写正文来解决。
一次误判,值得记下来
体检时我用工具查「站点装了哪些 SEO 插件」,工具返回:「未检测到任何 SEO 插件」。
我差点就按这个结论去建议装插件了。但多留了个心眼,直接抓了页面渲染后的 HTML 复核——插件装着,而且工作得好好的:meta description、Open Graph、canonical、结构化数据、sitemap 全都有。
原来那个工具只识别几款主流的 SEO 插件,不认我用这款,所以对所有文章都误报成「没装」。
这一节我想引一句官方提醒,它是写给所有站长的。Google 在生成式 AI 搜索优化指南里说:
警惕那些承诺排名成功、或声称使用 Google「内部」指标的第三方工具。没有任何第三方工具能访问我们的内部排名系统或 AI 系统。 如果这些工具有用就用,但一定要对照官方文档来评估它们的建议。
读到这句的时候我挺有共鸣——我踩的那个坑,本质上就是信了工具,没去对官方文档。
还有一句也值得记着,来自《搜索要素》:
仅仅因为一个页面满足了所有这些要求和建议,并不意味着 Google 就会抓取、索引或展示它的内容。
反过来理解:官方给的是一组"必要条件",不是"保证"。所以下面才需要自己做验收,而不是改完就宣布成功。
教训:工具会骗人,尤其是「检测类」的工具。凡是下「缺失」「不存在」这种结论,都要换个方式反向验证一次。
一次标题长度的修复,卡在一个开关上
体检发现十四篇文章的 <title> 太长。
搜索结果里标题的显示宽度是有限的,超出部分会被截断成「……」——用户看不到完整标题。我按常用的参考值(约 60 个宽度单位、中文约 30 个字)来卡线。
这里要说清楚:在我翻的这几份官方文档里,都没有给出"标题必须控制在多少个字符"的硬性规定。 官方对标题的要求集中在两件事上——唯一,以及切题。Google 在《搜索要素》里写:
使用用户会用来搜索内容的词,并把这些词放在页面上显眼的位置,比如标题和主标题……
必应那句"标题标签缺失、重复或过短可能降低索引可靠性"是从反面说的。
所以长度本身不是官方红线,它是呈现问题。但呈现问题会直接影响点击——一半的标题被省略号吃掉,等于白写。
标准做法不管用
按理说,给每篇文章单独写一个 SEO 标题就行了(SEO 标题可以和文章标题不一样,只影响搜索结果里的显示)。我按这个方式写进去,结果页面标题纹丝不动。
排查了一圈:
- 用带随机参数的方式绕缓存重试 → 没变
- 确认值确实存进数据库了 → 存进去了
- 检查 OG 标签有没有跟着变 → 没跟着变
- 读主题源码确认有没有硬编码标题 → 没有
最后找到原因
原来是插件里有一个功能开关列表,其中一项是「Meta title」。这个功能被关掉了。
关掉之后的表现很迷惑:写 SEO 标题完全不生效,页面标题退回系统默认格式,但描述、OG 这些功能全都正常——「描述能改、标题改不动」,就是这个状态的特征。
把那个开关打开,十四条标题一次性写入,全部生效。
顺带说个细节:插件生成的「带站点名后缀」的标题,和手写的「不带后缀」的标题,在后台列表里会显得不统一。这不是 bug——手写的 SEO 标题本来就原样使用不追加站点名。想统一的话,改一下标题模板就行,和每篇单独写不冲突。
最后一件事:回归验收
改完这么多东西,最怕的是捡了芝麻丢了西瓜——修好了小问题,却把原有的 SEO 结构搞坏了。
必应站长指南里有一段,基本就是我这次验收清单的原型:
最佳实践:清除重复或低价值 URL;一致地使用 canonical;让站点结构保持逻辑清晰、可访问……
重复的 URL 会稀释信号,降低必应选择某个 URL 的置信度。
所以我把"结构有没有变坏"拆成了十几项可测量的指标——不是因为勤快,而是因为官方本来就是按这些维度理解站点的。
| 检查项 | 结果 |
|---|---|
robots.txt | 正常,没有误屏蔽 |
sitemap 与索引状态一致性 | 六十多个 URL 里,没有一个 noindex 页面混进 sitemap |
| 各页面状态码 | 全部正常,不存在的 URL 是真 404 |
| 索引控制 | 该收录的收录、该 noindex 的 noindex |
| 标题、描述唯一性 | 无重复、无缺失 |
canonical / OG 标签 | 全部齐全 |
| 正文 HTML 完整性 | 改过 alt 的文章,标签全部配平 |
| 页面体积 | 平均增加 2.4 KB(内链块的体积),约 2.3% |
| 响应时间 | 与改动前持平,没有退化 |
结论是没改坏。 十二项结构指标全部通过,而且基础层比之前更干净了。
小结
几点体会:
- 先体检,再动手。 凭感觉优化,大概率是在解决不存在的问题。而且要用爬虫视角——你自己看到的页面,和搜索引擎看到的可能不是一回事。
- 内容缺口比技术配置重要。 描述、标签、内链这些「内容层」的东西,才是官方文档里反复强调的部分。技术配置是地基,但地基不会让你排名靠前。
- 薄内容页面不要放出去。 官方文档说得很直白:低价值页面被索引,可能对整站排名产生负面影响。与其让三十个空荡荡的归档页进索引,不如设成
noindex, follow。 - noindex 不是 nofollow。 官方对 noindex 的定义里明确说了"内容仍可被链接和访问"——理解清楚这一点,才知道关掉索引不等于砍掉内链。
- robots.txt 管不了收录。 它管的是抓取。想不收录就用 noindex,别用 Disallow 绕远路,那样反而可能适得其反。
- 工具会骗人。 官方甚至专门提醒过这件事。检测类工具的结论,尤其是「没有 / 不存在」这种,一定要反向验证。
- 性能问题在小站点测不出来。 查询放大这种写法,数据量小的时候完全正常,得靠代码逻辑判断。
- 改完要回归验收。 改的东西越多,越要确认没把原有的结构搞坏。
最后想补一段官方文档里我印象最深的话。Google 在生成式 AI 搜索优化指南里,把内容分成了两类:
大路货内容(commodity content,比如「首次买房的 7 个建议」)通常基于常识,谁都能写,对读者几乎没有独特价值。而另一类内容(non-commodity content)提供的,是超出常识的、独特的专家或亲身经验视角。
提供独特的视角:一手评测基于个人经验,能提供独特视角;而现有内容的摘要,只是复述别处已有的信息。
看完这段我明白了一件事:这轮优化里真正有效的部分,其实都不是"优化",而是把只有我能提供的东西说清楚——那几十张自己拆机拍的照片、自己踩过的坑、自己跑出来的数据。
写描述之所以写得成,是因为我真的读过那些正文;写 alt 之所以写得准,是因为我真的看过那些图。这些活没法外包给工具,也没法靠"关键词布局"替代。
官方文档从头到尾没教我怎么"讨好算法",它只是反复在讲一件事:让搜索引擎能准确理解你的页面上有什么。 剩下的功夫,还得花在内容本身。
参考资料
文中引用的官方文档(均为公开文档,可直接检索标题查看):
| 文档 | 出处 |
|---|---|
| Search Essentials(搜索要素,原站长指南) | Google Search Central |
| SEO Guide for Web Developers(面向开发者的 SEO 指南) | Google Search Central |
| Link best practices(链接最佳做法) | Google Search Central |
| Control the Content You Share on Search(控制分享给搜索的内容) | Google Search Central |
| Make your links crawlable / Robots 相关说明 | Google Search Central |
| A note on unsupported rules in robots.txt(2019) | Google Search Central 官方博客 |
| Pagination best practices(分页最佳做法) | Google Search Central |
| Mobile-first indexing best practices(移动优先索引最佳做法) | Google Search Central |
| Google's Guide to Optimizing for Generative AI Features | Google Search Central |
| Bing Webmaster Guidelines(必应站长指南) | Bing Webmaster Tools 官方帮助 |
说明:以上引用为便于阅读做了中文翻译,关键表述保留原意;建议以官方原文为准。
- 给 Sakurairo 的 H2 高亮条BUG做减法,踩了三个 CSS 的坑Sakurairo主题
- 给 Sakurairo 主题评论区接了一个自托管图床Sakurairo主题
- Slim SEO与Sakurairo主题使用造成SEO冲突Sakurairo主题
Comments NOTHING