
一块 1TB 的 TLC 固态,包装上写着顺序写入 6000MB/s。你从移动硬盘往里拷 200GB 素材,前十几秒确实能跑到 5000 多,之后数字开始往下掉,稳定在 800 上下,有时候只剩三四百。
盘没坏,温度也不高,这属于正常现象。但“正常”得有个解释。网上一搜,答案通常就三个字:缓存满了。再问一句缓存是什么、在哪、有多大、为什么满了就慢,能说清楚的人不多。因为大家嘴里的“SSD 缓存”其实是好几样东西,混在一起讲,越讲越糊。
如果你遇到过下面这些情况,这篇是写给你的:
- 拷大文件,前几秒飞快,之后速度像被抽掉了,断崖式往下掉
- 新盘测分很漂亮,用了一年再测,写入只剩一个零头
- 盘里还剩一百多 GB,往里写东西却比刚买时慢得多
- 想买盘,被“无缓”“1GB 缓存”“HMB”“nCache”这几个词绕晕
- 拆开看过 M.2,主控旁边有一颗小芯片,不知道是干什么的
下面先讲清 NAND 的存储原理,再回过头拆缓存。不然后面全是玄学。只想看结论和选购建议的,可以直接跳到最后一节。
先把“缓存”这个词拆开
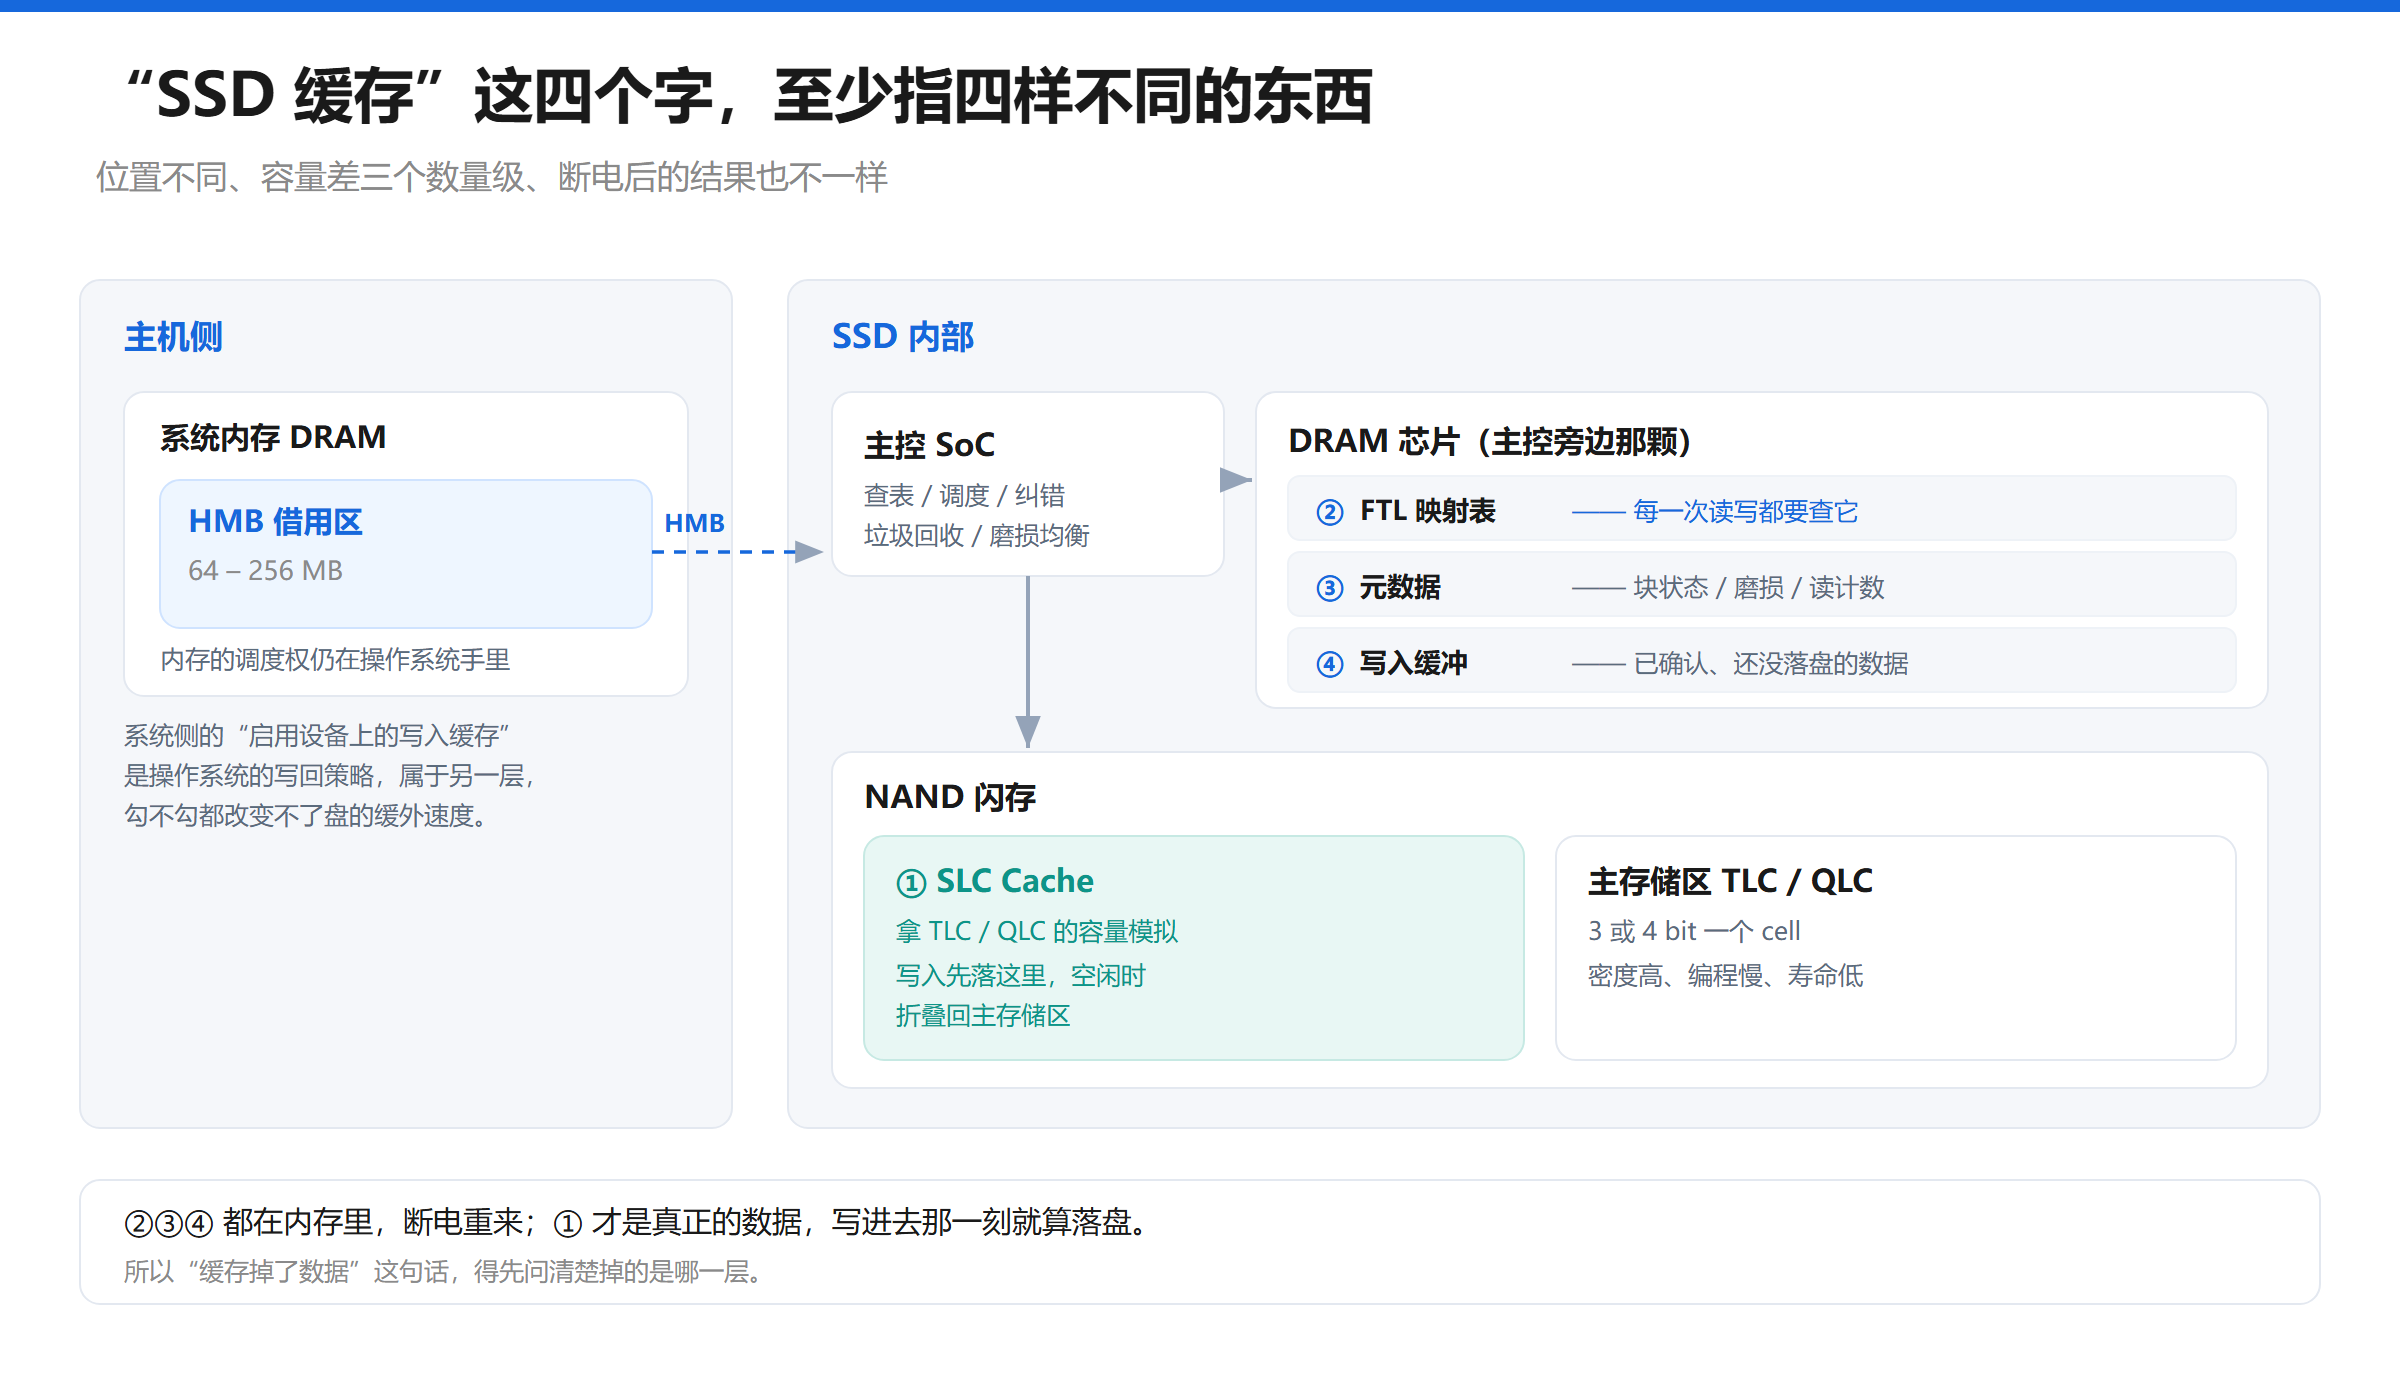
SSD 里被叫成缓存的东西,至少有四种。位置、容量、断电后的结果都不一样。
| 名字 | 在哪 | 装什么 | 典型容量 | 断电后果 |
|---|---|---|---|---|
| SLC Cache | NAND 闪存里 | 用户数据本身 | 几 GB 到全盘的三分之一 | 没有,已经落盘 |
| FTL 映射表缓存 | 主控外挂 DRAM,或向主机借的内存 | 逻辑地址到物理地址的对照表 | 每 1TB 容量约 1GB,或 64 – 256MB | 要从 NAND 日志重建 |
| 元数据缓存 | 同上 | 块状态、有效页计数、磨损计数、读计数 | 随固件设定 | 后台策略重算 |
| 主机写缓冲 | 同上 | 已接收但还没落盘的数据 | 受掉电保护电容的能量限制 | 未落盘的数据丢失 |
表里最要紧的是第一行和后面三行的区别。SLC Cache 是唯一一个把数据真正存下来的缓存,其余三种都在内存里,断电重来一遍。
还有一个容易混进来的东西:Windows 设备属性里那个“启用设备上的写入缓存”。那是操作系统的写回策略,属于另一层,勾不勾都改变不了 SSD 的缓外速度。往下讲的全是盘内部的机制。
SSD 存储原理
机械硬盘靠磁畴的取向记数据,固态靠的是电子。NAND 的每个存储单元叫 cell,本质是一个能困住电子的晶体管。往里注入多少电子,决定了它的阈值电压;读的时候加一个参考电压,看它导不导通,电子的量就翻译成了 0 和 1。
一个 cell 能存几个 bit,就是 SLC、MLC、TLC、QLC 的分野。1、2、3、4 bit,对应 2、4、8、16 个电压档位。档位越多,同样面积存得越多,代价后面细说。
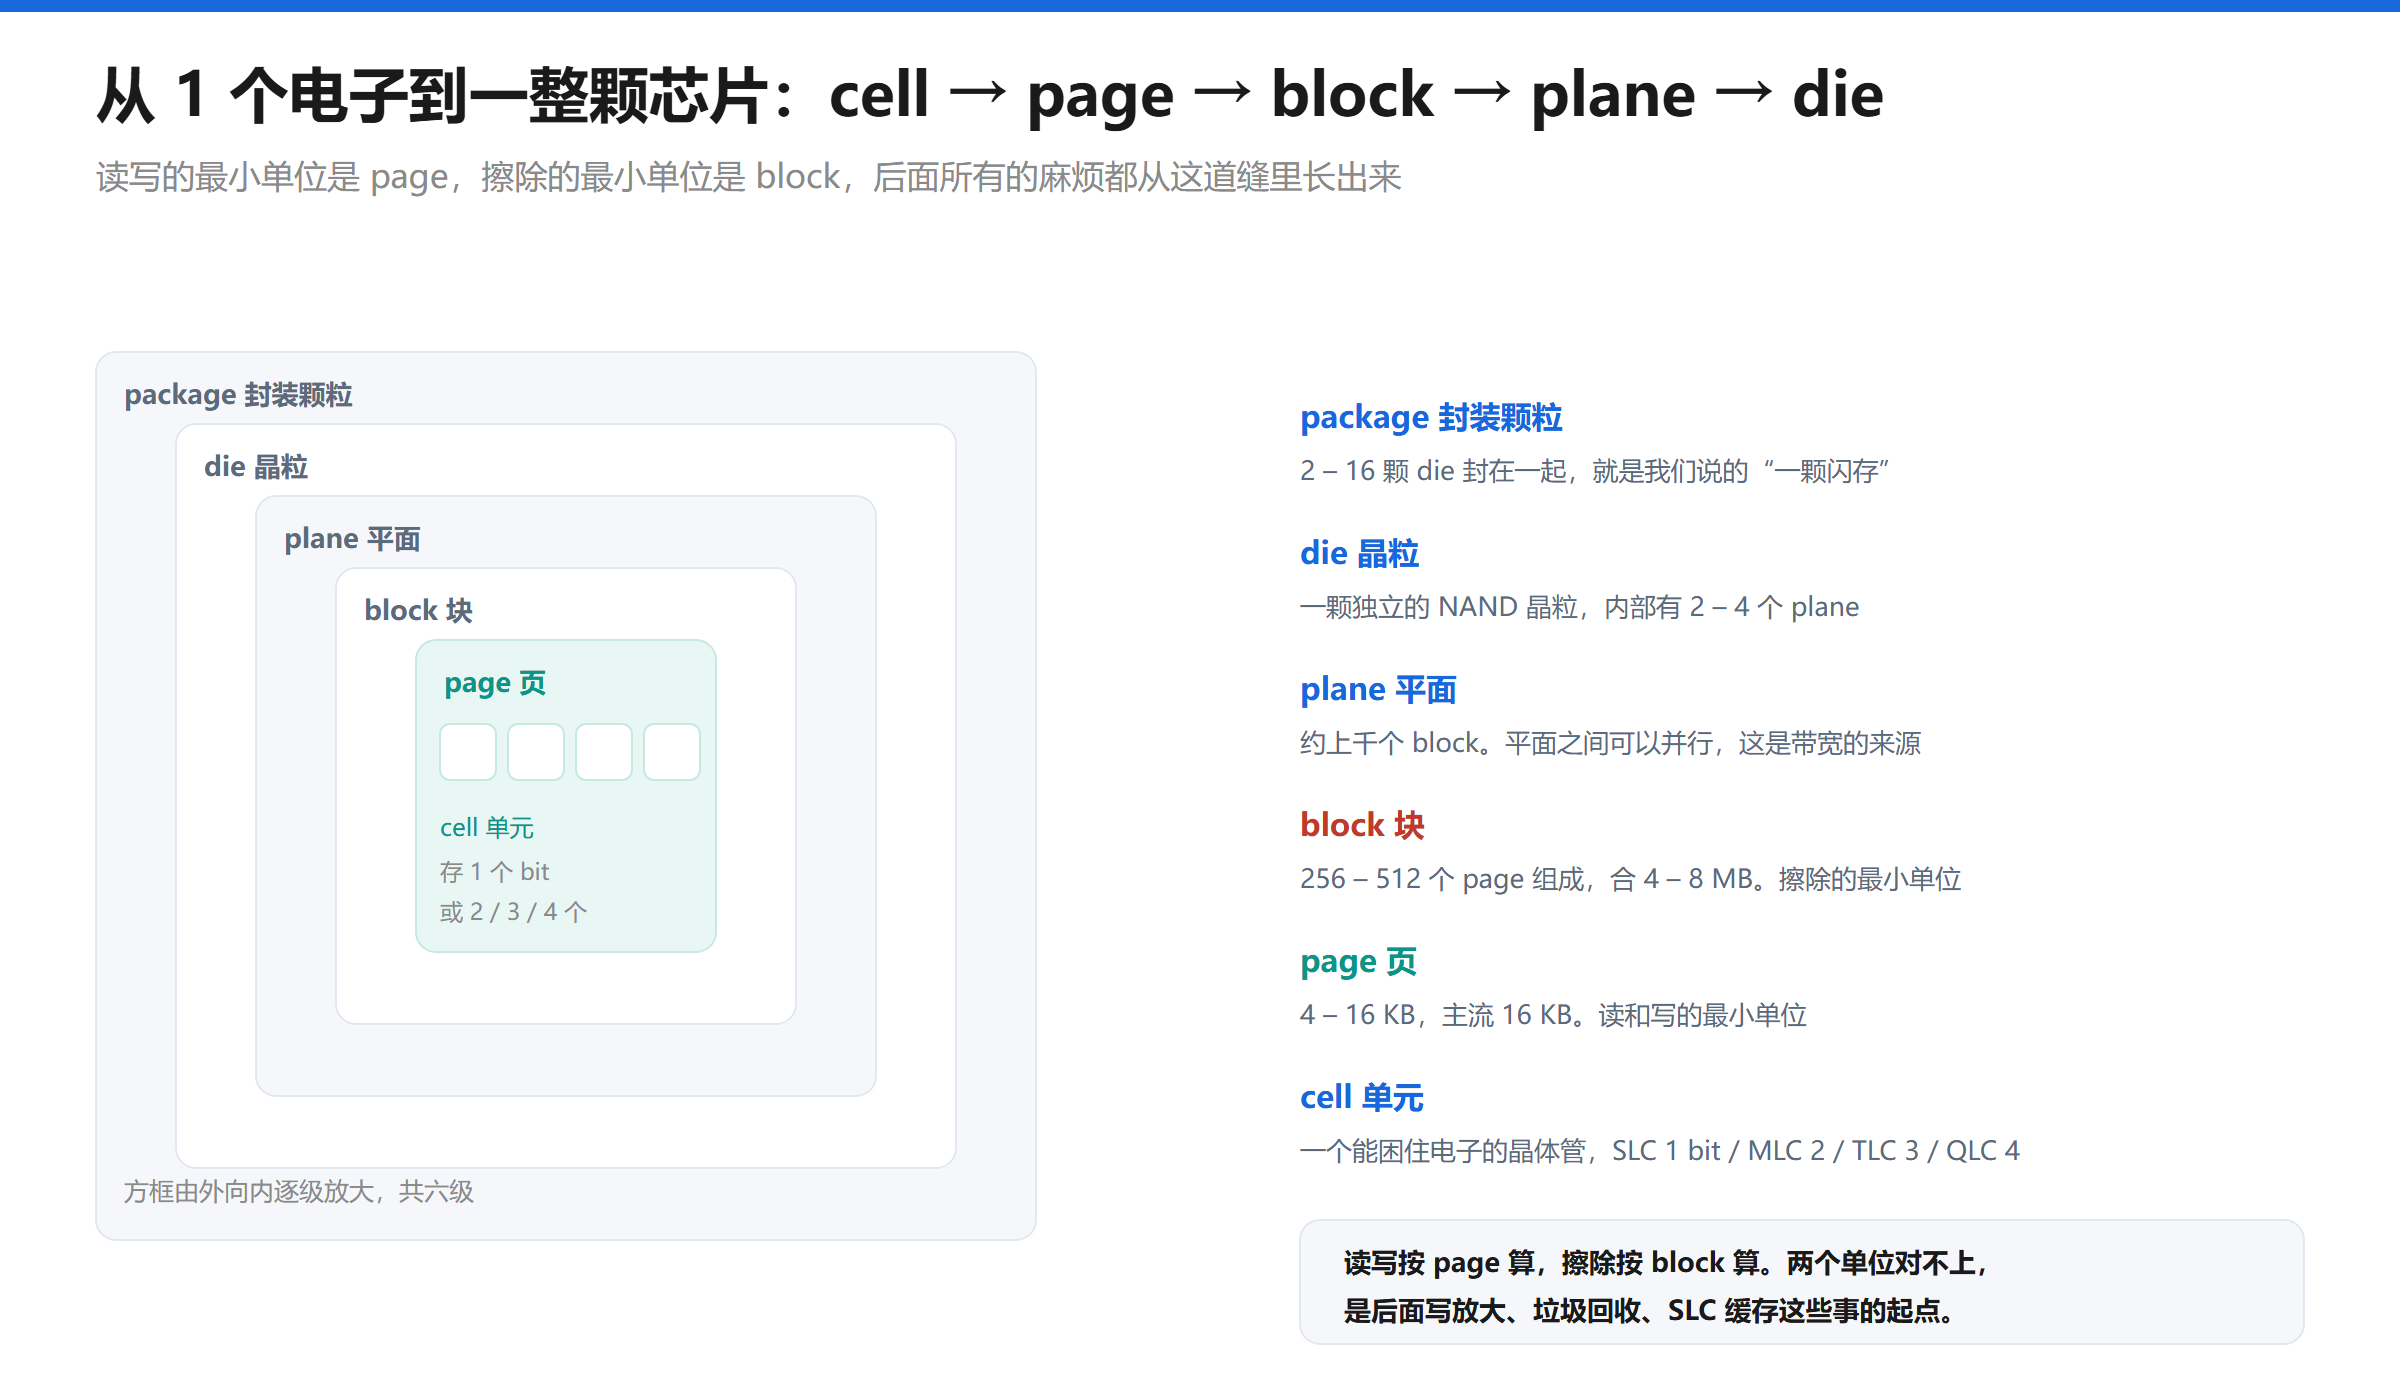
存储结构:cell、page、block、plane、die
一个 cell 之上,是一层层的组织结构:
- page(页):读写的最小单位。现在主流 16KB,也有 4KB 到 8KB 的。控制器下一条读命令,拿回来的是一整个 page。
- block(块):256 到 512 个 page 组成一块,合 4MB 到 8MB。block 是擦除的最小单位,这个限制是后面所有麻烦的起点。
- plane(平面):一块 die 里切出 2 到 4 个 plane,可以各自独立执行命令。
- die(晶粒):一颗独立的 NAND 晶粒,内部包含若干 plane。
- package(封装):我们说的“一颗闪存颗粒”,里面装 2 到 16 个 die。
这层关系不是名词游戏。单颗 die 的带宽其实很有限,SSD 主控有一半功夫花在“怎么把命令摊到不同的 die 和 plane 上并行执行”。顺序读能跑满 PCIe 4.0 的 7000MB/s,靠的不是某颗颗粒快,是几十颗并起来。
读、写、擦除,三个单位不一样
把三个操作的单位摆在一起,就能看出 NAND 别扭在哪:
- 读:以 page 为单位,16KB 起步。即使你存储了1KB大小的数据,读取数据也要一起读出来。
- 写(编程,program):也是 page 为单位。最小的写入单位,写入数据以此为单位。
- 擦除:只能以 block 为单位,一擦就是几 MB。如果你删除了数据,那么这附近的数据需要全部擦除重写。
更要命的是第二条约束:已经写进 0 的 cell,不能单独写回 1。要改数据,只能整块擦掉重来。所以“覆盖写一条 4KB 的数据”,物理上根本不是改掉那 4KB,而是走一遍这样的流程:
- 找一块空闲页,把新数据写进去
- 把映射关系指到新页
- 老页标记为无效。数据还在物理上,但不会再有人读它
- 等空闲块不够用了,主控挑一个垃圾最多的块,把里面还有效的页搬到别处,再整块擦掉。这一步叫垃圾回收(Garbage Collection,GC)
不同厂家的流程算法可能不一样,但是都是要遵循这一套原则。
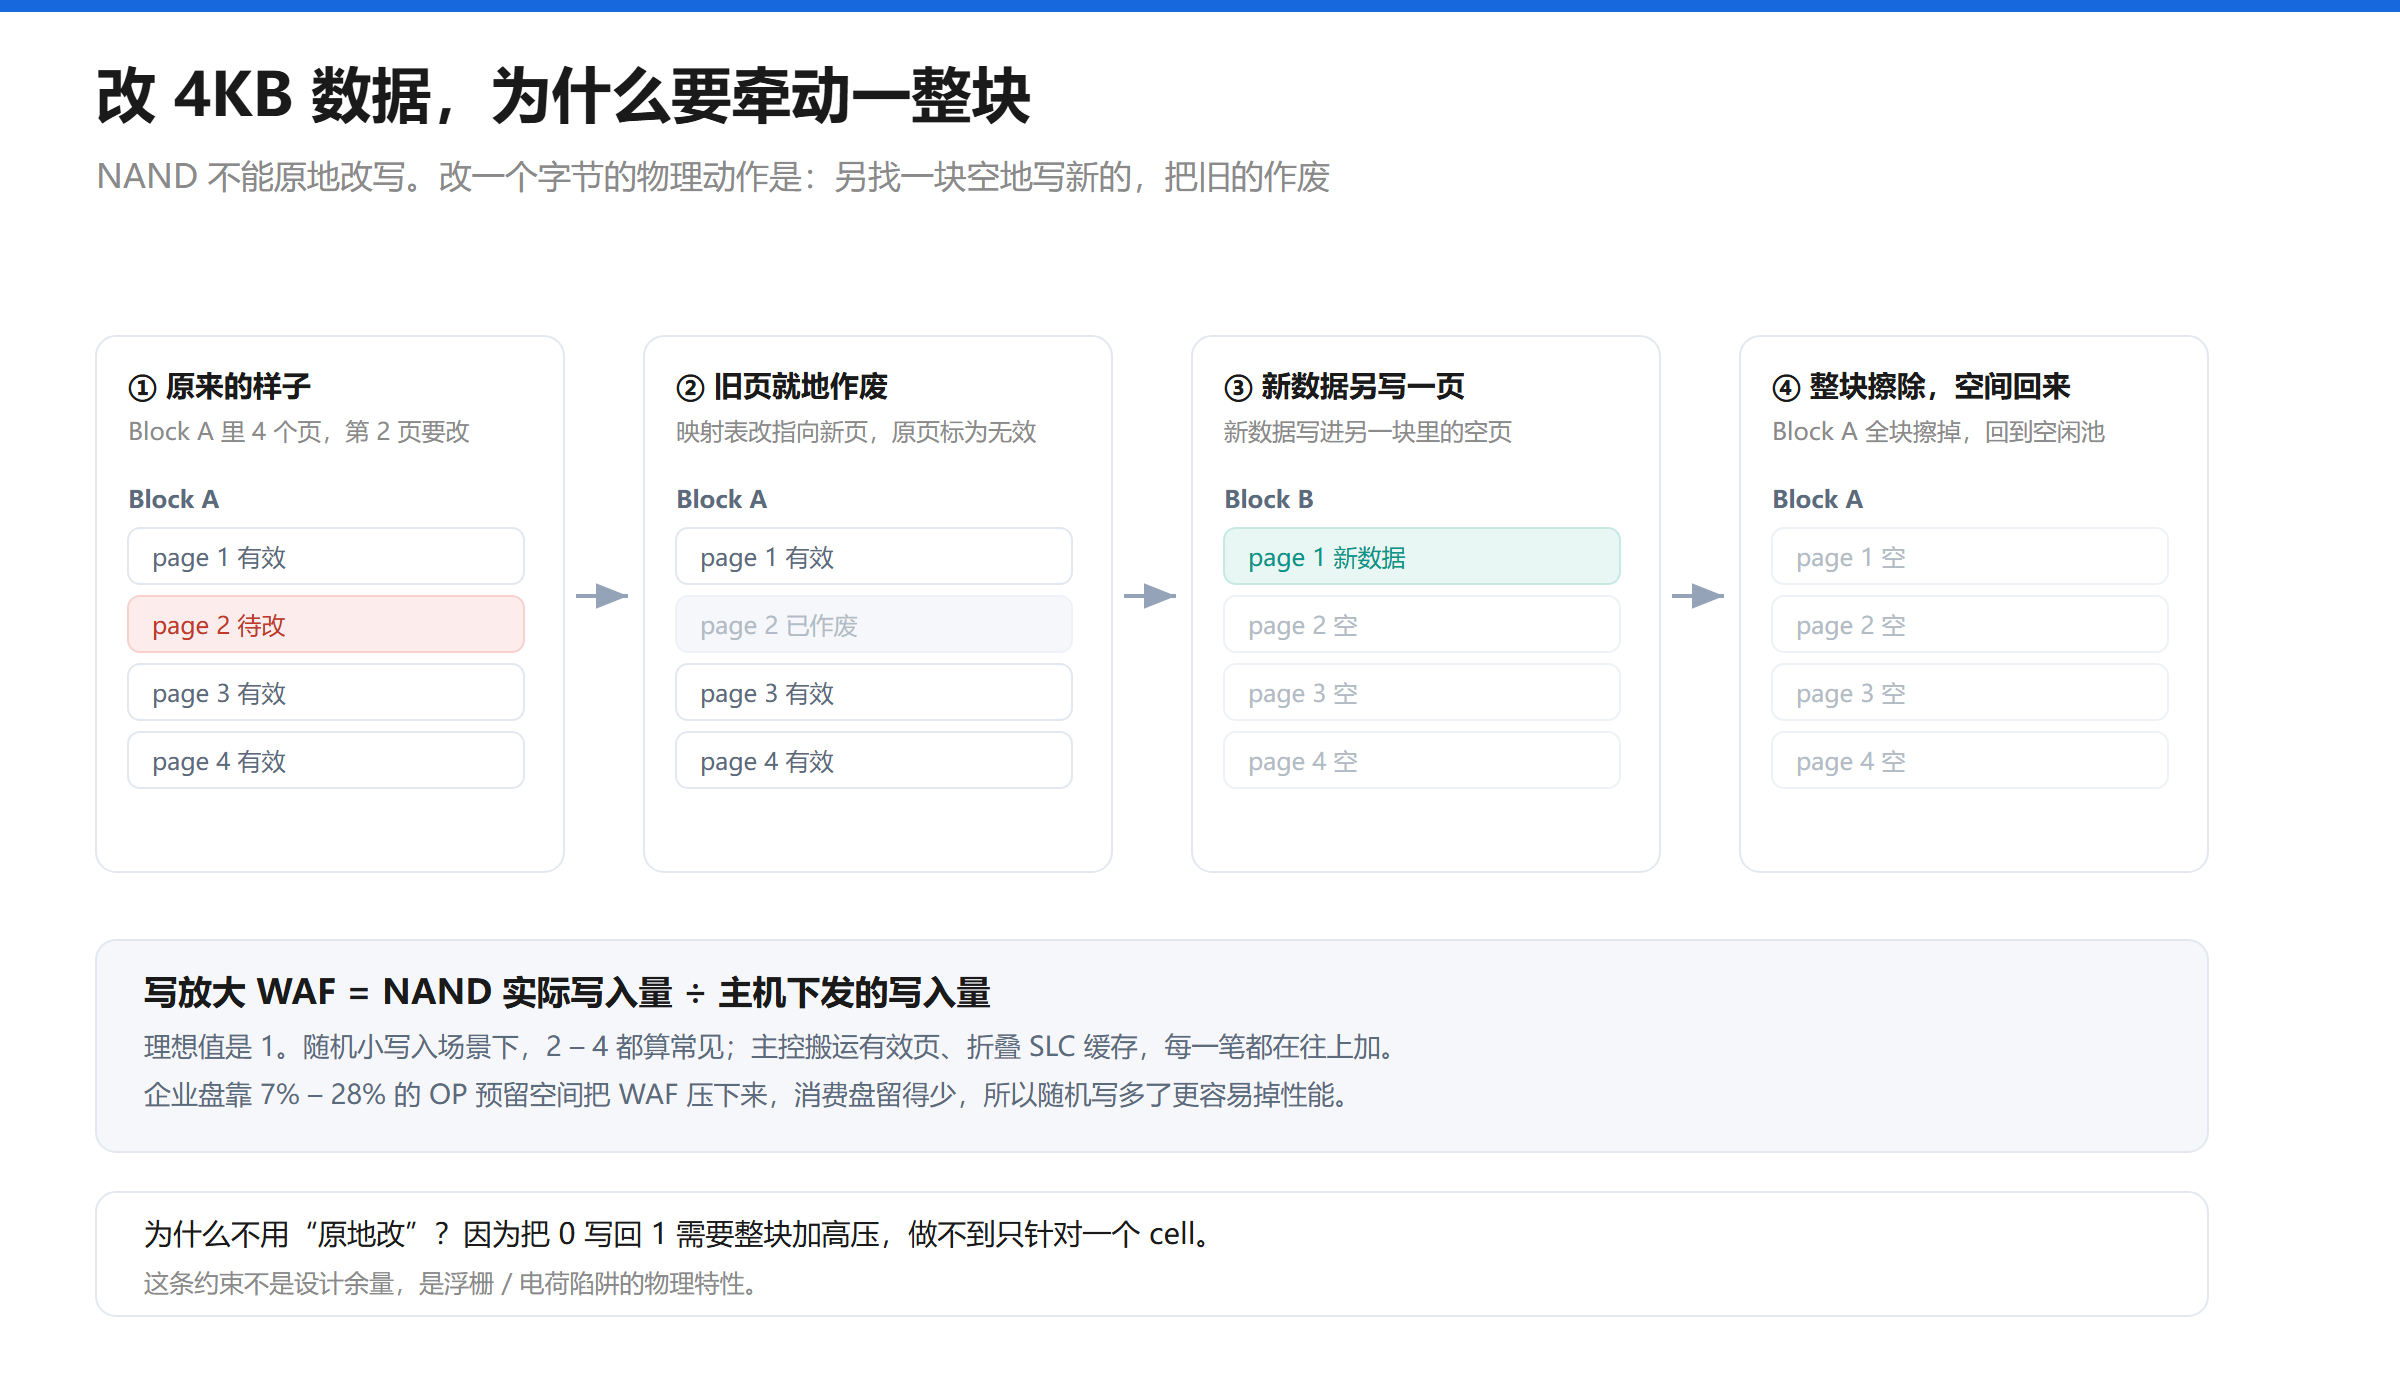
改写所造成的搬运产生的额外写入就是写放大,公式很直白:
WAF = NAND 实际写入量 ÷ 主机下发的写入量
理想值是 1。实际随机写场景里,2 到 4 都算常见。企业盘靠 7% 到 28% 的 OP 预留空间把它压下来,消费盘预留得少,所以随机写一多,性能就更容易掉。
顺带可以验算一下 TBW。一块 1TB、标称 600TBW 的 TLC 盘,600 次全盘写入配上 1.5 到 3 倍的写放大,每个块的擦写次数落在 900 到 1800 次之间,而 TLC 的预算是 1000 到 3000 次。数字对得上,说明厂家标 TBW 的时候已经把写放大算进去了。
行-列激活:一次读慢在哪
网上有种说法,SSD 读数据要“先激活行再激活列”,所以有延迟。方向没错,但中间还有四道动作。
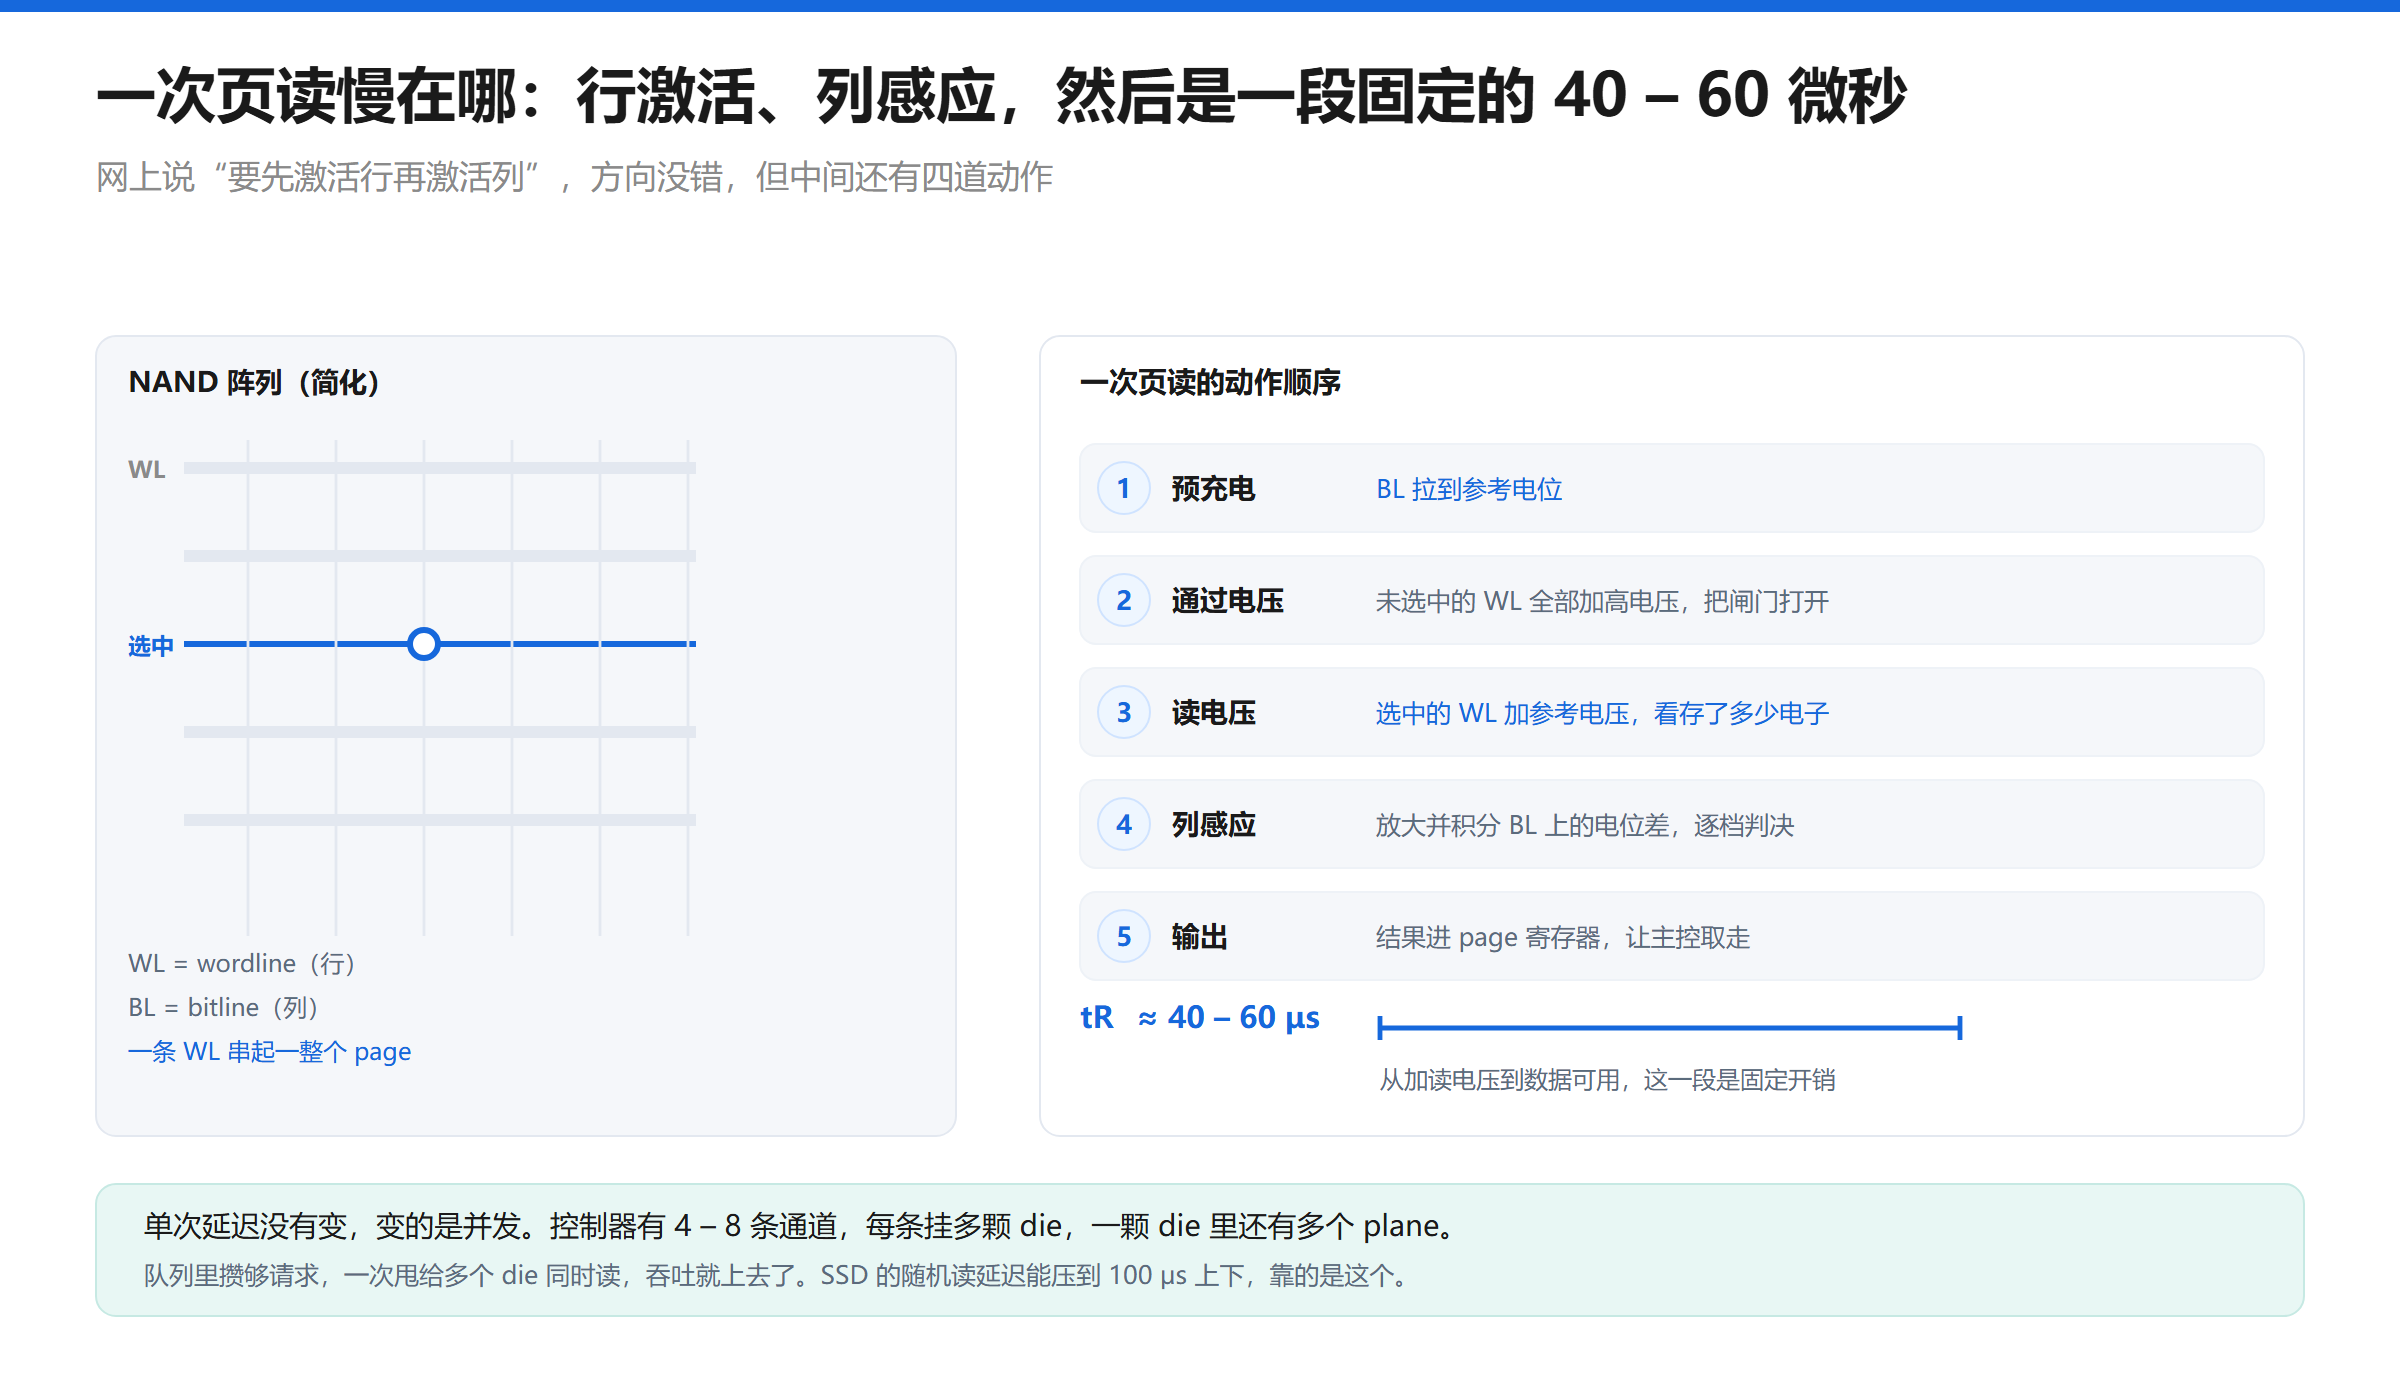
NAND 阵列里,一条 wordline 横着串起一整个 page 的 cell,一条 bitline 竖着把一列 cell 接到感应放大器上。读一个 page 的完整流程是:
- 位线预充电到参考电位
- 没被选中的 wordline 全部加一个足够高的通过电压,让那些 cell 无论存了什么都能导通,相当于把闸门打开
- 被选中的 wordline 加上读电压,存的电子多,导通得就少
- 位线电位随之变化,感应放大器积分、判决,确定这一格落在哪个档位
- 结果搬进 page 寄存器,再由控制器取走
从加读电压到数据可用,这段时间叫 tR,主流 TLC 在 40 到 60 微秒之间。作为对照,DRAM 完成同类动作只要几十纳秒,差了三个数量级。
但 SSD 的随机读延迟通常只有 80 到 100 微秒,并不是每次都老老实实等完 50 微秒。原因在并行:控制器有 4 到 8 条通道,每条通道挂多颗 die,一颗 die 里还有多个 plane。队列里攒够请求,一次甩给多个 die 同时读,单次延迟没变,吞吐量上去了。这就是单队列和多队列的区别,企业级主控拥有更多的通道,能够一次性读取多个die同时读,所以多die能带来吞吐量的优势,但是成本就会增加。
数据老化:电子会跑
非易失不等于永久保存。cell 里的电子靠隧穿氧化层困住,只要时间够长、或者温度够高,就会慢慢漏掉。漏到一定程度,阈值电压漂移,读出来就是错的。
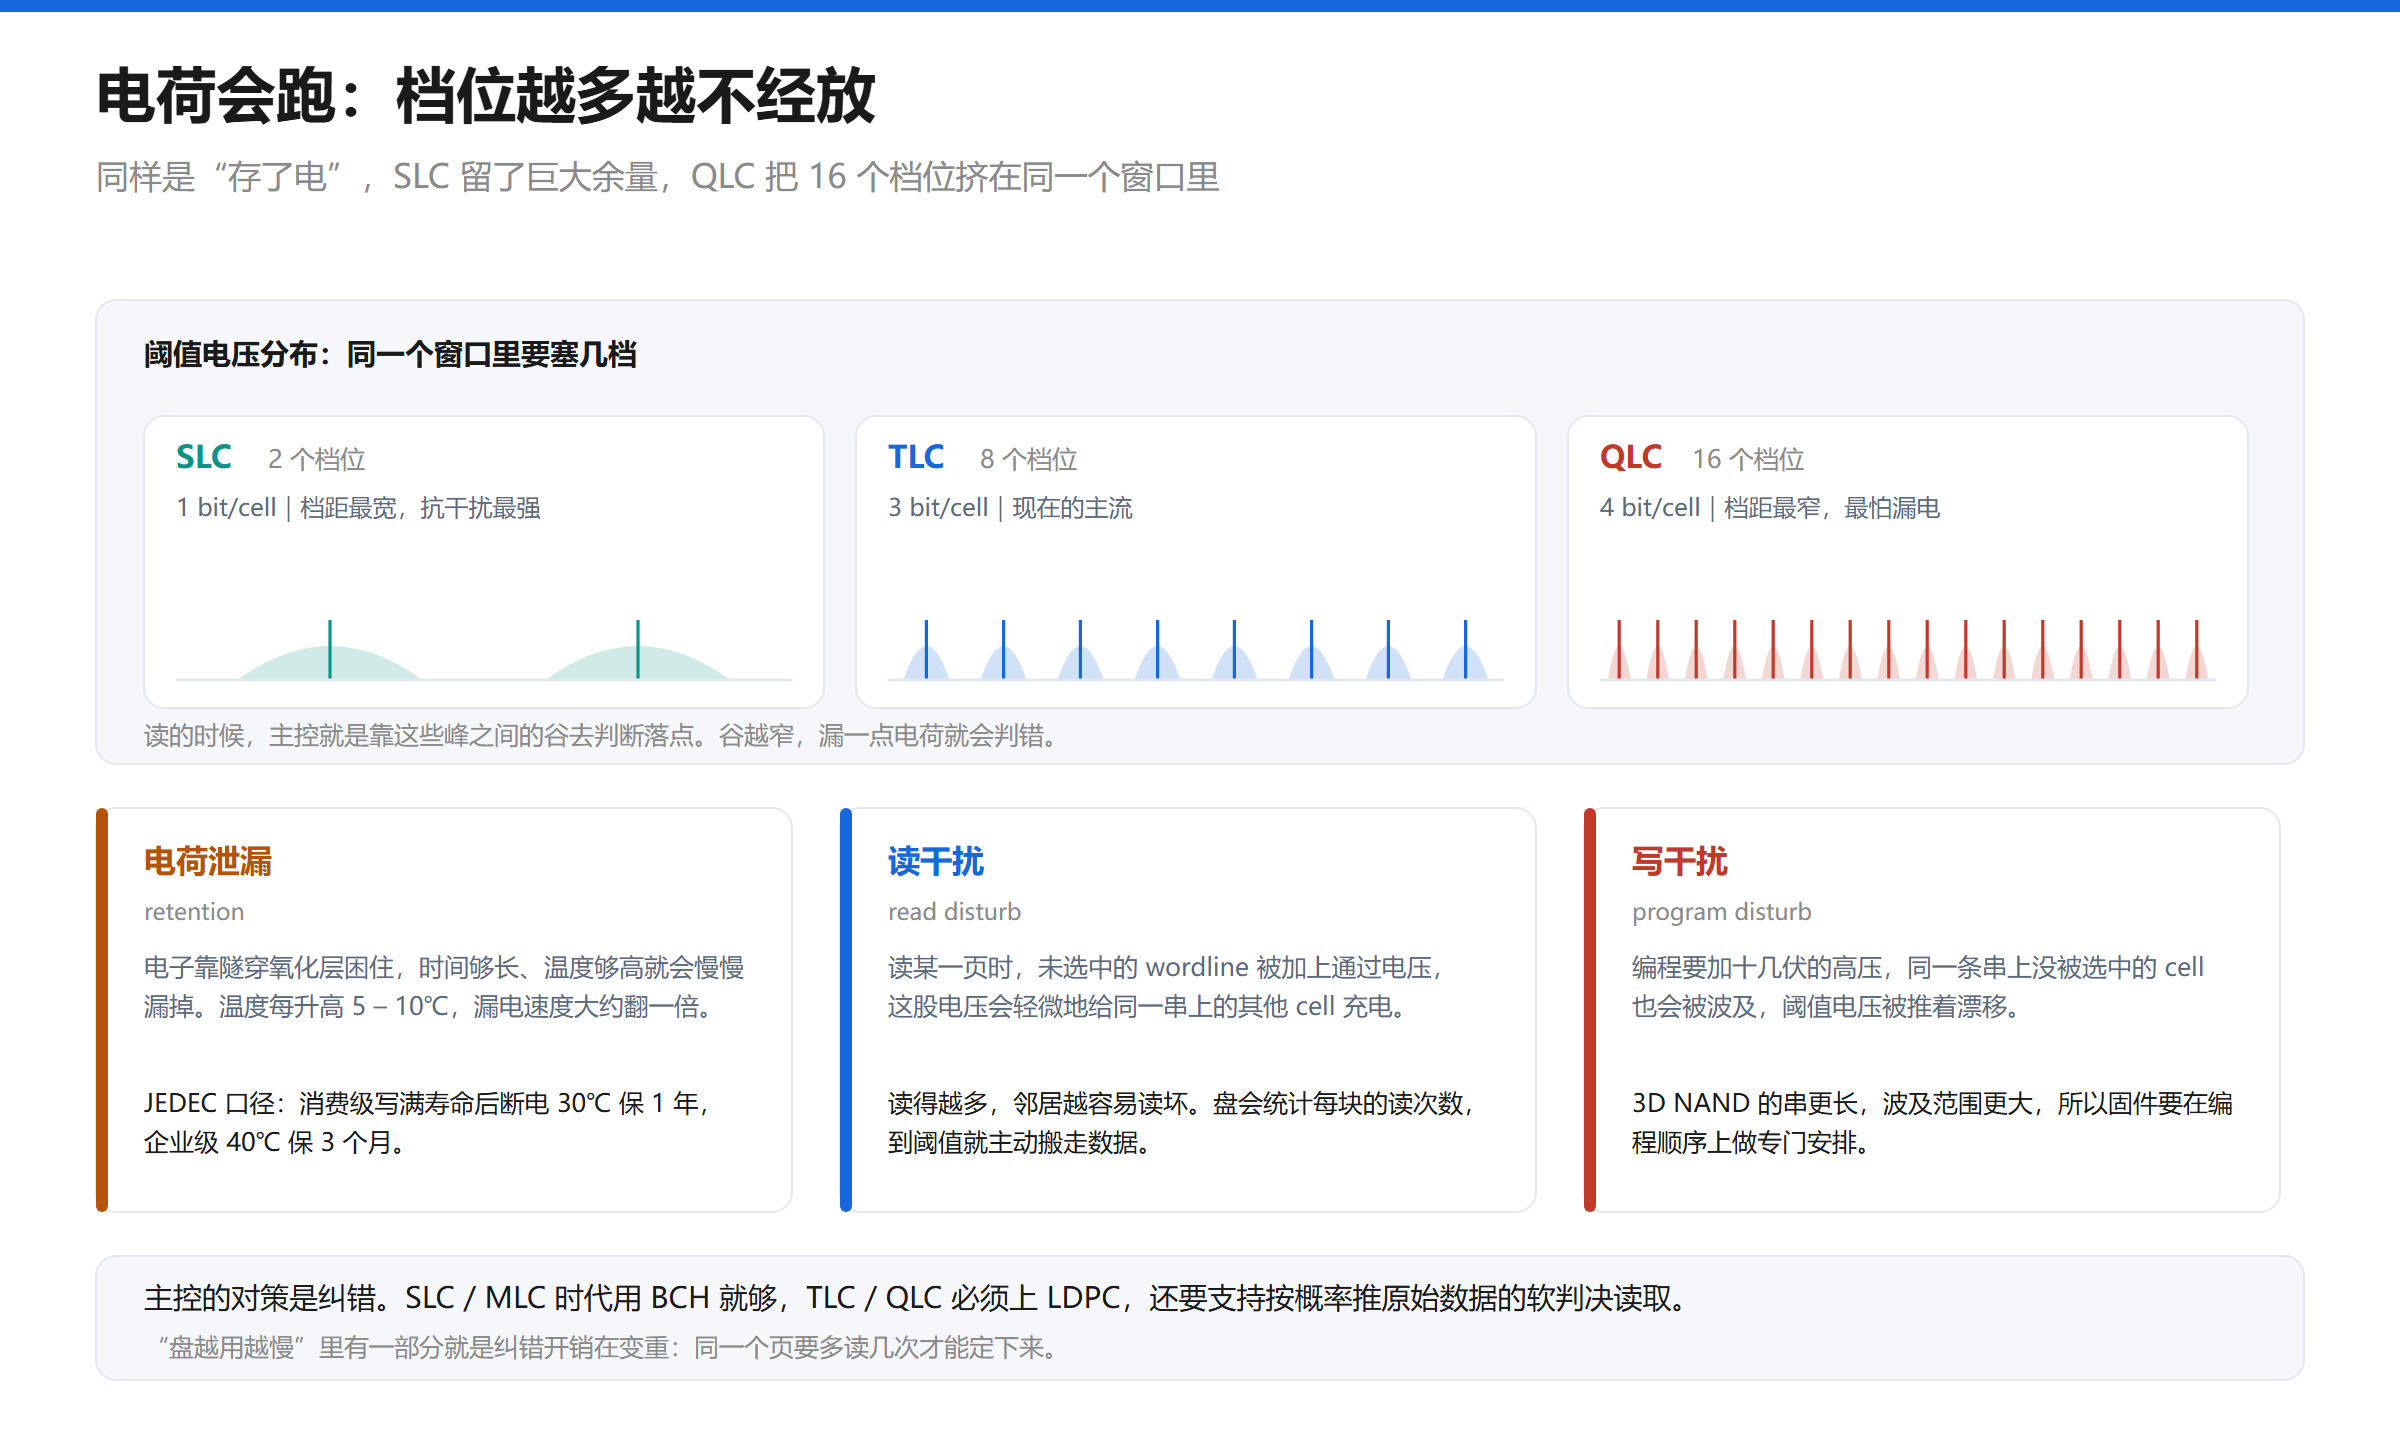
消费级 SSD 的断电保存期,JEDEC 的口径是:写满额定寿命、断电,30℃ 下放一年不出错。企业盘反过来只有 40℃ 三个月,因为它们默认一直通电,用保存期换了耐久度。温度对漏电的影响很大,每升高 5 到 10℃,漏电速度大约翻一倍。
除了自然泄漏,还有两种干扰:
- 读干扰(read disturb):读某一页时,未选中的 wordline 被加上通过电压,这股电压会轻微地给同一串上其他 cell 充电。读得越多,邻居越容易被读坏。所以固件会统计每块的读次数,到阈值就主动把数据搬到新块。
- 写干扰(program disturb):编程要加十几伏的高压,同一条串上没被选中的 cell 也会被波及,阈值电压被推着漂移。3D NAND 的串更长,波及范围更大。
档位越多,抗干扰越差。SLC 只需要分辨“有没有电”两个状态,中间留了巨大余量。QLC 要在同一个窗口里塞 16 个档位,档距被压得很窄,多漏一点电子就可能判错。
主控的对策是纠错。SLC、MLC 时代用 BCH 就够,到 TLC、QLC 必须上 LDPC,还要支持软判决读取:同一个 page 换几个参考电压多读几次,用概率反推原始数据。所谓“盘越用越慢”,一部分就是纠错开销在变重。
FTL 表映射:SSD 的户口本
主机只认逻辑地址(LBA)。操作系统说“读第 12345 号扇区”,它不关心这个扇区物理上躺在那颗 die 的哪个 block 的哪一页。中间的翻译层叫 FTL(Flash Translation Layer),它维护的表叫映射表,L2P。
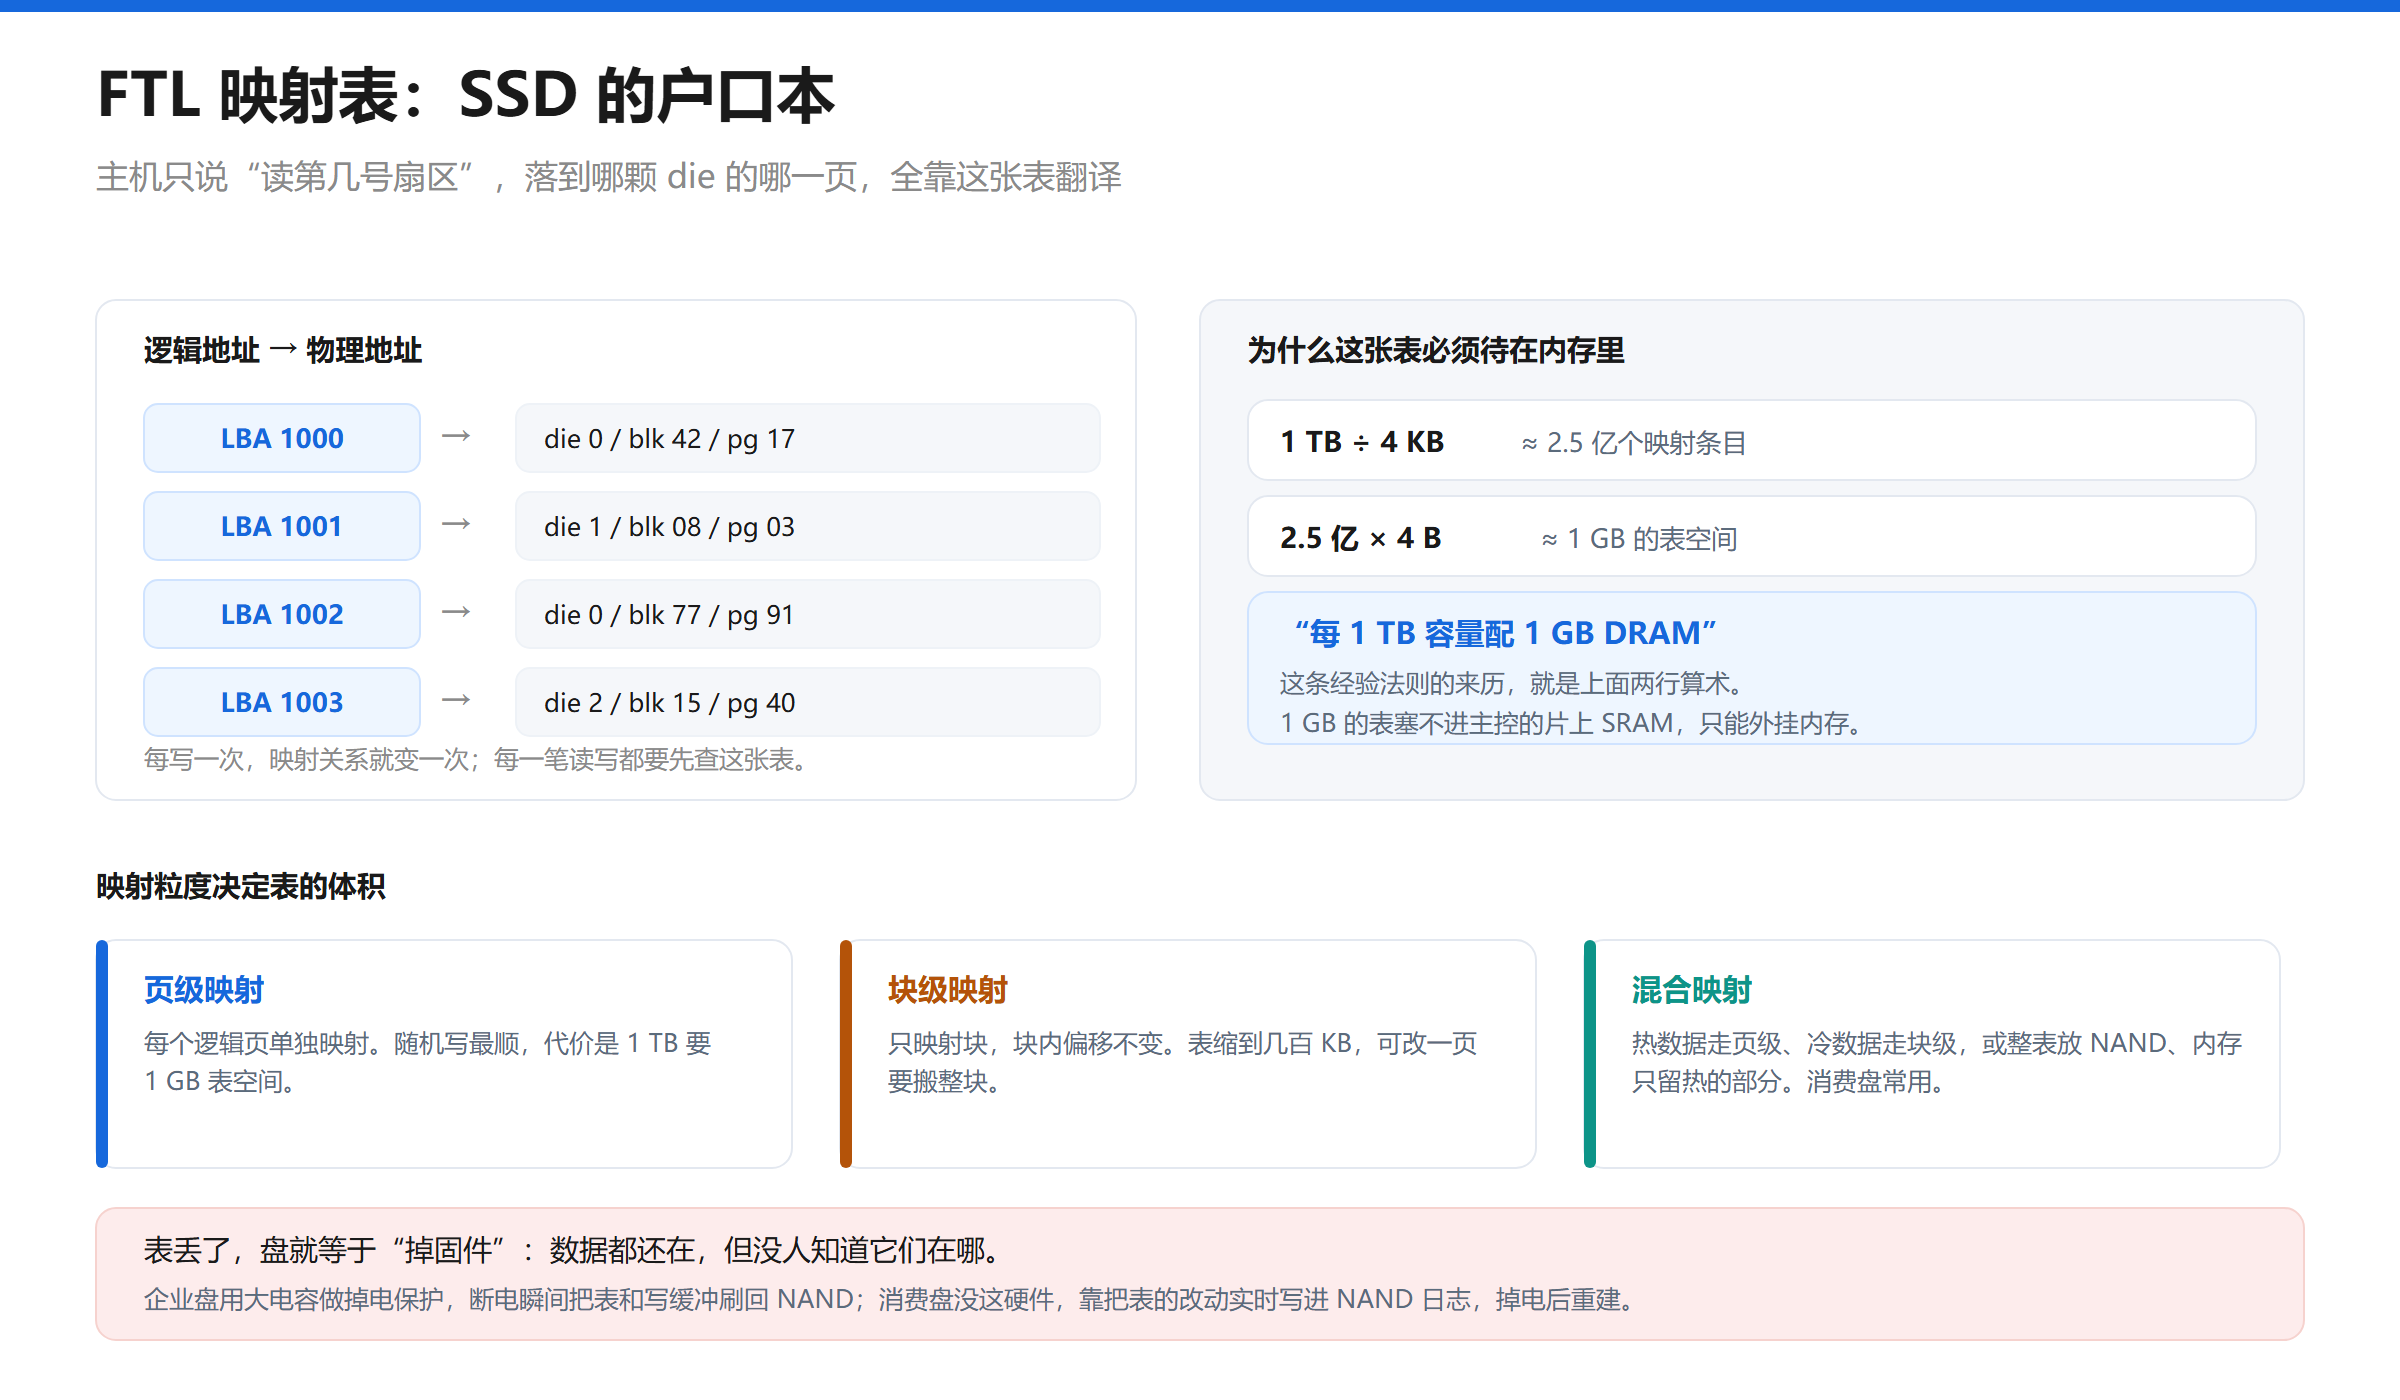
表的体积由映射粒度决定:
- 页级映射:每个逻辑页单独映射到一个物理页。随机写最顺,代价是表极大。1TB 盘按 4KB 粒度算,约 2.5 亿个条目,每条 4 字节,整张表接近 1GB。
- 块级映射:只映射块,块内偏移保持不变。表缩到几百 KB,但改块里一页要搬整块,随机写很难看。
- 混合映射:热数据走页级、冷数据走块级;或者整张表存在 NAND 里,内存只缓存热的那部分(DFTL)。消费级盘的常见做法。
“每 1TB 容量配 1GB DRAM”这条经验法则,就是上面那两行算术推出来的。1GB 的表塞不进主控的片上 SRAM,只能外挂内存芯片。
这张表不是可有可无的索引。它丢了,盘的表现就是“掉固件”:数据都在,但没人知道它们在哪。企业盘用大电容做掉电保护,断电瞬间靠电容里的电把映射表和写缓冲刷回 NAND。消费盘没这套硬件,只能靠固件设计补,比如把映射表的改动实时写进 NAND 的日志区,掉电后重建。这也是为什么盘怕突然断电:最坏的结果不是丢几秒的数据,是表损坏、整盘认不出来。
内存里的缓存:DRAM 与 FTL Cache
回到缓存。内存里的那几样,先看它们都在哪。
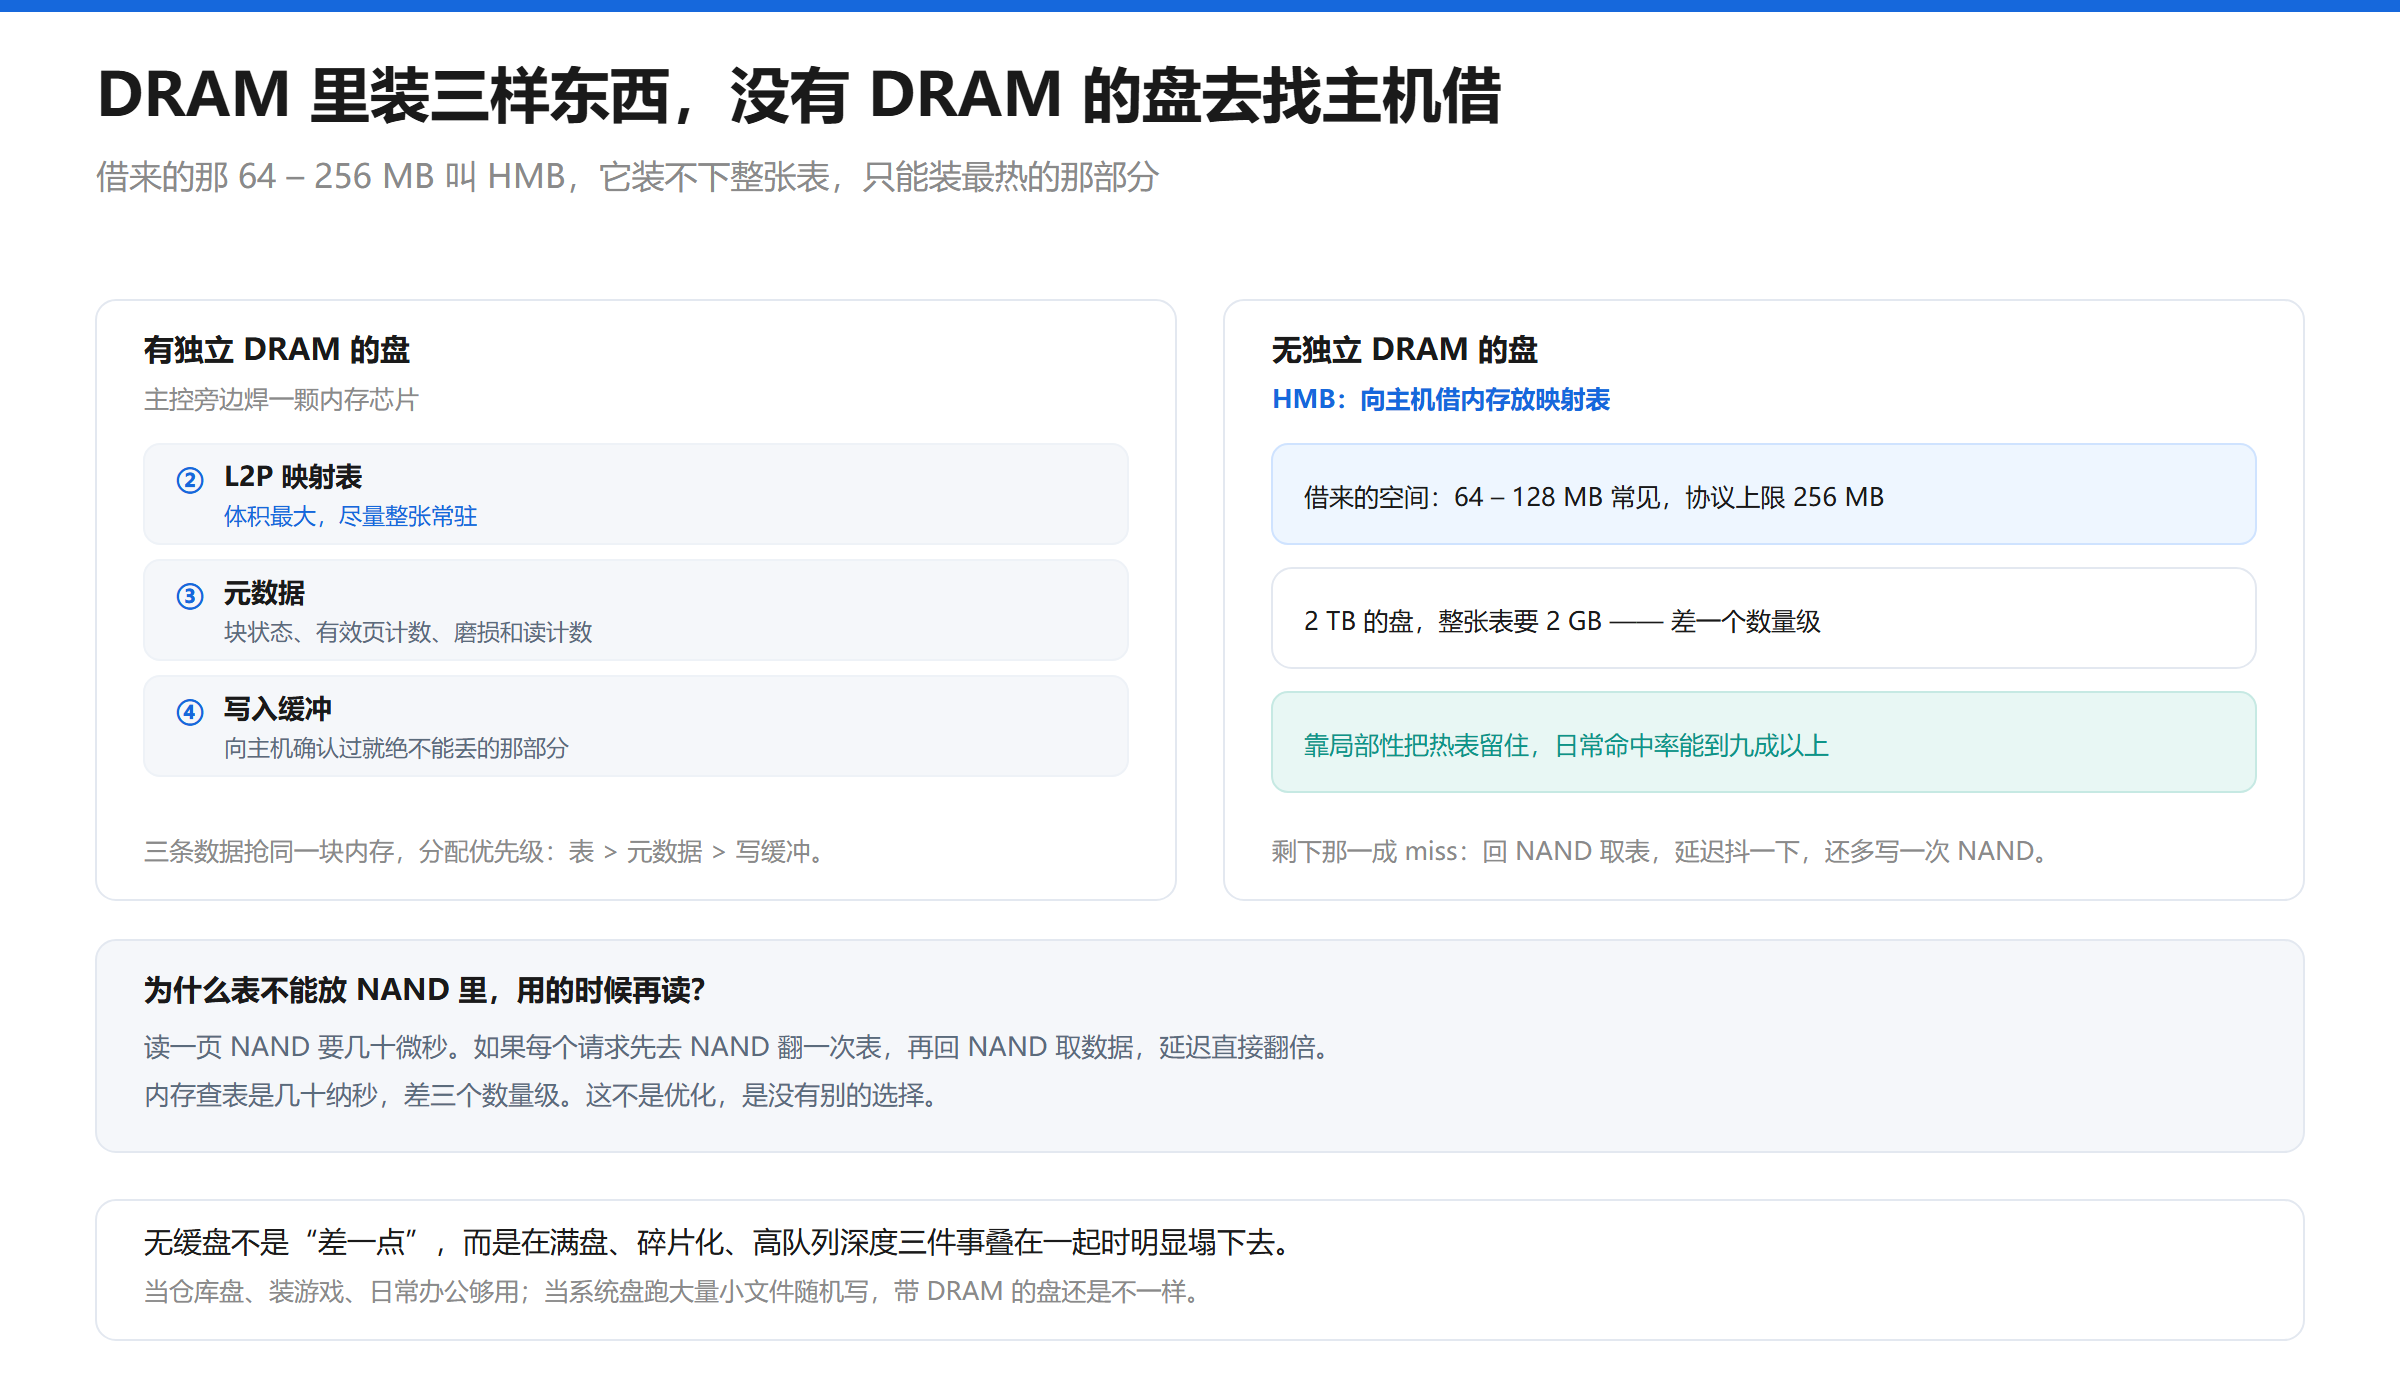
主控旁边那颗 DRAM 芯片,装的是三样东西:L2P 映射表、运行元数据(块状态、有效页计数、磨损和读计数)、以及主机写缓冲。三者抢同一块内存,分不匀的时候优先级是映射表 > 元数据 > 写缓冲。
为什么表非得放内存里?因为查表比取数据还频繁。NAND 读一页要几十微秒,如果每个请求都先去 NAND 翻一次表、再回 NAND 取数据,延迟直接翻倍。内存查表是几十纳秒,差三个数量级。这不是优化选项,是没有别的选择。
有个反直觉的点:写缓冲开多大,主要不是性能问题,是能量问题。带掉电保护的盘,缓冲里所有“已向主机确认”的数据必须在电容放完之前写进 NAND。所以缓冲容量受电容的能量预算限制,不是想开多大就开多大。
那没有 DRAM 的盘怎么办?把内存芯片从 PCB 上省掉,成本、功耗、板面布局都能受益,代价是映射表没地方常驻。NVMe 1.2 之后有个办法:HMB(Host Memory Buffer),向主机借一块内存,常见 64MB 到 128MB,协议上限 256MB。
64MB 装不下 2TB 盘的完整映射表,差着一个数量级。它能正常工作,前提是访问有局部性:刚读过的文件大概率还会再读,读完一个文件大概率会接着读它旁边的数据。缓存里只留最热的那部分映射表页,日常负载下命中率能到九成以上。
剩下那一成的代价是:回 NAND 取映射表页,再读数据,延迟抖一下;同时表的换入换出本身也在写 NAND,多一份磨损。所以无缓盘不是“性能差一点”,是在满盘、碎片化、高队列深度这三件事叠在一起时会明显塌下去。当仓库盘、装游戏、日常办公够用;当系统盘跑大量小文件随机写,带 DRAM 的盘还是不一样。
NAND 里的缓存:SLC Cache
你在评测里看到的写入速度,几乎全是 SLC Cache 的成绩。
为什么要拿 TLC 假装 SLC
TLC 一个 cell 存 3 bit,要分辨 8 个电压档位。写一个 cell,主控得反复微调注入的电子量,一道道逼近目标电压,这套动作叫增量步进脉冲编程(ISPP)。档位越多,需要的验证次数越多,越慢。
如果只判断“最高位是 0 还是 1”,只用 2 个状态,事情立刻简单:编程次数少,判决也快。所以现代 SSD 的做法是,把一部分 NAND 空间按 SLC 模式来写,真正存进去的只有 1 bit,剩下 2 bit 的位置先空着。
代价是空间。1GB 的 SLC 数据要占 3GB 的 TLC 物理容量,QLC 是 4GB。这块区域就是 SLC Cache。
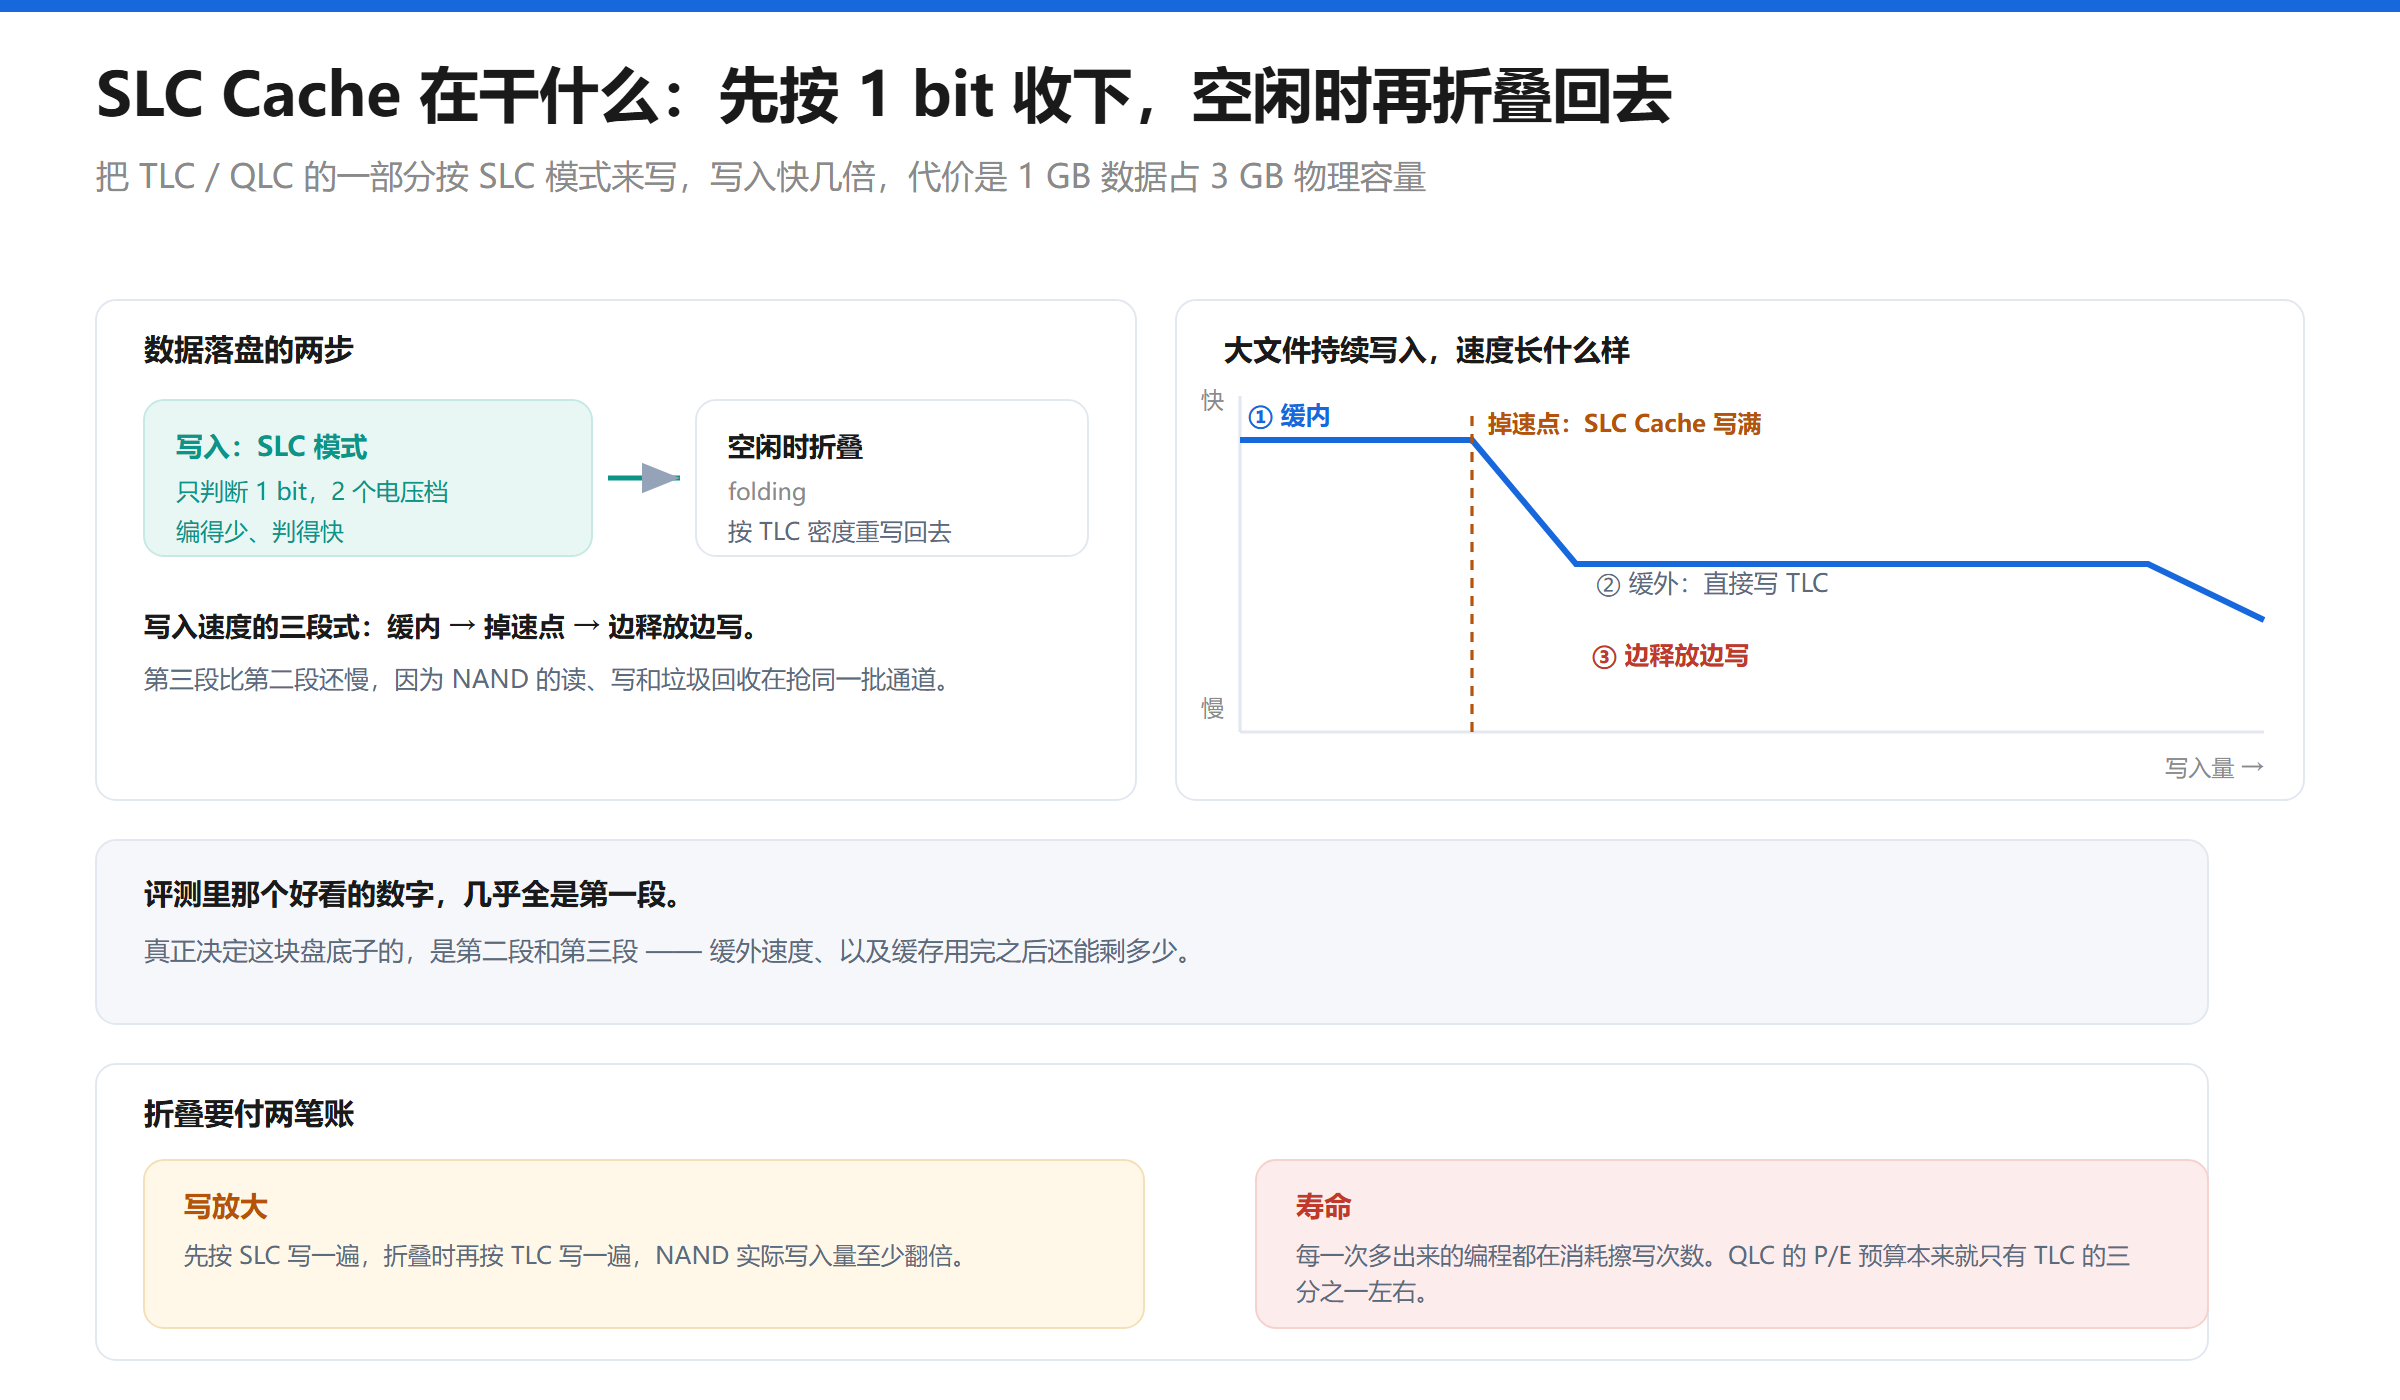
数据写进 SLC Cache 只是第一步。等盘空闲下来,主控把缓存里的数据按 TLC 密度重新写回常规区域,腾出空间给下一批写入。这个过程叫折叠(folding),西数闪迪和三星的官方文档里都用这个词。
折叠解释了写入速度的三段式曲线:
- 缓内:数据落在 SLC Cache,跑满接口速度
- 掉速点:缓存写满,新数据只能直接写 TLC
- 边写边释放:盘一边往 TLC 直写,一边把 SLC 里的旧数据折叠出去,速度比第二段还低,因为 NAND 的读、写和垃圾回收在抢同一批通道
所以“拷到一半掉速”不是故障,是设计。真正要看的是掉速之后的数字,缓外速度才是这块盘的底子。
三种划分方式:固定、动态、混合
SLC Cache 也不是想开多大就多大。厂家的划分方式主要三种:
| 方案 | 怎么划 | 空盘时 | 用掉一半容量后 | 常见于 |
|---|---|---|---|---|
| 固定容量 | 出厂定死一个值 | 几 GB 到几十 GB | 不变 | 部分工控盘、早期方案 |
| 动态(全盘模拟) | 按剩余空间的比例划 | 几乎全盘都算缓存 | 明显缩水,可能只剩三成 | 中低端 TLC / QLC 盘 |
| 混合(静态 + 动态) | 静态块加动态块 | 静态块 + 大部分剩余空间 | 保住静态块,动态部分缩水 | 中高端盘 |
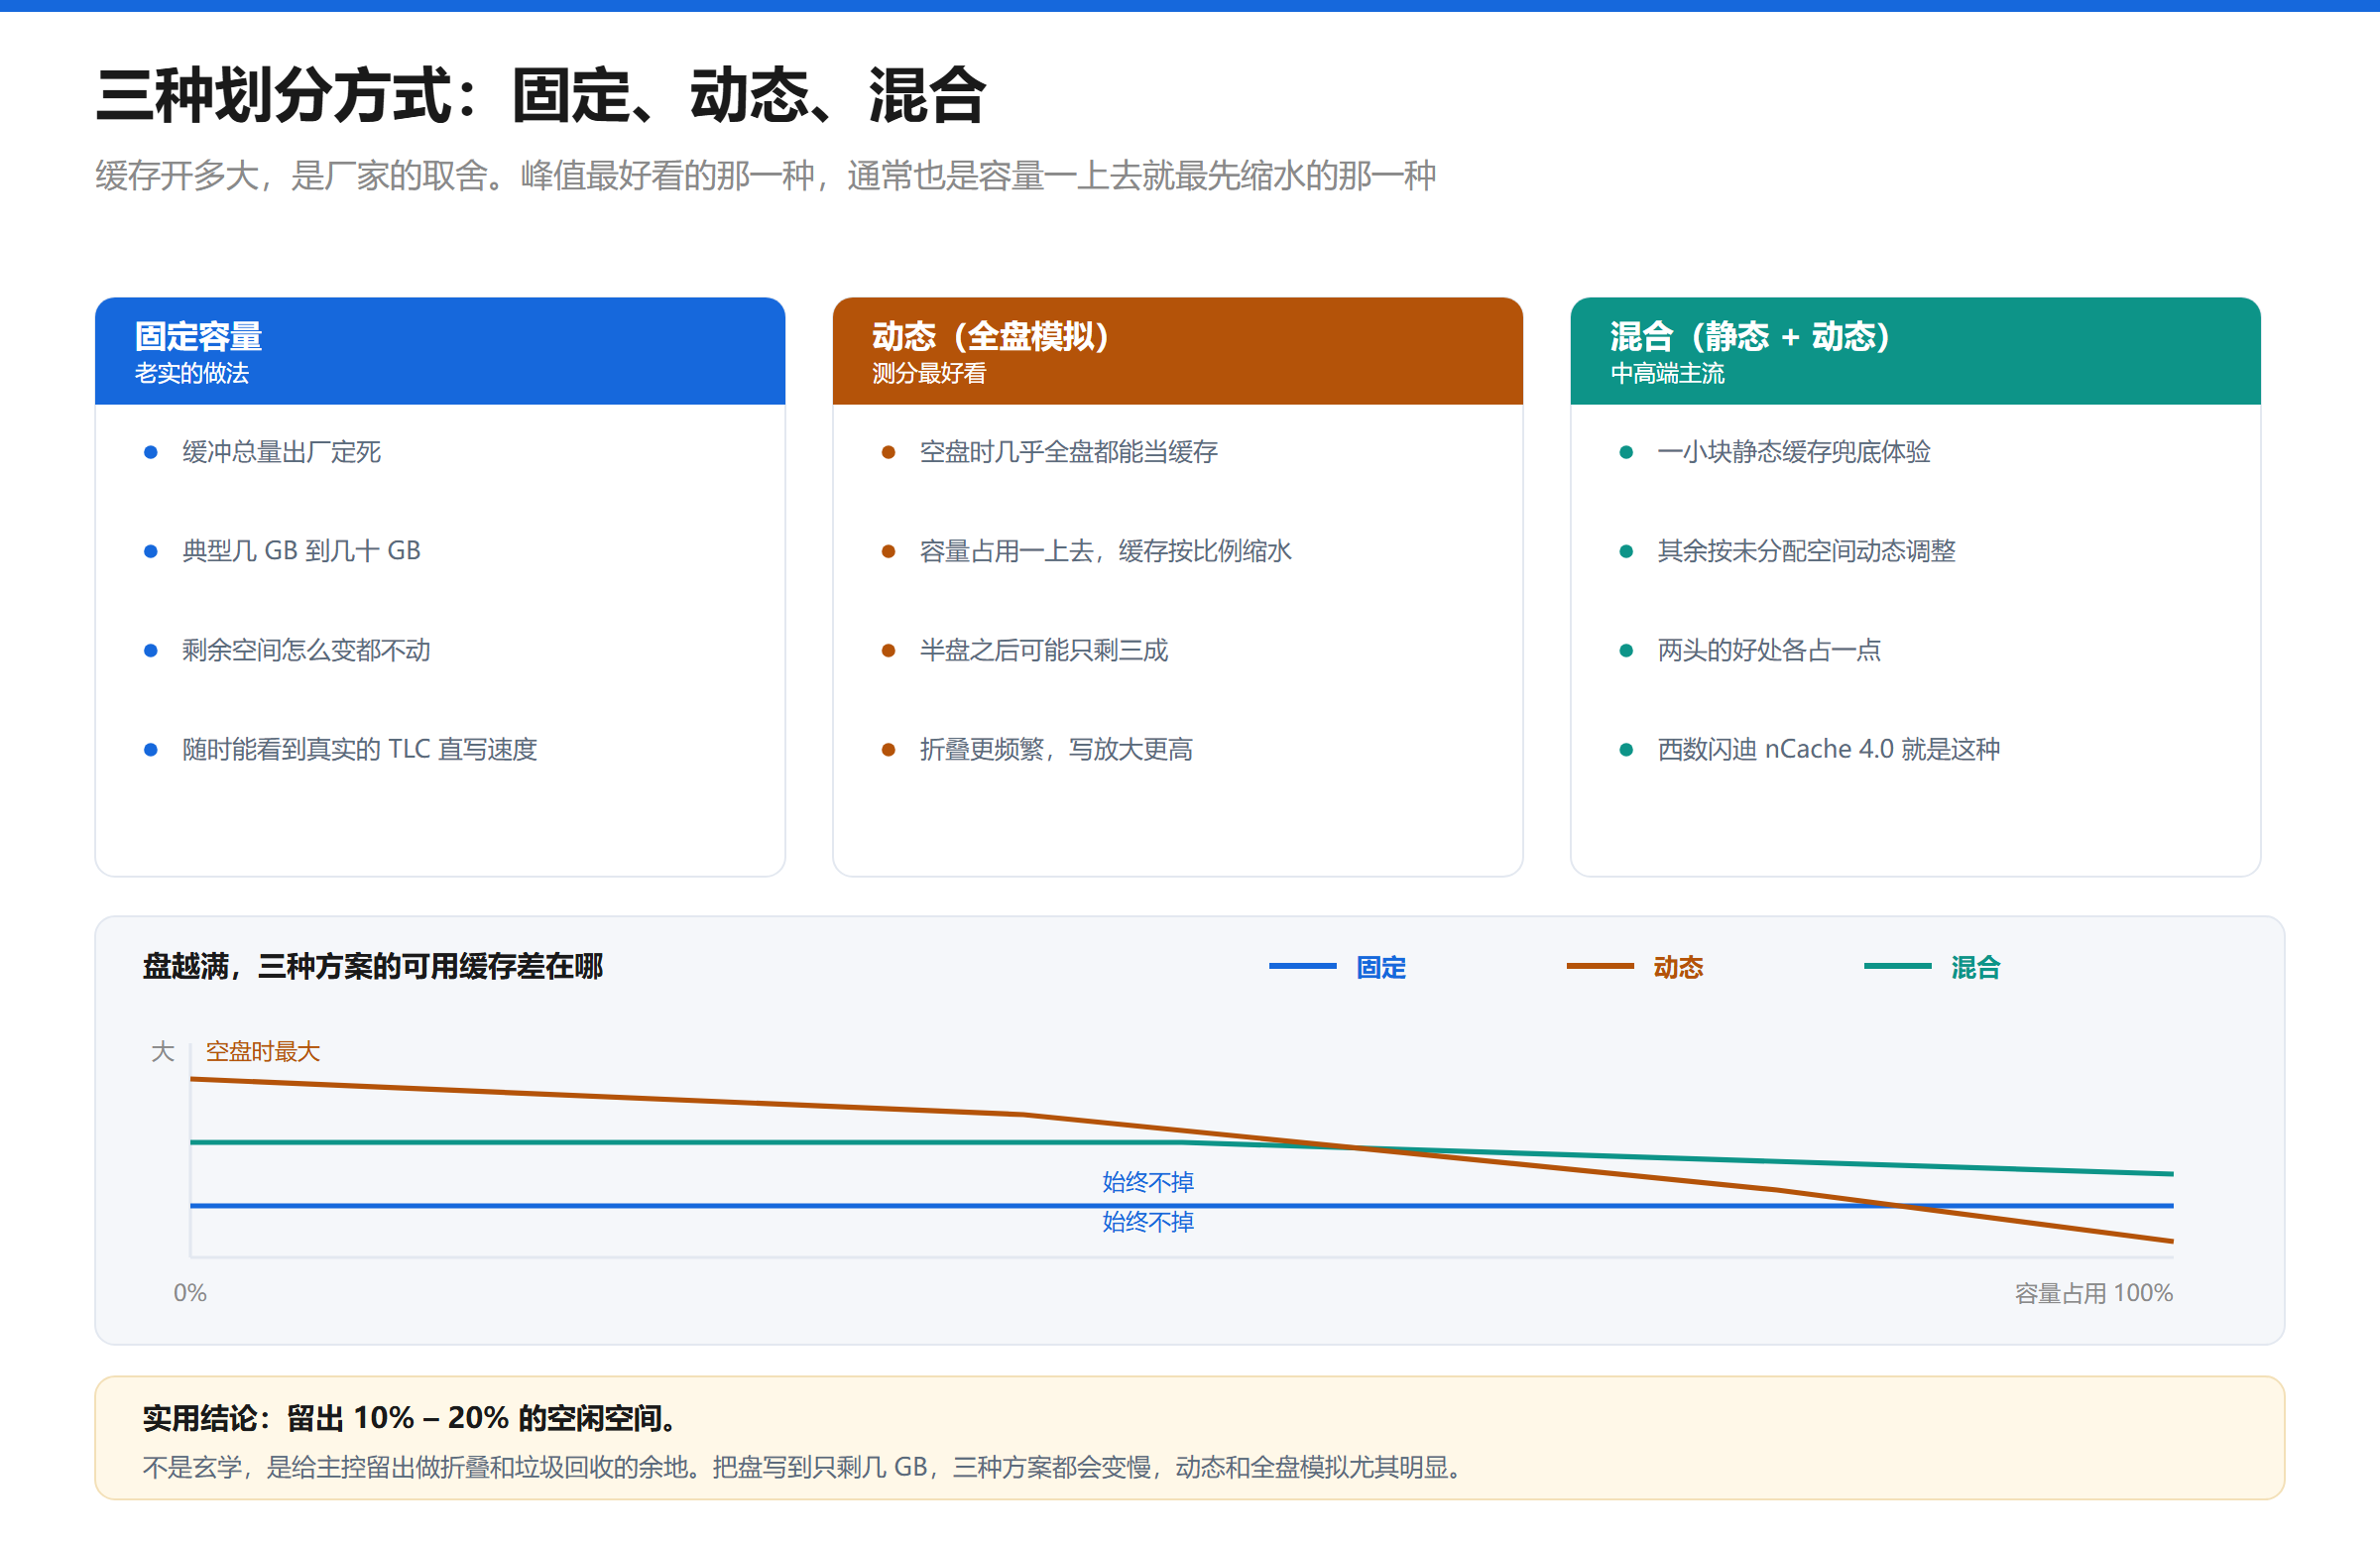
三种方案没有绝对高下。全盘模拟的峰值缓存最大,空盘测分最好看,但容量占用一上去,可用缓存按比例缩水,半盘之后可能只剩三成;而且它把本来能存 3 bit 的位置拿去当 1 bit 用,折叠时的写入量更大,QLC 上尤其明显。
固定方案老实,缓存就那么几 GB,好处是你随时能看到这块盘真实的 TLC 直写速度是多少。
混合是目前中高端的主流:一小块静态缓存保证基础体验,剩下的按未分配空间动态调整,两头的好处各占一点。
SLC Cache 的两笔账
折叠不是免费的。一笔是写放大:数据先按 SLC 写一遍,折叠时再按 TLC 写一遍,NAND 实际写入量至少翻倍。另一笔是寿命:多出来的每一次编程都在消耗擦写次数。
这两笔账在盘快满的时候同时恶化。空间不够,动态缓存缩水,折叠更频繁,写放大更高,于是“快满的盘又慢又费寿命”。QLC 上这个问题被放大好几倍,因为它的 P/E 预算本来就只有 TLC 的三分之一左右。
所以那句老话是真的:留出 10% 到 20% 的空闲空间。这不是玄学,是给主控留出做折叠和垃圾回收的余地。
各家的做法差在哪
同样是“静态加动态”,各家的取舍不一样。看官方文档比自己猜靠谱。
| 厂商 | 代表技术 | 缓存架构 | 独立 DRAM | 官方口径里的说法 |
|---|---|---|---|---|
| 三星 | TurboWrite / Intelligent TurboWrite | 固定缓冲区起步,后续版本加入动态部分 | 有 | 840 EVO 白皮书:缓冲区按 SLC 容量计 3GB – 12GB,随容量递增,物理占用要乘 3 |
| 西数 / 闪迪 | nCache 4.0 | 静态 SLC 块(按盘容量取百分比)+ 动态 SLC 块(按未分配空间取百分比) | 有 | 官方定性为混合 SLC 写缓存,空闲时 folding;宣传点里包含降低写放大 |
| 致钛(长江存储) | 动态 SLC 缓存 | 动态 | 无,走 HMB | TiPlus7100:联芸 MAP1602 主控 + 232 层 TLC,缓外为 TLC 原生水平 |
| 铠侠 / 美光 / SK 海力士 / Solidigm | 各自命名,思路相近 | 固定 + 动态为主 | 高端有,主流型号有 HMB 方案 | 差别主要在层数、QLC 策略和主控固件调校 |
三星是最早把这套东西做成卖点的。840 EVO 那代的白皮书里写得很明确:缓冲区按 SLC 容量计 3GB 到 12GB,容量越大给得越多;因为是用 3bit 单元模拟的,物理占用要乘 3。后来的 Intelligent TurboWrite 把动态部分加了进来,缓存大小开始随剩余空间变化。
西数(SSD 业务现在归闪迪)的 nCache 4.0,官方文档里少见地把架构写清楚了:静态 SLC 块按盘容量的百分比取,动态 SLC 块按未分配空间的百分比取,两池相加。它宣传的不只是速度,还有降写放大:把零散写入先吸收到寿命更好的 SLC 块里,整理好了再往高密度单元写,等于替 NAND 挡了一层。
致钛走的是另一条路。TiPlus7100 用的是联芸 MAP1602 主控,本身没有独立 DRAM,靠 HMB 借主机内存放映射表,配合动态 SLC 缓存。232 层 Xtacking 的 TLC 颗粒,缓内 7000MB/s,缓外就是 TLC 的原生水平。这条路线把成本压下来了,代价是前面说的,高负载下延迟抖动更明显。
铠侠、美光、SK 海力士、Solidigm 思路大同小异,差别主要在 BiCS 层数、QLC 的策略,以及主控固件的调校水平。所以真正影响体验的不是品牌名,是具体型号和固件版本,同一个系列换一次主控,缓外速度可能差一倍。
顺带一个坑:别信电商详情页的“缓存”两个字。有的页面写“无缓存”,那指的是没有独立 DRAM 芯片,不代表没有 SLC Cache。这两个概念差得远,前面那张表就是为了分清它们。
怎么选、怎么用
买之前,下面这几个参数比顺序读速有用得多。
| 看什么 | 为什么 | 在哪看 |
|---|---|---|
| 缓外(持续)写入速度 | 决定大文件持续写入的实际体验 | 评测里“掉速之后”那段数字;或自己用 HD Tune 做一次全盘写 |
| 有没有独立 DRAM | 影响满盘、碎片化场景下的随机读写稳定性 | 拆解图、评测;无缓盘会标 DRAM-less 或 HMB |
| 颗粒类型 | TLC 和 QLC 在缓外速度和寿命上差一个档 | 拆机看丝印,或用 Flash ID 一类工具读主控 |
| TBW 与质保年限 | 厂家给出的写入寿命上限 | 商品参数页。1TB 的 TLC 盘普遍标 600TBW 上下 |
| 散热 | 主控过热会主动降速 | 有没有散热马甲,机箱和笔记本内部的风道 |
| OP 预留 | 出厂已留 7% 左右,自己别再写满 | 留 10% 到 20% 的空闲空间 |
已经买了的,能做的事不多,但都有用:
- 别把盘写满,留 10% 到 20%
- 确认 TRIM 是开着的。Windows 上执行
fsutil behavior query DisableDeleteNotify,返回 0 就是开的 - 别拿“满盘跑分”的结果判断盘坏了。跑分工具写满全盘,本来就是专门去触发缓外速度和垃圾回收,数字难看是正常的
- 注意散热。主控超过一定温度会主动降速,笔记本里贴着电池的 M.2 尤其容易
- 看 SMART。CrystalDiskInfo 里的“已用寿命百分比”和“意外掉电计数”,比“健康状态:良好”这行字有意义
什么时候确实该换盘:写入速度掉到机械硬盘水平、清空空间也回不来;SMART 报备用块大量增长;或者意外掉电之后系统认不到盘。前两种还能拖一拖,第三种别拖。
回到开头那 200GB 素材。前十几秒的 5000MB/s 是 SLC Cache 给的,后面稳定的 800MB/s 才是这块 TLC 的本来面目。挑盘的时候盯住后者,比盯住包装上那行峰值数字有用。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
- 硬盘安全擦除:为什么全盘填充是浪费时间SSD固态硬盘
- SSD知识:企业级与消费级的区别?SSD固态硬盘
- 三星PM9A1(OEM)简单评测SSD固态硬盘
- TLC 和 QLC 到底该选谁:从可靠性、成本、性能三个角度看SSD固态硬盘
- ITGZ m.2硬盘盒U009(2230)开箱测评SSD固态硬盘
Comments NOTHING