

上个月底我想算一笔账:WorkBuddy 这一个月到底吃了我多少 token。打开界面,能看到的只有两样东西——当前会话的上下文占用,写着「476.7k / 1.00M,47.7%」,以及右上角一个孤零零的积分数字。
我想知道的不是这个——上周三为什么烧得特别快,想知道思考在输出里占了多少,想知道那个 98% 的缓存命中是真的还是我自我安慰。它一个都答不上来,因为它压根没打算记这些——界面上翻不到昨天,更别说上个月。
也不能说它做得差。界面回答的是「现在够不够用」,我想问的是「过去怎么花的」,这两个问题长得像,其实要的东西完全不同。前一个问题它答得挺好,后一个它连历史都没存。
那就自己动手。中间试了三个现成方案,全没跑通,最后写了个单文件 exe,双击就能看。这篇记录整个过程:数据藏在哪、现成的为什么不能用、自己写要注意什么、以及怎么证明它没在骗我,最后那部分是我花时间比较多的地方,因为看板这东西特别容易自己骗自己。
先说结论
- 数据一直都在本地硬盘上,每次请求的完整响应都落了盘,带着 usage 字段,只是没有界面去读它。
- 现成的三个方向各有各的墙:官方的要企业管理员权限,开源的要你对得上它的数据格式,同门产品只认它自己那个目录,我是逐个装上试过才放弃的。
- 真正麻烦的不是画图,画柱状图半天就够,难的是让它在 WorkBuddy 下次改版本的时候别整片散架。
- 思考过程看不到,只能看到它花了多少,一千四百多条响应我全扫了,一条 reasoning_content 都没有。
- 做完之后我改了自己的用法,以前觉得「上下文快满了」是个模糊感觉,现在能一眼看出哪几次缓存命中率掉得厉害,回头看都是我把话题扯太远的那几次。
数据其实一直在硬盘上
动手之前我先干了一件事——把 ~/.workbuddy 整个翻了一遍,不是翻文档,是翻文件,因为文档写的是功能,文件里才是真相。
结果比我想的干净。每一次模型调用,完整响应都写在 traces/<pid>/trace_*.jsonl 里,一行一个 span。工具调用、流式输出、最后的 API 响应全在里面,不是摘要,是原文。
顺手记一下结构,万一你也要读:每个 span_end 行里有个 generation 类型的 span。它的 toolOutput 是一段被转义过的 JSON 字符串,解析出来是个数组,数组第一项就是那次请求的响应体。
{
  "id": "chatcmpl-...",
  "model": "deepseek-v4.1-flash",
  "usage": {
    "prompt_tokens": 78234,
    "completion_tokens": 912,
    "total_tokens": 79146,
    "prompt_tokens_details": { "cached_tokens": 76700 },
    "completion_tokens_details": { "reasoning_tokens": 486 }
  }
}就这些——cached_tokens 告诉你多少输入复用了前缀缓存,reasoning_tokens 告诉你模型在思考上花了多少输出,有这两个数,一个看板要的东西基本就齐了,剩下的都是排列组合。
另一处是 workbuddy.db,里面的 session_usage 表存了每个会话的上下文占用、轮数和一个 credit_json。界面右上角那个积分就是从这儿来的,它按会话记账,没有按天的明细。
跑到今天,这台机器上已经是一千九百二十九次请求、三亿三千万输入、一百五十六万输出。其中思考占了五成左右。
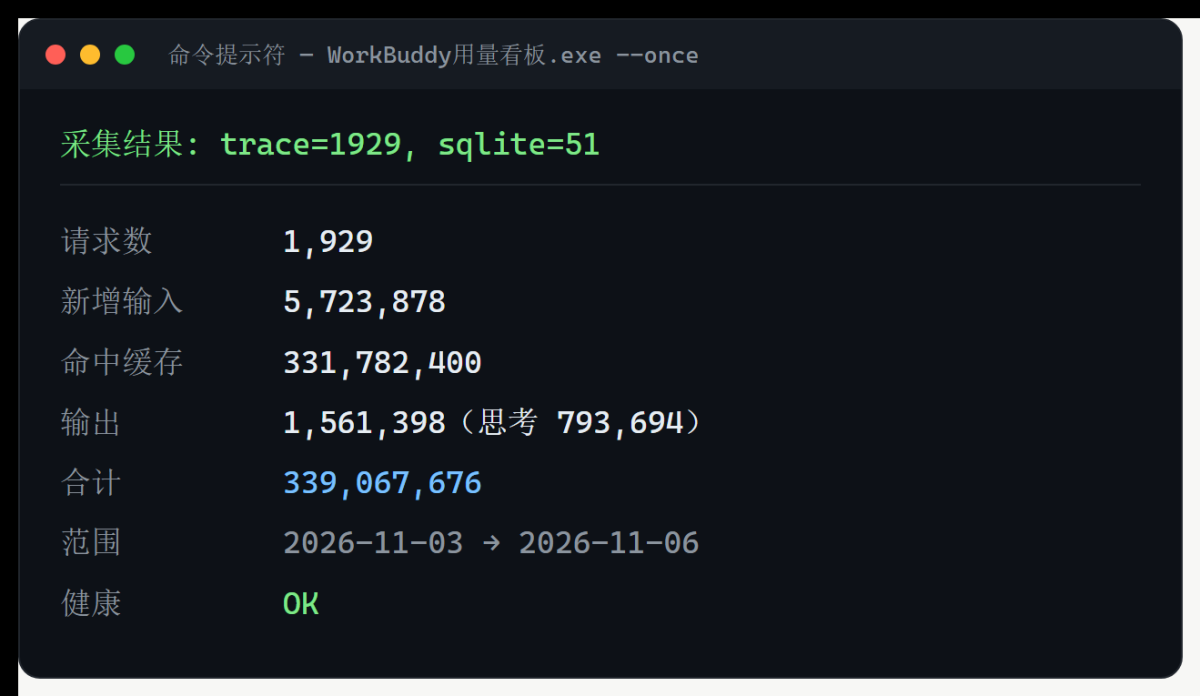
找到这儿的时候我有点想笑。我一开始的判断是「它不给你历史」——实际上历史一条不少,只是没人把它读出来。
缺的是一个读取器,不是一个记录器,这两件事的工作量差得很远,前者我周末就能弄完。
现成的三个方案,一个都没成
在动手写之前,我先确认了市面上真没有能直接用的。不是没搜,是搜完之后逐个装上试,三个方向,三种墙。
| 方向 | 能看什么 | 卡在哪 |
|---|---|---|
| WorkBuddy 企业版可观测中心 | 实时观测、会话追踪、积分按部门和模型拆解 | 要企业管理员权限,个人版进不去 |
| ccusage(开源) | 支持十几种 Agent CLI,有热力图、按会话、按模型的统计 | 读不进来,格式校验比文档里写的严 |
| codebuddy-stats(npm cbs) | TUI 界面、成本热力图、缓存命中率 | 写死读 ~/.codebuddy/projects/,这台机器上那个目录是空的 |
企业版那个是唯一真正意义上的官方看板——2026 年 10 月才开始公测。如果你们单位开通了,用它就行,别自己造,一套东西维护起来是要花时间的。我这边是个人版,所以这条路直接断了。
ccusage 是离得比较近的一个,我甚至写了个转换器。它能用 CLAUDE_CONFIG_DIR 指定数据目录,读的是 Claude Code 那种 JSONL,那我就把 trace 里的 usage 映射成它的字段:prompt_tokens 减去缓存的部分算新增输入,缓存那部分单独一个字段。推理 token 塞进 thinking。
两种放法我都试了——自定义目录,和直接铺到它默认的 ~/.claude/projects/ 下面,都返回 No usage data found。它的格式校验比 README 里写的严格,而且内置定价表全是 Claude 和 GPT 的单价,deepseek 的价格对不上,硬塞进去算出来的钱是错的。
到这一步我就没往下磨了。因为就算格式骗过去了,价格还是错的,一个价格错位的成本看板对我来说没什么意义,还不如自己算 token 数。
顺便说,测试时建的 ~/.claude 我删掉了,那会儿该目录本来不存在,是本次测试新建的,不清掉的话以后自己都分不清它是哪个工具留下的。
codebuddy-stats 更可惜,它长得挺像我要的——终端里跑,有热力图,能按项目拆。
但它把路径写死了,同门产品不等于同门数据目录,它要的那个目录在这台机器上是空的,界面进去一片零,连报错都没有。
那就自己写一个
写的时候我给自己定了一条规矩,后来发现这是整套东西里唯一真正重要的决定:只有一个目录允许知道 WorkBuddy 的存在。
原因很实际。这类工具最大的风险不是写不出来,是上游改一版就全废,而 trace 那个格式属于内部实现,说变就变,没有任何承诺。
如果解析逻辑散在采集、统计、界面三个地方,一次改版我要改三处,还特别容易漏掉其中一处。
| 层 | 它知道什么 | 上游改了要动它吗 |
|---|---|---|
| adapters/ | trace 长什么样、数据库有哪些表 | 要,而且只动这里 |
| contracts | 只有一个「一条用量记录」的定义 | 不动 |
| core/ | 去重、聚合、健康状态 | 不动 |
| web/ | 怎么画 | 不动 |
于是核心层从头到尾不知道「WorkBuddy」这个词,它收到的就是一批标准化记录——什么时候、哪个模型、输入多少、缓存多少、输出多少、思考多少,谁产的它不关心。
这条规矩真正派上用场,是在我写验证脚本的时候。我造了一个纯假的数据源塞进去,界面一行代码没改,照样出图。如果换个数据源还要动前端,那说明分层只是画在文档上的。
采集是增量读的——trace 是追加写,所以只记一个字节偏移量,每次从上次读完的位置接着读,不用整文件重扫,文件长到几十兆也不影响速度,因为它只碰新长出来的那一截。
wb-usage-monitor/
├── config.py            所有路径、端口、字段映射
├── contracts.py         数据契约:一条记录长什么样
├── adapters/
│   ├── trace_adapter.py     ← 唯一认识 trace 格式的地方
│   └── sqlite_adapter.py    ← 唯一认识数据库表结构的地方
├── core/
│   ├── store.py         落库、水位、聚合
│   └── engine.py        调度、健康状态、广播
└── web/index.html       看板(手写 SVG,不依赖 CDN)
刷新走 SSE,服务端一有增量就推,页面不用轮。这条链路实测是追加记录之后零点八到一秒,页面上就能看到,不用手动刷新。后来还补了一道兜底:超过十二秒没收到任何消息,页面自己去拉一次快照。
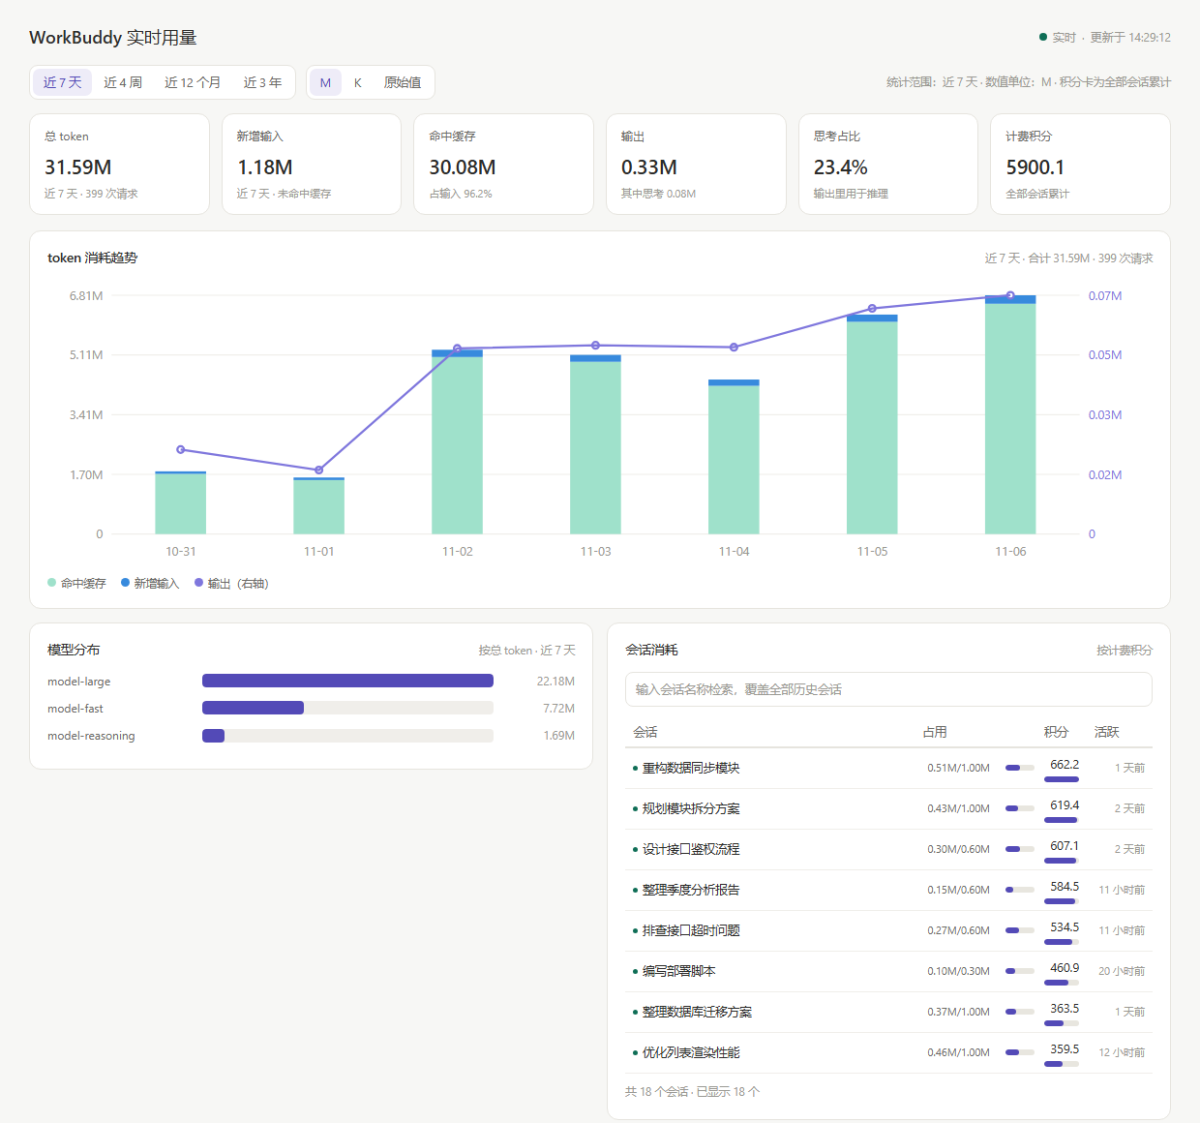
打包成单文件 exe,八点八兆,双击跑起来会自己开浏览器。
做成 exe 而不是让你装 Python,是因为我先发的是源码版,收到的第一句反馈是「执行 Python 代码后没有任何输出」。查下来是三件事叠在一起——输出被缓冲区吞掉、启动后不自动开浏览器、双击 .py 报错时窗口一闪而过。
这三件事单看都不算 bug,凑在一起的效果就是「程序没反应」。后来所有给用户看的输出都强制刷一次缓冲,启动自己开浏览器,出错时用 input 把窗口挂住,至少让人能看见报错。
几个把我耗到半夜的坑
写代码本身没花多少时间,卡住的都是环境。留个记录,省得下次再撞一遍。
第一个:8787 端口根本不清净。我一开始判断这个端口空闲,理由是「没人监听」。后来加了端口冲突处理才发现,占着它的是 WeChatAppEx.exe,微信的小程序组件,而我之前那句「空闲」是错的,错得还没有任何提示,只表现为偶尔启动失败。
第二个:Windows 上的端口探测不能用 bind。我写的探测逻辑是「试着 bind 一下,成功就是空闲」——这行代码在 Linux 上是对的,在 Windows 上是错的。问题出在 SO_REUSEADDR,它在那里允许重复绑定同一个端口,于是明明被占用,bind 也返回成功。
两个进程会真的去抢同一个端口,然后其中一个莫名其妙收不到请求。
改成用 connect 探测之后,又炸出第三个问题:为了让重启更快,我把端口复用关了,结果强杀进程后端口进入 TIME_WAIT,连续重启时端口一路往后跳,8877、8878、8879,每次重启地址都不一样,之前存的书签全废。
最后的解法是分两种情况:先 connect 一下看有没有实例在跑,有就直接复用那个地址,顺便把单实例也实现了,双击两次不会开两个服务。没有的情况才允许复用绑定,用来覆盖 TIME_WAIT 的残留。
现在连续重启三次,端口稳稳不动。
第四个:PyInstaller 的 __file__ 指向解压目录。源码跑的时候网页文件在相对路径上找得到,打成 exe 之后 __file__ 指向临时解压目录 _MEIPASS,静态资源全 404,页面一片白,而且控制台不报错,你只会看到浏览器里一个空页面。
第五个:控制台中文乱码。Windows 控制台默认 GBK,我那些带中文的启动横幅全变成问号,得在启动时把代码页切到 65001,再把标准输出重新包一层 UTF-8。这问题不影响功能,但用户第一眼看到的就是乱码,印象基本就没了。
第六个特别隐蔽:截图验证不了「页面会自己刷新」。我想截个图证明 SSE 生效,结果 headless Chrome 一直等不到「网络空闲」。因为 SSE 是长连接,它永远不会空闲,--screenshot 直接不产出文件,也不报错。
一个不报错的失败,是最容易骗过自己的东西,我一开始还以为是自己路径写错了,反复改了三四遍才发现方向根本不对。后来改用 DevTools 协议直接读页面里的 DOM,同一个页面不刷新,追加一条记录,看数字变不变。
这个办法还有个额外好处:能顺手验证兜底逻辑。把 SSE 请求整个拦掉之后,页面在十一秒左右靠轮询把新数据补上了,跟设计时估的时间差不多,算是把「断线了怎么办」也验了一遍。
怎么证明它没在骗我
看板这类工具麻烦的地方在于:数字错了你也不知道。一根柱子画歪了,你会以为是那天的数据真的低;一个字段取错,曲线会变得很平滑很好看,看不出异常。所以我一开始就把验证当成功能的一部分写,不是写完再补。
每个用例都写死判定标准,跑完直接输出 PASS 或 FAIL 和实际数值,不靠人眼看。现在一共十一项,前九项是核心性质,后两项是后来加功能时补的。
| # | 验什么 | 判定 |
|---|---|---|
| V1 | 数据完整性 | 和独立重算的总量逐项比对,差 0 |
| V2 | 幂等 | 重复采三次、重开五次,条数不变 |
| V3 | 实时延迟 | P50 397ms,P95 602ms |
| V4 | 断点续采 | 中途强杀,重启后不漏不重 |
| V5 | 格式漂移 | 改字段名、写半行、删表、删目录,都不崩 |
| V6 | 资源占用 | CPU 3.7%,内存 33MB |
| V8 | 只读安全 | 采五十个文件,指纹零变动 |
| V9 | 可插拔 | 换假数据源,核心与界面零改动 |
| V10 | 时间分桶 | 四种粒度合计与独立重算一致 |
| V11 | 会话检索 | 翻页不重不漏,通配符已转义 |
V9 是整套东西的验收点,不是凑数的。如果换数据源还要改界面,这套分层就是假的,代码写得再整洁也没用。
同理还有 V5:我故意把 trace 里的 prompt_tokens 改名成 prompt_tokens_v2,程序不能崩,只能把这一项降级,其余面板继续显示最后一次有效值。
V8 那条我多说一句。我读的是 WorkBuddy 自己的数据文件,如果读的时候把它锁住了,或者顺手往里写了什么,那就成了「看板把工具搞坏」的经典事故。所以采集全程只读打开,前后对五十一个文件做指纹比对,零变动才算过。
也有不体面的地方。第七项「长稳」我只跑了六十秒,内存增长 0%,但这说明不了八小时之后不涨。表格里写的是实测值,没测的就是没测,我不想拿六十秒的结论冒充八小时,那属于自己给自己发合格证。
还有一件更尴尬的事:验证脚本自己出过两次错。V3 最初测出 P50 五千多毫秒,我差点以为是采集太慢,查下来是去重键写错,延迟被累积了;V5 一开始 FAIL,是几个子用例共用同一个目录互相污染。
修完才是上面那些数字,第一版是错的,我没拿它交差。这件事让我后来养成一个习惯——验证失败的时候,先怀疑验证本身,尤其是当失败结论「特别符合预期」的时候。
后补的三样东西
第一版只有一张每日消耗柱状图和一张会话表,用了几天发现不够用,又补了三样。
一是时间粒度。只能看最近几天,没法回答「这个月比上个月多花了多少」,所以加了四个档位:近七天按天、近四周按周、近十二个月按月、近三年按年。切档的时候趋势图、上面几个数字、模型分布一起变,不会出现图是七天、模型却是全部历史这种自相矛盾。
这里有个细节我纠结了一会儿:没有数据的那几天要不要留着。留着会出现一根零高的柱子,不好看,但删掉更糟——如果停用了一周,图上看不出断层,会让人以为你天天都在用。
二是单位切换。M、K、原始值三档,看着像小事,实际是我自己点得挺多的按钮:看总量用 M,对比两个小模型时要切原始值,不然它们都显示成 0.00M,看着像没数据。
三是会话检索。会话表原来只显示积分最高的二十个,这意味着消耗小的那些永远看不到,而「那个只用过两次的会话到底花了我多少」——恰恰是我偶尔会问的问题。
改成服务端检索之后,输入名字就能翻到全部历史,哪怕它只有零点几积分。
做这个的时候顺手改了个底层行为:原来每次采集都是清空会话表再重写,上游一旦把某个会话关掉,这边的记录也跟着消失。改成只累积不删除,关掉的会话标一个离线,用灰点画出来,记录永远留着。
积分那条线单独说一句:它没法按时间范围拆——积分是按会话记的账,没有按天的明细,所以那张卡固定显示全部会话累计,界面上也这么标着。
我知道这看着和别的不一致,但硬拆出来的数字是假的,不如说清楚。
它做不到的事
用了这些天,有几件事是明确做不到的,写出来免得你抱着错误的期待装上,然后回来骂我。
看不到思考内容,只能看到思考花了多少。我把当时能扫到的一千四百七十一条响应全翻了一遍,reasoning_content 一条都没有,只有 reasoning_tokens 那个计数——模型确实在思考,网关也统计了思考消耗,但思考文本在中间层就被剥掉了。
所以看板上只能写「思考占输出 52%」,写不出它想了什么。
实时性的上限不在我这边。采集侧是秒级的,但 WorkBuddy 不是每条请求写完立刻落盘,它有自己的批量写入节奏——所以「页面停在一个时间点很久」有两种可能——上游还没写,或者页面没刷新。右上角的状态灯和时间戳能分开这两种情况。
不跨机器。数据不进云端,每台机器只看自己那份,想两台机器合起来看——就得自己想办法搬 trace 文件。这是我故意选的:一旦涉及上传,这东西就不该随便发给别人用。
会话历史从它第一次运行开始攒。更早的会话如果 WorkBuddy 自己已经清掉了,这边也没法凭空补出来,这一点绕不过去,只能早装。我装得不算早,所以最早那批会话的积分是缺的。
想试的话,从 --probe 开始
单文件 exe,八点八兆,Windows 十或十一的 64 位,双击就能跑。前提只有一条——这台机器装过并用过 WorkBuddy,%USERPROFILE%\.workbuddy\ 那个目录在。不需要 Python,不需要联网,也不需要 WorkBuddy 当前开着。
第一次跑会全量扫一遍历史,几秒到几十秒,看数据量。如果窗口一闪就没,别急着说坏了,在命令行里跑一次 --probe,它会告诉你两个数据源各自能不能读到,报错也看得见。这个参数就是我被「双击没反应」投诉之后加的。
我现在的用法很简单——每天收工前开一次,看当天总消耗和缓存命中率。命中率掉到九成以下的,就去翻那天的会话,基本都能找到话题扯太远的那一次,比起盯总量,这个指标更能说明问题。
代码是 MIT,随便改。只有一点想提醒:如果你要加功能,别往 adapters/ 以外的目录写 WorkBuddy 的字段名。那条线守住了,下次它改版本你只改一个文件;守不住,你会花一整个下午在四个文件里找哪个字段对不上。
项目在这两个地址,仓库里带全部源码和验证脚本:
- 仓库主页:github.com/dellzou/workbuddy-usage-dashboard
- 直接下 exe:Releases 页面,不用自己打包
另外,如果你们单位开了 WorkBuddy 企业版,先去管理后台看一眼有没有可观测中心。有的话用它,那才是正路,我这个是给没有的人准备的。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING