





11 月 10 日,第六代 EPYC 开始出货,代号 Venice,产品线叫 EPYC 9006 系列,AMD 照例为它办了一场 In Depth 2026 的技术讲解。翻完这套幻灯片我注意到一件事:Zen 6c 占掉的页数比标准 Zen 6 还多,讲得也更细,一家公司把哪块内容讲得更用力,通常比它嘴上说重视什么更可信。
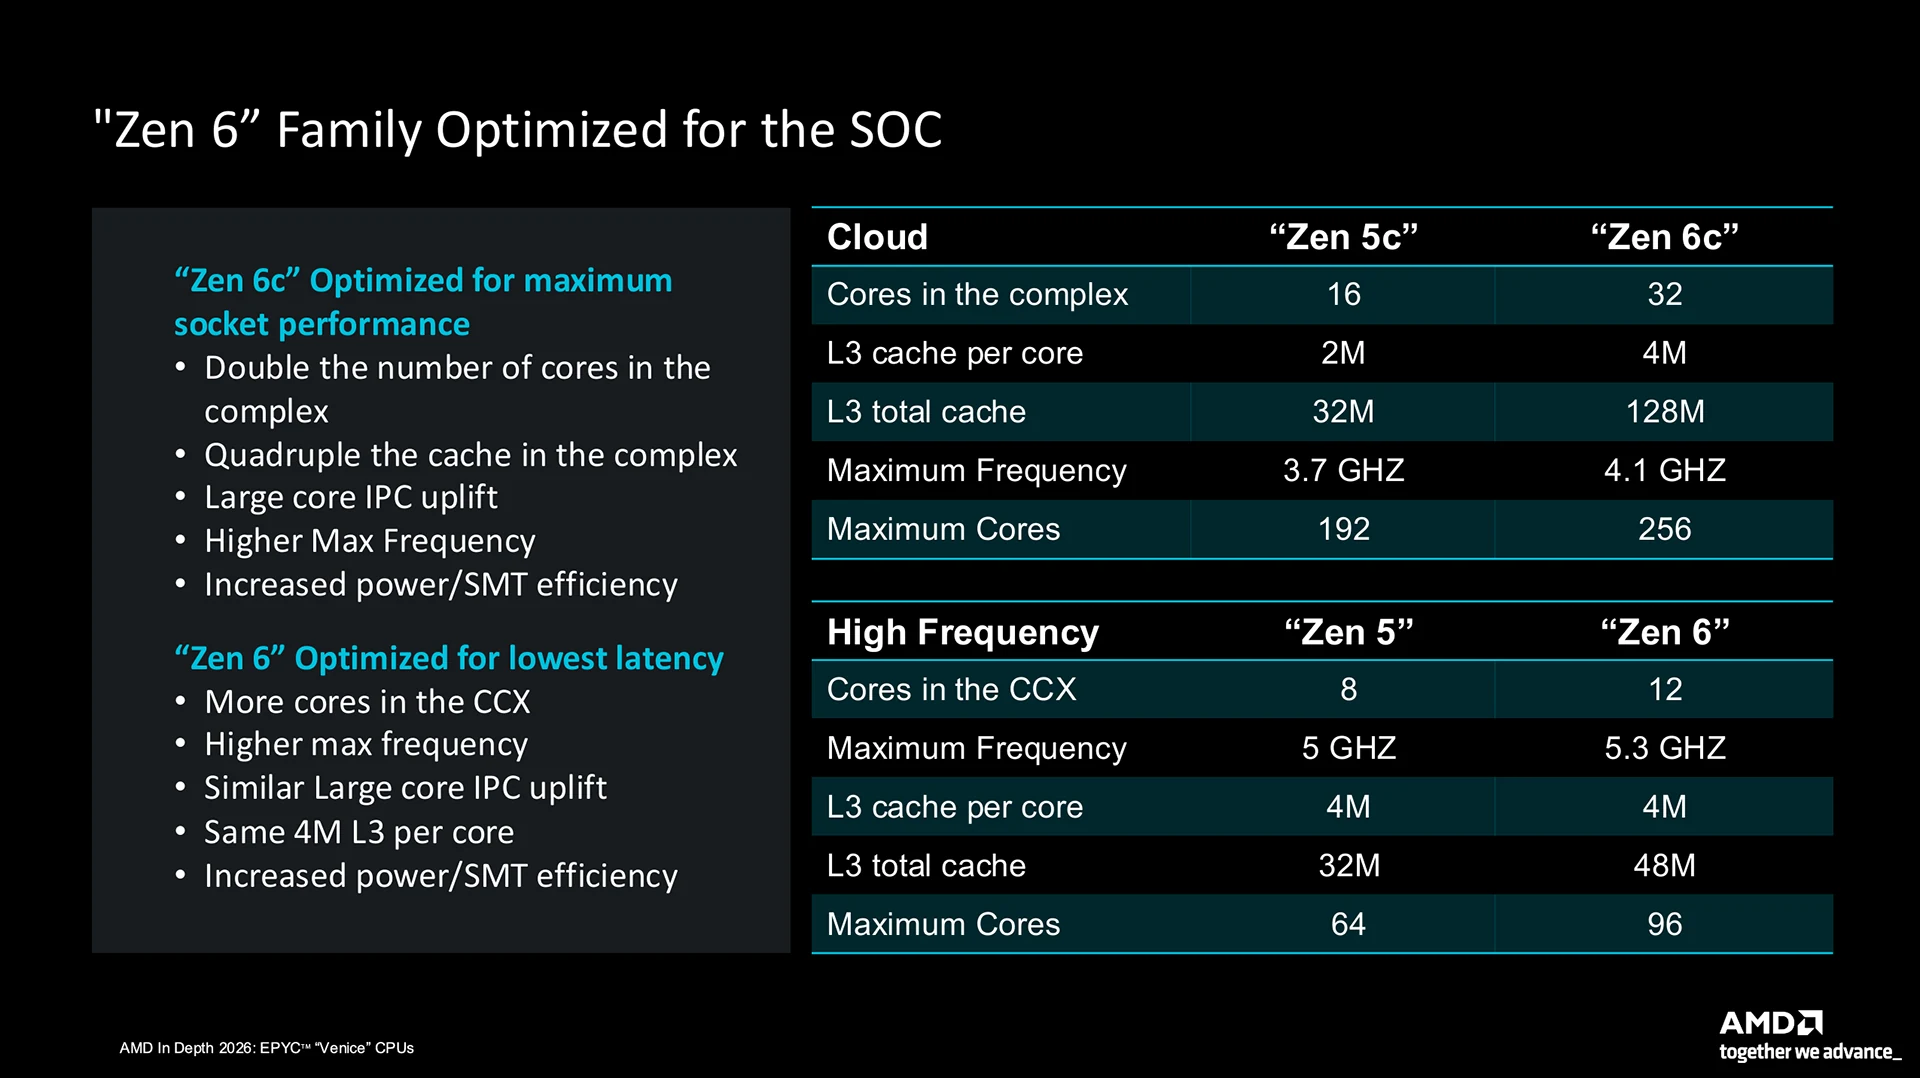
规格表上写着四个数字:单 CCD 32 核、每核 4MB L3、频率上限 4.1GHz、单路最多 256 核。上一代 Zen 5c 是 16 核、每核 2MB,缓存和核心数同时翻倍,这才是这次真正的新闻。标准 Zen 6 那边反而温和,CCD 从 8 核加到 12 核,每核 L3 还是 4MB,单路封顶 96 核。
AMD 把「堆核心」这件事整体交给了密度核,把「守频率」留给了标准核。这个分工比参数本身更值得说,因为它决定了未来两年服务器 CPU 的竞争方式,也预告了明年 PC 上的 Zen 6 大概会长成什么样。
先说结论
- Zen 6c 不再是「砍缓存的小核」:每核 4MB L3 和标准 Zen 6 完全一致,单 CCD 128MB,32 个核共享同一个缓存池。
- 固定频率下 IPC 比 Zen 5 高约 20%,AI 负载约 31%,综合约 27%,这是 AMD 自己的口径,而且对比配置对 Zen 6c 不利——16 个核分散在 2 个 CCD 上。
- 密度核拿到的是大核那套家当:ROB 640、整数寄存器 352、Op Cache 6.75K 微操作,乱序窗口比上一代大核的 448 还大一圈。
- 面积账决定路线:一个大核的地盘能放 2 到 3 个密度核,同面积下多线程吞吐小核占优,Intel 的 E 核和 Apple 的 M 系列走的是同一套逻辑。
- 小核的代价落在预测打空和调度上:数据库这类随机访问负载最怕这两样,核心堆到 256 个,缓存一致性和中断分布也一起变难。
- 家用平台跑数据库是个伪需求:真正该担心异构调度的是服务器,不是你的台式机。
规格与微架构
CCD 与缓存
先把几个名词说清楚:CCD 是计算芯粒,一颗 EPYC 由若干块 CCD 加 IOD(输入输出芯粒)拼起来,核心和对应的 L3 都长在 CCD 里,而 IOD 负责内存控制器、PCIe 和片间互连。
「复杂体」是 CCD 内部共享 L3 的那一组核心,AMD 文档里写作 complex,早几年大家习惯叫 CCX。Zen 6c 把每个复杂体的核心从 16 个加到 32 个,L3 总量从 32MB 加到 128MB,每核从 2MB 补到 4MB,频率上限从 3.7GHz 提到 4.1GHz。
单路最多 256 核 512 线程,x86 服务器 CPU 目前没有第二家做到这个数。8 块 CCD 才能拼出这个规模,每块芯粒 32 核共享 128MB L3,密度就是这么一堆一堆摞出来的。
| 项目 | Zen 5c(Turin) | Zen 6c(Venice) |
|---|---|---|
| 每复杂体核心数 | 16 | 32 |
| 每核 L3 | 2MB | 4MB |
| 每复杂体 L3 总量 | 32MB | 128MB |
| 频率上限 | 3.7GHz | 4.1GHz |
| 单路核心上限 | 192 | 256 |
标准 Zen 6 那边换一组数字看更清楚:CCX 从 8 核变 12 核,每核 L3 保持 4MB 不动,总量从 32MB 涨到 48MB,频率上限从 5.0GHz 抬到 5.3GHz,单路核心上限从 64 到 96。核心数只多了五成,每核缓存一寸没让,这是标准核的定价逻辑:多给核心,但不拿缓存去换。
缓存翻倍的意义不只是「多装数据」。32 个核共享一个 128MB 池,二三十个核协同的负载不用再跨复杂体跑远路,数据交换留在同一块 L3 里,延迟和功耗都省下来。AMD 给 Zen 6 的定位是「延迟最低」,给 Zen 6c 的定位是「插槽性能上限」,两句话代表两种产品哲学。
每核 1MB 的 L2 是私有的,4MB 的 L3 是共享的,这个层级关系决定了缓存的用法。私有 L2 保证单核不被邻居打扰,共享 L3 负责让协作的核交换数据,两层都够大,密度核才不至于一直等内存,Zen 6c 把 L2 稳定在 1MB,把增量全给了 L3,这个选择偏向多核共享,不是单核延迟。
服务器上的缓存从来不是给一个程序用的。一台机器跑几十个虚拟机,每个虚拟机都希望自己的热数据留在 L3 里,2MB 每核的时候,稍微大一点的数据库实例就会被邻居挤出去。4MB 每核加 128MB 共享池,才勉强够把常驻索引摊开,这是我理解 AMD 这次补缓存的实际动机,跑分只是顺带的结果。
别把 L3 当万灵药,在 EPYC 上它是 L2 的受害者缓存,数据被 L2 挤出来先落这里,不是直接回内存。它能省一次长途往返,省不掉容量不够时的必然缺失,128MB 听起来很唬人,分到 32 个核头上每核只有 4MB 的份额。
幻灯片里还有个容易被忽略的细节:CCD32 里加了一颗冗余核,用来提高良率。32 核的芯粒面积大,制造缺陷的概率也大,多塞一颗做备份,坏一个还能屏蔽掉顶上,这也是密度核在工程上的一个隐性优势,大核想加冗余,面积代价立刻翻倍。
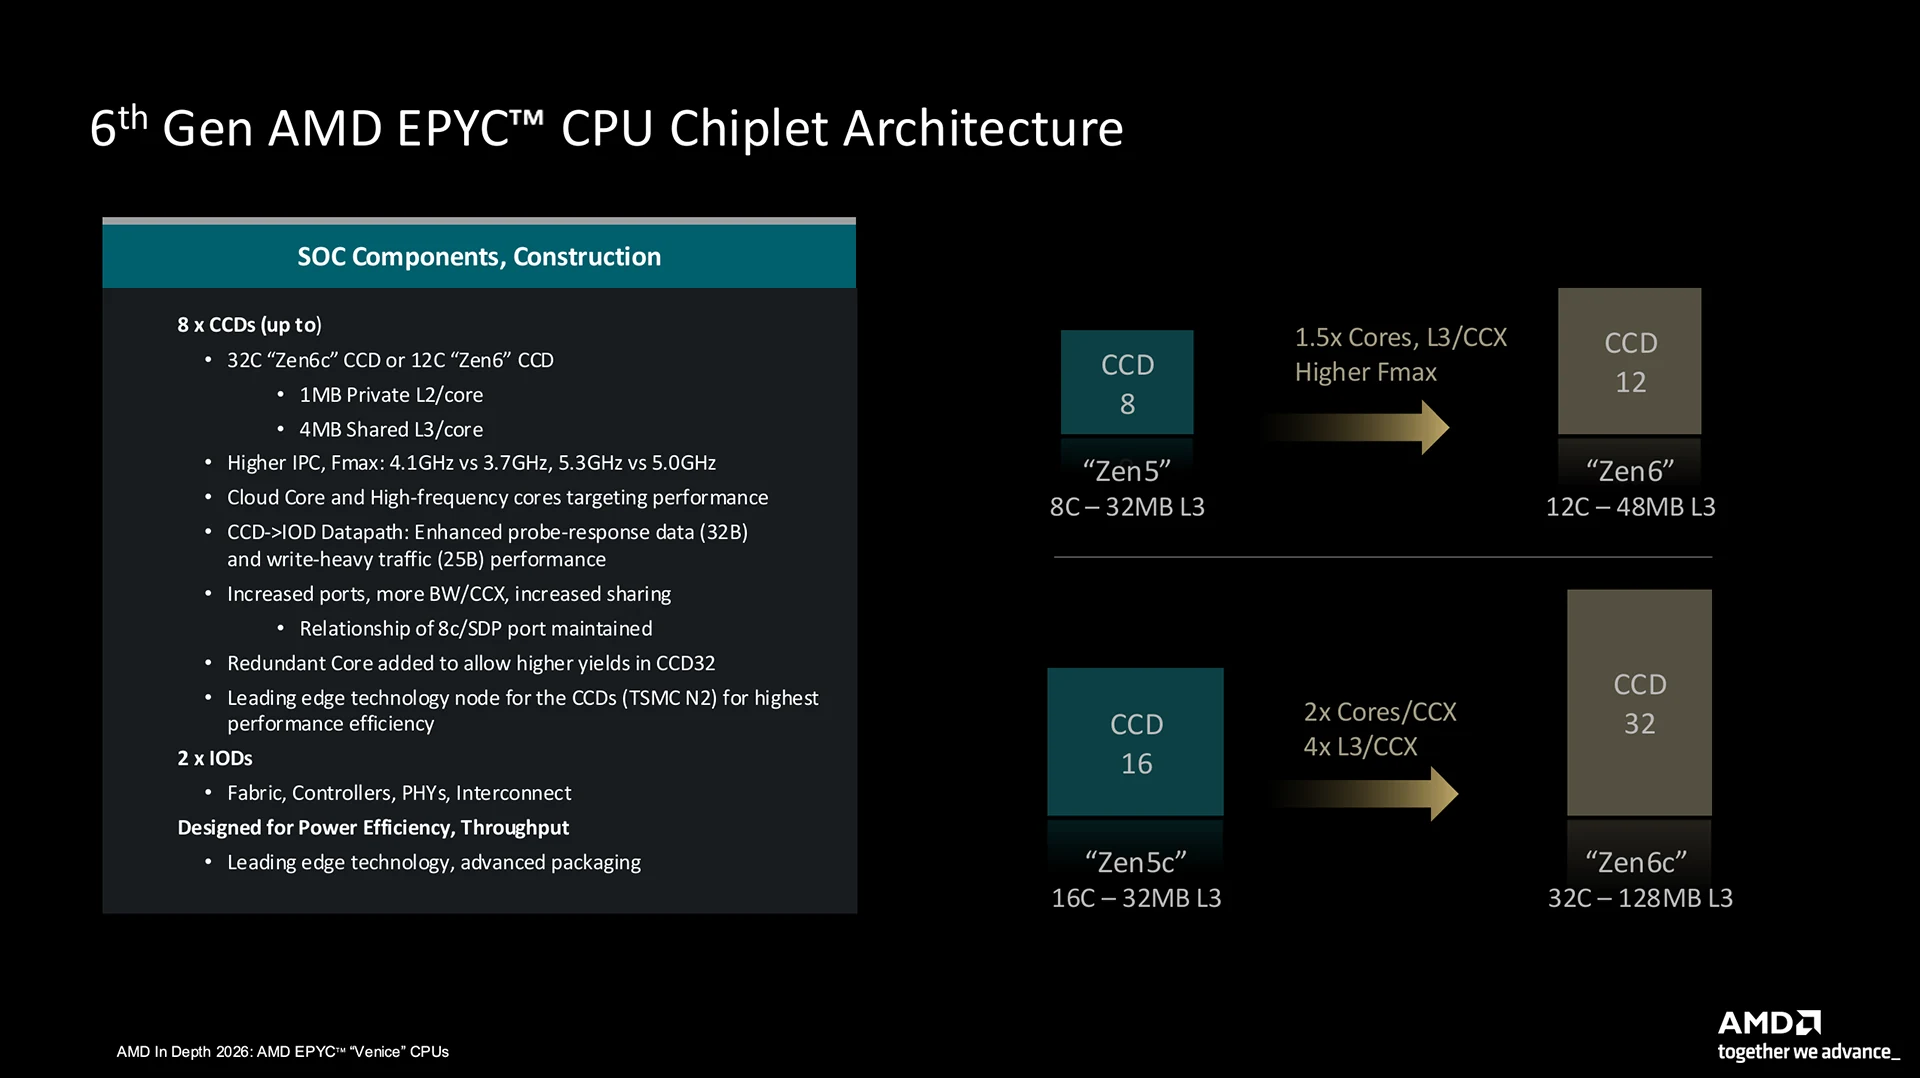
8 块 CCD 拼出 256 核,对软件是压力:一颗芯片里要管 512 个逻辑处理器,NUMA 域(每个核访问本地内存更快的那套分区)、缓存亲和、中断分布全部要重算,这也是 AMD 把 IOD 从一块拆成两块的原因,内存通道和互连带宽得跟着核心数一起翻倍,不然核再多也是饿着跑。
核心数上去之后,缓存一致性协议要维护的 sharer 列表变长,跨 CCD 的探测消息也变多。幻灯片里专门提到,CCD 到 IOD 的通路增强了探测响应数据(32B)与写密集流量的处理(25B),这些工程细节不会出现在跑分里,但它们决定了 256 核能不能真跑满。
顺带说一句频率上的取舍:Zen 6c 的 4.1GHz 比标准核的 5.3GHz 低了 1.2GHz,这个差距不是工艺问题,是设计选择。频率和电压不是线性关系,越往高频走,每多 100MHz 要付的功耗越贵,密度核停在 4.1GHz,是算过账的位置。
缓存这条线还有一条支线。9006X 用 3D V-Cache 把 L3 堆到 1152MB,走的是「少核大缓存」的方向,跟 9996 的「多核中缓存」正好相反。同一代产品给出两种缓存策略,说明 AMD 自己也清楚 4MB 每核不是所有负载的答案。
前端与执行单元
幻灯片里那张结构图值得逐项读。前端还是两条取指流水、每周期双路 32 字节取指、双路 4 宽解码,派发保持 8 宽。后端 6 个 ALU、4 个 load 加 2 个 store、512 位浮点通路、2 周期 FADD 延迟、48KB 一级数据缓存、1MB 二级缓存。
页面下半截的提升清单更有信息量:更大的 Op Cache、更大的返回地址栈、更大的浮点和整数调度器、更深的 load/store 队列、更大的 ROB、更多的指令融合、更低的分支预测延迟、VNNI INT8 通道从 2 条翻到 4 条。这是一份大核的升级清单,不是小核的补丁清单。
8 宽派发、6 个 ALU 这组数字放在服务器核里不算夸张,但配上 640 的 ROB 就能看出意图:前端每周期能吞 8 条,后端有 6 条整数通路接得住,中间还有一个能装 640 条指令的窗口做缓冲,宽度、深度、缓冲三样配齐才叫完整的乱序核,少一样都会在不同负载上露馅。
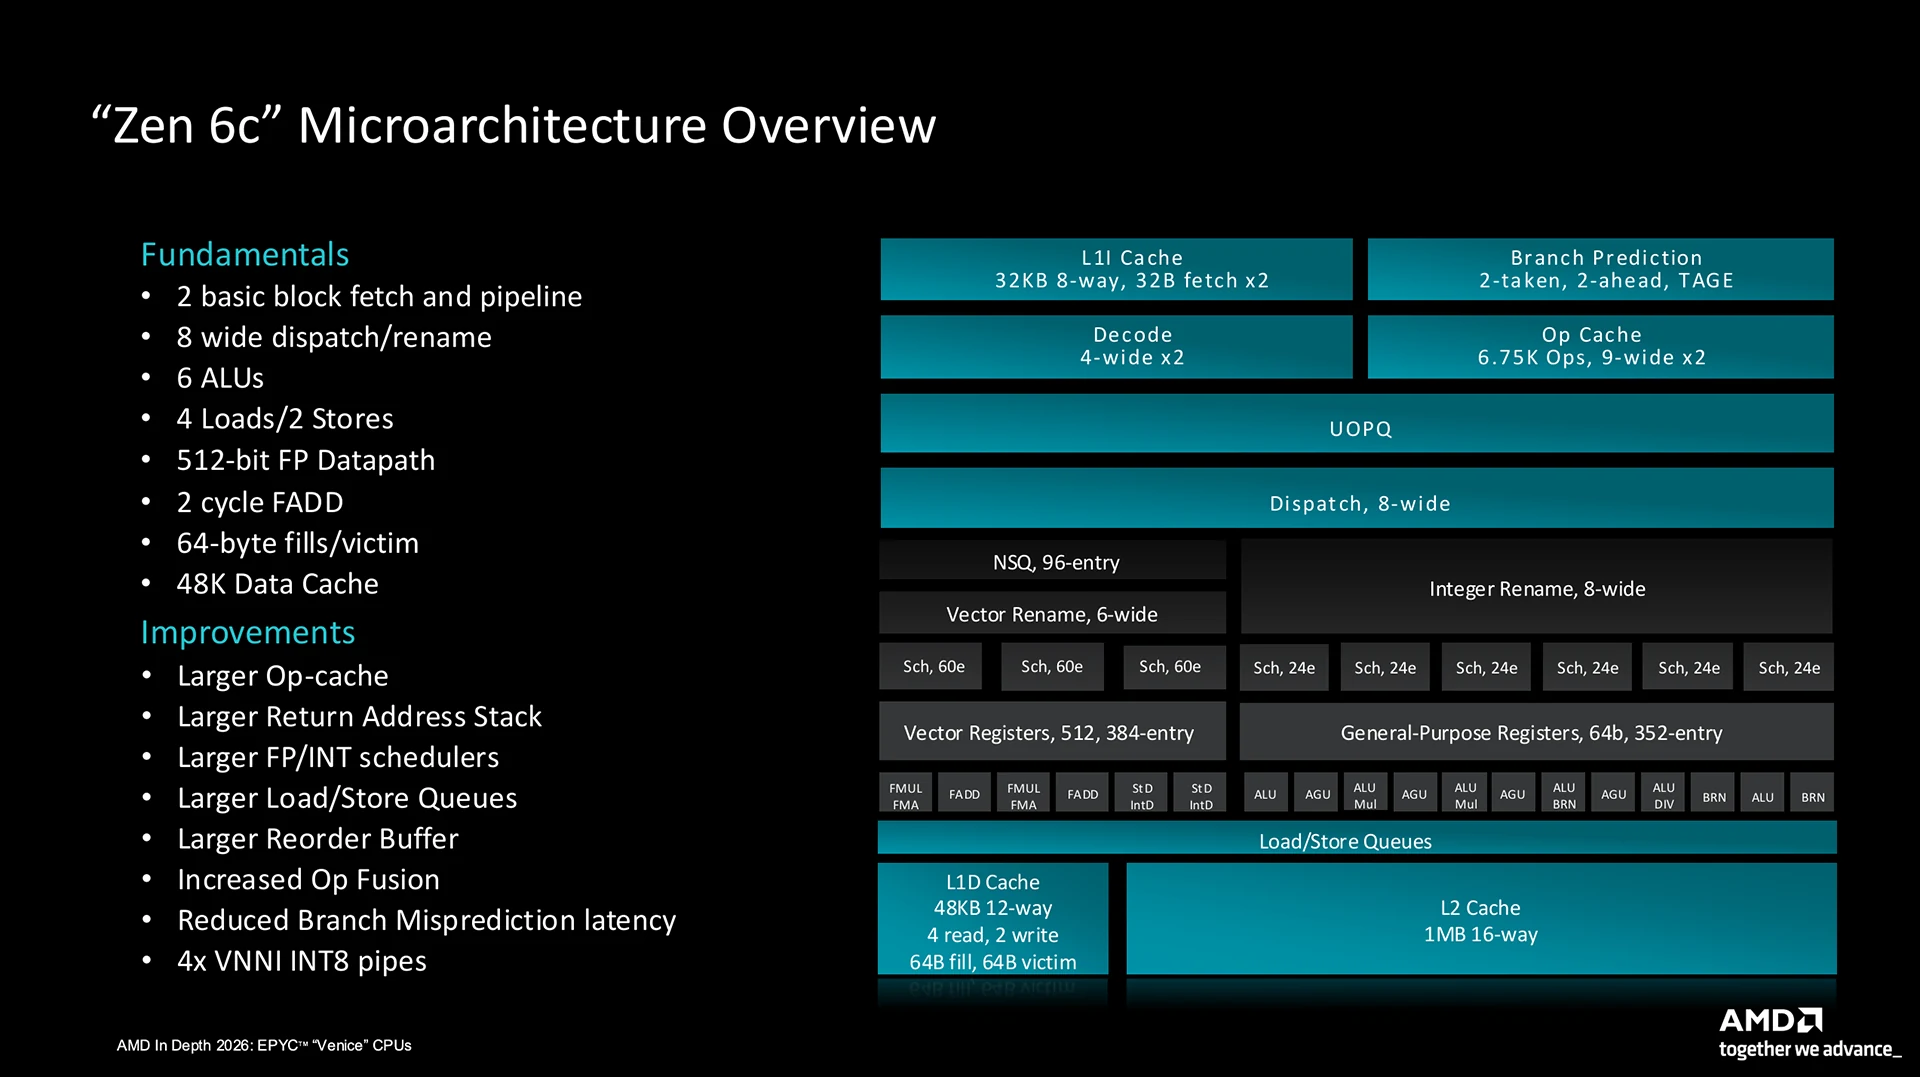
指令这边还有两处变化。512 位浮点通路保留,新增原生 AVX-512 FP16,VNNI INT8 从 2 条通道翻到 4 条。翻译成人话:半精度浮点和 8 位整数矩阵乘跑得更快,恰好是推理最常用的两种精度,这也是 AI 负载 IPC 涨幅更高的物质基础。
结构对照
把 Zen 5c 和 Zen 6c 的结构摊开对比,差距是全面的。表面看是一张参数表,实际每一项都在回答同一个问题:密度核要不要保留完整的大核能力。AMD 的答案是要,而且要比上一代的大核更宽。
| 结构 | Zen 5c | Zen 6c |
|---|---|---|
| 返回地址栈 | 52 | 64 |
| Op Cache 容量 | 6K 指令 | 6.75K 微操作 |
| Op Cache 带宽 | 12 条/周期 | 18 条/周期 |
| 整数调度器 | 统一 | 共享 + 专用 |
| AGU 调度器 | 56 | 96 共享 |
| ALU 调度器 | 88 | 96 共享 + 48 专用 |
| 整数寄存器 | 240 | 352 |
| Load 队列 | 64 | 80 |
| Store 队列 | 96 | 128 |
| 浮点调度器 | 3×38 | 3×60 |
| ROB / 退休队列 | 448 | 640 |
| 每核 L3 | 2MB | 4MB |
ROB 是重排序缓冲,乱序执行要在窗口里找能提前跑的指令,窗口越深,越能把内存延迟藏在后面。Zen 6c 的 640 比 Zen 5 大核的 448 还多出 43%,这个配置放在密度核里相当激进,说明 AMD 不打算让它只吃「后台任务」这碗饭。
Op Cache 是把解码后的微操作存起来复用,省掉重复解码,6.75K 微操作、每周期出 18 条,前端不容易饿着后端。返回地址栈管函数返回的预判,64 项够撑住深层调用。整数寄存器从 240 到 352,意味着同时能在飞的整数指令更多,编译器排得出更深的重叠。
一句话总结这条路:不是把大核砍一半,是把大核的乱序能力整建制搬过来,只砍频率和面积。同构的好处在这里兑现——指令集一样、SMT 一样、AVX-512 FP16 一样、VNNI 一样,操作系统和编译器看到的行为完全一致,不存在「这个库只在大核上快」的问题。
Apple 的 M 系列是同一种打法。频率上不去,就把流水线做宽、ROB 做深、L2 做大、分支预测做准,用每周期干的活补回频率的亏。区别在于 Apple 从一开始就不用背 x86 的历史包袱,AMD 得背,所以同样的事做起来更贵,也更慢。
Intel 的 E 核从 Gracemont 起也是这个方向,乱序、宽发射,只是没有 SMT,面积压得更狠。三家殊途同归,说明「靠拉频率和堆面积换性能」确实是贵的那条路,尤其中低负载下电费不认架构,只认瓦数。
性能折算:IPC 与面积
IPC 的口径
AMD 给的数字是:固定频率、16 个活动核,企业及云负载 IPC 提升约 20%,AI 负载约 31%,综合约 27%。IPC 是每时钟周期执行的指令数,衡量同频率下的效率,把它和频率、核心数分开看,才能判断一代架构到底进步了多少。
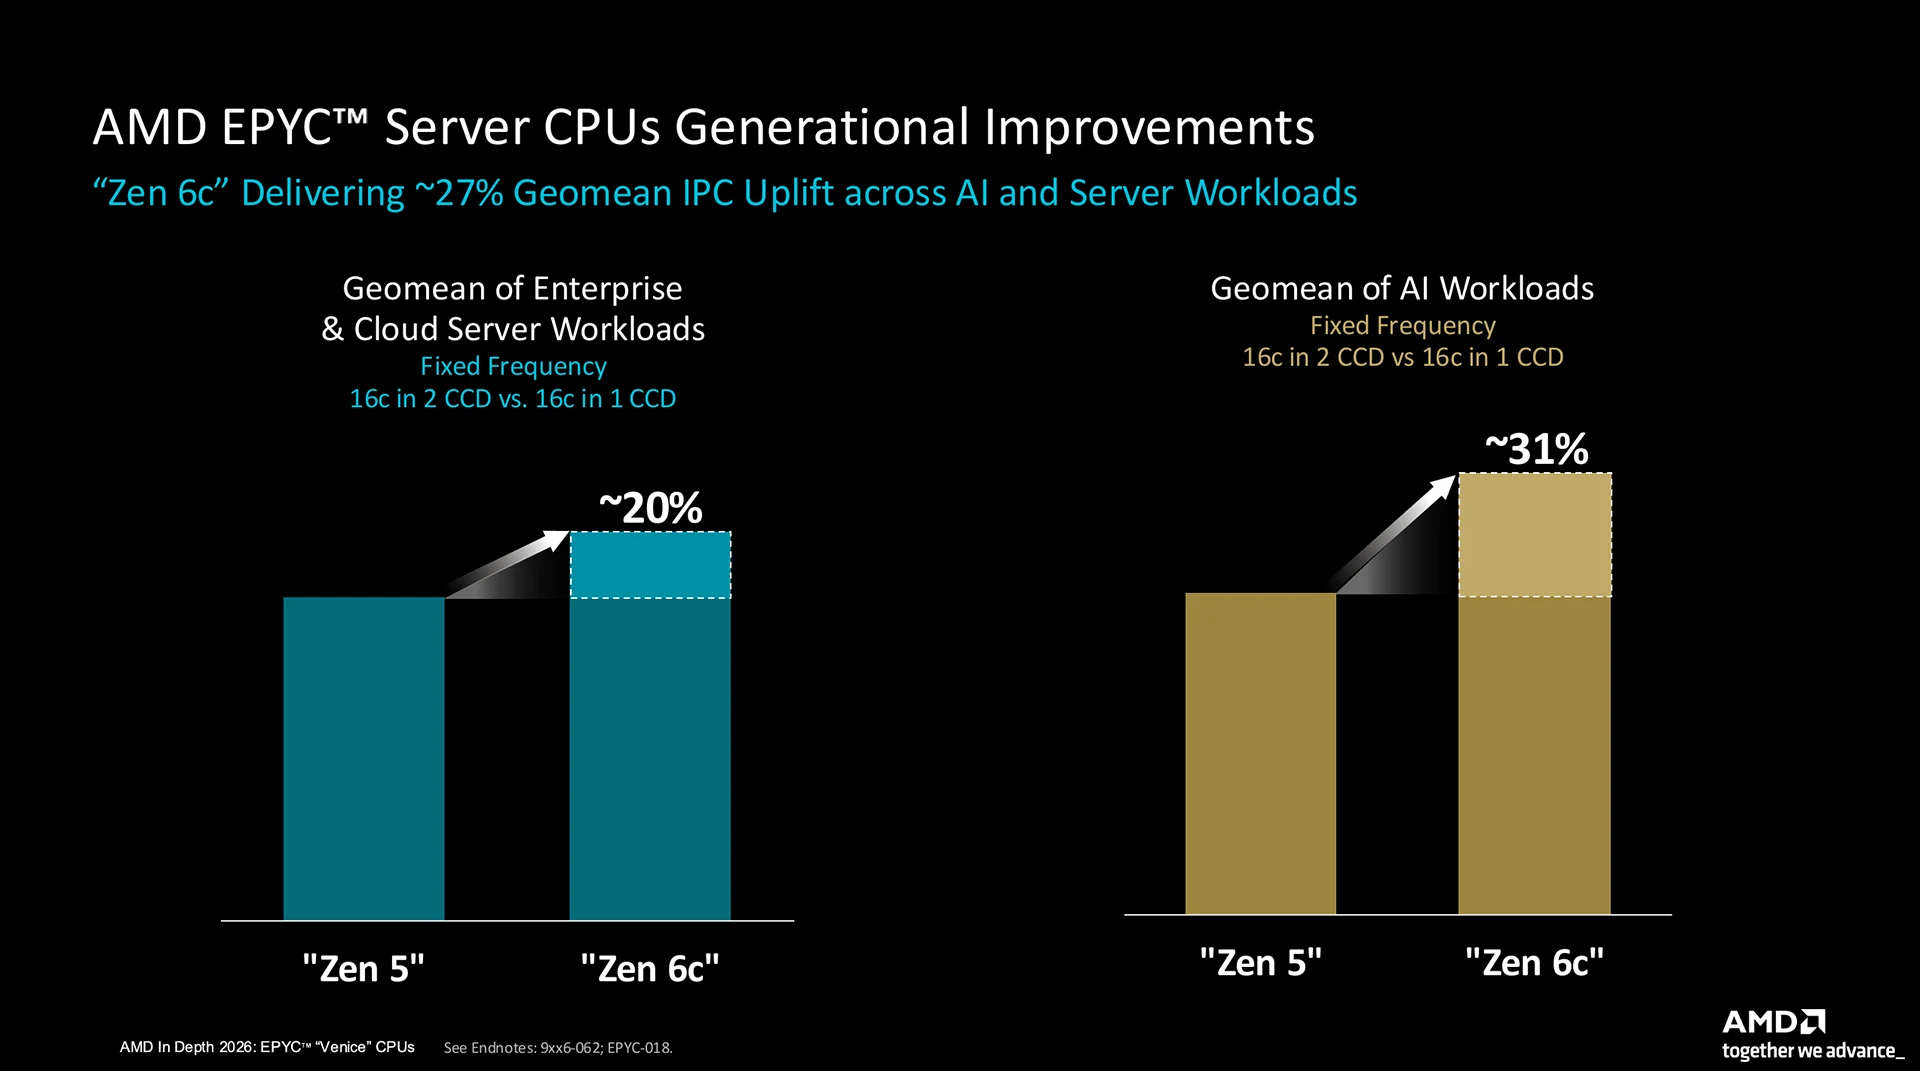
注意对比配置:16 核 Zen 6c 分散在 2 个 CCD 里,16 核 Zen 5 挤在 1 个 CCD 里。跨 CCD 访问要过 Infinity Fabric,延迟更高、带宽更紧,AMD 等于给自己出了道更难的题,做完还是赢 20%,这个结果的含金量比表面数字高。
AI 那 31% 比企业负载高出一截,我猜跟 VNNI INT8 通道翻倍有关。推理负载里有大量整数矩阵乘,正好吃这条通路,而企业负载里的分支跳转和随机访存躲不掉,涨幅自然低一些。这是推断,AMD 没有按指令类别拆开给数,写的时候得留个余地。
但 IPC 不等于实际性能,频率低、内存慢、核心少,任何一项都能把 IPC 优势吃掉,所以这个 20% 应该读成「同样的钟摆,Zen 6c 每周期多干两成活」,而不是「装到机器上就快两成」。厂商发布会最容易被误读的,就是这种效率指标。
另一个数字更容易被当成宣传语:EPYC 9996 的整数吞吐是初代 EPYC 7601 的 19.9 倍,上一代 9965 是 11.3 倍,两者相差约 76%。这是 SPECrate 2017 整数吞吐,幻灯片脚注写作 SIR17,是六代产品的累计曲线,不是单代提升。
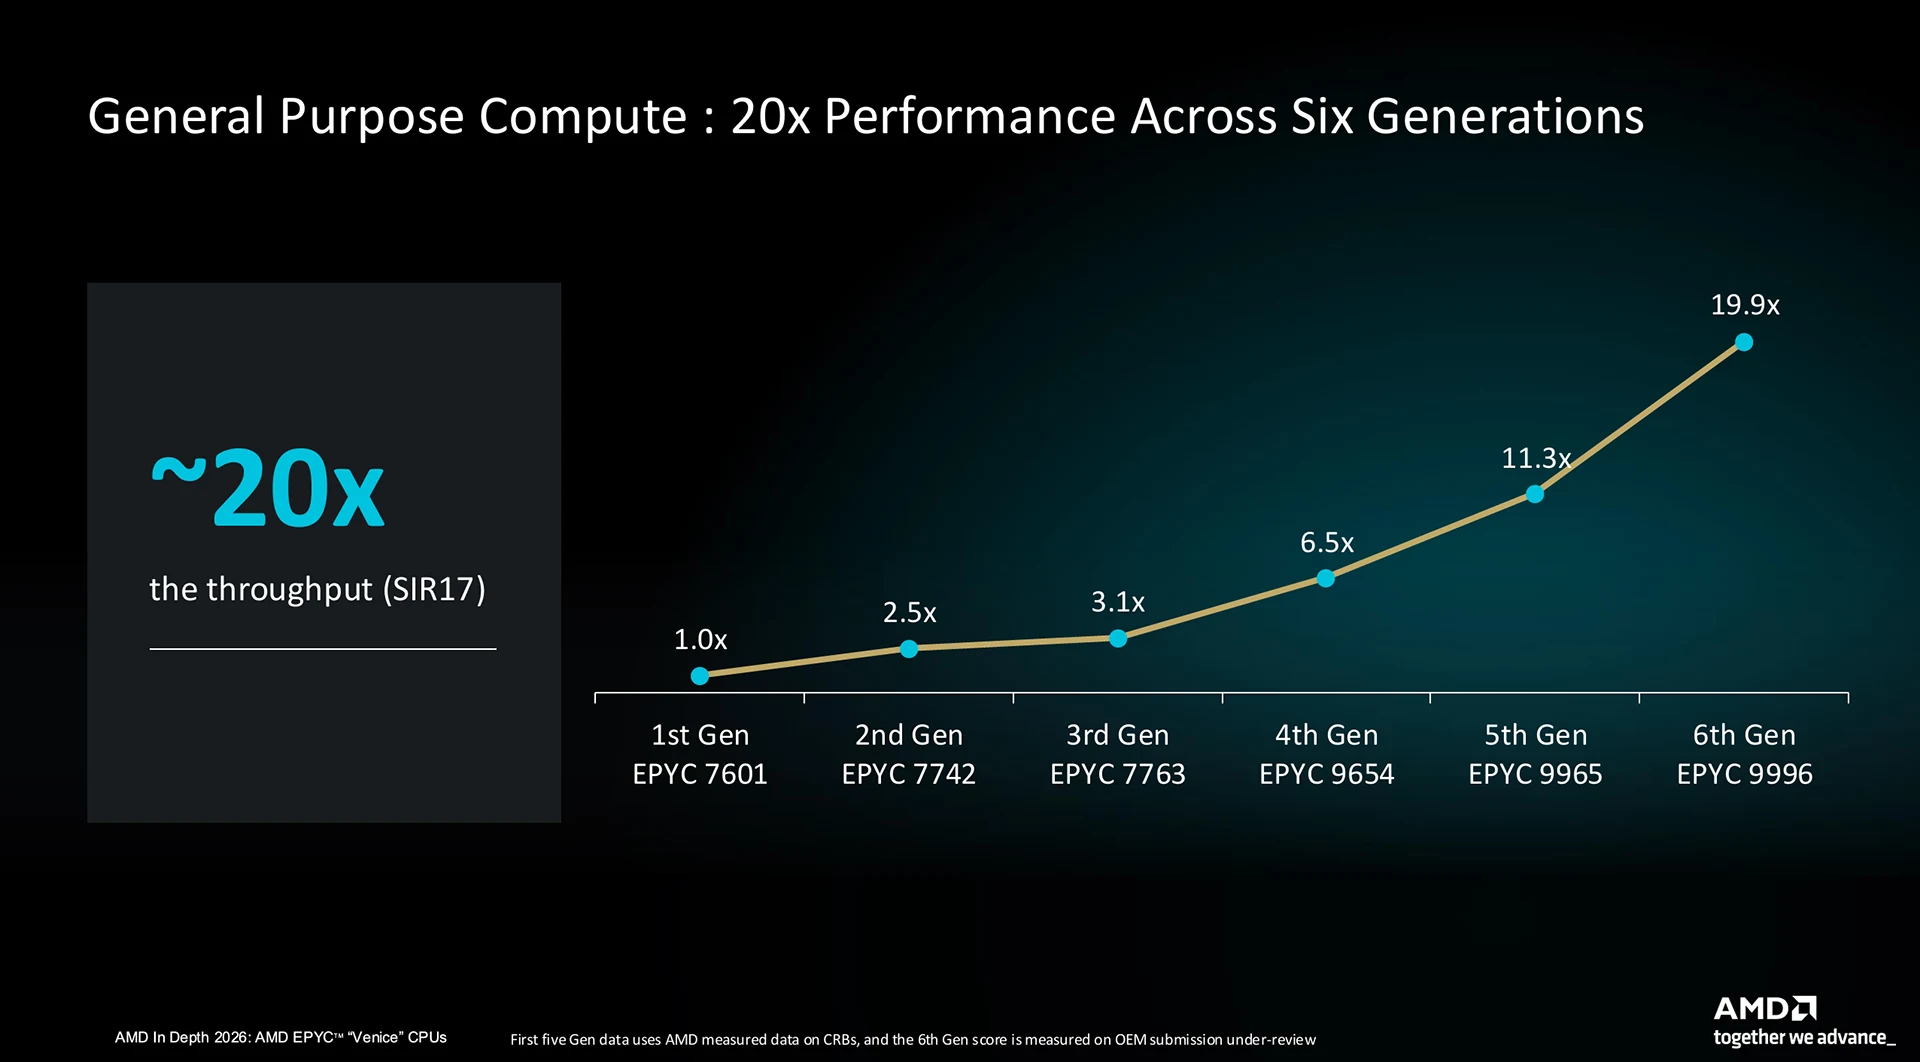
拿核心数除一下更直观:256 核对 192 核是 1.33 倍,1.76 除以 1.33 约等于 1.32,粗算下来还剩三成来自频率、缓存和架构。这个除法不严谨,内存配置、NUMA 布局、测试项权重都会影响结果,只能当量级参考,不能当结论引用。
还有个必须说的边界,幻灯片脚注写明:前五代的成绩是 AMD 在 CRB 参考板上自测,第六代 9996 是 OEM 送测、还在审核中,也就是说 19.9 倍这个终点还没被 SPEC 委员会认证。厂商发布期用送测成绩很常见,我不觉得这是造假,但把它当「已认证」引用就是另一回事了。
想看已经落地的第三方实测,可以翻我之前那篇 EPYC 9996 与 9686F 的横评,SPEC、Python、渲染、数据库上百项负载都有数,那批数据的口径比幻灯片更接近真实使用场景。
面积与频率的折算
讨论小核绕不开面积。Intel 当年给 12 代酷睿的口径是,4 个 Gracemont 核放进 1 个 Skylake 核的地盘,同功耗下多线程性能高 80%,换成单核算,一个 E 核的面积大约是大核的三分之一到四分之一,性能能到大核的六到八成,具体看负载类型。
面积还不只是「能放几个核」的问题,一片晶圆上切出来的 die 数量和面积近似成反比,良率又随面积明显往下掉,大核每多 10% 面积,付出的成本远不止 10%。密度核的优势不只是每平方毫米的性能,还有那条更平的成本曲线。
这个比例放到今天依然成立:小核在分支密集、串行依赖强的代码里吃亏,在能铺开的吞吐型任务里占便宜,数据库的连接池、Web 服务的并发请求、视频转码的分片,都属于后者。换句话说,小核不是「弱一点的大核」,是另一种性价比曲线。
| 同一个面积预算 | 1 个大核 | 3 个密度核 |
|---|---|---|
| 单线程性能 | 100 | 60–80 |
| 多线程吞吐 | 100 | 180–240(理想铺开) |
| 频率上限 | 高 | 低 |
| 可承载线程 | 2(含 SMT) | 3–6 |
| 调度复杂度 | 低 | 异构时明显上升 |
按这个模型,一个 100 分的大核,换三个 60 到 80 分的小核,账面上是 180 到 240。所以 Zen 6c 的 IPC 比 Zen 5 大核高 20%,我并不意外,密度核本来就在吃面积红利,架构上再补一刀,领先是自然结果,算不上什么奇迹。
再把频率那一头算进来。大核拉到 5.3GHz 要多付的电压和功耗,在服务器上是实打实的电费,而密度核停在 4.1GHz,用每瓦吞吐换掉了单核峰值。拿频率去换性能是最贵的一种换法,这句话在机房里比在评测室里更成立,因为机房要乘上数量和使用年限。
但账不能只算吞吐,这个模型成立的前提是任务能并行铺开,且单核延迟不重要。数据库的单条查询、编译的依赖链、游戏的单线程逻辑,都属于铺不开的那一类,这时候 60 到 80 就是实打实的损失,没有第二种解释。
AMD 的取巧在同构加 SMT:32 核 64 线程,每个核都能吃两个线程,吞吐比「32 个单线程小核」更猛。代价是每个核都要带完整前端、完整乱序窗口和 SMT 逻辑,面积压不到 Intel E 核那么小,功耗也做不到那么低,这是它选的交换条件。
小核的代价:预测打空与调度开销
分支预测打空为什么贵
现代 CPU 靠预测提前跑,猜错了要把流水线里做错的工作全部丢掉。丢多少取决于窗口深度,ROB 640 的核一次打空可能废掉几百条在飞的指令,窗口越深,猜错的单次损失越大,这是宽核绕不过去的代价,也是「小核堆 ROB」这件事最矛盾的地方。
数据库、指针追逐、脚本解释器这类代码,分支方向跟着数据走,预测器基本靠猜。索引遍历时每个节点在内存里的位置都是随机的,缓存没命中就得等内存,猜错方向就得清流水线,两种惩罚叠在一起,单核的响应时间会变得很难看。
举个具体的例子:一张几千万行的订单表,索引是 B+ 树,查一条记录要跳四五层,每层都是一次大概率不命中的访存,分支方向还取决于键值分布,预测器学不到稳定规律,大核靠更深的乱序窗口和更大的缓存把这段延迟盖住,小核只能硬扛,差距就是从这里长出来的。
这也是为什么缓存对小核特别重要。L3 命中率掉一个点,可能就是几百个周期的等待,而数据库这类负载的缓存命中率本来就靠容量撑,4MB 每核的意义正在这里,不是跑分表上那行字。AMD 把 L3 补满,补的是这个短板。
Zen 6c 在这块的补法是加 Op Cache、加深返回地址栈、降低预测延迟,幻灯片里专门列了一行「reduced branch misprediction latency」。补回来多少,得等第三方在数据库负载上实测,官方不会给这个数,因为它不好看。
异构调度的额外开销
Intel 那边是两套微架构,操作系统要知道哪个核快、哪个核省电。Windows 靠 Thread Director 的硬件提示分配线程,Linux 到 6.0 才有像样的 P 核与 E 核调度,之前的发行版跑同样的负载,成绩能差一截,这不是玄学,是调度器真的不知道该把线程放哪。
虚拟机更麻烦。vCPU 钉在哪个物理核、跨 NUMA 怎么迁、中断落在哪个核,全要人配,配错了不会报错,只会慢。这是异构在服务器上的真实成本,跑分体现不出来,账单体现得清清楚楚,运维半夜爬起来排查的也是这个。
AMD 同构的好处就在这:调度器不用猜,进程扔到哪个核行为都一样,SMT 拓扑也一致,虚拟机迁移过去不用重新调亲和性。坏处前面说过,面积和功耗省不下来,每个核都是完整的一份,省心和省电,在同构这边只能选一个。
这里要分清楚两件事:异构的开销是确定存在的工程成本,但它的大小取决于软件栈成熟度。消费级 Windows 已经把这层抹得差不多,服务器上的虚拟化平台还差得远,两者不能混着谈,拿家用平台的体验去推断数据中心的结论,方法论上就不成立。
同构与异构:省心与省电
| 项目 | Intel 异构 | AMD 同构 |
|---|---|---|
| 微架构 | P 核、E 核两套 | 一套,只切频率与面积 |
| SMT | P 核有,E 核没有 | 全核都有 |
| 面积效率 | 高,E 核约大核 1/3 | 中,密度核压不下去 |
| 单核峰值 | 高 | 略低 |
| 低负载功耗 | 低,可只开 LPE 核 | 中 |
| 软件与调度开销 | 需要系统配合 | 基本为零 |
Panther Lake 把异构的好处展示得很清楚。低负载时 P 核和 E 核全关,只留低功耗核干活,国内首测里这类机器的 SOC 功耗在 1 到 3W、整机 4W 上下,Notebookcheck 测的惠普 OmniBook X 14(酷睿 Ultra 7 356H)整机待机落在 2.6W 到 4.2W 之间。
日常办公的整机功耗 10W 出头,这个数字放在五年前的轻薄本上不可想象。异构架构、砍掉 SMT、18A 工艺,三件事叠起来才有这个结果,少任何一样都拿不到这个数,而这三样恰好都是 Intel 押了很久的方向。
砍掉 SMT 之后,单核性能全靠 P 核硬顶,而 P 核面积又小不下来,于是同一块 die 上要摆两种核、两套缓存层级、一套调度硬件。芯片复杂度上去了,验证成本也上去了,这些钱最后都会进售价,也进驱动和固件的维护成本。
AMD 选的是另一条:所有核一样,SMT 一样,缓存一样,靠频率和 CCD 数量切产品。省心是真的省心,客户迁移过来不用改一行调度代码,代价是每瓦性能只能靠制程和架构一点点抠,抠不出 Intel 那种「待机 3W」的戏剧性数字。
核心多了,频率就更难维持,256 个核同时冲高频,功耗会立刻顶到插槽上限,所以这类芯片的全核频率通常比标称低不少,标称数字只在少量核激活时成立,看服务器 CPU 的参数,得先分清那是单核、全核还是短时睿频。
从采购角度看,这笔账还要乘上时间。一批服务器用五年,电费和运维人力是持续支出,芯片贵的那点钱反而是一次性的,所以同构方案在「不知道自己会跑什么」的客户那里更容易过评审,异构方案更适合负载明确、机型固定的场景。
我的判断是这两条路都对,只是适配的场景不同。消费级要待机功耗和瞬时响应,异构划算,服务器要可预测的吞吐和低的迁移成本,同构划算。把一边的标准套到另一边,结论一定是错的,这也是网上那些大小核吵架帖吵不出结果的根本原因。
家用平台跑数据库是个伪需求
网上讨论大小核,最常见的论据是「数据库场景异构调度会崩」。我不认同把这个当成消费级选购的理由,因为它描述的是一个几乎不存在的使用场景,用数据中心的毛病去否定一台家用电脑,逻辑上就先错了。
没有哪个 IT 会拿家用 CPU 跑生产数据库、OA 或者域控。真要跑,虚拟化平台上至少是至强或者 EPYC,内存带 ECC,硬盘做 RAID,谁会拿一台 16 核桌面芯片扛这些。真扛了,出事也不是调度的锅,是选型的锅。
专业 3D 渲染同样不会用家用平台。双通道内存带宽卡在 100GB/s 上下,CPU 吃不到数据,渲染器优化得再好也白搭,这种瓶颈不是换个大核就能解决的。这类活要么上工作站平台,要么直接上服务器,跟大小核没关系。
游戏是另一个常被拿来举例的场景:异构平台把后台线程赶到 E 核,前台渲染留在 P 核,1% 低帧确实更稳,可这点收益在 1080p 高帧下才明显,4K 分辨率下显卡先撞墙,把它当成「必须买异构」的理由,同样站不住。
学习用途倒是真的普遍,大学虚拟化课程、网络实验、搭个域控练手,AMD 和 Intel 用下来没什么区别,卡住你的永远是内存够不够——32GB 起步,64GB 舒服,16GB 开三个虚拟机就开始交换,硬盘灯一直亮,换什么 CPU 都救不了。
这两年换电脑的人容易被「AI PC」「大小核」这些词带着走,实际体验的差别更多来自内存容量、硬盘速度和散热设计。我的排序是同价位先加内存,再看核显,最后才轮得到核心数,多 16GB 内存带来的感知,通常比多两个小核实在。
所以消费级该看的东西很清楚:单核响应、待机功耗、核显够不够用、内存能不能插满,以及散热压不压得住。至于异构调度开销,等你真在跑数据库的那天,你手里的芯片也不会是桌面那颗。
反过来也一样。把家用那套「待机 3W 很爽」的逻辑套到服务器上同样荒谬,机房里没人关心待机功耗,关心的是满载每瓦吞吐、机架密度、以及出故障时能不能热插拔,同一个指标换个场景,重要性可以差出十倍。
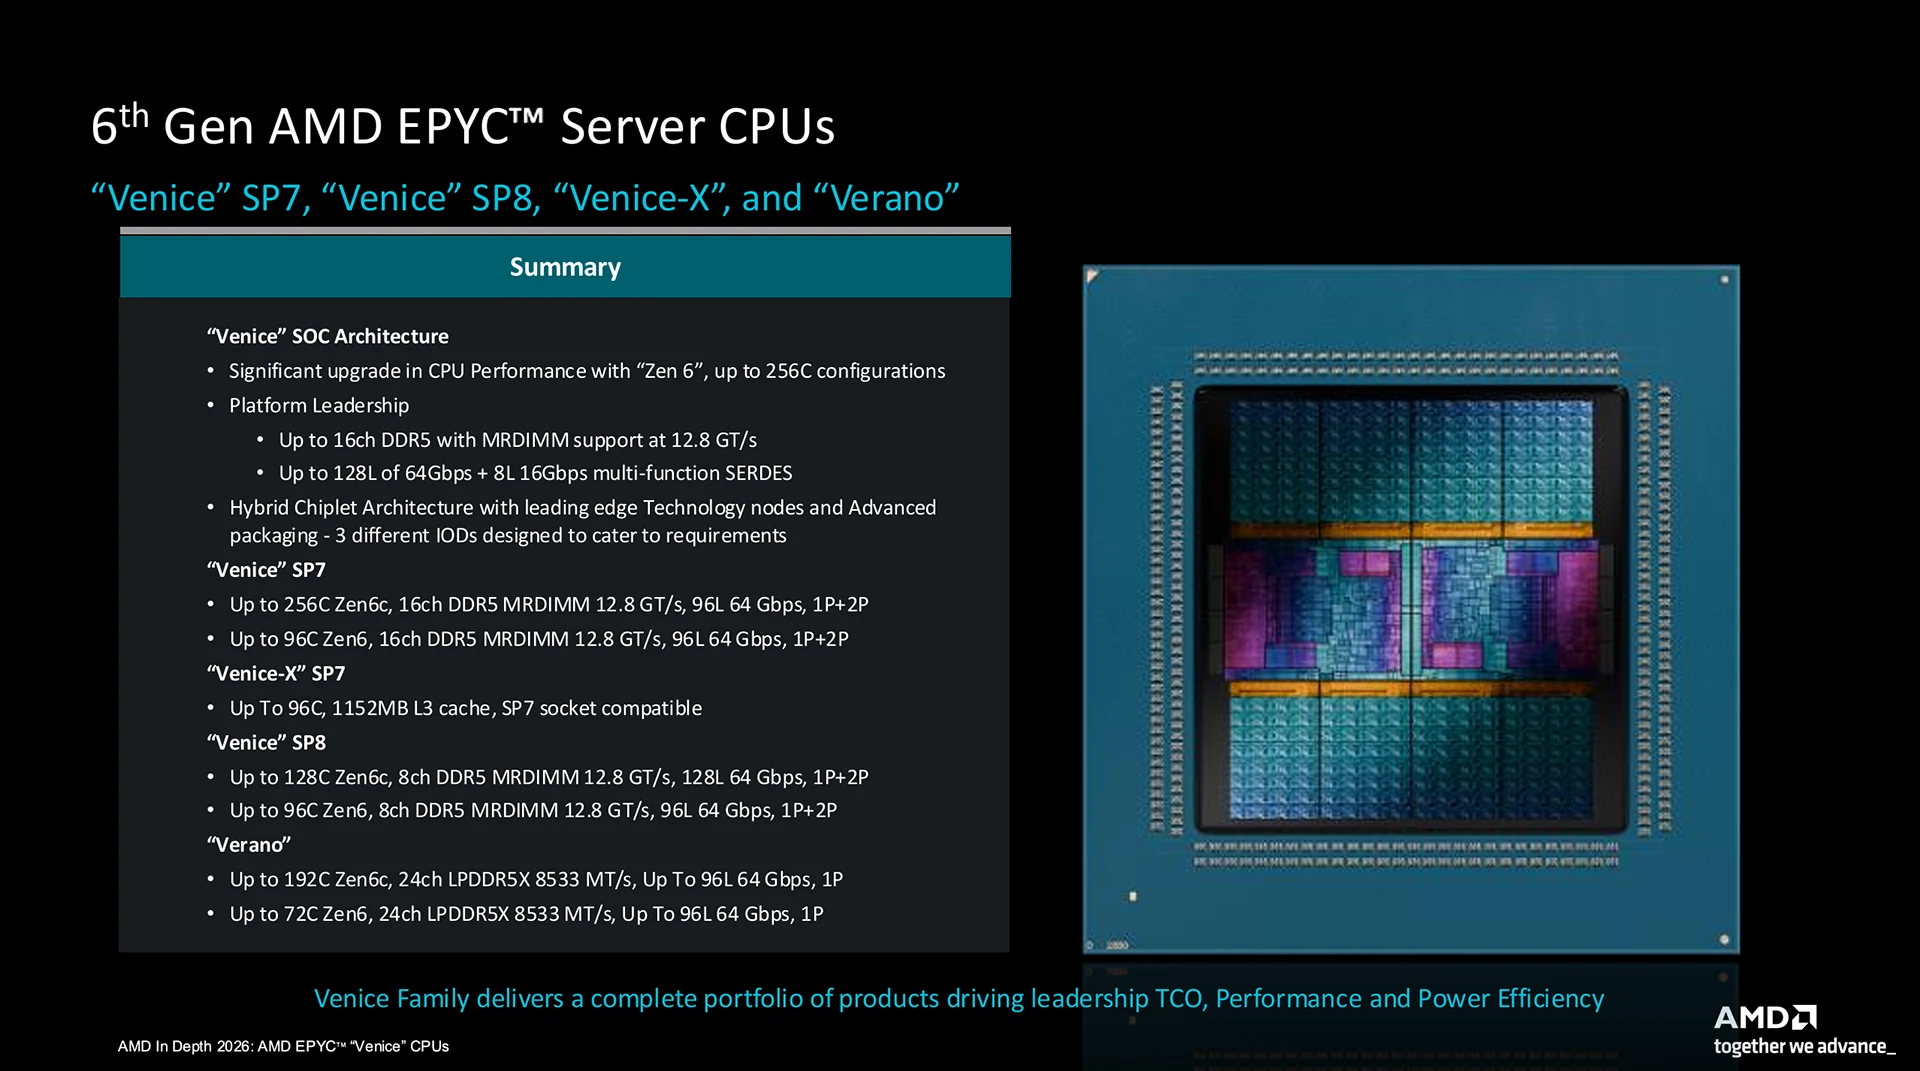
说完消费级,回到这代产品本身。EPYC 9006 分了四条线:SP7 主打 AI 数据中心,256 核 Zen 6c 和 96 核 Zen 6 双版本。SP8 是企业通用版,8 到 128 核、8 通道内存、128 条 PCIe 6.0。
9006X 带 1152MB 3D V-Cache,给缓存敏感的仿真和预处理。Verano 用 LPDDR5X,走低功耗机架路线。这四条线基本覆盖了从训练集群到边缘机架的全部场景,同一代核心切出四种形态,比只堆一个旗舰型号的覆盖面宽得多。
明年 PC 上能不能见到 12 核 CCD 的 Zen 6、能不能见到 4MB L3 的 Zen 6c,我猜会见到,但比例不会像服务器这么激进。桌面只有双通道内存,塞 32 个核进去,带宽先撑不住,核心数不是想加就能加,得看内存给不给饭吃。
移动端已经在往这个方向走,之前 Geekbench 里露出的 Medusa Point 样品就是 Zen 6 加 Zen 6c 的混合配置,10 核里 4 个大核配 6 个密度核,比例相当悬殊,那批数据的可信度我单独写过一篇分析,这里不重复。
我真正想看的是两件事:一是 12 核 CCD 配上 3D V-Cache 之后,游戏和编译这些吃缓存的负载能涨多少,二是 Zen 6c 上了笔记本,4MB L3 能不能把「小核只配跑后台」这个印象改掉,这比多两个核有意义得多。
有人会说 AMD 这是偷懒,一套架构改改频率就交差。我不这么看,同构要付的代价一点不少,面积压不下去、待机功耗做不到 3W、每瓦性能只能靠制程硬抠,这些都不是省事的选项。它只是把复杂度从软件挪回了硬件,哪边更划算,取决于你站在机房还是站在桌面。
等实测吧。厂商的幻灯片负责给方向,第三方数据负责给答案,这两样从来不是一回事。AMD 这次把 Zen 6c 讲得比 Zen 6 还细,态度已经摆出来了:服务器市场买的是每平方毫米的吞吐,不是每颗核的峰值频率。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING