





AMD Zen 6 的第一份实测数据出来了。Tom's Hardware 拿 EPYC「Venice」系列的两款核心型号做了一轮横评——256 核的 EPYC 9996 和 96 核的 EPYC 9686F,覆盖 SPEC、Python、Java、HPC、渲染、数据库、编译等上百项负载。
结论有两层:整数吞吐较上代提升 93%,接近翻倍,但其中相当一部分来自核心数翻倍,不是纯架构红利;更有意思的是 Zen 6 与 Zen 6c 共用一套微架构,这与 Intel 大小核各做一套的做法完全相反。
先把证据等级说清楚:SPEC CPU 2026 的成绩全部是估算值,没有提交 SPEC 委员会认证;制程与 IPC 数据来自 AMD 官方公布;其余实测结果来自 Tom's Hardware 的测试平台。下文所有百分比都按这个口径读。
架构变化
Zen 6 计算核心用台积电 N2P 制程,这是 N2 的优化版本,性能比基础版 N2 高 5%。
按 AMD 公布的数据,N2P 相对 N3E 在相同功耗下性能提升 18%,或在相同性能下功耗降低 36%,密度同时提升 15%。上一代 Zen 5 用的是 N4P。制程每代的实际收益都靠这些百分比堆出来,但它们是厂商在典型场景下的口径,不等于任何一颗芯片的表现。
微架构层面,AMD 给出的 Zen 6 平均 IPC 提升是 27%。IPC 是每时钟周期执行的指令数,衡量同频率下的性能,把它和频率、核心数分开看,才能判断一代架构到底进步了多少。这个 27% 针对企业、云与 AI 负载,基于固定频率下 16 核 Zen 5 与 Zen 6c 的对比得出,不覆盖所有应用。
核心内部有两处改动值得单独说。一是向量通路延续 Zen 5 的 512 位宽度,新增原生 AVX-512 FP16 半精度指令支持——Zen 5 上这类指令要靠转换执行,现在直接支持。二是整数调度器从统一架构拆成共享 ALU/AGU 与专用 ALU 两组,容量一并提升;物理寄存器文件从 240 项扩到 352 项,飞行中的 load/store 队列也加了深度。
缓存层级保持 48KB L1d、1MB 私有 L2,共享 L3 依旧充当 L2 的受害者缓存。受害者缓存的意思是:数据被 L2 挤出来时先放进 L3,而不是直接回内存,下次命中还能就近取,省一次长途往返。
Zen 6 与高密度的 Zen 6c 用同一套微架构,只在频率、功耗和 die 面积上做密度优化。Intel 的大小核是两套不同的微架构,P 核和 E 核指令集兼容但内部完全不同——Nova Lake 那批 28 核样品就是 8P + 16E + 4LPE 的混合配置;AMD 这条路是同一套设计压两次面积,软件看到的指令行为一致,调度器不用猜哪个核快。
CCD 密度提升是这一代最直观的变化。CCD 是核心复合芯片,AMD 把核心和对应的 L3 做成一块小 die,一颗处理器由多个 CCD 加上 IOD 拼成,核心数想加就多放几块。两代的对比如下:
- 标准 Zen 6 CCD:12 核上限(Zen 5 为 8 核),每核 4MB L3,单 CCD 共 48MB,Venice 上的频率上限 5.3GHz。
- Zen 6c CCD:32 核上限(Zen 5c 为 16 核),每核 L3 从 2MB 提到 4MB,单 CCD 共 128MB,频率上限 4.1GHz。
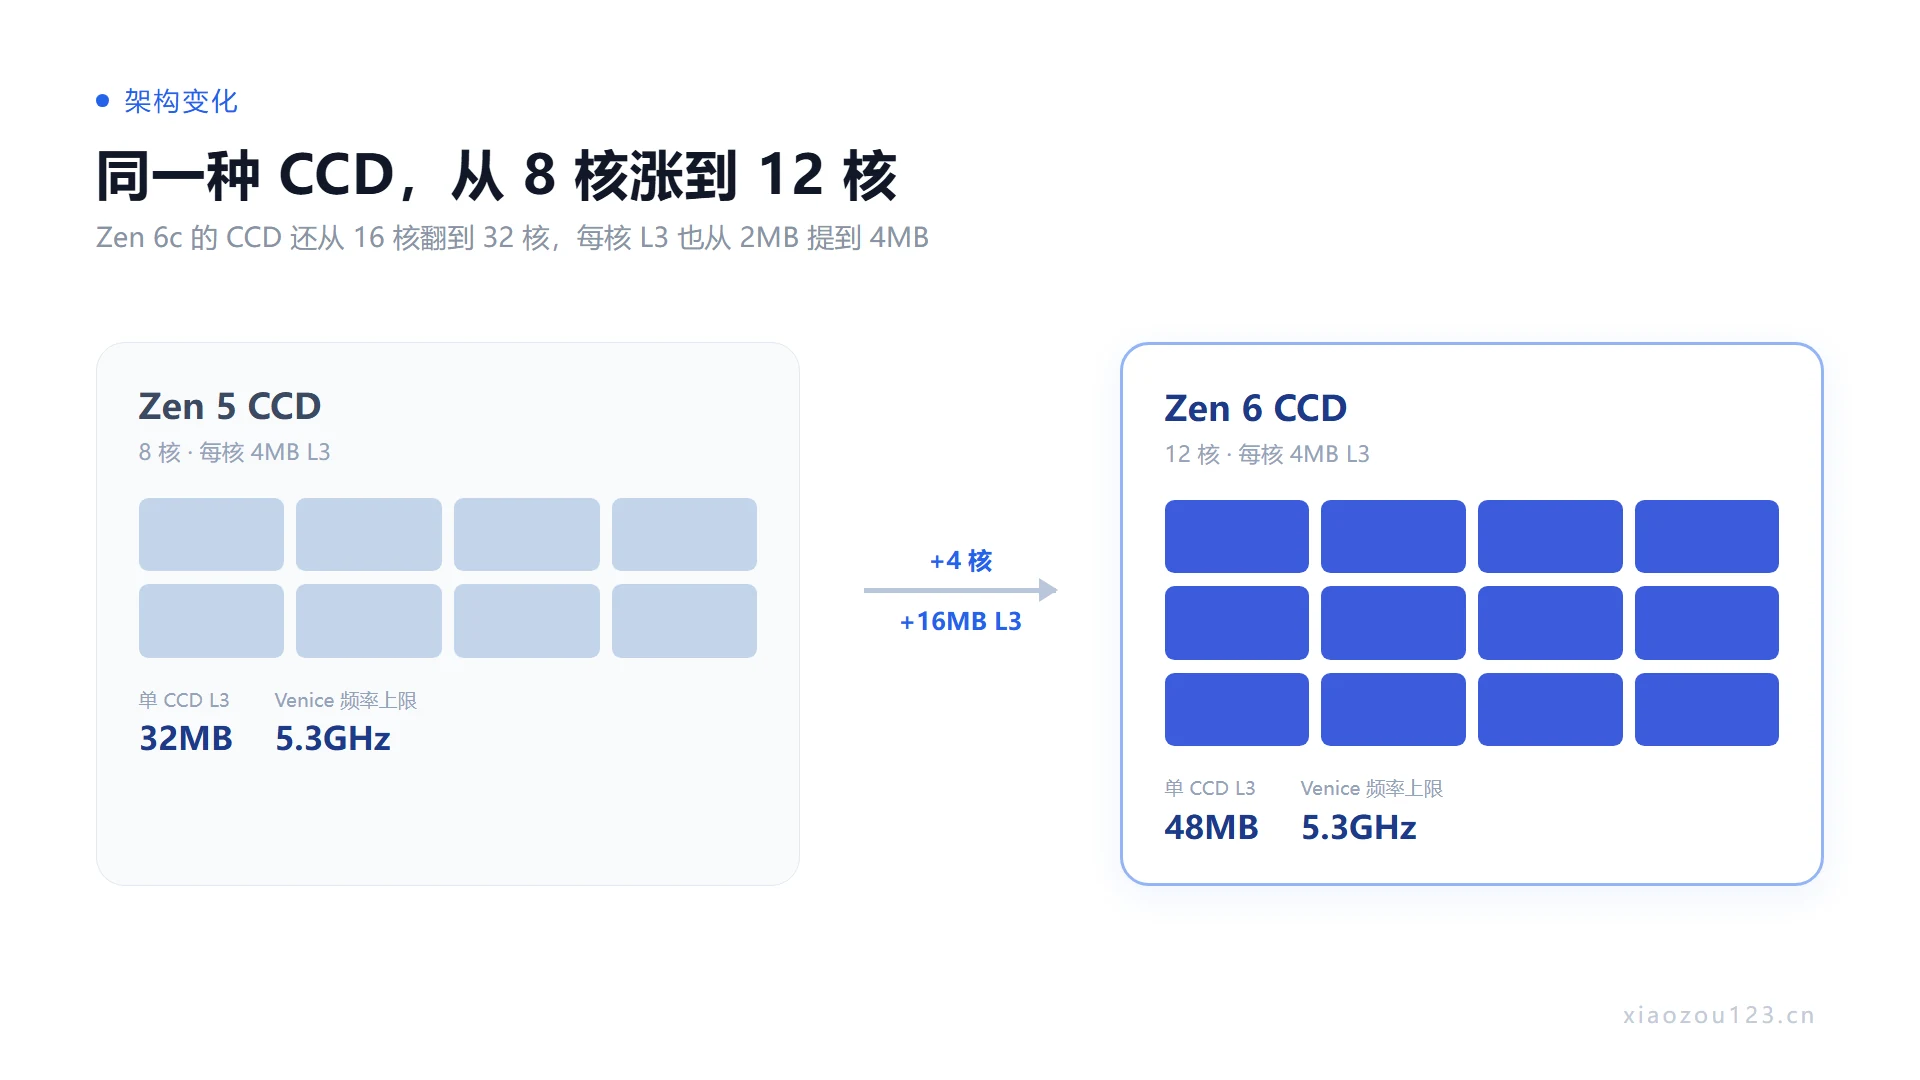
单颗 Venice 能挂 8 个 CCD,所以 SP7 平台上 Zen 6c 型号顶到 256 核,标准 Zen 6 型号 96 核封顶。这两个数字后面会反复出现,记住 256 和 96 就行。
平台与互连
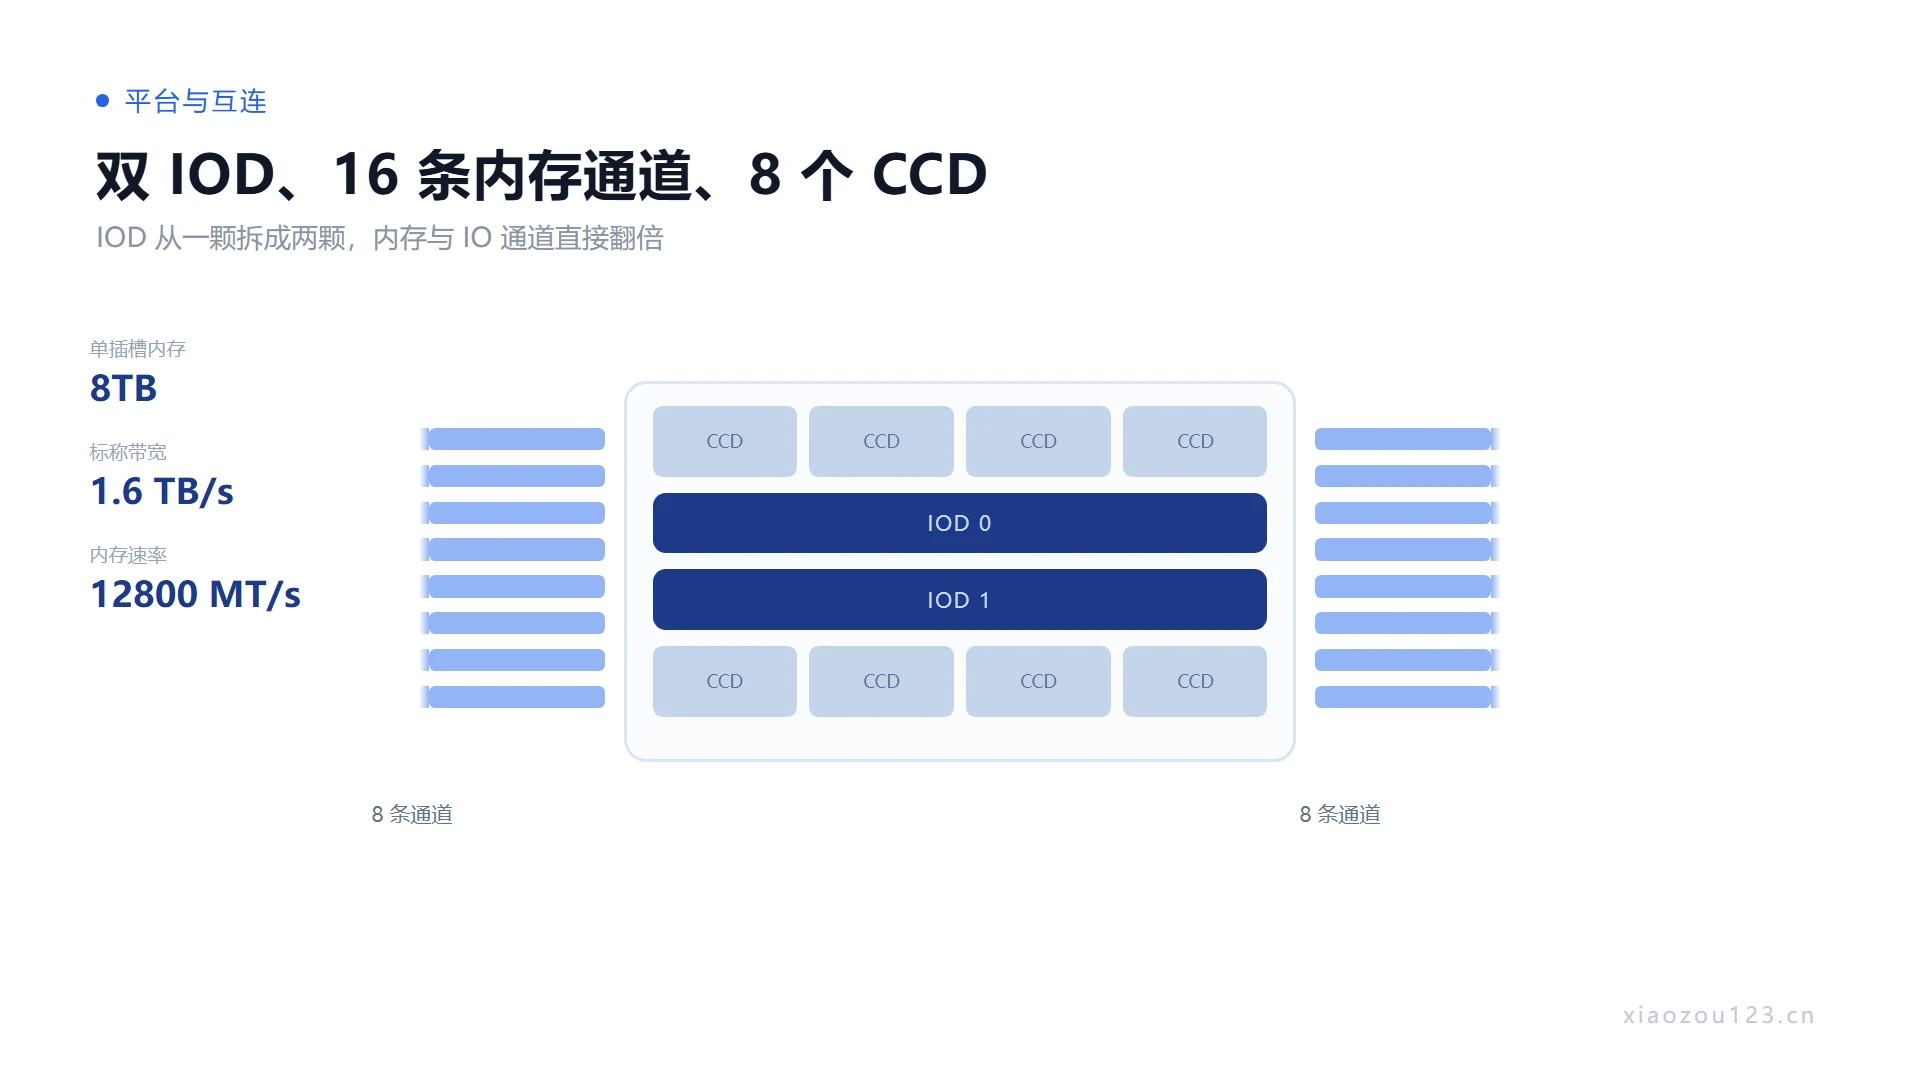
封装层面有一处明显变化:从单 IOD 改成双 IOD。IOD 是输入输出芯片,内存控制器、PCIe、CXL 这些对外接口都挂在它上面,相当于处理器的南北桥。多加一颗 IOD,内存通道和 IO 通道直接翻倍,这是 Venice 平台能力跃升的物理来源。
首发平台 SP7 面向高核心数数据中心。单颗处理器 16 条内存通道(每个 IOD 8 条),支持 12800 MT/s 的 MRDIMM(1DPC 配置)与 8000 MT/s 的 RDIMM。单插槽 8TB 内存,AMD 标称 MRDIMM 下带宽 1.6TB/s。
MRDIMM 是带多路复用缓冲的服务器内存模组,靠一次传输两组数据把有效速率推高,代价是延迟和成本;RDIMM 则是更常规的带寄存器模组,速率低一档但便宜、生态成熟。同一块板子上两种都能插,怎么配取决于应用更吃带宽还是更吃延迟。
IO 侧上到 PCIe 6.0,单 lane 64Gbps。单路给 96 条 PCIe 6.0 通道,双路 128 条;另外单独留了 8 条(单路)或 16 条(双路)PCIe 4.0,用来挂那些还没跟上新总线的老设备。全平台支持 CXL 3.1,IOD 里还集成了硬件根信任和机密计算扩展。
CXL 是建立在 PCIe 物理层上的缓存一致性互连协议,3.1 版本支持内存池化和多级交换。说白了,它让 CPU 能访问插在 PCIe 槽上的内存和加速器,且保持缓存一致,是这几年服务器平台扩展内存容量的主要手段。
除 SP7 之外还有 SP8:插槽更小,只给 8 条内存通道,但 PCIe 6.0 通道更多——单路 128 条,双路 192 条,同样支持 CXL 3.1。这是给不需要海量内存、但需要大量加速器和网卡的场景准备的,按计划未来数月内推出。
两款 SKU 规格
本次测试的两颗都是 SP7 双路配置,规格差异正好代表两种设计取向:
| 项目 | EPYC 9996 | EPYC 9686F |
|---|---|---|
| 核心类型 | Zen 6c | 标准 Zen 6 |
| 核心 / 线程 | 256C / 512T | 96C / 192T |
| L3 缓存 | 1024MB | 384MB |
| 频率 | 未披露(CCD 上限 4.1GHz) | 加速 5GHz |
| TDP | 600W(400–600W 可调) | 500W(400–600W 可调) |
| 定位 | 高并发吞吐 | 单线程与向量性能 |
9996 是堆核心的那一款:单颗 256 核 512 线程,1024MB L3,双路拼起来 512 核 1024 线程。这个规模的芯片不谈单核,卖点就是同一台机器里塞进更多并发任务。
9686F 走的是反方向。后缀 F 代表高频,单颗 96 核 192 线程,加速到 5GHz,384MB L3,TDP 500W。它面向科学计算、HPC 和 AI 主机,这些负载对单线程和向量性能更敏感,多给一倍核心反而不如把频率拉上去。
基准测试结果
先看 9996:双路 EPYC 9996 在 SPEC CPU 2026 整数吞吐(intrate)中比上代双路 EPYC 9965 高 93%,而 9965 是 192 核 384 线程、双路 768 线程。intrate 是同时跑多份相同任务的成绩,天生放大多核心收益,所以 93% 这个数要先打个折:核心数从 384 涨到 512,架构又进步了一截,两部分叠在一起才有这个结果。
其他多线程负载的幅度更接近真实体验。Blender 渲染比 9965 快 30% 到 40%,按场景不同浮动;Stockfish 国际象棋引擎提升接近 50%。这两个测试更接近"把活干完要多久",参考价值高于吞吐类分数。
9686F 这边,Tom's Hardware 把它和英伟达的服务器 CPU Vera 以及上代 EPYC 9755(128 核)放在一起比。结果整理成表更清楚:
| 测试项 | 对 Vera | 对上代 9755 |
|---|---|---|
| SPEC CPU 2026 整数吞吐 | +17% | +19% |
| SPEC CPU 2026 浮点吞吐 | +40% | — |
| SPEC CPU 2026 整数速度 | +21% | — |
| PyBench(Python) | +32% | +35% |
| SciMark(Java) | +92% | — |
| CloverLeaf(HPC) | 约 2 倍 | — |
| FFTE(HPC) | 接近 2 倍 | — |
值得盯的是"对上代"那一列:9686F 只有 96 核,9755 是 128 核,核心更少还领先 19%,说明这一代的单核效率确实提上来了,不再是靠堆核心数撑分数。
压缩、编译、渲染这些通用负载里,9686F 也都处在第一梯队,没有明显短板。
内存子系统表现
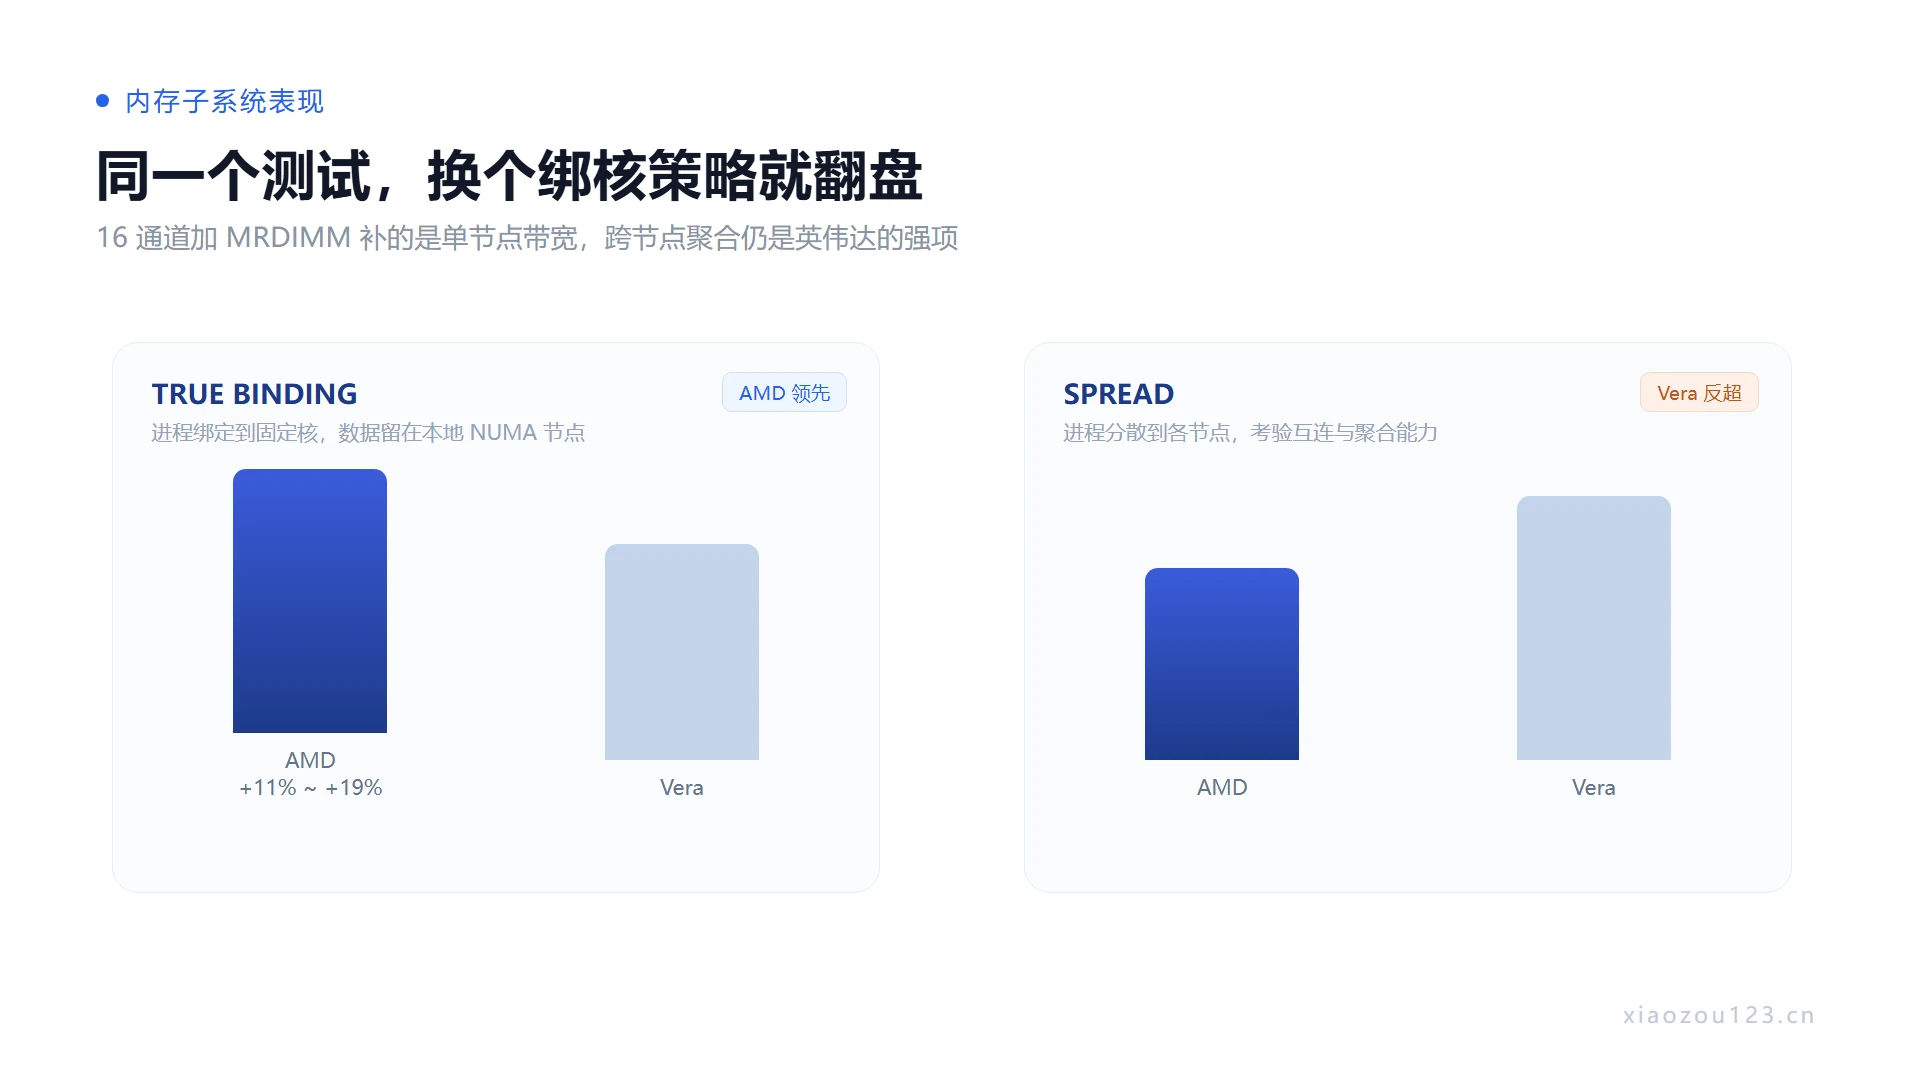
这一节没有绝对的胜负,结果跟着测试策略走:
- STREAM:用 OpenMP 的 true 策略(进程绑定到固定核)时,AMD 平台内存带宽领先 Vera 11% 到 19%;换成 spread 策略(进程分散到各节点)后,Vera 反超。
- MBW:小阵列(128MB)下 9996 小幅领先,阵列规模一大,Vera 就翻上来了。
这两种策略测的不是一回事。绑定让数据尽量待在一个 NUMA 节点的本地内存里,考验单节点带宽;分散则是故意把流量打散到多个节点,考验互连和聚合能力。Vera 在分散模式下赢,说明它的跨节点访存路径更顺,而 EPYC 的优势在单节点带宽够宽。
结论是 16 通道加高速 MRDIMM 确实补强了 EPYC 的内存子系统,但补在哪一段要看应用:访存密集且能绑核的负载吃得到,跨节点共享数据的负载未必。选型时拿自己的实际负载跑一遍,比看 STREAM 榜首有用。
产品布局与后续规划
Venice 这代的产品逻辑很清楚:不用一颗芯片打天下,而是拿标准 Zen 6 与 Zen 6c 两种核心、SP7 与 SP8 两种平台,交叉组合出不同定位的 SKU。9996 走吞吐,9686F 走单线程和向量,中间还有大量按核心数与频率切出来的型号。
按 AMD 公布的规划,明年还有两款衍生品:带 3D V-Cache、面向 HPC 的 Venice-X,以及用 LPDDR5X SOCAMM2 可更换内存的 Verano 平台。前者堆缓存换命中率,后者换的是内存形态和功耗。
对手也在路上。Intel 的 Diamond Rapids 预计明年发布,服务器 CPU 的竞争格局大概率要重新排一次。
回到这次测试本身:Zen 6 靠微架构调整、CCD 密度提升和平台 IO 升级三件事叠加,在多数通用服务器负载上交出了明确的代际进步。但 93% 这个数字别直接拿去当宣传语——它是核心数翻倍和架构进步的合计,拆开看,架构那一部分的贡献远小于它给人的印象。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING