





英伟达在 SC26 大会上给 Rubin 家族添了一个新名字:Rubin HPC。CUDA 核心数超过五万个,是这家公司目前所有 GPU 里最多的,预计 2028 年上市。
但决定它能不能干活的几项参数——HBM 容量与带宽、FP64 双精度怎么配、芯片怎么封装——一个都没公布。现在能确定的只有规模,不是性能。
英伟达给它的定位是面向处理大规模数据集的科学家、工程师和分析师,主打智能体工作流与仿真任务的加速。
核心规格
官方给的数字是「超过 50000 个 CUDA 核心」。作为参照,当前标准款 Rubin GPU 是 224 个 SM、28672 个 CUDA 核心,两者相差约 74%。
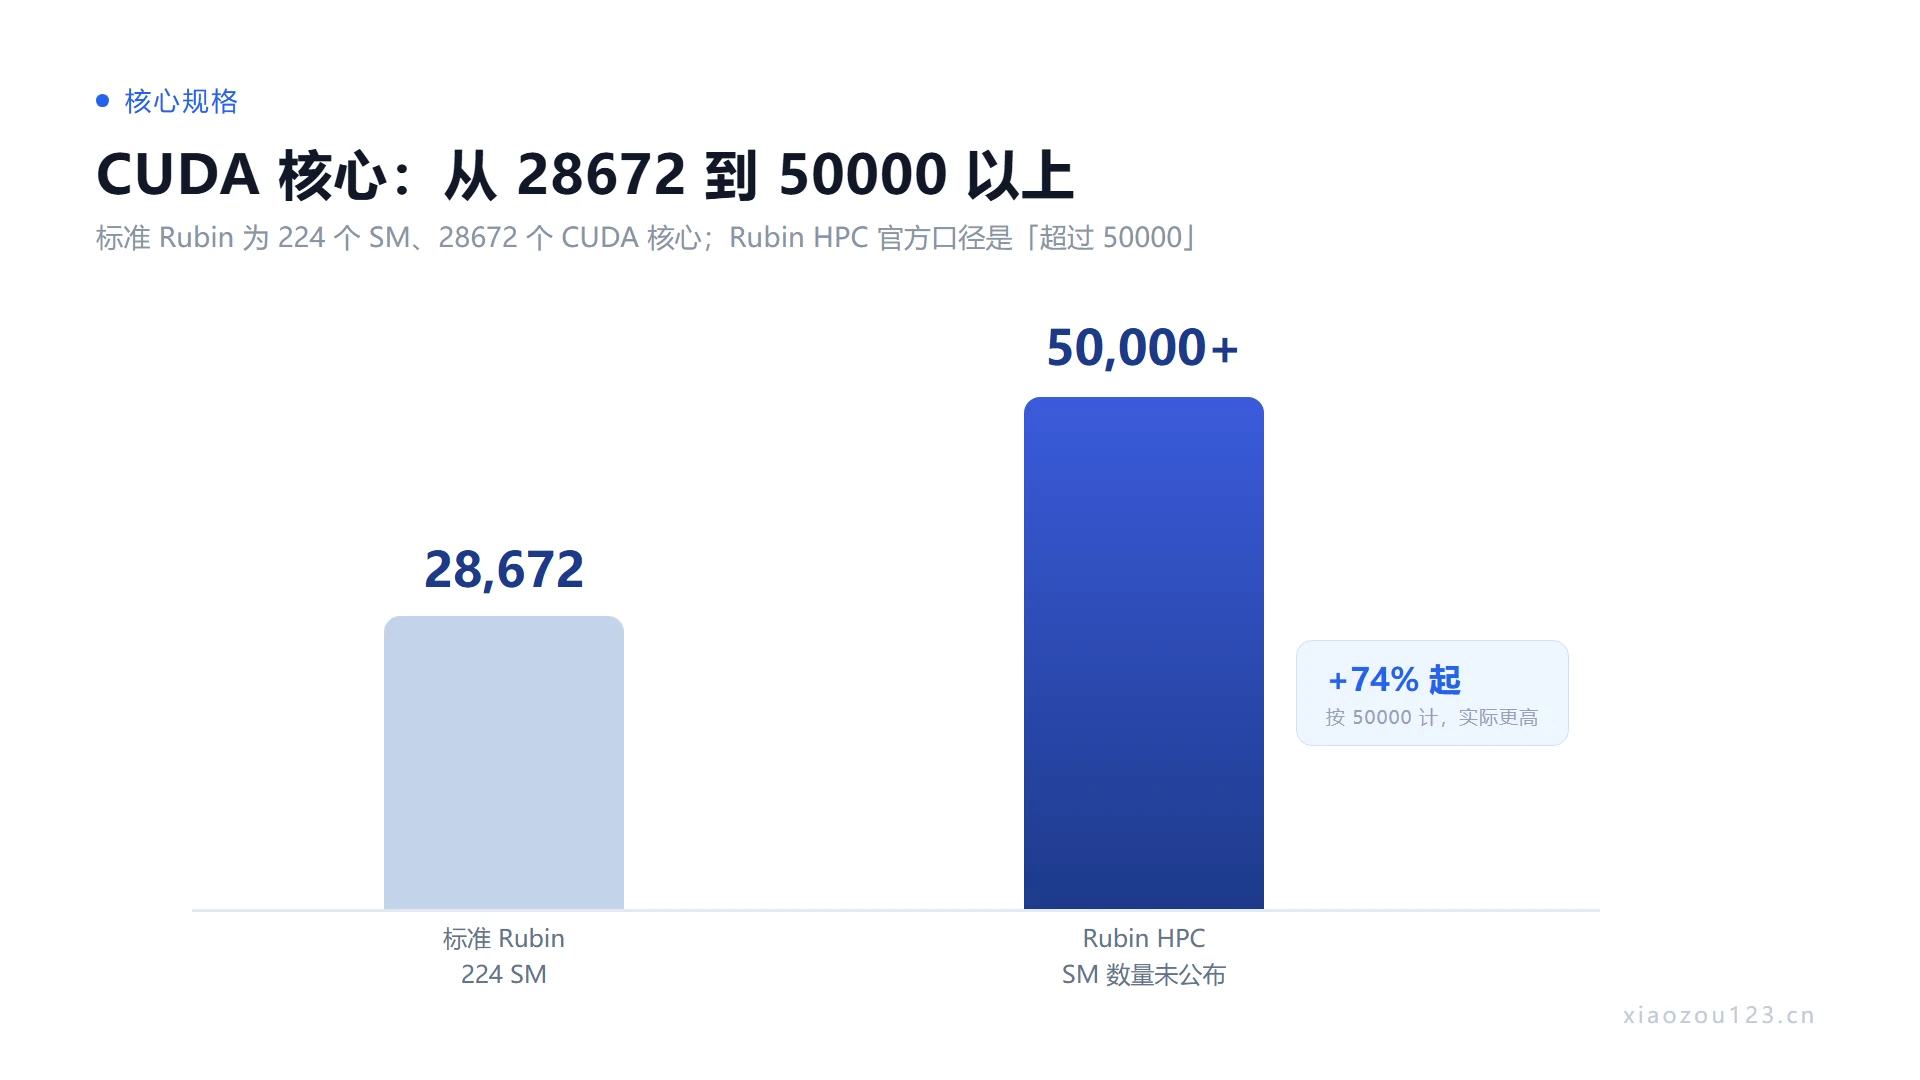
CUDA 核心是 GPU 里的通用计算单元,SM(流式多处理器)是装这些核心的基本调度单位,一颗 GPU 的 SM 数量乘以每个 SM 的核心数,就是总核心数。标准 Rubin 的 28672 除以 224,正好是每个 SM 128 个——如果 Rubin HPC 沿用同样的比例,五万个核心大约对应 390 个 SM。
核心多不等于快。同样的核心数,架构差一代、频率差一截、显存供不上数据,性能就能差出一倍。所以 74% 这个数字只能说明规模上了一档,不能直接换算成算力提升。
| 项目 | Rubin HPC 的状态 |
|---|---|
| CUDA 核心 | 超过 50000 个(官方) |
| SM 数量 | 未公布 |
| 封装形式 | 四芯粒(第三方推测,未确认) |
| GPU 间互连 | NVLink 7(官方),带宽未公布 |
| HBM 容量与带宽 | 未公布 |
| FP64 双精度配置 | 未公布 |
| 上市时间 | 2028 年 |
封装与芯粒设计
英伟达这次没公开芯片的物理封装布局。Tom's Hardware 从核心数规模推测,Rubin HPC 可能采用与四芯粒 Rubin Ultra 类似的多芯粒设计,通过 NVLink-C2C 互连。这个推测没有得到英伟达确认。
芯粒(chiplet)是把一颗大芯片拆成几块小芯片分开制造,再封装到一起。NVLink-C2C 是英伟达的裸片级互连,负责让几颗芯粒在封装内部像一颗芯片那样通信,带宽和延迟都远好于走 PCB 走线。
这么猜的逻辑不难理解:核心数从两万八涨到五万,单颗芯粒在面积和良率上都顶不住,拆成四颗是行业里现成的解法。但拆几颗、每颗多少核心、缓存怎么分,这些只有英伟达自己的图纸知道。
互连设计:NVLink 7
为支撑多 GPU 之间的数据传输,Rubin HPC 会采用 NVLink 7 互连。英伟达本次没有披露机架内带宽,也没提物理层细节。
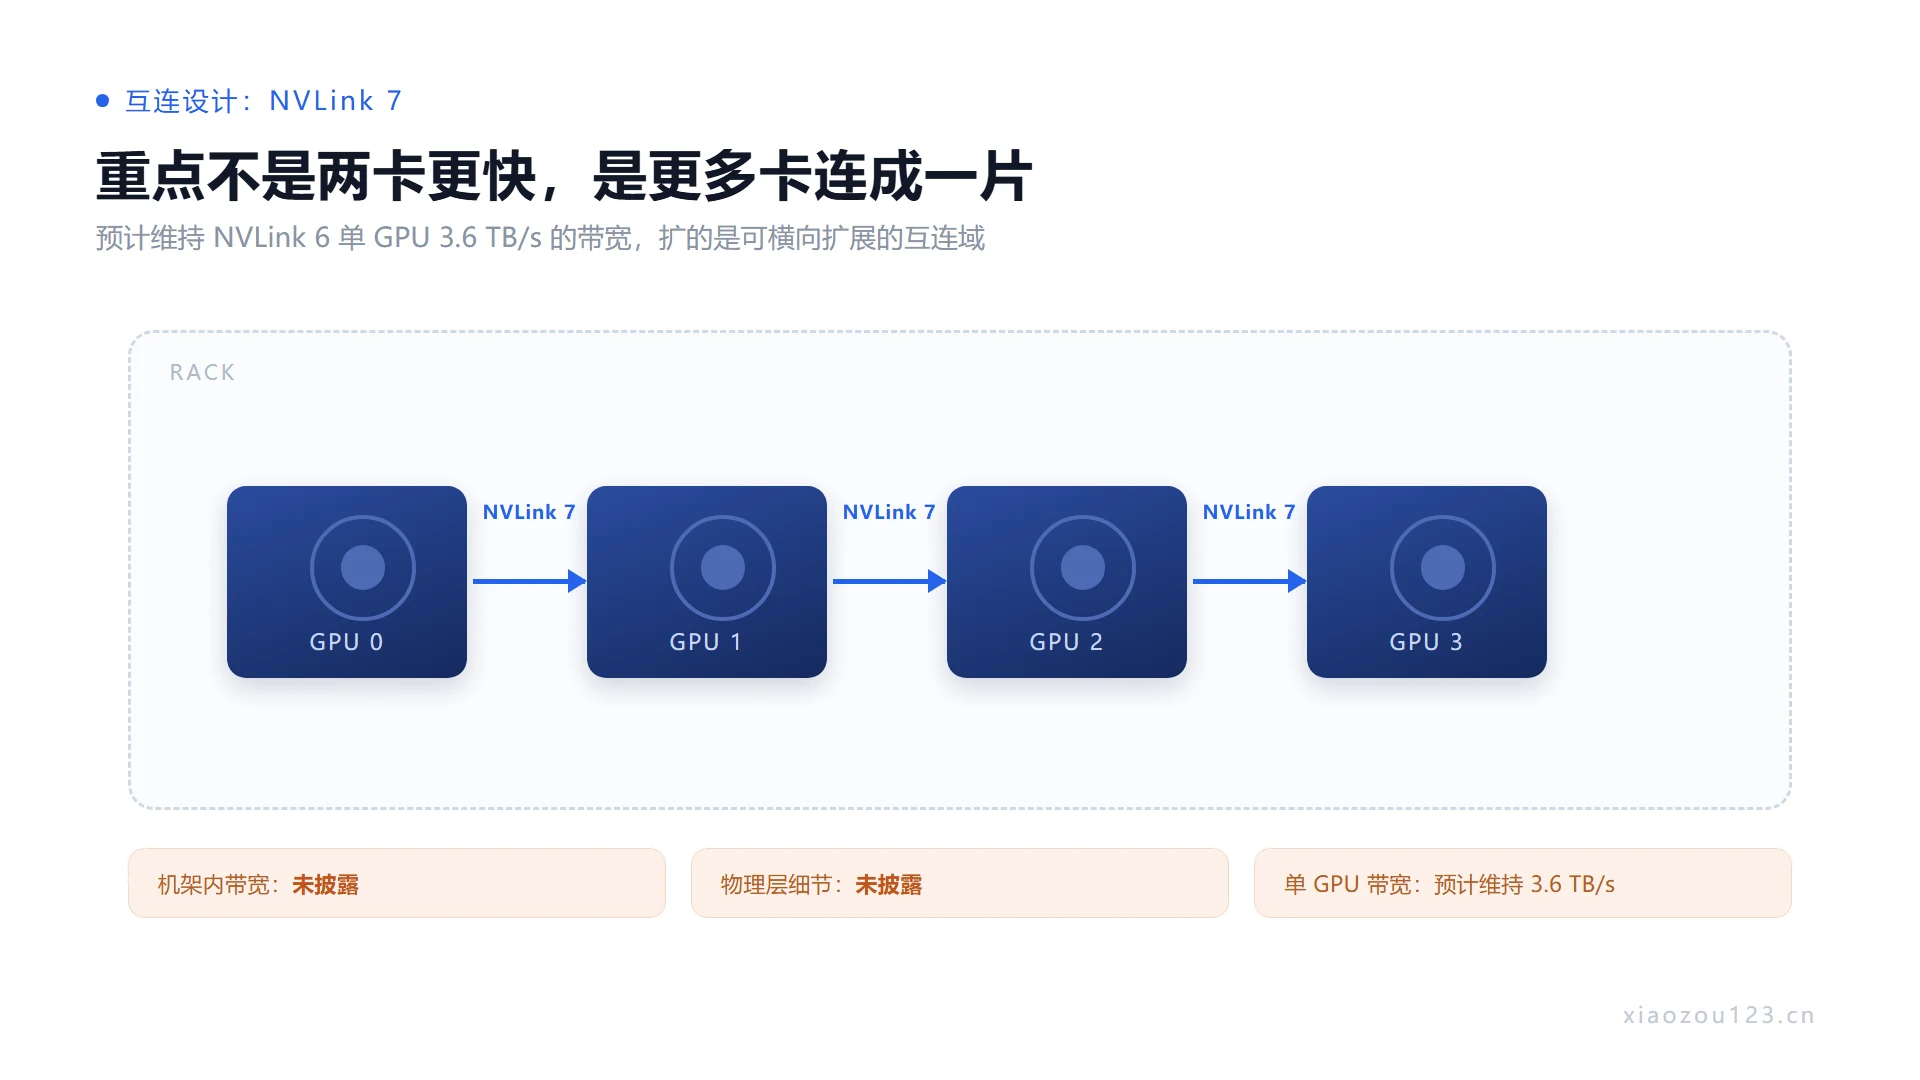
按此前公开的信息,NVLink 7 预计维持 NVLink 6 单 GPU 3.6 TB/s 的带宽水平,同时扩大可横向扩展的互连域范围。换句话说,这一代升级的重点不是让两张卡之间跑得更快,而是让更多张卡连成一片。
NVLink 是英伟达自家的 GPU 间高速互连,用来替代 PCIe。放在 HPC 场景里看,互连往往比单卡峰值更影响实际表现:气候模拟、分子动力学这类任务要把一个大问题切给几百上千张卡算,卡与卡之间每传一次数据都要等,互连跟不上,算力再高也在空转。
平衡架构与科学计算场景
英伟达把 Rubin HPC 的设计思路叫「平衡架构」:一边加计算资源,一边强化节点间的数据流动能力,减少计算单元因为等数据而闲置的时间,把利用率提上去。
目标场景写得很具体:气候研究、基因组分析、金融仿真,共同点是数据量大、模拟要反复跑。这类负载的瓶颈常常不在算得多快,而在数据搬得多快。
软件侧对应的是 CUDA-X 领域库。英伟达提到,针对多智能体协同探索问题空间的工作流,用户可以借这些库进一步榨出性能,缩短「提出假设—跑仿真—看结果—改假设」这一圈的周期,更快筛掉没价值的方向。
未公开参数:HBM 与 FP64
发布会开到这一步,还有两项真正决定 HPC 表现的参数是空的。
第一项是 HBM 显存的容量和带宽。HBM 是把显存堆叠封装在 GPU 旁边的方案,带宽比普通显存高一个量级,代价是贵、产能紧。科学计算的数据集动辄几百 GB,显存装不下就得来回搬,带宽不够就喂不饱计算单元——五万个核心配一块小显存,等于给跑车装了个小油箱。
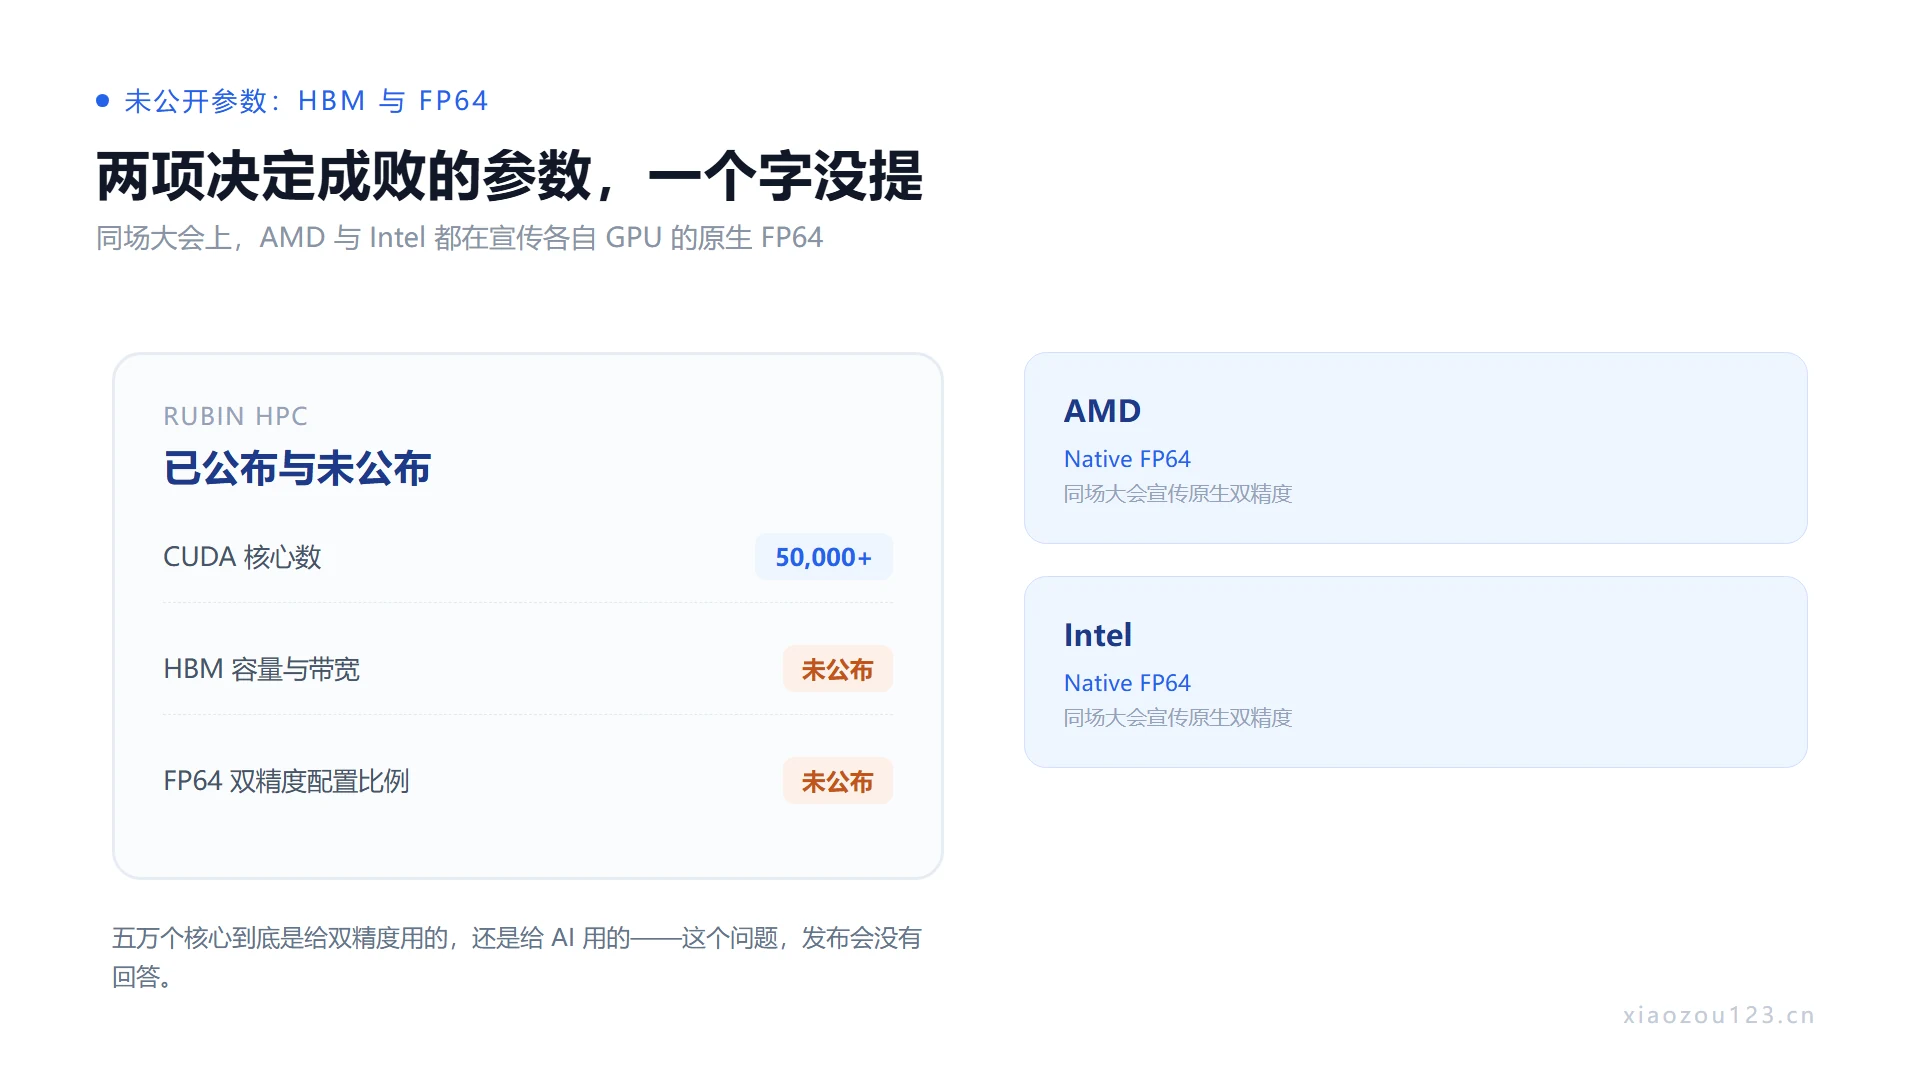
第二项是原生 FP64 双精度计算的配置比例。FP64 是科学计算的精度基准,浮点运算要做 64 位。消费卡砍 FP64 是为了省面积,同一个 SM 里塞更多单精度单元,游戏和 AI 训练都用不上双精度;HPC 卡不能这么砍,气候模型和流体仿真离了它就出错。
这也是 HPC 产品和 AI 训练卡分家的原因。大模型训练主要跑 FP16、BF16 这类低精度格式,把精度降下来换吞吐;科学计算要的是误差可控,双精度是硬指标。两种需求对芯片面积、功耗和散热的要求完全不同,一颗芯片很难两头都讨好。
英伟达没说 Rubin HPC 会不会调整这个比例。而同场大会上,AMD 和 Intel 都在宣传各自 GPU 的原生 FP64 特性——这等于把问题摆到了台面上:五万个核心到底是给双精度用的,还是给 AI 用的。
产品路线定位
把这次发布当成一次产品交付,信息量其实不够;当成路线图的一个节点,就说得通了:更大规模的 GPU 计算、跨 GPU 的互连、CUDA-X 软件生态,三样绑在一起,服务的是智能体参与的仿真与分析任务。
离 2028 年还有一段时间,中间足够英伟达改几轮图纸。真正该等的不是核心数再涨多少,而是 HBM 容量、FP64 比例和封装披露——这三样定下来,五万个核心才有一个说得清的性价比。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING