





2020 年 11 月,第一批 M1 MacBook Air 到了评测编辑手里,跑分结果出来那天,很多人的第一反应是去翻参数表,确认这台机器真的没有风扇。
一台轻薄本,单核成绩压过了桌面上还在卖的酷睿 i9;它不烫,没有风扇,电池能撑一整天。当时主流的解释是"台积电 5nm 的功劳",这个说法对了一半,也遮住了另一半。
五年过去,事情反而更难解释了:M5 的峰值频率 4.61GHz,Core Ultra 9 285K 和 Ryzen 9 9950X3D 都能冲到 5.7GHz,频率低 19%,Geekbench 6 单核分数却高出 32%。按"频率高就快"的直觉,这笔账算不平。
我想从头算一遍:一条指令究竟走了哪些路,x86 和 ARM 在哪几处分了岔,Apple 到底多买了什么,Intel 和 AMD 又为什么买不了。算完你会发现这里面没有黑科技,全是被明码标价的取舍。
先说结论
六条判断先摆出来,后面全是给这六条找证据。
- 单核性能 = 频率 × IPC,Apple 赢在 IPC。Geekbench 6 上每 GHz 得分约为 x86 的 1.6 倍,这个差距不是一代架构能追平的。
- 差距落在三处具体结构上:十宽译码、六百多项的乱序窗口、192KB 的 L1 数据缓存,没有任何一处是玄学。
- x86 的 L1 卡在 48KB,是被 4KB 页锁死的。VIPT 结构下"组数 × 块大小 ≤ 页大小",4KB 页只给 64 组,48KB 配 12 路刚好用完。
- Apple 能做,是因为它拆掉了五道锁:页大小、二进制兼容、内存封装、决策权、损益表。每一道锁背后都是一笔别人赔不起的钱。
- Intel 不是设计能力差,是被目标函数绑住,而且中途摔过两跤:NetBurst 冲高频翻车,Itanium 换指令集赔了几十亿美元。
- "换个干净指令集就能变快"是错的。x86 的遗留特性早就不在热路径上,砍掉它省的是面积和验证成本,换不来跑分。
CPU 的结构与性能指标
CPU 是一台只会做一件事的机器:从内存里取一条指令,照着做,把结果写回去,再取下一条。这个循环七十年没变过,变的是它一次能同时处理几条、能提前看多远。
拆开看只有三个部分:控制单元负责取指、译码、决定谁先执行,运算单元负责整数、浮点、向量运算,存储部分负责把数据放在离运算单元足够近的地方,三者的比例决定一颗核的性格。
指令集是程序员看到的那一层,微架构是硅片上真实实现的那一层;同一个 x86 指令集,Pentium 4 和现在的 Core 内部完全不同,同样是 ARM 指令,Cortex-A55 和 Apple 性能核差着十倍能效。把这两层混为一谈,是后面所有误判的源头。
再看存储,这一层的重要性被严重低估,因为它的容量数字看起来远不如频率性感。
| 层级 | 典型容量 | 命中延迟 |
|---|---|---|
| 寄存器 | 几百字节 | 0,指令直接寻址 |
| L1 缓存 | 32–192 KB | 3–5 个周期 |
| L2 缓存 | 0.5–16 MB | 12–20 个周期 |
| L3 或 SLC | 8–96 MB | 30–50 个周期 |
| 内存 | 16 GB–2 TB | 80–120 纳秒,约 300 个周期 |
延迟那一列才是重点:寄存器零延迟,L1 三五拍,跑到内存就是两三百拍——一颗 4GHz 的核,一次内存访问的时间够它执行三百条加法。
这段时间要是喂不饱,流水线就空转;喂得太满,缓存又装不下。缓存不是加速器,是防堵设施,命中率每提高一点,IPC 就往上走一截。
衡量一颗核快不快,三个指标:频率是每秒多少拍,IPC 是每拍干几件事,核心数是能同时干几摊活;单核性能只看前两个,乘起来就是答案。
麻烦在于这三个指标抢同一块硅片:缓存多占面积,核心数就得减,执行端口多开,频率就上不去。所有架构师都在解这道分配题,区别只在他们被允许动哪些变量。
指令执行的流水线
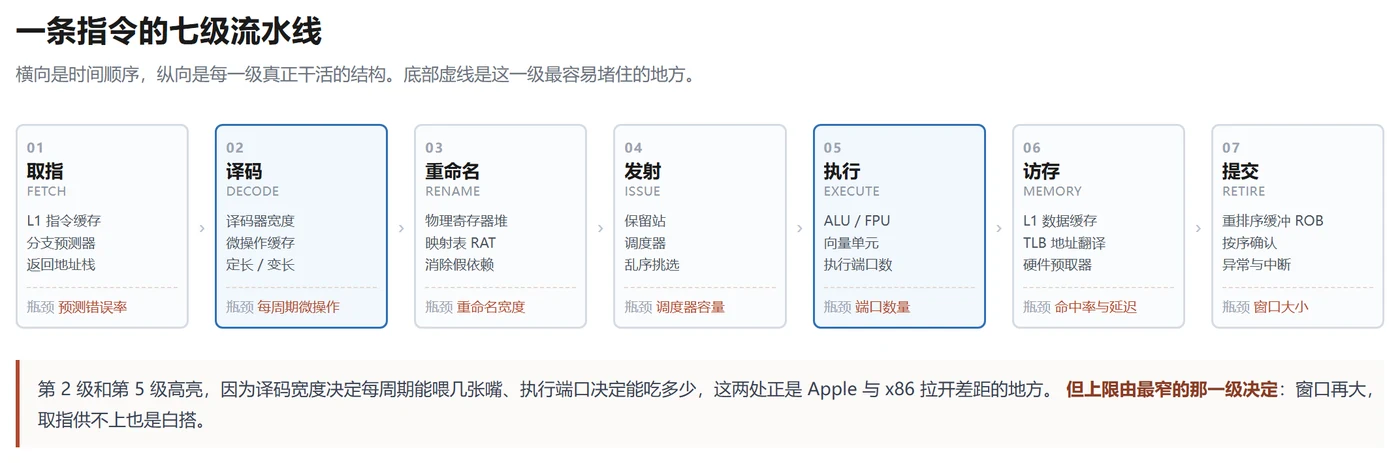
把上面那个循环拆细,一条指令要过七道工序;CPU 的设计史,基本就是把堵点从这一级挪到下一级的历史。
取指与分支预测
取指按程序计数器走,遇到条件跳转就得猜,猜对了继续往下走,猜错了整条流水线作废,六十多拍的功夫全打水漂。
现代处理器的分支预测命中率能到 95% 以上,靠的是一堆历史表和模式匹配;这个数字听着很高,但剩下的 5% 全落在关键路径上,而惩罚大约是"流水线深度 × 2"这个量级。
这就解释了一个反直觉的现象:流水线越深越容易冲高频,可一旦预测错误,代价也越贵——当年 Intel 为了冲 10GHz 把流水线拉到 31 级,猜错一次要空转六十多拍。
译码与微操作
取回来的指令是给程序员看的格式,硬件用不了,得翻译成内部微操作;x86 那套复杂的 CISC 指令,在核心里其实被拆成一条条类似 RISC 的小动作。
译码宽度就是每周期能拆几条,而这一级最容易被忽略:它不像缓存那样有容量可以宣传,却直接决定后面所有单元的上限——喂不进去,后面再宽也是空转。
Intel 的应对是加一个微操作缓存,把翻译过的指令存起来,命中时跳过译码器直接供货,AMD 也这么干;这是个聪明的补丁,代价是占面积,而且命中率永远到不了百分之百。
重命名与乱序窗口
架构寄存器数量很少,x86 十六个,ARM64 三十一个;程序里反复读写同一批寄存器,会产生大量本来不存在的依赖。
重命名把这些名字映射到几百个物理寄存器上,让"写同一个寄存器"的两条指令互不干扰。这一级做宽了,后面的乱序才有意义,做窄了,前端再宽也白搭。
紧接着是重排序缓冲,简称 ROB:它是一张按程序顺序排好的表,指令可以在里面乱序执行,但必须按序提交,ROB 有多深,核心就能提前看多远。
这是整个微架构里最贵也最有性价比的一块:窗口够大,一次内存访问的两三百拍延迟就能被别的活填满,而不是让整个核干等着。
发射与执行端口
指令在保留站里等操作数,齐了就被发射到执行端口;端口是物理连线,每个端口接一组特定功能单元,整数、浮点、访存各有各的。
端口数决定同一时刻能并行几条同类指令:开四个整数端口,就意味着每拍最多四条整数运算同时开工,第五条只能排队。端口少的核,哪怕频率再高,也会在同类指令密集时堵成一团。
访存与缓存层级
访存这一级最难啃:地址要先过页表缓存(TLB)做翻译,再去 L1 找数据,找不到就往 L2、L3、内存逐级下探。
有个指标叫 load-to-use 延迟,意思是数据从 L1 取出来到能参与运算要几拍;这个数字每加一拍,整条依赖链上的指令都得等,而且没法用并行掩盖。
硬件预取器是另一个隐形角色:它根据访问模式提前把数据搬进缓存,做得好能掩盖一大半延迟,做得差就是白白占带宽。Geekbench 这类循环紧凑的负载,被预取器伺候得非常舒服。
提交与精确异常
最后一步按序提交,把结果写回架构状态,这一步保证了精确异常:出错时能准确回到某一条指令,前面的都生效,后面的当没发生。
ROB 满了,前端就得停;这就是为什么窗口大小和译码宽度必须匹配——喂得太快后面装不下,一样堵。
串起来看,单核性能被三条物理规律钉住:
- 分支预测错误惩罚约等于流水线深度的两倍。深流水线冲高频,代价是猜错一次赔得多。
- ROB 容量等于预判距离。窗口越大,越能靠别的活掩盖内存延迟。
- 功耗随频率三次方量级上涨。从 4.6GHz 推到 5.7GHz,性能多两成,单核功耗可能翻倍。
Apple 的选择很明确:不深挖频率,把预算全押在"每拍干更多活"和"少跑冤枉路"上。这句话是后面所有分析的钥匙。
x86 与 ARM 的架构分歧
先拆一个流传很广的误会:两者都是 64 位,都是乱序多发射,都有向量扩展,指令集本身并不决定谁快;决定快慢的是,这套指令集允许你用什么代价做到多宽。
指令编码:变长与定长
x86 指令长度从 1 字节到 15 字节不等,前缀还能叠加;译码器拿到一串字节,第一件事是判断"这一条到哪里结束",而这个判断依赖前面那条有多长。
这是一个串行过程:想并行译码,就得先做一遍预扫描把边界标出来,再用多个译码器并行处理,宽度每加一档,复杂度和功耗的增长都超过线性。
ARM64 固定四字节,边界天然确定,十个译码器并排摆着就行;Apple 从 M1 的八宽,到 M3 的九宽,再到 M4、M5 的十宽,代价比 x86 做同样的事低得多。
但不能因此说 x86 落后:Intel 现在走的是八宽直译码加微操作缓存,命中时每拍能供十二个微操作,稳态吞吐并不输十宽。
真正吃亏的是冷代码——大二进制、首次执行、编译器这类巨型程序,微操作缓存命中率掉下来,就得退回八宽。Geekbench 里唯一让 Apple 难受的子项恰好是 Clang 编译,这不是巧合。
页表与 L1 容量上限
这一条是 x86 独有的硬约束,也是"为什么 L1 长期卡在 32 到 48KB"的答案;很多人以为是工程师舍不得堆缓存,其实不是。
L1 用虚拟地址做索引、物理地址比对标签,这种结构叫 VIPT。好处是 TLB 查询和缓存索引可以并行,省掉一拍;代价是索引位不能超出页内偏移,否则两个虚拟地址映射到同一个物理页时会落到不同组,缓存里出现两份副本,一致性直接崩。
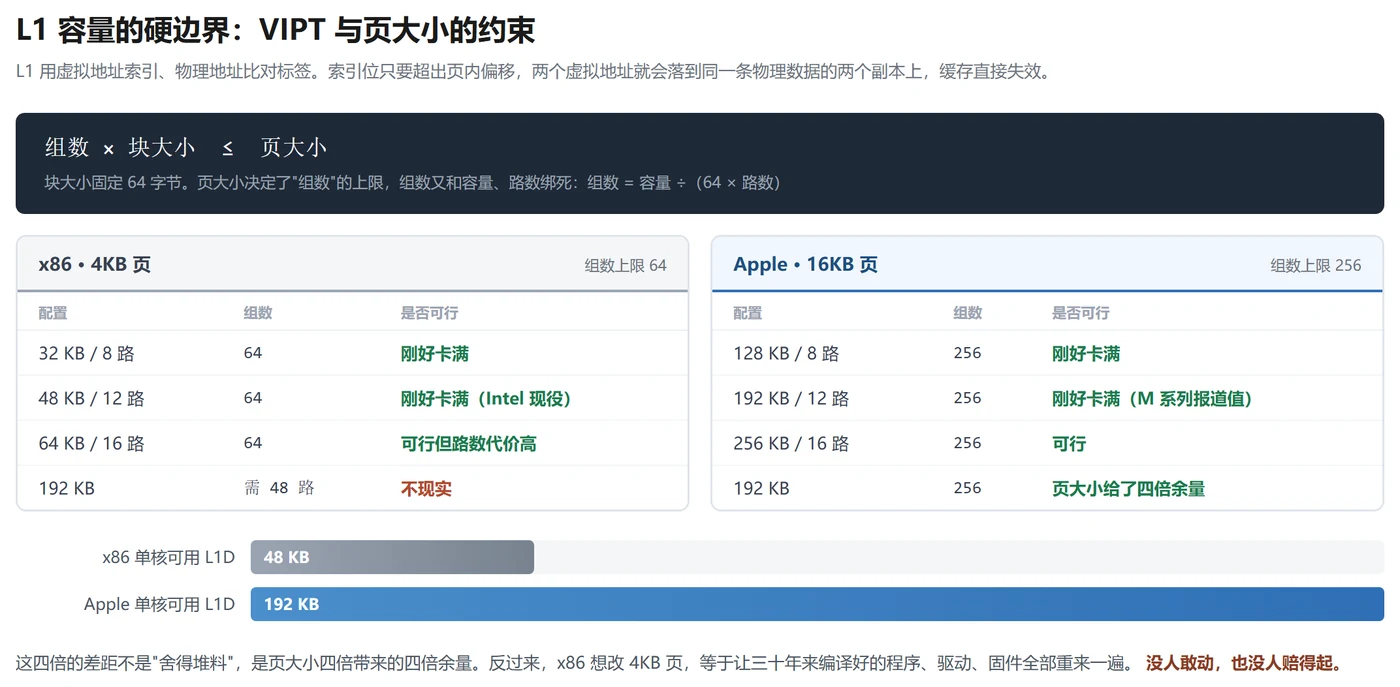
算一下就很清楚:32KB 配八路,64 组;48KB 配十二路,还是 64 组。AMD 的 32KB/8 路和 Intel 的 48KB/12 路,都不是"觉得这么大合适",而是"4KB 页下面就这么大合适"。
Apple 用 16KB 页,组数上限变成 256,128KB 八路、192KB 十二路全都能装下;这不是巧合,是同一道算式算出来的两个答案,数字严丝合缝。
那 x86 为什么不改页大小?因为改页大小等于让三十年来编译好的程序、驱动、固件、虚拟化镜像全部重做一遍,没人敢动,也没人赔得起。
内存模型:TSO 与弱一致
x86 用的是强一致模型 TSO,写操作对其他核的可见顺序必须和程序顺序一致;落到硬件上,这意味着 store buffer 不能随便重排,访存单元白白损失一块乱序空间。
ARM 是弱一致,默认不保证顺序,需要显式屏障:好处是硬件可以自由重排,代价是程序员更容易写出并发 bug。
Apple 在这里拿了个便宜:跑原生 ARM 代码时用弱一致,跑 x86 程序时靠 Rosetta 2 在翻译层插入 TSO 语义,代价只落在被翻译的那部分代码上;x86 是没法这么"只在自己不想遵守的时候不遵守"的。
启动路径与授权模式
还有一条很少被提到,但它决定了谁能设计宽核。
x86 处理器复位后进入的是 8086 兼容状态,要经过几次模式切换才能进 64 位;这套路径养活了四十年的固件、引导器和老系统,也让任何激进简化都得先说服整个行业。
ARM 只定义架构,不卖成品核:Apple 拿的是架构授权,可以从零设计微架构,高通、三星拿的是核授权,只能改缓存和频率。这个差别比指令集本身重要得多。
换句话说,Apple 的宽度不是 ARM 给的,是它自己花钱买下的设计自由。
Apple 的微架构取舍
到这里可以下一个判断:Apple 没有发明任何新东西,它做的事只有一件——把 x86 因为成本、兼容和产品分层而主动放弃的选项,一项一项买了下来。
前端:十宽译码与巨型预测器
M1 的 Firestorm 核心是八宽译码,M3 九宽,M4 和 M5 十宽,后端执行宽度十六;这个数字在 2020 年就已经超过当时所有 x86 桌面核。
配套的是极深的分支预测资源:分支目标缓冲(BTB)条目数以万计,还有专门的返回地址栈和间接跳转预测。这些结构不产生算力,只负责让流水线别停,但正是它们把"猜错"的概率压到了 x86 追不上的水平。
能效核(E 核)也不是凑数的摆设:它的存在让性能核不必为了压住发热而降频救场,macOS 把后台任务统统丢过去,前台那一个线程就能一直贴着峰值跑,这件事在跑分里体现不出来,在日常使用里天天发生。
后端:六百多项窗口与十六个执行端口
Apple 性能核的 ROB 大约 630 项;作为对照,Intel Golden Cove 是 512 项,AMD Zen 4 到 Zen 5 在 320 到 448 项之间。
这些数字来自公开的微架构逆向分析,Apple 自己从不公布,但多个独立团队的测量结果互相吻合,可信度不低。
还有一处容易被忽略的选择:Apple 不做超线程。单线程时,所有执行端口、所有 ROB 项、整块 L1 都是这一个线程的,没有兄弟线程抢资源,也没有超线程相关的安全缓解开销。
缓存层级:192KB 的 L1 与 16MB 的 L2
L1 数据缓存 192KB,指令缓存 128KB,命中延迟仍然压在三四拍;桌面 x86 的 L1D 是 32 到 48KB,延迟四到五拍。
L2 这块更夸张:四个性能核共享 16MB,平均每核能摸到 4MB,而 Intel 的每核 L2 是 2 到 3MB,共享的 L3 才 36MB 上下。
再加一层系统级缓存(SLC),容量 8 到 96MB,把 CPU、GPU、NPU 的数据放在同一个池子里;对 JavaScript 堆、数据库索引、编译器符号表这种"热但装不进 L2"的数据,这一层的收益非常直接。
代价藏在多核那一侧。核心越多,维持缓存一致性要广播的消息就越多,环形总线的直径一长,一次跨核同步就得几十拍;x86 上到十六核必须拆成多个 CCD(核心复合芯片),跨 die 访问的延迟直接翻倍,而 Apple 靠一颗 die 上的 SLC 把这件事压在可控范围里,代价是核心数上不去、内存容量焊死。
频率与功耗:停在甜点区
M5 峰值 4.61GHz,桌面 x86 冲 5.7 到 6.0GHz——这个差距不是做不上去,是不划算。
Apple 单核满载大约五到八瓦,一台十四寸 MacBook Pro 能长时间贴着峰值跑;x86 那边单核冲 5.7GHz 要三十到四十瓦,笔记本在功耗墙下面几秒就掉下来。同样是跑分,一个能跑一天,一个只能跑十秒。
所以"跑分强"和"用起来强"在 Apple 这里是同一件事,在 x86 轻薄本上经常不是;评测里那句"跑分很好看,实际用起来一般",有一半是散热和功耗策略造成的。
专用单元与软硬协同
SME 矩阵扩展、媒体编解码引擎、神经引擎,这些单元把大量本该 CPU 干的活接走了。
结果就是 CPU 核只需要处理"不好并行、延迟敏感"的那部分通用代码,于是可以专心做深做宽,不用为每种负载都堆执行单元,这是一种很聪明的减法。
软件这一侧同样在配合:芯片团队和 LLVM、Swift 团队在同一家公司,新指令能第一时间生成代码,Accelerate 和 vDSP 是手写汇编,直接吃满微架构特性。
JavaScriptCore 的 JIT 针对自家核心调优,内联缓存和多层编译的阈值可以贴着硬件定;macOS 的调度器把前台线程直接钉在性能核上,不来回迁移。
Rosetta 2 是翻译加缓存,不是逐条模拟,所以 x86 应用只有两三成损耗;这一层配合很多评测会漏掉,但它解释了为什么同一颗核,在 Mac 上就是比在别处顺手。
把纸面参数摆在一起,差距的来源一目了然:
| 项目 | Apple M4/M5 性能核 | Intel Lion Cove | AMD Zen 5 |
|---|---|---|---|
| 译码宽度 | 10 宽 | 8 宽 | 2×4 宽 |
| 重排序缓冲 | 约 630 项 | 512 项 | 448 项 |
| L1 数据缓存 | 192 KB | 48 KB | 48 KB |
| 每核 L2 | 4 MB | 3 MB | 1 MB |
| 超线程 | 无 | 部分型号已取消 | 有 |
| 峰值频率 | 4.6 GHz | 5.7 GHz | 5.7 GHz |
这张表里每一行都是钱:更大的 L1、更深的窗口、更宽的译码,占的都是芯片面积和功耗预算,而这些预算在 x86 那边要分给核心数、集成显卡、内存控制器和一堆别的单元。
数字落到跑分上是这样,先把口径说清楚:这组成绩来自 Geekbench 6 用户上传的平均值,同一颗芯片换台机器、换个散热、换个系统版本就能差出好几百,只当参考量级看,不是官方认证结果。
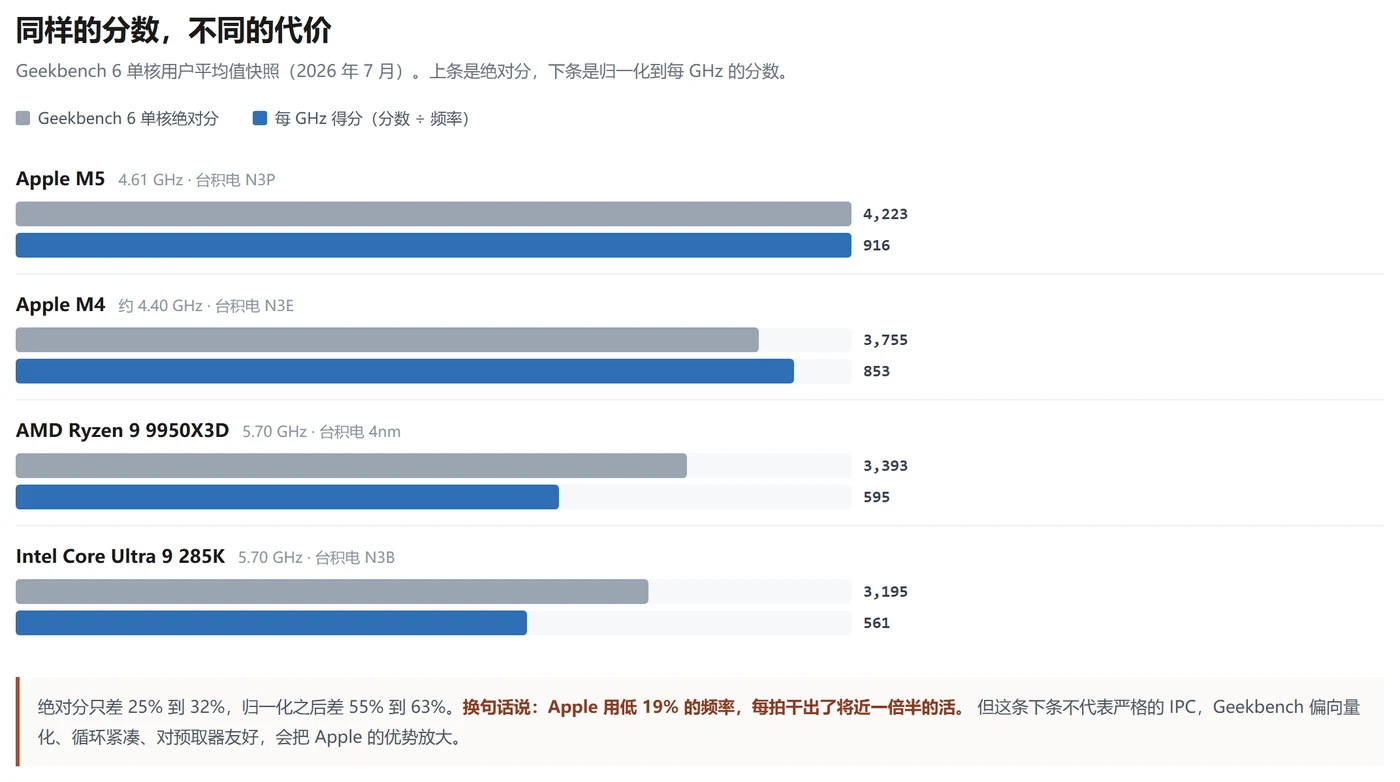
| 芯片 | GB6 单核 | 峰值频率 | 每 GHz 得分 | 制程 |
|---|---|---|---|---|
| Apple M5 | 4,223 | 4.61 GHz | 916 | 台积电 N3P |
| Apple M4 | 3,755 | 约 4.40 GHz | 853 | 台积电 N3E |
| Ryzen 9 9950X3D | 3,393 | 5.70 GHz | 595 | 台积电 4nm |
| Core Ultra 9 285K | 3,195 | 5.70 GHz | 561 | 台积电 N3B |
绝对分差 25% 到 32%,归一化后差 55% 到 63%;这个"每 GHz 得分"不是严格的 IPC,Geekbench 偏向量化、循环紧凑、对预取器友好,天然放大 Apple 的优势,换成 SPECint 这类更中性的负载,领先幅度会收窄到两三成。
但收窄不等于消失:按保守口径算,Apple 在客户端常见负载上的每周期效率仍然领先一档,而且这个优势已经连续保持了五六年。
M5 相对 M4 提升约一成,M1 到 M5 每代八到十二个点;这条曲线很平,但五年没断过——架构能力不看单代爆发,看的是能不能稳定交付。
三家路线的历史成因
今天的架构形状不是设计出来的,是被二十年的决策、事故和商业合同塑造出来的;想理解为什么三家走了三条路,得回头看几个节点。
Apple 为什么放弃 Intel
2005 年,Apple 从 PowerPC 转到 Intel,理由是 PowerPC 的功耗和路线图撑不住笔记本;那次迁移很成功,Mac 用了十五年 Intel 芯片。
转折出现在 2018 年前后:Intel 的 10nm 一延再延,14nm 反复改,MacBook Pro 的散热压不住标压 i9,降频成了固定节目——与此同时,Apple 在 iPhone 上已经把自研核做到了世界前列。
更根本的原因不在性能,在路线:Apple 想要一条从手表、手机、平板到电脑贯通的芯片路线,统一内存模型、统一指令集、统一调度策略,而这些东西 Intel 给不了,因为它要卖给所有人。
2020 年 11 月 M1 发布,两年过渡期走完,2023 年 Mac Pro 换芯,全线完成;中间靠 Rosetta 2 兜底,开发者不得不跟。
这里有个容易被忽略的前提:Apple 有强制迁移的权力——用户基数有限、产品线封闭、只有一个买家,说不支持就不支持,Intel 和 AMD 这个权力一次都使不出来。
NetBurst:冲高频的第一次翻车
2000 年 Intel 推出 Pentium 4,架构代号 NetBurst,思路是"把流水线拉到极深,用超高频率换性能"——设计目标 10GHz,量产版本 31 级流水线。
结果惨不忍睹:Prescott 那一代功耗和发热失控,4GHz 都稳不住,性能还被自家低频率的 Pentium M 追平。
这是 Intel 二十年来最丢人的一次技术豪赌。赌输了不算,还让整个行业陪着吃了三年 90nm 的苦,只能灰溜溜地把以色列团队做的 Core 架构扶正,等于承认前面几年白干。
到今天 x86 停在 5.7GHz 附近,根子还在那次教训里——频率不是想堆就能堆的,功耗曲线会先把你拦住。
Itanium:换指令集的第二次翻车
比 NetBurst 更贵的一次,是 Itanium。
Intel 和惠普联手做 IA-64,架构叫 EPIC,思路是把并行性交给编译器静态提取,硬件做得又宽又简单;理论上很美——编译器看得见全局,能排出比硬件乱序更好的调度。
现实是编译器做不到:指针别名、间接跳转、运行时才知道的分支,静态分析全都抓瞎,硬件为了跑 x86 老程序又得塞一个模拟层,速度慢到客户直接放弃,软件生态从头到尾没建起来。
2004 年 Intel 回头做 x86-64,而且是照着 AMD 的 AMD64 抄的;Itanium 一直拖到 2021 年才停产。
几十亿美元买了一个教训:把"编译器会替我搞定"当架构前提,是拿真金白银赌一个学术假设。这件事之后,"换掉 x86"在行业里基本成了禁忌词,谁提谁被笑——你今天看到的每一条 x86 包袱,都是那次失败留下的利息。
AMD 的扩展路线与今天的联盟
AMD 的答案从一开始就相反:不替换,只扩展——AMD64 保留全部 16 位和 32 位模式,只在长模式上加 64 位寻址,老程序一行不改照样跑。
这个决定让 AMD 在 2003 年抢到先手,也让 x86 的包袱又厚了一层;到了 chiplet 时代,AMD 靠把大芯片拆成小芯片摊成本,用核心数换市场,路线和 Intel 越走越远。
2023 年 Intel 提过一个叫 x86S 的方案,思路和"只留 64 位"完全一致——砍掉实模式、16 位保护模式、32 位内核;2025 年 Intel 宣布不推了,把这件事并进 x86 生态咨询组。
那个组 2024 年 10 月成立,创始成员有 Intel、AMD、博通、戴尔、谷歌、惠普、联想、Meta、微软、甲骨文、红帽。两年下来出了实货:AVX10 统一向量规范、FRED 重写中断路径、ACE 矩阵加速规范,2026 年 6 月发布 1.15 版,GCC 17 已经合并支持。
但性质要说清楚:联盟能治碎片化,治不了包袱——x86S 的死恰好证明了这一点,任何激进简化都要十几方谈判,最后只能取最小公约数。
拆 die 也有代价:跨 CCD 访问要走 Infinity Fabric,延迟比片内高出一截,单核跑分看不出来,但游戏和数据库这类延迟敏感的应用会挑 CCD;AMD 用 3D 堆叠缓存去补这个洞,才有了 X3D 那条产品线。
制程与组织:能力这个词不好用
还有一个常被低估的变量:谁先拿到新节点。
Apple 是台积电新工艺的首发客户,M5 用 N3P,拿的是最优的密度和能效曲线;Intel 得用自己的 Intel 7 和 18A,AMD 用 N4 但受成本约束——同样一颗核,换个节点就能差出两成。
Intel 在 10nm 上延期了五年,直接丢掉两代制程领先;这是资本开支和组织执行的问题,不是微架构团队画不出好图纸,把它算成"设计能力",是算错了科目。
有个反证很能说明问题:高通 Oryon 的核心团队就是前 Apple 架构师,Oryon 在 Geekbench 上同样打到四千分级别;方法论可以复制,但前提是同样的自由度——只做一类产品、绑最新节点、不为兼容性买单。
所以"Intel 设计能力不如 Apple"这个说法是偷懒的;准确的说法是,Apple 在自己定义的单项上做到了极致,Intel 在解一道约束多得多的题,而且中途摔过两跤、耽误了五年。
常见误区与错误结论
这个话题在中文互联网上被反复讲,讲错的地方比讲对的多;挑五条常见的拆一下。
"ARM 比 x86 先进,所以更省电"
指令集不决定能效,微架构才决定——同样跑 ARM 指令,Cortex-A55 和 Apple 性能核的能效差十倍以上。
反过来,x86 阵营里 Lunar Lake 的能效也能压过不少 ARM 笔记本芯片;把"ARM 省电"当物理定律,是把指令集和微架构两件事混成了一件。
"Apple 的 L1 大是因为不用兼容老软件"
不对。真正的开关是页大小,16KB 对 4KB,直接给出四倍的组数余量;兼容性影响的是指令集层面的包袱,跟 L1 容量没有因果关系。
这条结论流传很广,因为它听起来很顺,但把组数算式摆出来,它立刻站不住。
"x86 砍掉 32 位就能追上 Apple"
追不上。x86 的遗留特性早就不在热路径上了——现代系统启动完就是平坦 64 位,16 位段机制、实模式、ring 1/2 全都不执行。
这些特性消耗的是芯片面积和验证工作量,不是每周期性能;砍掉它们,跑分可能涨两三个点,生态风险却是万亿级,这笔账谁算都划不来,Intel 自己算完也放弃了。
"Geekbench 单核分等于真实性能"
不等于:Geekbench 偏向量化、循环紧凑、工作集小,对硬件预取器特别友好,这些恰好是 Apple 的强项。
更中性的口径是 SPECint,或者干脆看你要跑的具体软件——数据库、编译、浏览器的排序经常和 Geekbench 不一致。说 Apple 强是对的,说"强 32%"就要看负载了。
"Intel 做不出高带宽 CPU"
做得出,而且做得更高:Xeon 6 系列八通道 DDR5,带宽六百到七百 GB/s,带 HBM 的 Xeon Max 超过 1TB/s。
M4 Max 的 546GB/s 是 LPDDR5X 512 位统一内存,主要喂给四十核 GPU 和媒体引擎,单颗 CPU 核连十分之一都吃不满;严格说它是"统一内存 SoC",不是"高带宽 CPU"。
Intel 不在消费级做,是因为 DIMM 必须可插拔、要卖给所有 OEM、要支持 ECC 和容量扩展,这几条和"焊死在封装里"天然冲突;不过方向在趋同,Lunar Lake 已经把内存封装到片上了。
常见问题
M 系列跑 Windows 体验如何
能跑,但有损耗:Parallels 下的 Windows 11 走的是虚拟化加翻译,日常办公够用,重负载和依赖驱动的软件会出问题,游戏是最弱的一环,瓶颈不在 CPU,在图形栈和反作弊。
为什么 Mac 打游戏还是不行
不是算力问题,是生态问题:原生 Mac 游戏少,移植靠工具链,反作弊的内核驱动在 ARM 上跑不了,而 M4 Max 的 GPU 算力不弱,缺的是愿意为它做优化的开发商。
苹果为什么不堆频率
堆频率的收益曲线太陡:从 4.6 到 5.7,性能多两成,功耗翻倍,笔记本的散热和续航立刻崩。Apple 卖的是"安静、冰凉、能撑一天",这条产品定位不允许它去追 6GHz。
高通 Oryon 为什么也强
团队是前 Apple 架构师,方法论一样,节点一样新,也没有 32 位包袱;但高通要卖给多家 OEM,调度和功耗策略没法像 Apple 那样一体化,实际体验的差距比跑分更大。
x86 会消失吗
短期不会:PC 存量、企业采购、服务器生态、游戏兼容,这些都不是五年能换掉的,更可能的走向是 x86 继续做减法,ARM 继续抢笔记本和服务器份额,两边长期并存。
学计算机的该关注哪个架构
两个都看,但别从指令集入手:先搞懂流水线、缓存、乱序、内存一致性这四件事,再看具体实现。架构之间差的是取舍,不是原理——这句话对 x86、ARM、RISC-V 一样成立。
回到开头那台没有风扇的笔记本:它快,不是因为它用了什么别人拿不到的技术,是因为它把别人算过账之后放弃的选项全买了下来——大四倍的 L1、宽两级的译码、深一倍的窗口、低两成的频率。
每一项单独拿出来都不惊艳,叠在一起就是 32% 的差距;而 Intel 和 AMD 不是算不出这笔账,是它们要同时照顾另外九本账。
下次再看到"苹果跑分作弊"或者"ARM 天生比 x86 省电"这类帖子,把页大小和每 GHz 得分这两个数摆出来,基本就能判断对方是不是在讲事实。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING