

打开讲 Transformer 的文章,翻到某一页,通常会单独框着这样一行:
Attention(Q, K, V) = softmax(QKT / √dk) V
每个字符你都认识。softmax 见过,Q、K、V 是三个大写字母,根号和除号更熟。可连在一起读的时候,脑子里是一片空白:这三个东西是谁?从哪来?矩阵乘完为什么就叫“注意力”了?
问题不在数学。问题在于 Q、K、V 不是通用符号,它们不是微积分里那个 ε、不是线代里那个 λ,它们是这篇论文自己发明的三个名字,而绝大多数文章跳过定义直接开始用。就像有人递给你一张图纸,上面标着“甲”“乙”“丙”,然后开始讲甲怎么连乙——你当然听不懂,因为你连甲是什么东西都还不知道。
这篇做两件事:先把大语言模型绕不开的几个公式,一个符号一个符号翻译成人话;再说清这些公式是怎么拼出一个能对话的模型的。不推导,不证明,每个符号说清三件事——它念什么、它指什么、它从哪来。
先说结论
在拆公式之前,先把整件事用一句话说清:大语言模型就是一个数学函数——给它前面所有的字,它算出下一个字是什么的概率。它一开始什么都不会,只能拿海量文本反复调参数,让它猜得更准;这一步做完,它学会的是“接着往下写”,不是“回答问题”。然后人类再教它一轮:同一个问题,哪种说法算好、哪种是敷衍,用奖励机制把好回答的概率抬上去,它这才知道被问了要答。
最后一步是让它学会想、也学会少说错——在给出答案之前先被打断,转去写一长串中间过程,写完再回头作答;答错扣分、答对加分,反复下来它挑出来的是“能走到正确答案的那条路”,不是“听起来最顺的那句话”。不过这一层只在有对错标准的地方成立,数学、代码、能跑测试的任务都算;至于写得漂不漂亮、判断得对不对,这套机制管不到,这也是它照样会编的原因。
- 公式里根本没有“字”这个词。从第一步开始,进网络的只有数字,所谓理解,是数字在空间里占到了合适的位置。
- 注意力的全部计算只有一行,六个符号,其中三个(Q、K、V)只是同一份输入乘上三个不同矩阵得到的三个分身。
- √dk 那个除法不是装饰,它是整个架构里几乎唯一一处“人工设计”的救火补丁,去掉它训练就崩。
- 损失函数里的负号和 log 各有分工:log 负责让“自信地错”罚得比“含糊地错”更狠,负号只负责把“最大化”翻成“最小化”。
- 符号吓人主要因为密度,不因为深度。下面这些公式,拆完之后你会发现每一个都在说一件很朴素的事。
一、从红警到 ChatGPT,这条路走了七十年
1956 年夏天,一批数学家和工程师在达特茅斯开了个会,给这件事起了名字——人工智能。从那时到 ChatGPT 上线,隔了六十六年。
中间是漫长的起落。普通人第一次直观见到“机器自己拿主意”,大多不是在实验室,是在游戏里。《红色警戒》那个年代的即时战略游戏,电脑对手会自己造兵、自己派兵,你打掉它一个矿场,它换个方向再开一片。规则清楚、目标明确的场合,机器做得比人快,也比人耐烦。
再往后是语音助手。2010 年代后期,对着音箱问一句“今天天气怎么样”,它能听懂,能放歌、能设闹钟。但这类系统有个天花板:每多听懂一种说法,工程师就要多写一条规则。你换个问法,它可能就接不住了。
2022 年 11 月,ChatGPT 上线,两个月用户破亿。它和之前那些系统最大的差别不是更聪明,是没人给它写规则——它从海量文字里自己学会了怎么接话。
到 2023 年,模型开始能调工具、能把一个任务拆成几步自己做;2024 年,这类东西有了统一的名字:Agent,智能体。
看起来换了好几代技术。但把外壳剥掉,底下那套东西——矩阵乘法、softmax、梯度下降——从 2017 年那篇 Transformer 论文之后基本没动过。变的是数据量、参数量和训练方法。
所以下面要拆的这几个公式,不是新东西,是这场爆发里唯一没变的那部分。
二、模型从第一步起,就没见过“字”
不把这件事说清,后面的公式全是悬空的。你说“北京是首都”,模型收到的不是四个汉字,是一串整数,再往下是一串小数。它这辈子没见过汉字,也没见过“词”这个概念——中间那步切分,是按字节出现频率合并出来的,跟语法没关系。
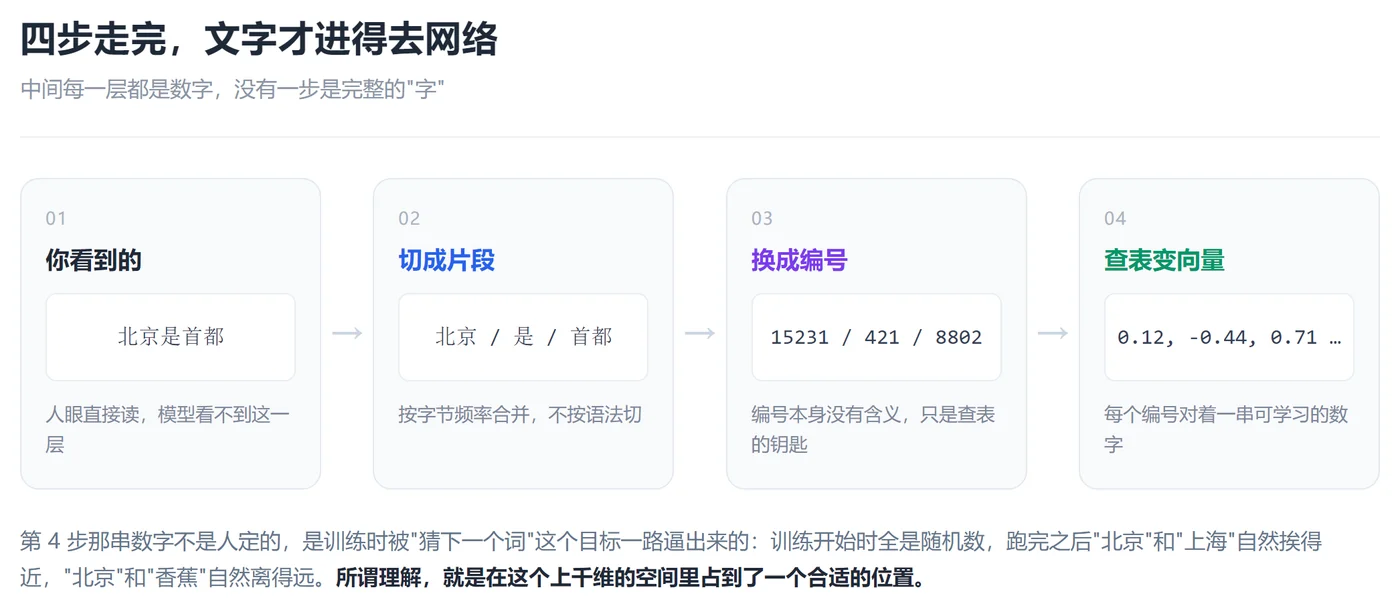
第四步那串数字最有意思。它不是人定的,人只定了一件事:这串数字要能让“猜下一个词”这件事尽量准。训练开始时全是随机数,跑完几万亿 token 之后,“北京”和“上海”的向量自然挨得近,“北京”和“香蕉”自然离得远。
所以后面所有公式里的 Q、K、V、X,指的都是第四步这一堆数字,不是文字。把这一点记住,符号的恐怖感会掉一半。
三、先认几个数学词
拆符号之前,有七个词得先说清楚。它们都是中学到大学一年级的内容,但多数人只记住了名字,没真正用过一次。下面每个单独讲,尽量把“大概是这个意思”变成“我知道它在算什么”。
向量:一串有序的数字
一排数字就是向量。(175,68,29)因为里面有三个数,所以叫三维向量。就这么简单——三维不是空间里的三个方向,是三个数字。
模型里每个词对应一个向量,通常一千多维,也就是一千多个数字。这串数字是训练算出来的,单独看每一维都没有含义:并不存在“第 37 维代表褒贬”这种对应关系,它只是一千多个坐标。
高维之所以让人不适,是因为二维能画在纸上,三维能想象成立方体里的一个点,一千维没有任何对应的图像。但画不出来不等于算不了。两个向量相加,就是把对应位置的数分别相加,一千维和三维的规矩完全一样,机器不需要“看见”它。
顺带澄清一个常被混的地方:“维度”和“参数量”是两个东西。说一个词用 4096 维表示,是指它的向量有 4096 个数字,不是模型只有 4096 个参数。
矩阵:一张数字表格
矩阵就是把一堆数字排成矩形。下面这个有 2 行 3 列,一共 6 个数:
1 2 3
4 5 6
行数是横着的条数,列数是竖着的条数。这个顺序别记反,下面讲方阵要用。
在公式里,X 是“一句话里所有词的向量摞起来”,形状是(词的个数 × 向量维度);W 是一个(维度 × 维度)的矩阵,属于模型参数。矩阵本身没有任何运算含义,它就是个容器,真正的操作在下面。
方阵:行数和列数一样多
方阵就是行数等于列数的矩阵。3 行 3 列、10 行 10 列,都叫方阵。上面那个 2 行 3 列的不是方阵。
为什么单独给它一个名字?因为在矩阵运算里,方阵有几条别的矩阵没有的性质——可以自己乘自己,可以求逆,可以算行列式。这些在这篇里都用不到,你只需要记住一件事:
QKᵀ 乘出来一定是方阵。因为它是“每个词对每个词”,10 个词就是 10 行 10 列,1000 个词就是 1000 行 1000 列。行是“谁在看”,列是“看谁”。
所以看到“方阵”这个词,脑子里换成“一张正方形的表”就够了,不用想更多。
矩阵乘法:一行乘一列
规矩只有一条:左边取一行,右边取一列,对应位置相乘,再加起来。
拿两个 2 乘 2 的矩阵试一次。A 的第一行是 1 和 2,第二行是 3 和 4;B 的第一行是 5 和 6,第二行是 7 和 8。要算的结果叫 C,也是 2 乘 2,四个格子一个一个来:
C 左上角 = 1×5 + 2×7 = 19
C 右上角 = 1×6 + 2×8 = 22
C 左下角 = 3×5 + 4×7 = 43
C 右下角 = 3×6 + 4×8 = 50
C 的每个格子,都是“A 的一行”和“B 的一列”配对算出来的。一层里那 12d² 个参数,就是这些矩阵的尺寸堆出来的——大多是 d 乘 d,或者 d 乘 4d。
这里有个容易卡住的地方:为什么非得是“左行乘右列”,不能随便乘?因为要让“行”代表输出的某一个位置,“列”代表输入的某一个位置,这样每个输出位置才能收集到全部输入的信息。换成别的规则,这套对应关系就断了。
极限:无限靠近,但不等于
极限描述的是趋势,不是某个具体的数。举个例子,看这串数:0.9,0.99,0.999,0.9999……一直写下去。它永远不会真的等于 1,但会无限接近 1。数学上用 lim 表示这种“无限靠近”,写成 lim(n→∞) xₙ = 1,读作“当 n 趋于无穷时,xₙ 的极限是 1”,这里的 n 指的是第几个数。
注意这里没有说“等于”。极限的意思不是“最后到达了”,是“你要求多接近,我都能做到比那更接近”。
偏导里会用到它。因为导数的定义是“变化量趋于 0 时,变化率的极限”——Δx 不能真的等于 0(等于 0 就成除以 0 了),只能让它无限小,再看比值趋向哪个数。这篇里你不会真的去算极限,知道它在说什么就够了。
偏导:只问一个方向
偏导是最容易被一句话带过、也最容易糊住的地方。“把别的按住不动”这个说法,省略了三个关键动作。下面用一个能真算的例子走一遍。
设 f(x, y, z) = x² + 3y + z。要问的问题是:在 x=2、y=1、z=5 这个点上,只让 x 变大,f 会怎么变?
第一步,把 y 和 z 换成常数。不是“按住不动”这么抽象——是把它们当成具体数字写进去:y 就是 1,z 就是 5。
f(x) = x² + 3×1 + 5 = x² + 8
到这一步,原来的三元函数已经被压成了一个只含 x 的一元函数。这才是“按住不动”的真实含义:它们从变量变成了常数,在这个过程中不再是会变的东西。
第二步,对 x 求导。x² 的导数是 2x,常数 8 的导数是 0,所以:
∂f/∂x = 2x
第三步,把 x=2 代进去,得 2×2 = 4。这个 4 的意思是:在(2,1,5)这个点上,x 每增加 1,f 大约增加 4。
“大约”这两个字很关键。导数是瞬时变化率,只有变化量足够小的时候,按它线性推算才准。x 从 2 加到 2.01,f 从 12 变成 12.0401,增加了 0.0401,确实是 4 的 0.01 倍。但 x 从 2 加到 3,f 从 12 涨到 17,涨了 5,不是 4。差得越多,越不准。
所以要想精确,就得让变化量趋于 0,写成这样:
∂f/∂x = lim(Δx→0) [ f(x+Δx, y, z) − f(x, y, z) ] / Δx
这个式子看起来唬人,拆开就是三件事:
先让 x 多一点点(x+Δx),y 和 z 照原样——这就是“变一点点”的具体做法;再用新的 f 减去旧的 f,得到输出变化了多少;最后除以 Δx,得到每变一个单位,输出变多少。
最后让 Δx 无限趋近 0,就得到那一点上的精确变化率。这也解释了为什么需要极限:Δx 不能等于 0,只能越来越小。
那为什么叫“偏”?因为空间不止一个方向。除了 x 方向,还有 y 方向和 z 方向。偏导只问其中一个方向,故意忽略其他方向。同一个点上,往 x 方向走可能是上坡,往 y 方向走可能是平路,两个偏导会给出完全不同的数。在这个例子里,三个偏导分别是 4、3、1。
为什么写成 ∂ 而不是 d?纯粹是记号上的区分:d 用于只有一个变量的情况,∂ 用于多个变量里挑一个。算的东西其实一样。
顺带说,把三个偏导排成一队,就是梯度:(4, 3, 1)。它指向“往哪个方向走,f 涨得最快”。后面讲的梯度下降,就是朝它的反方向走。
子集:集合里的一部分
集合就是把一些东西打包成一个整体,比如 A = {1, 2, 3, 4, 5}。子集是从里面挑一部分出来,单独打包,比如 B = {2, 4}。
B 里的每个元素都在 A 里,所以 B 是 A 的子集,写作 B ⊆ A。两个容易忽略的地方:空集是任何集合的子集;集合自己也是自己的子集。这篇正文里没用到它,但读论文会撞见,比如“训练集是数据集的一个子集”这种说法。
这七个词说完了。下面那张符号表不再重复它们,只讲那些直接出现在式子里的记号。
四、一张符号对照表
下面这张表,建议先扫一眼再看公式。所有让人卡住的东西都在里面。
| 符号 | 怎么念 | 在这个语境里到底是什么 |
|---|---|---|
| θ | theta | 模型全部可调参数的总称,几亿到几千亿个数字,训练就是改它们 |
| xt | x 下标 t | 第 t 个片段。注意是片段不是字,中文一个词常被切成两三段 |
| x<t | x 下标小于 t | 它前面所有的片段,也就是"已经看过的上文" |
| p(A | B) | A 在 B 条件下的概率 | 已知上文 B 之后,下一个词是 A 的可能性 |
| Σ | 西格玛,求和 | 把一串东西全加起来,没有别的意思 |
| log | 对数 | 把概率换算成惩罚力度。概率越接近 0,log 的负值越大 |
| − | 负号 | 只是把"越大越好"翻成"越小越好",方便叫它"损失" |
| ∂L/∂θ | 偏 L 偏 θ | 单独看某一个参数,它挪一下,损失 L 会变多少 |
| ∇L | nabla L,梯度 | 所有参数的偏导堆成一个向量,指向 L 上升最快的方向 |
| η | eta,学习率 | 每一步挪多远。太大踩过坑,太小学不完 |
| E[·] | 期望 | 平均,在数据分布上取均值 |
| KL(·‖·) | KL 散度 | 两个概率分布差多远。严格说不是距离,但可以当距离理解 |
| σ | sigmoid | 把任意实数压进 0 到 1 之间,常用来看概率 |
| β | beta | 一个可调的系数,控制两股力量谁说了算 |
| T | 转置 | 把矩阵横过来放。不是新东西,只是为了让两个矩阵能相乘 |
就这些。剩下的全是加减乘除和矩阵乘法。
五、注意力那个公式,一个符号一个符号看
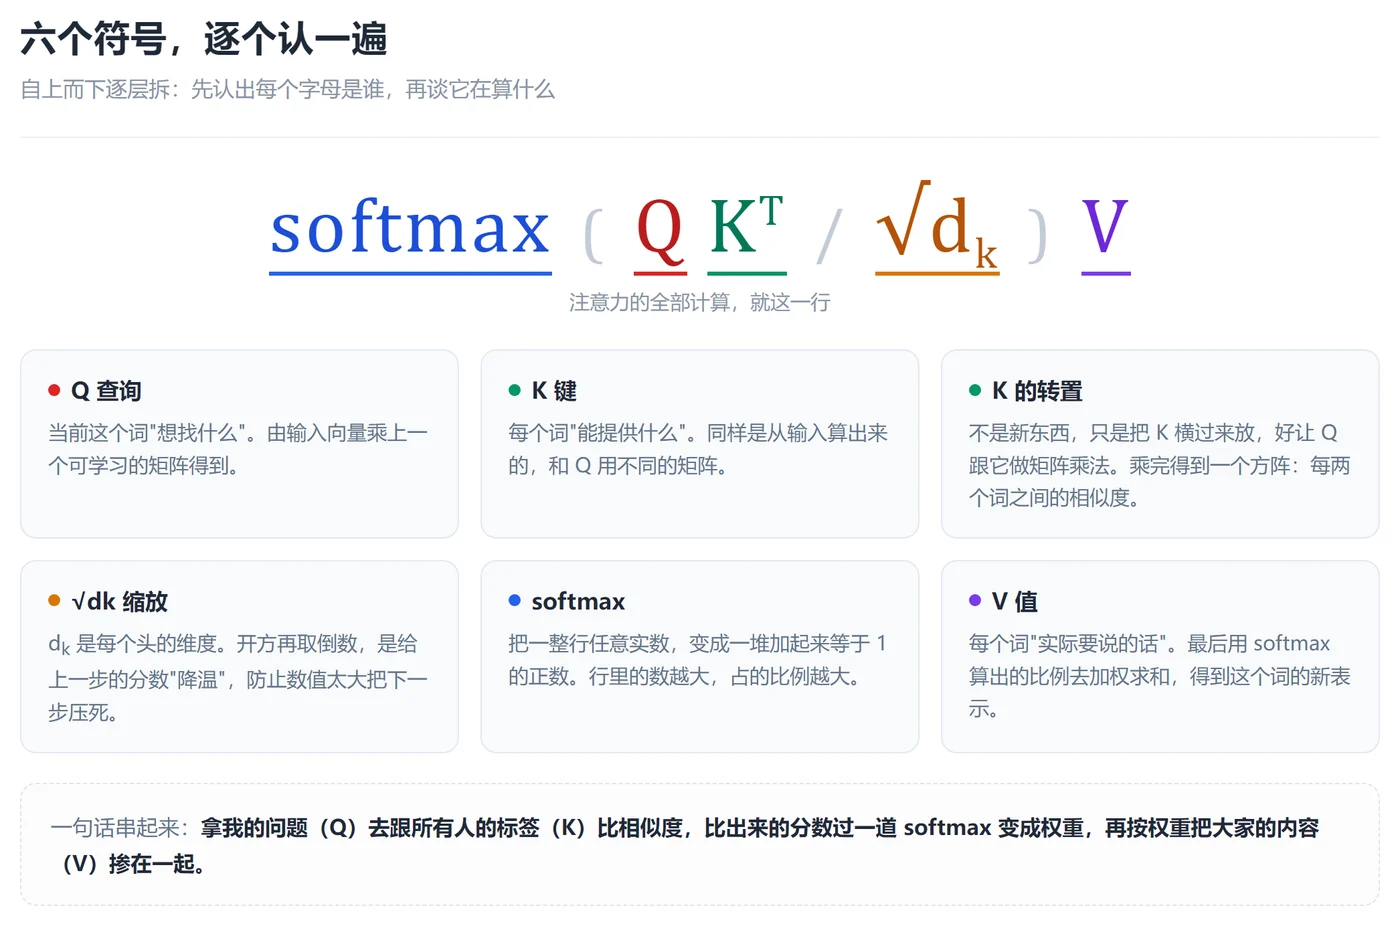
图上把每个符号都标了,这里补三件图上说不完的事。
第一,Q、K、V 是同一份输入的三个分身。它们不是三份不同的数据,是同一堆数字乘上三个不同的矩阵:
Q = X·WQ K = X·WK V = X·WV X 是那一堆向量,W 是三个可学习的矩阵,属于 θ 的一部分
为什么要分成三个?因为在“这个词该关注哪些词”这件事里,有三种不同的角色:我在找什么(Q)、我能提供什么(K)、我实际要交出去的内容(V)。合成一个就没法表达“我想找的和我要给的不一样”这种情形,而这种情形恰恰是语言里最常见的。
第二,QKT 乘出来的是一个方阵(行数和列数一样多的矩阵),不是向量。假设一句话 10 个词,乘完你得到一个 10 乘 10 的表,第 3 行第 7 列那个格子,意思是“第 3 个词对第 7 个词的关注程度”。
这一步是整个注意力里最贵的地方,因为它随长度平方增长。10 个词是 100 个格子,1000 个词是 100 万个格子。长上下文之所以贵,贵的就是这张表。
第三,softmax 是按行做的。上面那张表每一行过一遍 softmax,让每行的数加起来等于 1。所以每一行变成了一组百分比:这个词把自己的注意力,按什么比例分给其他所有词。
最后乘 V,就是按这组比例把大家的内容掺起来。掺完之后,这个词的新向量里就混进了别人的意思——“它”这个字的向量里,混进了“书”的意思,所以下一层才能判断“它太重了”是指书重,不是桌子重。
一句话串完:拿我的问题(Q)去跟所有人的标签(K)比相似度,比出来的分数过 softmax 变成权重,再按权重把大家的内容(V)加权求和。没有了,注意力就这一件事。
六、为什么非除一个 √dk 不可
这是整行公式里唯一一个“看起来像凑出来”的东西,很多人以为是经验技巧,其实它有明确的数学原因。
dk 是每个注意力头的维度,比如 64 或 128。QKT 里每个格子的值,是 dk 个乘积之和。如果每个分量大致独立、均值 0、方差 1,那么 这个和的方差大约是 dk——维度越大,格子里的数字越夸张。
数字一大,下一步的 softmax 就出问题。softmax 里有指数函数,输入差个十几,输出就变成 0.9999 和 0.00001。这时候那一行实际上变成了“只关注一个词,其他全忽略”,而且更糟的是梯度几乎变成 0——因为 softmax 在极端值附近是平的,参数就学不动了。
除以 √dk 是把方差拉回 1 附近。方差归到 1,softmax 就落在它最有分辨力、梯度最健康的那段区间里。
所以这个除法不是调参技巧,是让整个训练能跑起来的前提。去掉它,小模型可能只是变差,大模型基本会直接训崩。
七、softmax:把分数变成比例
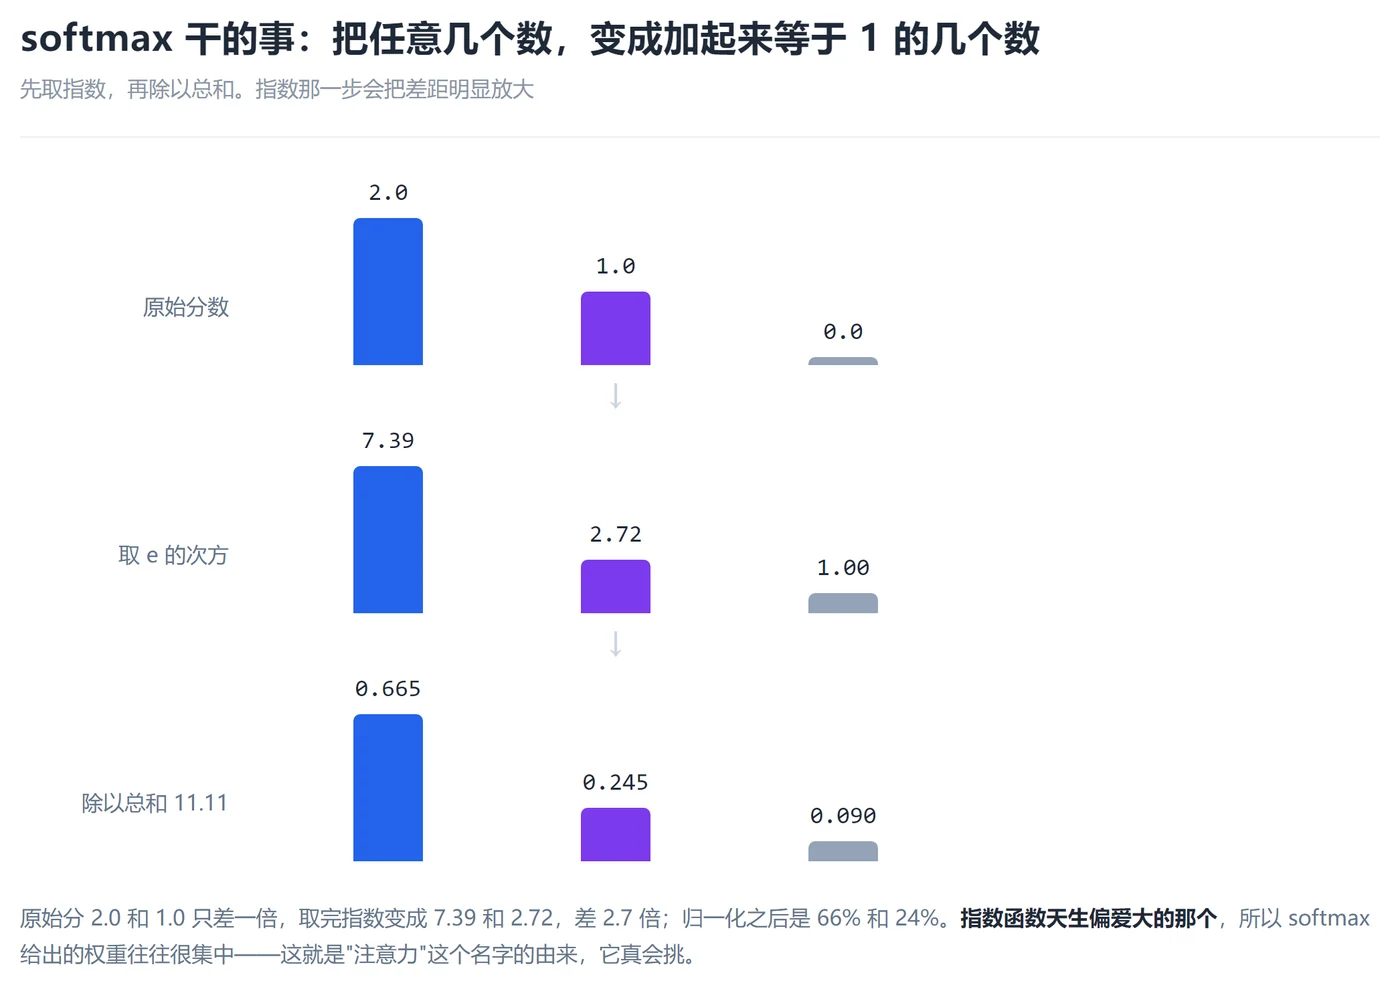
它的定义只有一行:
softmax(z)i = ezi / Σj ezj 分子的意思是:第 i 个分数取 e 的次方。分母的意思是:所有分数取 e 的次方之后加起来
拆开就三步:每个数取 e 的次方、全都加起来、各自除以这个和。它保证了两件好事:结果全是正数,加起来恰好等于 1,可以当比例用。
但真正有用的是它顺带做的那件事——指数函数会放大差距。图上第一行 2.0 和 1.0 只差两倍,取完指数变成 7.39 和 2.72,差到 2.7 倍。所以 softmax 的输出往往很“偏”,一两个拿走大部分权重,剩下的接近 0。
这不是缺陷。“注意力”这个名字之所以成立,就是因为这个偏——它真的会挑,而不是平均分配。
八、把一句话从头到尾走一遍
前面几节把符号一个一个拆开了,但拆完还是一地零件。这一节拿一句真话把它们串起来:我今天去了广州。模型要做的事只有一件——猜出跟在“广州”后面的是哪个词。
下面六张动图是同一件事的六个阶段,会一帧一帧往下走。为了画得下,向量只画 4 维;真实模型一层是 4096 维,每个注意力头 128 维。图里的数字是示意的,但每一步的算法都是真的。
分词不按语法切,按高频片段切。切完再查表:每个编号对应参数矩阵里的一行,这一行就是这个词的初始向量。位置编码也在这里加进去,否则“我打你”和“你打我”进模型时是同一批数字,它分不出谁在前。
注意 q、k、v 不是三份数据,是同一行向量乘三个不同矩阵的结果。可以理解成同一个词被问了三个问题:你要找什么、你能提供什么、你实际携带什么内容。
这一格算的是“广州”和“去了”有多配。算法就是逐位相乘再相加,没有别的花活。维度越大,加出来的数越飘——这正是上一节那个除法的由来。
原始分数有正有负,也不会加起来等于 1,没法直接当权重用。softmax 把它们压成一组份额。注意它是按行做的:每个词自己决定把注意力怎么分给四个位置,行与行之间互不影响。
拿到份额之后,用它去加权四个位置的值向量,加成一个新向量。这时候“广州”这个向量里已经混进了“去了”和“今天”的信息——“注意力”这三个字,落地就落在这一步。另外留个心眼:四个位置各得一个新向量,但只有最后一个会继续往后走。
新向量乘词表矩阵,一次得到十二万多个分数,softmax 变成概率,“玩”拿到最大的那个,于是被选中。选中之后并没有结束——把它接到句子末尾,整条链路从头再算一遍,去猜“玩”后面跟什么。一句话 20 个词,就要走 20 遍。训练时之所以四个位置一起算,纯粹是为了省时间。
走完这一遍,开头那句话可以说得更准确一点了:模型没有“读懂”这句话,它做的是——把四个位置之间的关系算成一张表,用这张表把信息重新混一遍,再拿最后一个位置去猜下一个词。语法、语义没有独立模块,全都长在这条链路里。
九、损失函数:负号和 log 各自的活儿
模型吐出的是每个词的概率,得有个东西告诉它“你猜得有多差”。这个东西就是:
L(θ) = − (1/T) Σt log pθ(xt | x<t) T 是这段文本的长度。p 那一项是:给了上文之后,模型给“真实的下一个词”打了多少概率
先看最里面那个 pθ(xt | x<t):模型认为“真正的那个词”出现的概率有多大。猜得准,这个数接近 1;猜得离谱,接近 0。
然后取 log。为什么不直接用概率当惩罚?因为 log 在接近 0 的那一端下坠得特别快,而那一端恰好就是“猜错”发生的地方。
- 模型给正确答案 0.9 → log 约 −0.11,几乎不罚
- 给 0.5 → 约 −0.69
- 给 0.1 → 约 −2.30
- 给 0.01 → 约 −4.61
- 给 0.001 → 约 −6.91
从 0.9 掉到 0.1,概率差了九倍,惩罚从 0.11 涨到 2.30,涨了二十倍。这就是 log 的用处:它把“自信地错”和“含糊地错”拉开了距离,而前者恰好是模型最危险的错误形态——一个笃定的错答案,比一个犹豫的错答案更容易被信。
负号只是把一串负数翻成正数,让“损失”符合直觉——越小越好。前面的求和是所有位置累加,除以 T 是取平均,免得长文本天然罚得重。
最后那一句可能反直觉:整个训练里没有人标注答案,标签就是原文自己的下一个字。也正因为如此,它才能吃下几乎无限量的文字。
十、梯度下降:∂ 和 ∇ 的区别
有了损失,还得知道往哪改参数。这一步的公式只有一行:
θ ← θ − η · ∇θ L 读作:新的 θ 等于旧的 θ,减去 学习率 乘 梯度
四个部分,逐个说。
∂L/∂θ 是偏导,问你一个非常具体的问题:如果只把某一个参数往上挪一点点,损失会变大还是变小,变多少。它一次只回答一个参数。
∇L 是梯度,是上面那个问题对所有参数的回答凑成的一个向量。模型有几百亿个参数,就有几百亿个偏导,堆在一起就是梯度。它指向“损失上升最快”的方向。
负号就是“反着走”。梯度指向上坡,我们要下坡,所以减。
η 是学习率,决定每步迈多大。这一步有个具体的例子好理解:假设损失函数简单到 L = θ²,在 θ = 4 的地方,梯度是 8。取 η = 0.1,那么新 θ 就是 4 − 0.8 = 3.2。再算一次,梯度变成 6.4,新 θ 是 2.56。一步比一步慢,最后稳稳停在 0 附近。
如果 η 取 1.0 呢?4 − 8 = −4,直接跑到另一边,下一步又弹回来,来回震荡永远不收敛。这就是学习率调不好的典型症状:loss 不降,反而上下乱跳。
真实训练里真正的做法比这复杂:一批数据算一次梯度、动量、自适应步长、梯度裁剪、学习率先热身再缓慢下降。但那些都是在这一个式子上加修饰,核心动作始终是“算方向、走一小步”,重复几千亿次。
十一、后训练:从续写变成对话
预训练完的模型只会续写,不会对话。你问它“法国的首都在哪里”,它不会回答,而是接着往下出一串类似的问题——因为它学的是“句子后面该跟什么”,从没人教过它“被提问要作答”。要让它变成一个能对话的助手,得再改一轮参数,这轮的核心公式长这样:
max E(x,y)~πθ [ rφ(x, y) ] − β · KL( πθ(·|x) ‖ πref(·|x) ) 读作:让奖励的平均值尽量大,同时别离参考模型太远,两边按 β 加权
这行里的符号看着最唬人,其实只在讲一件很日常的事:既要进步,又不能跑偏。
| 符号 | 大白话 |
|---|---|
| rφ(x, y) | 奖励模型给这个回答打的分。它不是人,是人看了大量"哪个回答更好"之后训出来的一个打分器 |
| E[·] | 平均。不是一个回答打分,是很多回答一起平均 |
| πθ | 正在训练的那个模型,把它想成"当前策略" |
| πref | 复制一份、冻结不动的旧模型,也就是初始参数 |
| KL(·‖·) | 两个模型的输出分布差多远。差得越多,这一项越大 |
| β | 这根绳子的松紧。调大,模型老实但进步慢;调小,分数涨得快但人话不会说了 |
为什么非要加后面那一项?因为奖励模型本身是个近似,它有漏洞。如果只让它一个劲儿追分数,模型迟早会找到漏洞开始刷分——输出变得又怪又长,分数很高,人看不懂。这个现象有个专门的名字叫 reward hacking。
KL 那一项就是一根绳子,把模型拴在初始参数附近,不许跑太远。所谓“后训练”,本质是在一个已经会说话的东西身上做小幅调整,而不是重新教它说话。
后来有个叫 DPO 的方法把这条绳子直接写进了损失函数里,省掉了奖励模型,公式变成这样:
L = − log σ( β·log(πθ(yw|x)/πref(yw|x)) − β·log(πθ(yl|x)/πref(yl|x)) ) yw 是人选中的那个回答,yl 是被人放弃的那个。σ 把结果压到 0 到 1,log 再变成损失
这个式子看着长,其实只要求一件事:好回答的概率(相对初始参数)要涨,坏回答的概率要跌。“相对初始参数”这几个字很重要,它防的就是上面说的跑偏。
十二、让它先想再答
前面那套奖励机制管的是“哪个回答更讨人喜欢”。但讨好和正确不是一回事——一段话说得漂亮、听起来很有道理,照样可能是错的。这两年出现的一批推理模型走的是另一条路:不评价回答好不好看,只评价最后那个答案对不对。
这里有个绕不过去的限制:模型每做一次前向计算,只产出一个词。它没有“在脑子里想”这个动作,想必须写成字,才能占住计算。所以所谓“先思考再回答”,落到实现上就是在答案前面先写一大段中间过程。这段过程进了上下文,就成了下一步的输入,下一步看得见自己刚才写了什么。一次前向的深度,被拉成了几十上百次前向串起来——它没有变聪明,是算力被摊到更长的路上了。
训练时的做法也就顺理成章:不让它直接吐答案,先让它写推理,再让它给结论,打分只看结论。这就是那个“中断”——在作答那一刻把它按住,转去写草稿。草稿写得好不好没人管,只要最后结论对,整条路径的权重就往上抬。所以它学到的是“能走到正确答案的那条路”,不是“听起来最顺的那句话”。
打分那部分更简单,只要题目有唯一答案就行。数学题有标准解,代码题能跑测试用例,答案对不对是程序判得出来的,不需要人来标。判对给正分,判错给负分,一条规则就能自动产出海量的训练信号。这套做法叫“可验证奖励”,写成式子就这么点:
R(y) = +1(答案判对) / −1(答案判错)y 是模型给出的最终答案,过程不参与打分
它的价值在于绕开了人类打分的瓶颈。让人一条一条读、一条一条选,几万条就是极限;让程序判对错,几百万条也不费劲。推理能力这两年的提升,主要来自这里,不是因为模型突然开窍了。
但有一点必须说清:它被惩罚的是“答案错”,不是“过程假”。所以它能学到的,是“在有标准答案的地方少犯错”;在没有标准答案的地方——判断、取舍、审美,以及“这句话是不是编的”——这套机制一分都给不了。这也是为什么它在数学题上越来越靠得住,写一件你公司里的事却还是可能张口就来。
所以“说真话”这件事,目前靠的不是它学会了诚实,而是外面有没有一把能判对错的尺子。有尺子的地方,它被压着不敢错;没尺子的地方,它只能挑听起来最顺的那条路走。
十三、把话收回来
现在再回头看第一行公式。
Attention(Q, K, V) = softmax(QKT / √dk) V
Q、K、V 是同一份输入乘上三个矩阵得到的三个分身;QKT 算出每两个词之间的相似度,得到一个方阵;除以 √dk 是防止数值太大把下一步压死;softmax 按行归一成百分比;乘 V 是按百分比把内容掺起来。
就完了。这一行重复几十层,就是一个能接着往下写的模型。它离“能对话”还差最后一步——那一步改的是它愿不愿意按你的话做,不改这一行。
写这篇的原因不是公式本身多难,而是符号密度太高,而解释太少。一篇论文为了省篇幅,会把 Q 的定义放在三个自然段之前,读者读到公式的时候早就忘了。真正需要的往往就是一句话:这个字母是谁,它从哪来。
所以下次再撞上这类公式,可以试试这个顺序:先找那个你没见过的符号,查清它指什么,别急着看它在式子里的位置。通常查完两个,剩下的你自己就能读出来了。
至于那些一时半会儿查不到的,多半是因为它在这篇文章里被作者重新定义过——那不是你的问题。
公式和符号从来不是孤零零摆在那儿的东西,它是某个人思考留下的痕迹——有人想知道“这个词和那个词有多相关”,试了很多种办法,最后写下 QKᵀ;有人发现数值一大就算崩了,加了个除以根号 d。每一个看着莫名其妙的记号,背后都对应着一个具体的麻烦。
所以“公式背下来就会了”这句话,只说了一半。背下来的是形状,理解到的是形状为什么长成这样。这两件事差得远:背下来的,换个场景就不认你了;真懂了的,符号忘了也能自己推回来。
这篇能做到的,只是把每个符号重新对应回它当初要解决的那个麻烦。剩下的那一步,别人替不了。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING