

2026 年 9 月,华为 Mate XT 2 带着新一代旗舰 SoC 麒麟 9050 Pro 上市。这一代最大的变化不是"继续堆核",而是把功夫下在了底层——华为第一次把逻辑折叠(Logic-Folding)这种 3D 集成思路用在 CPU 的关键路径上,让超大核频率回到 3.1GHz,同时把同性能下的功耗压了下来。这篇文章把极客湾的实测图逐张拆开看:从论文原始数据,到规格、能效曲线、GPU / NPU 跑分与三款大作的 30 分钟帧率,全部以图上读到的数字为准,不吹不黑。
一、先看规格:3.1GHz 超大核,大核拆成了两档
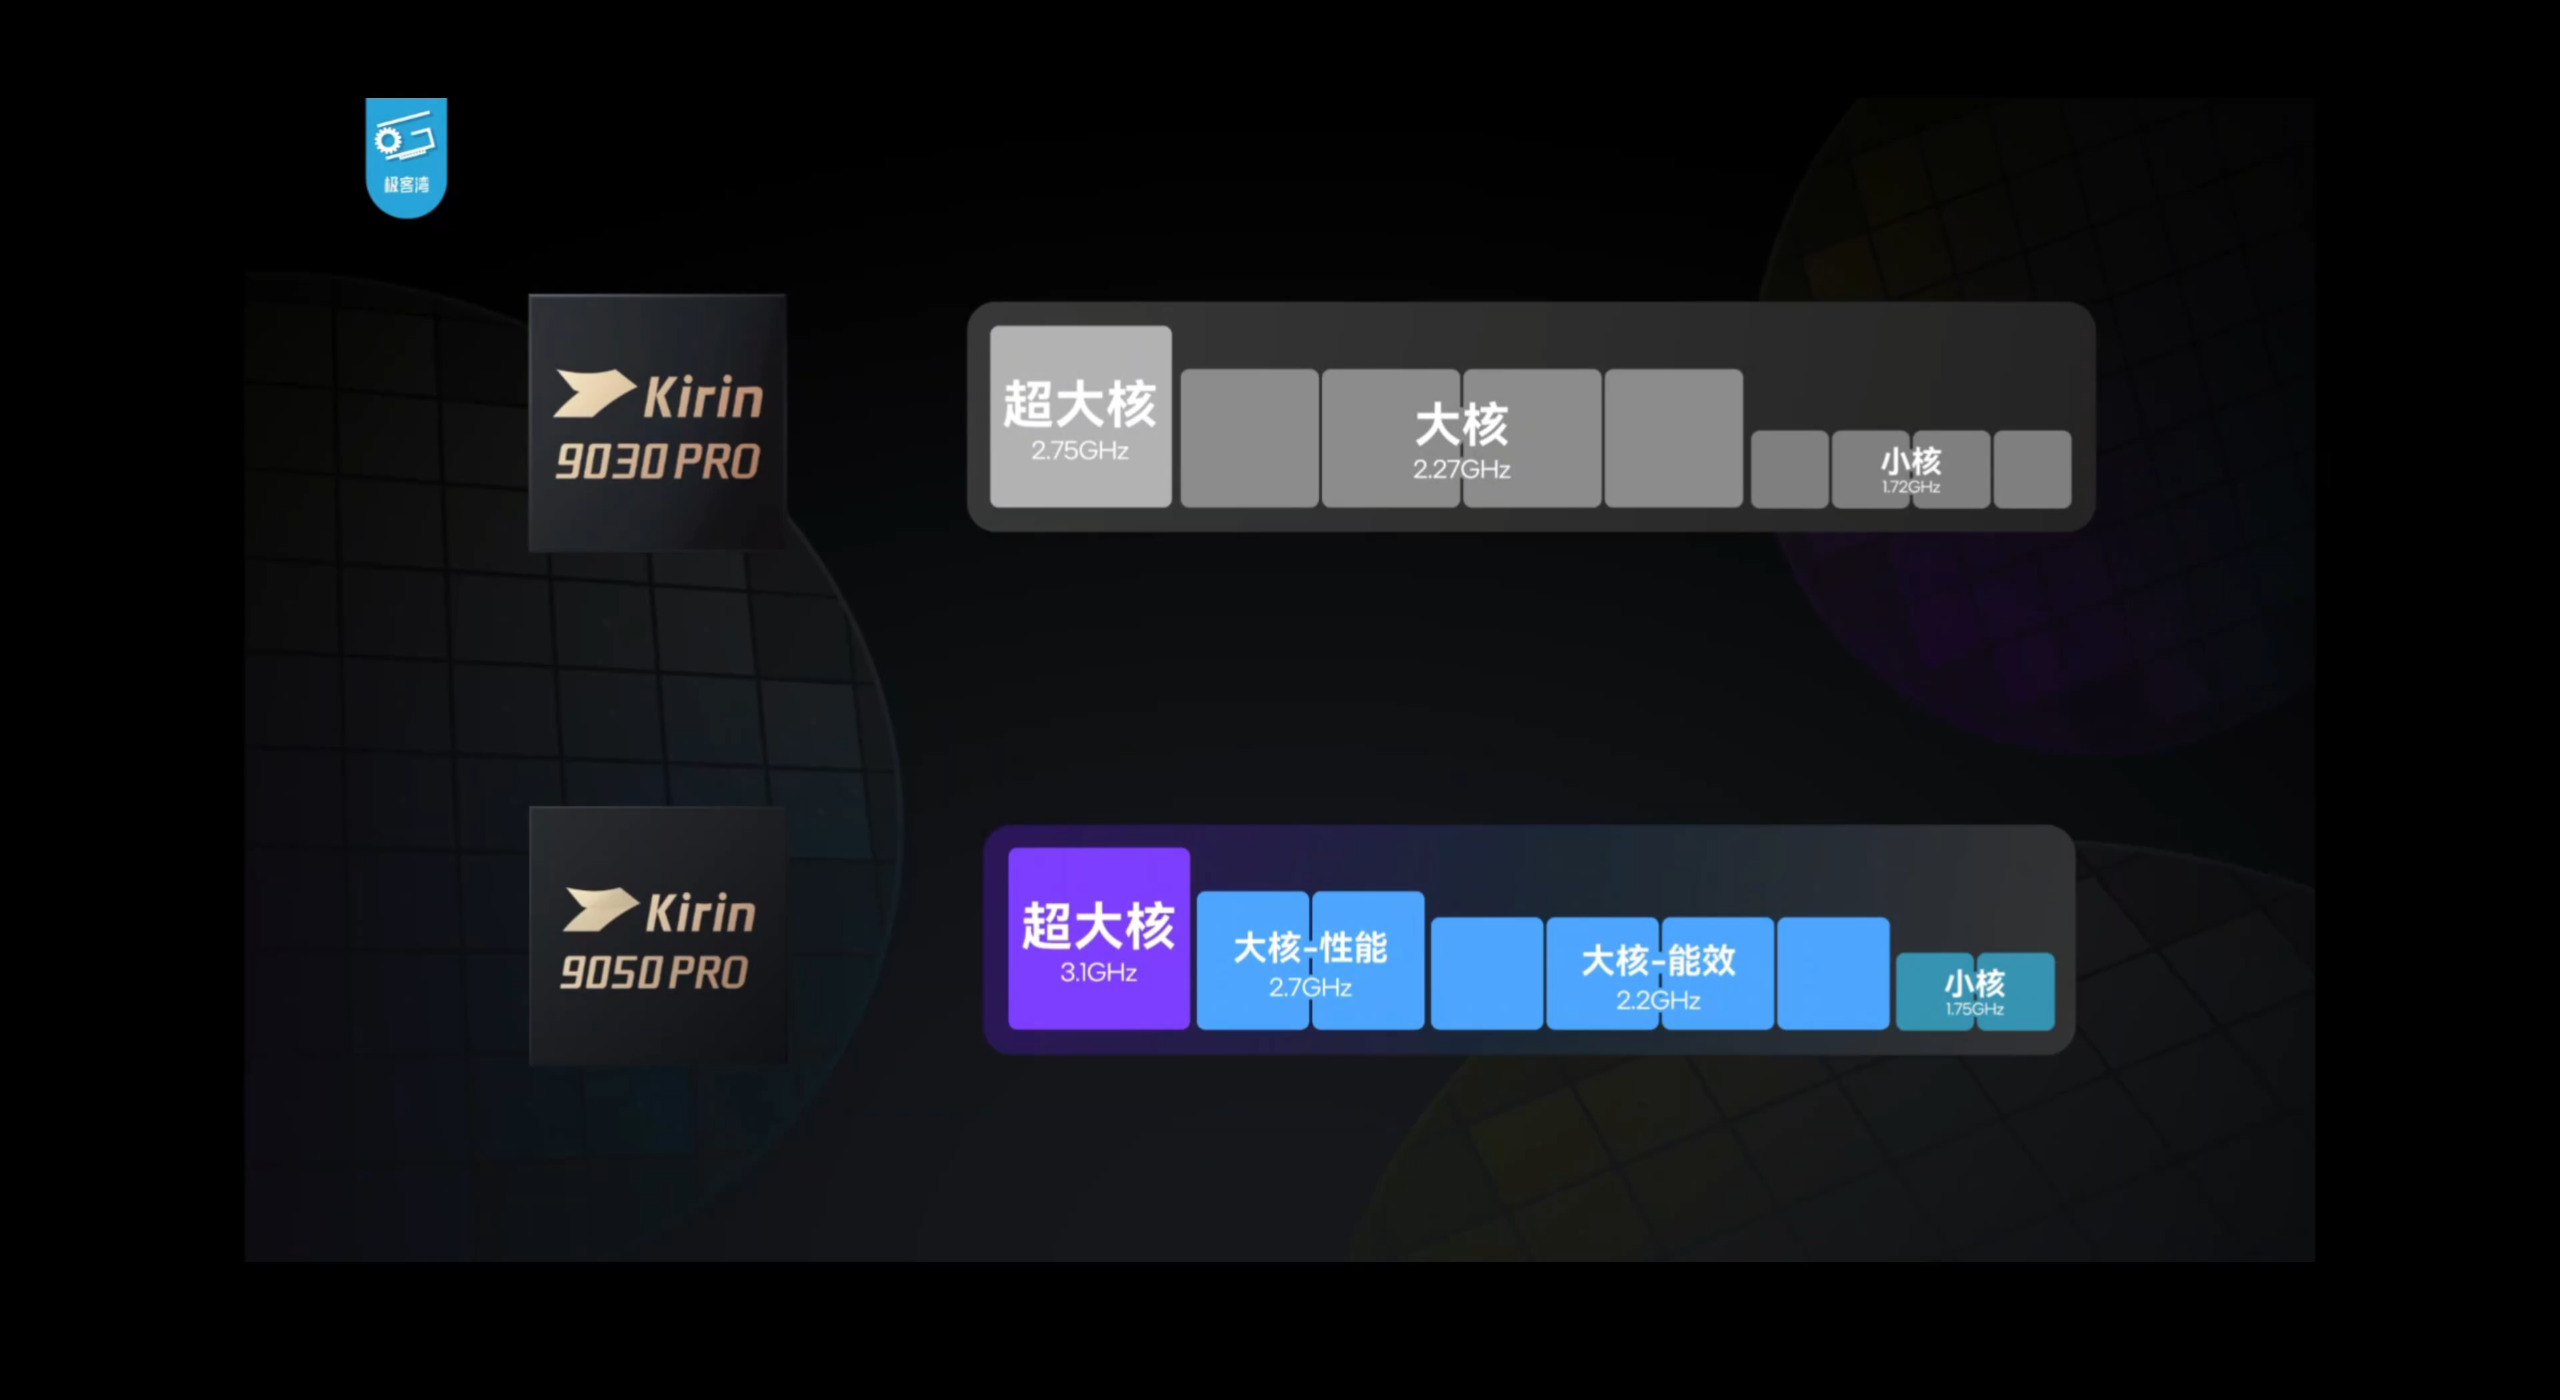
先看核心分档。9030 PRO 是三档结构:超大核 2.75GHz、大核 2.27GHz、小核 1.72GHz;到了 9050 PRO,核心被拆成四档:
- 超大核:2.75GHz → 3.1GHz
- 大核-性能:新增,2.7GHz
- 大核-能效:新增,2.2GHz
- 小核:1.72GHz(不变)
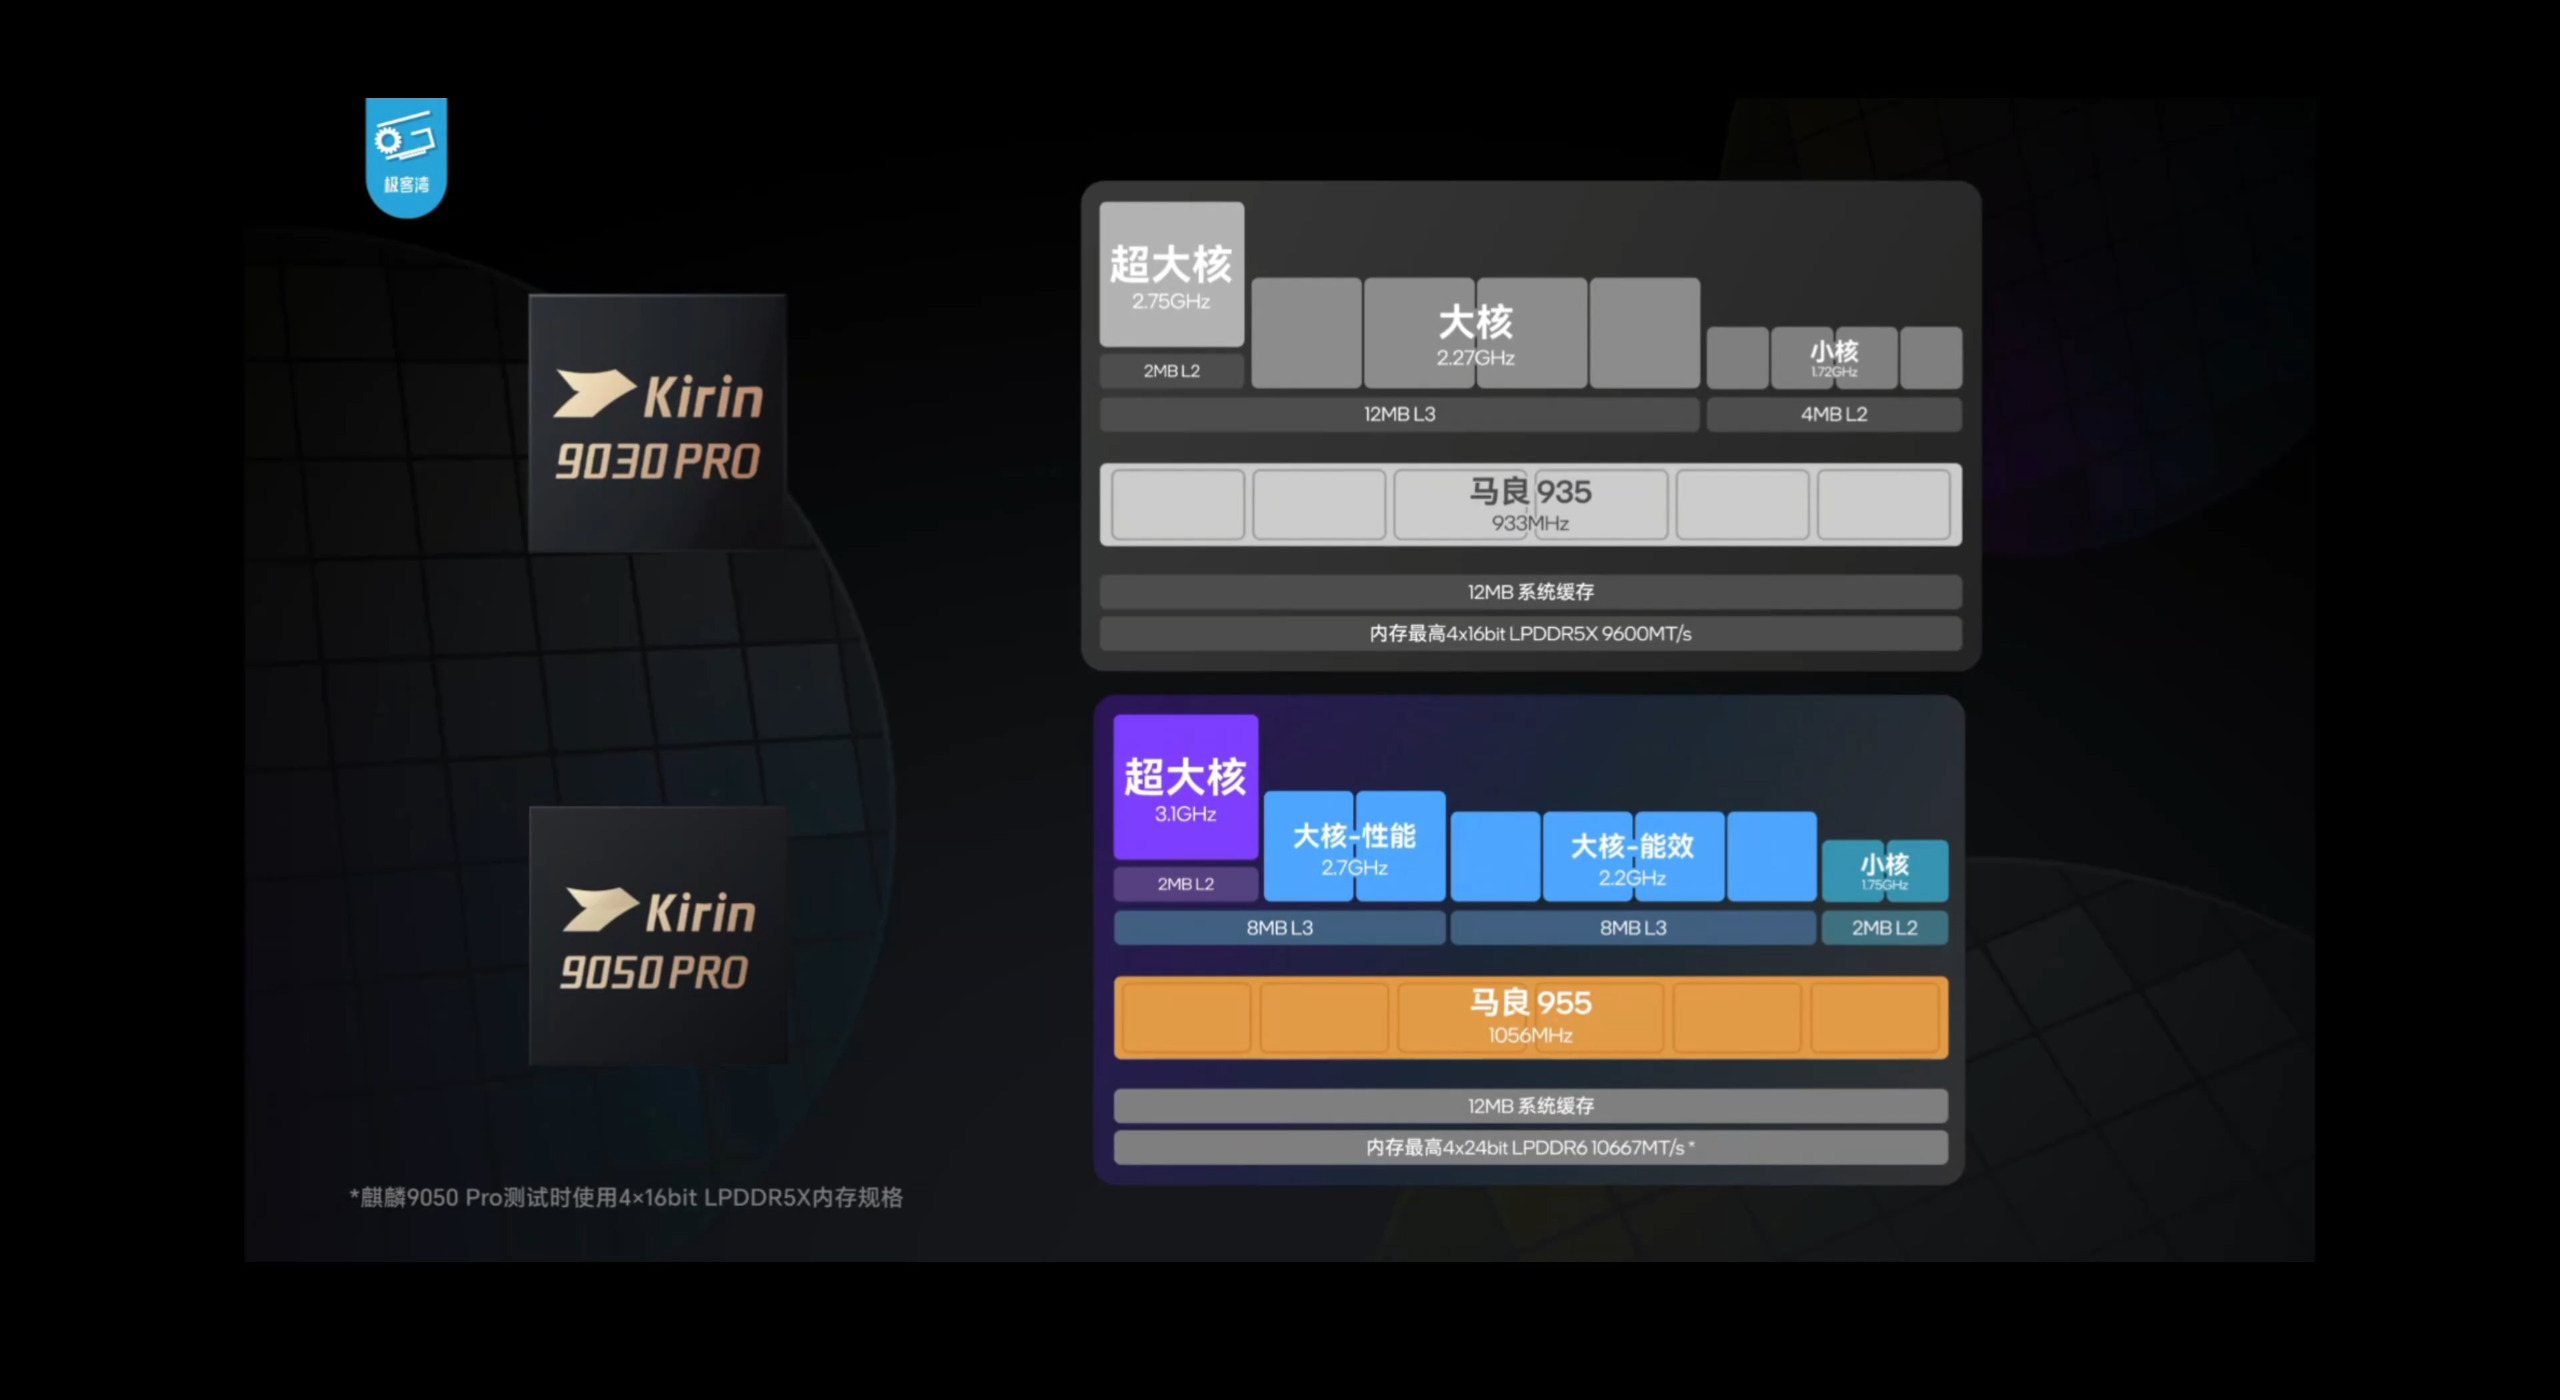
| 项目 | 麒麟 9030 PRO(Mate X7) | 麒麟 9050 PRO(Mate XT 2) |
|---|---|---|
| 超大核 | 2.75GHz / 2MB L2 | 3.1GHz / 2MB L2 |
| 大核-性能 | — | 2.7GHz / 8MB L3 |
| 大核-能效 | — | 2.2GHz / 8MB L3 |
| 大核 | 2.27GHz / 12MB L3 | — |
| 小核 | 1.72GHz / 4MB L2 | 1.72GHz / 2MB L2 |
| GPU | 马良 935 @933MHz | 马良 955 @1050MHz |
| 系统缓存 | 12MB | 12MB |
| 内存 | 最高 4×16bit LPDDR5X 9600MT/s | 最高 4×24bit LPDDR6 10667MT/s |
这里有一个容易被忽略、但很关键的细节:图上脚注写得很清楚——麒麟 9050 Pro 测试时使用的是 4×16bit LPDDR5X 内存规格。也就是说,它本身支持 4×24bit 的 LPDDR6 10667MT/s,但下面所有成绩都不是在内存拉满的状态下跑出来的。
二、能效从哪来:把"平面绕线"折起来
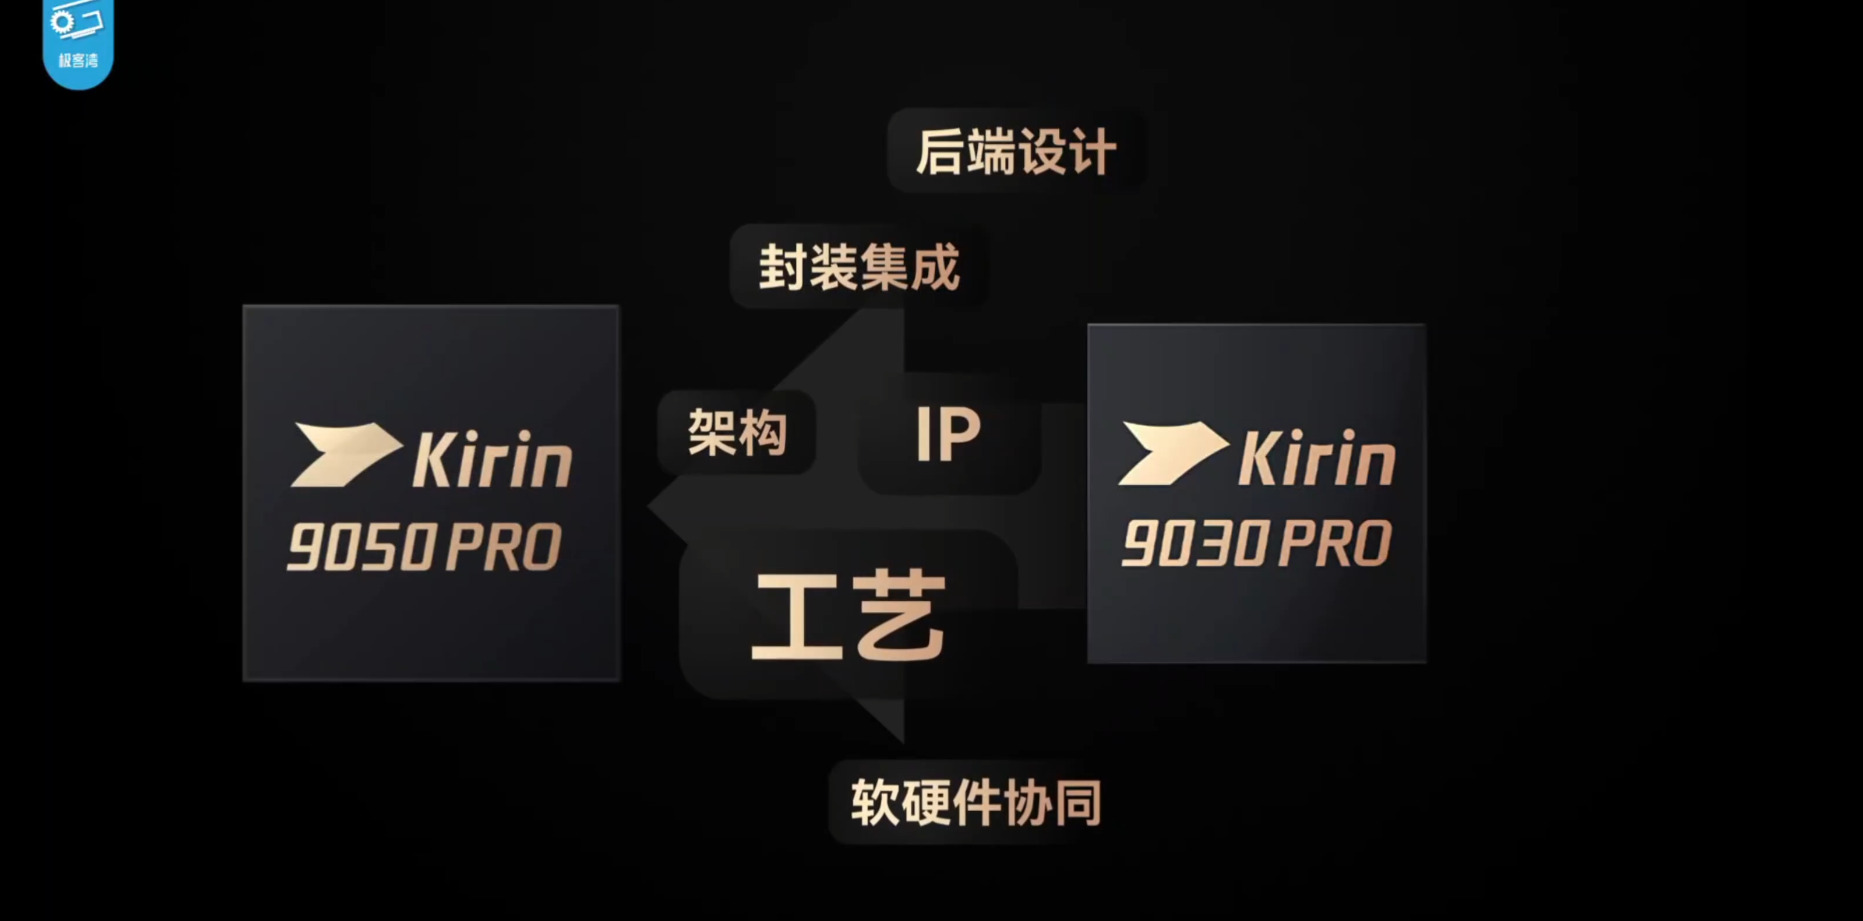
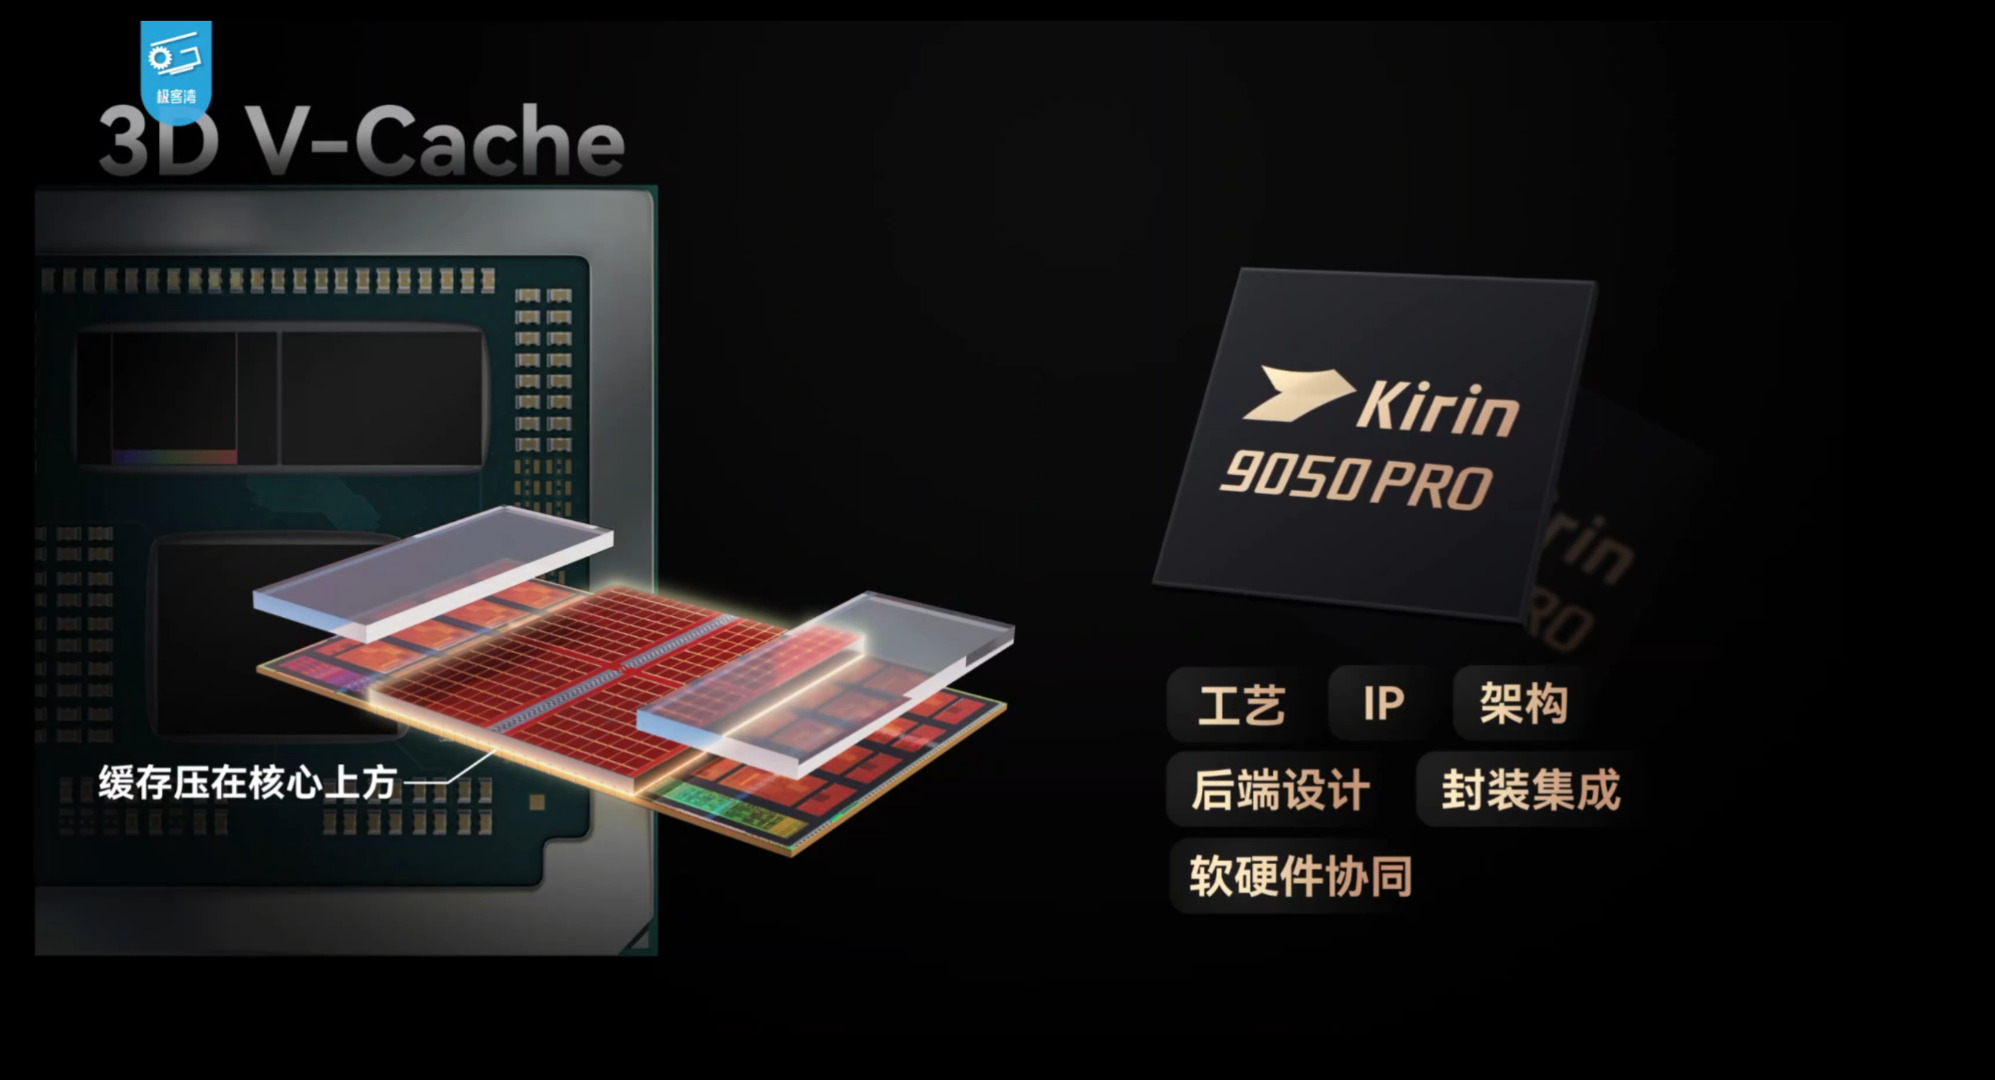
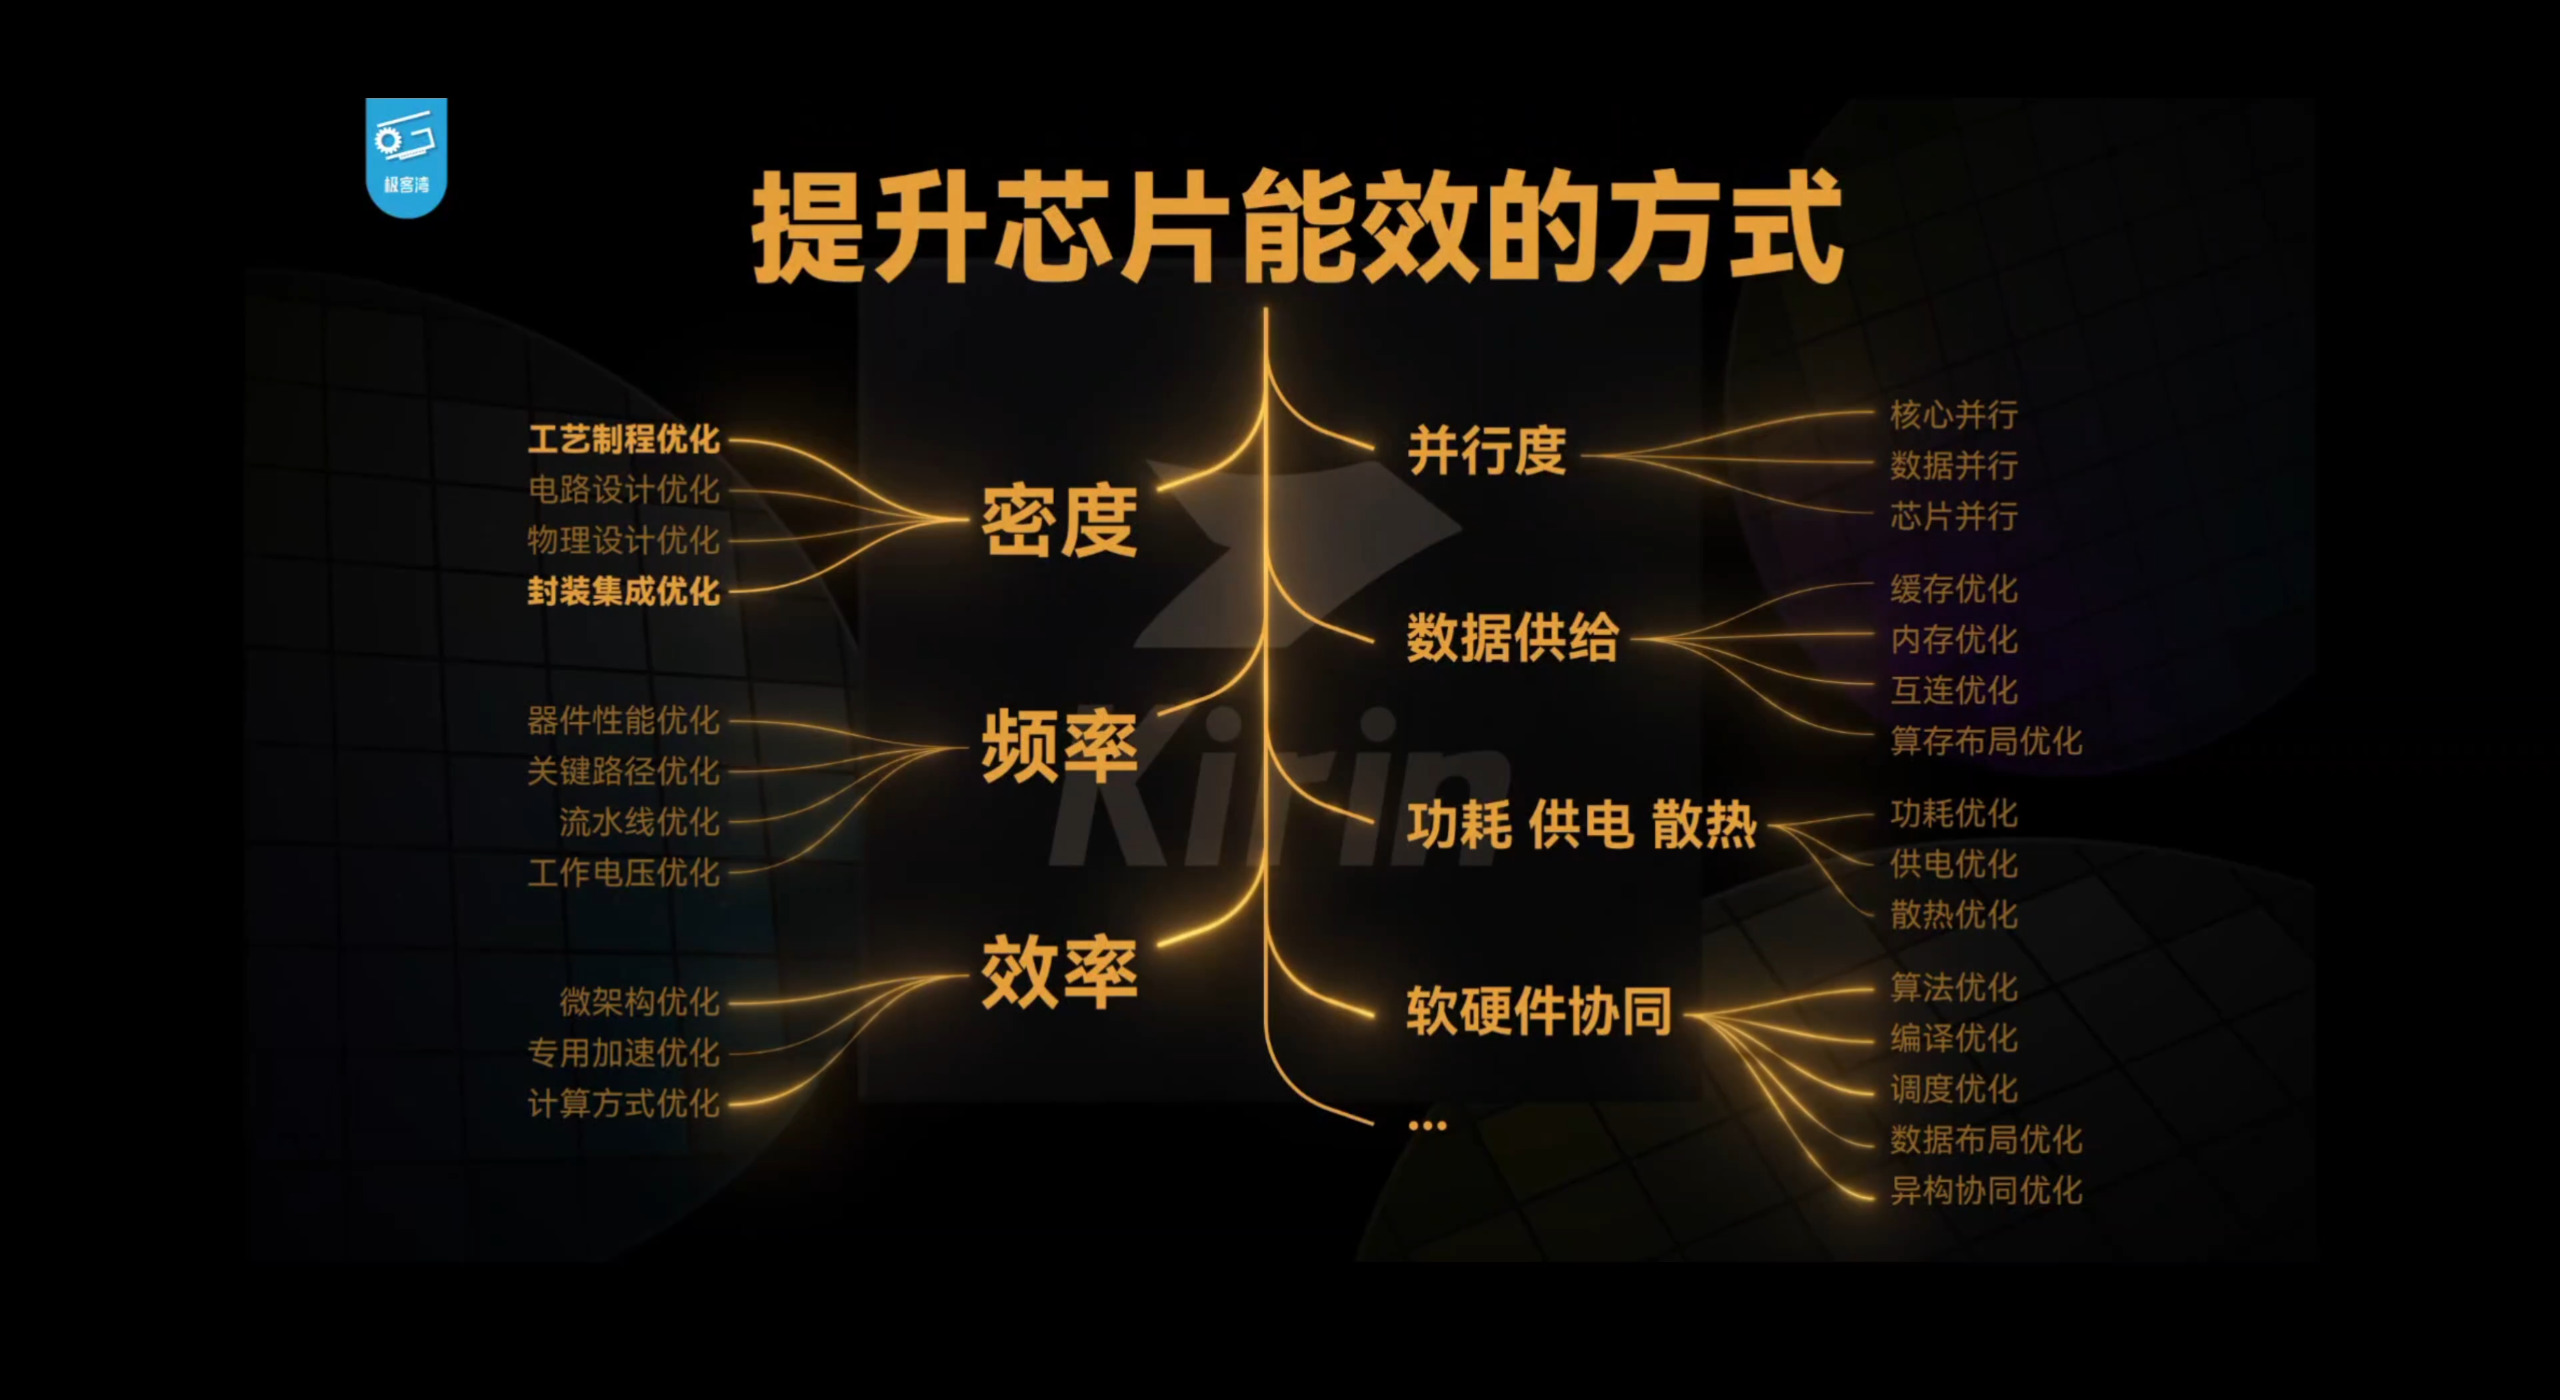
芯片的能效不是靠单一手段堆出来的。极客湾把路径拆成六个方向——工艺、IP、架构、后端设计、封装集成、软硬件协同,麒麟 9050 Pro 这一代的发力点,主要集中在"架构 + 后端设计 + 封装集成"这三块。
要理解逻辑折叠,先要理解 CPU 的一个时钟周期里发生了什么。图上标了一个具体数字:3.0333 ps——这是一个时钟周期的时间。在这点时间里,数据要依次经过 t取 → t传 → t算 → t传 → t存,其中"传"占了两段。
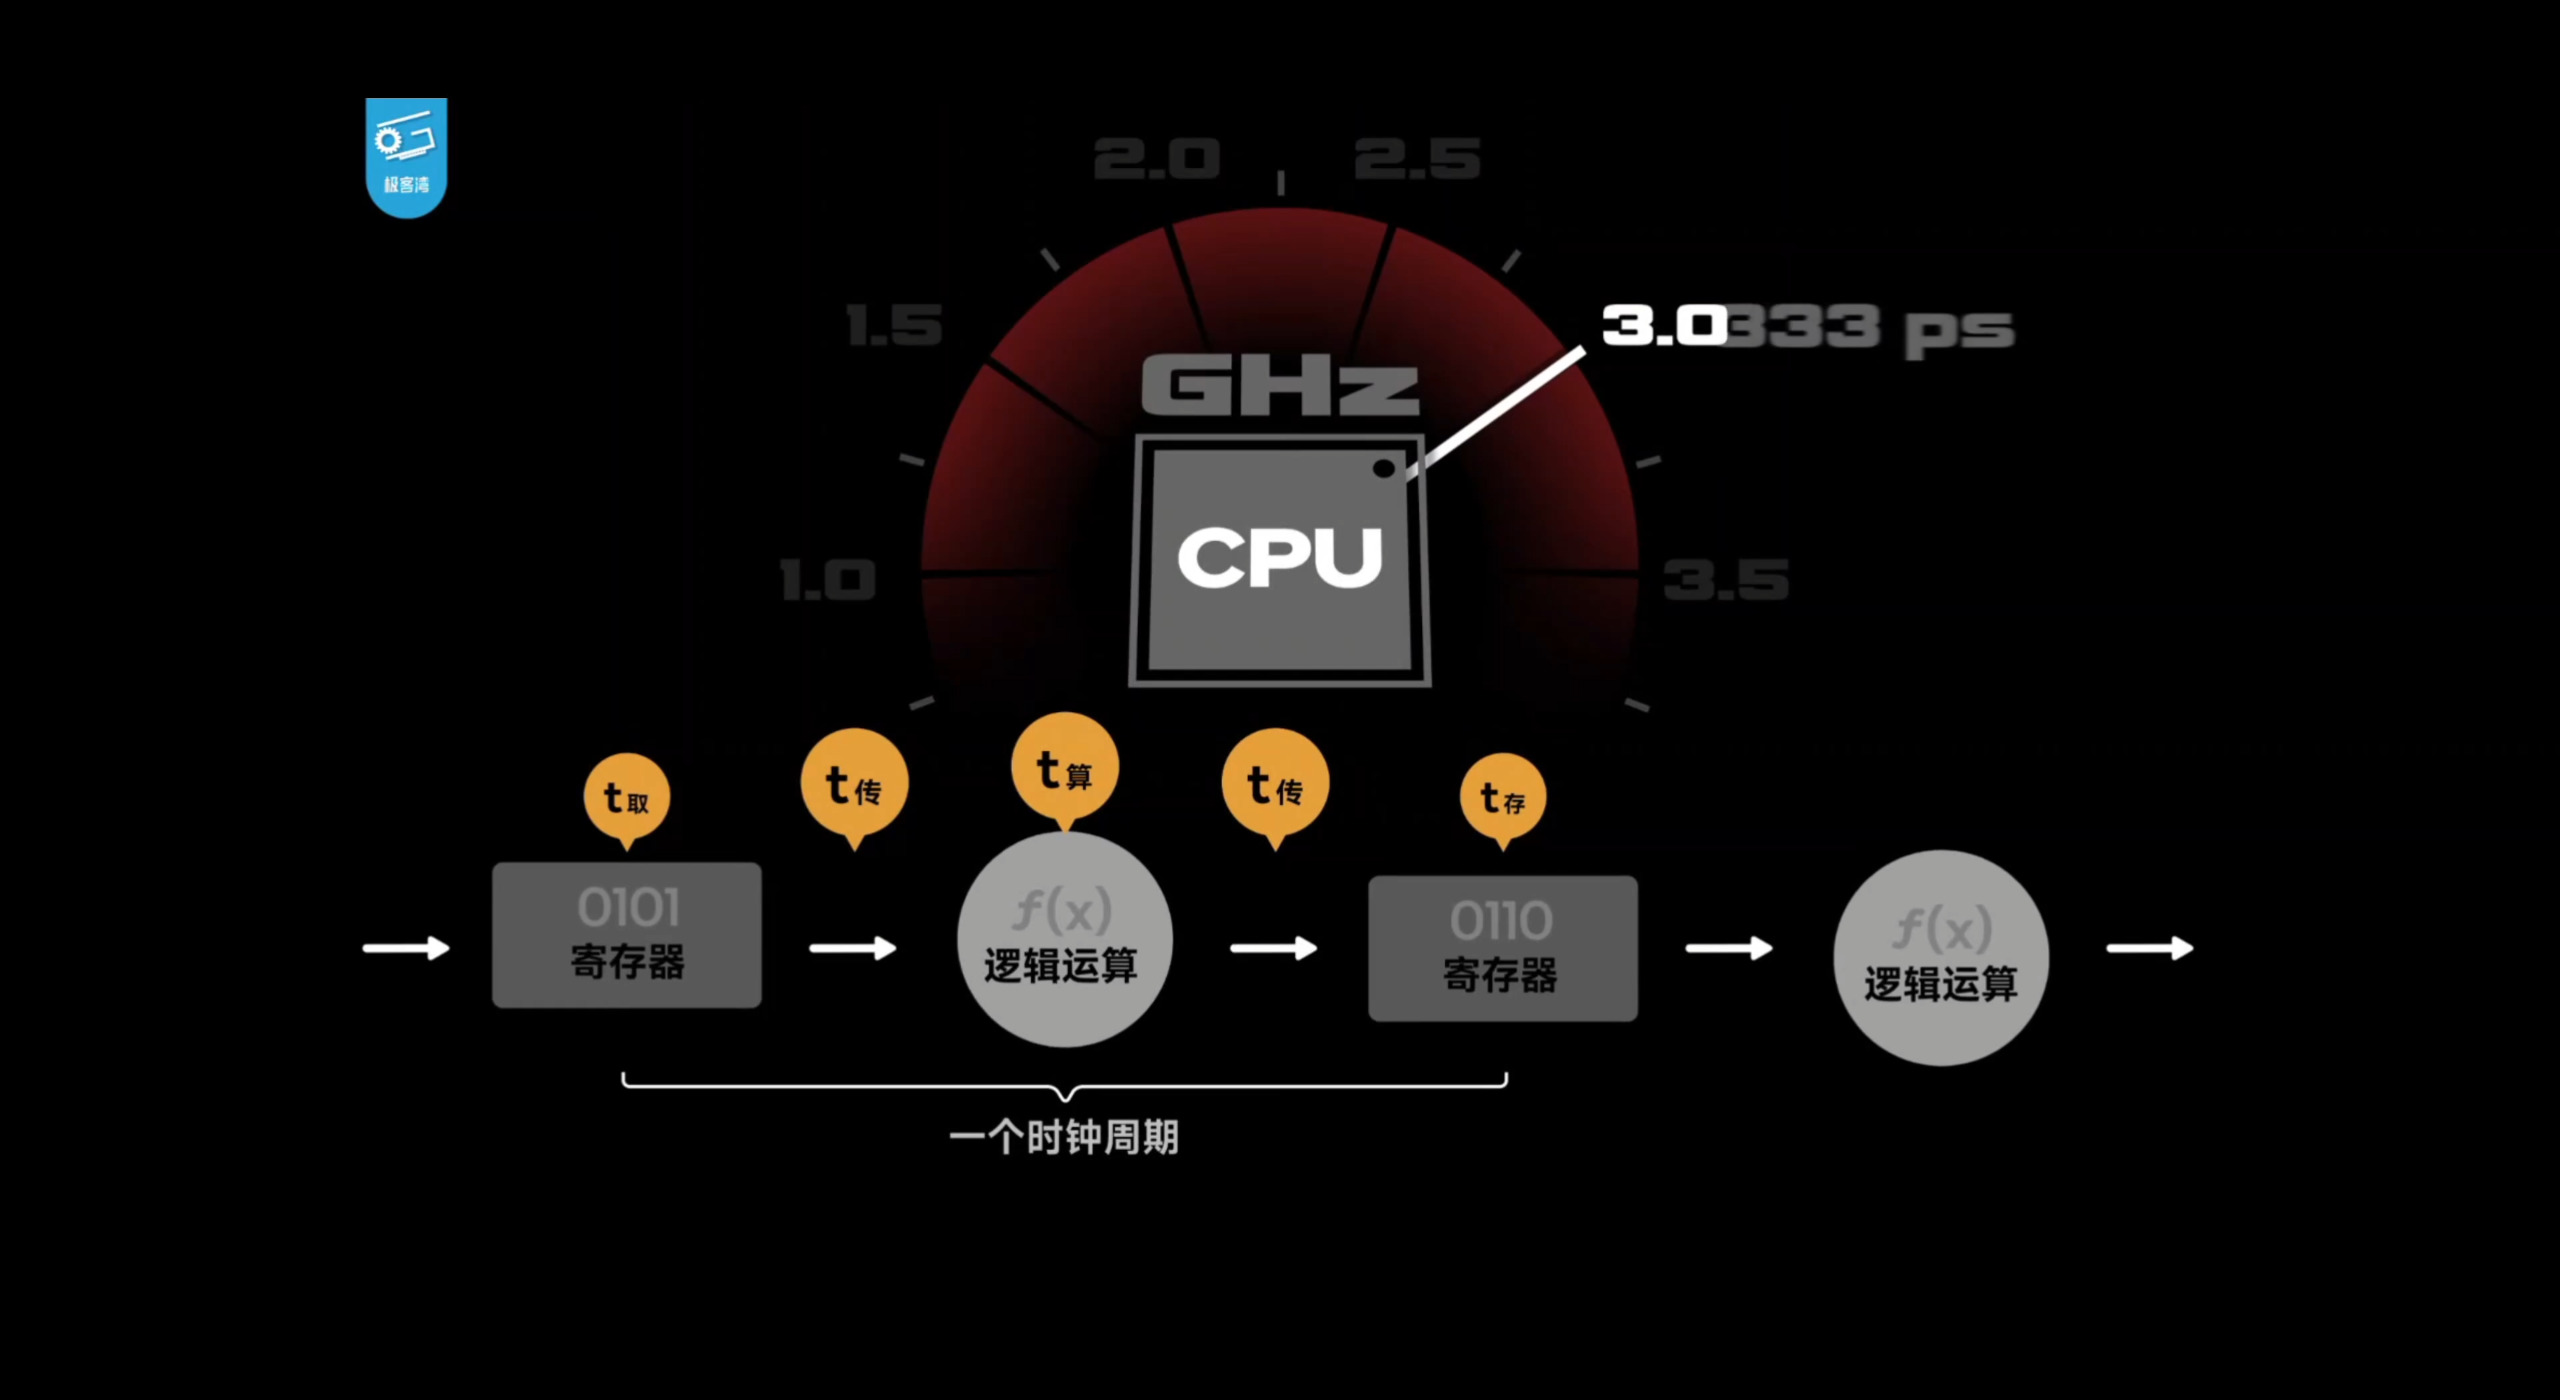
问题就出在这两段"传"上。传统平面布局里,寄存器组 A 和寄存器组 B 之间的组合逻辑要在二维平面上绕线连接,走线越长,寄生电阻和电容越大,信号变化被拖慢,延迟和功耗都跟着涨。
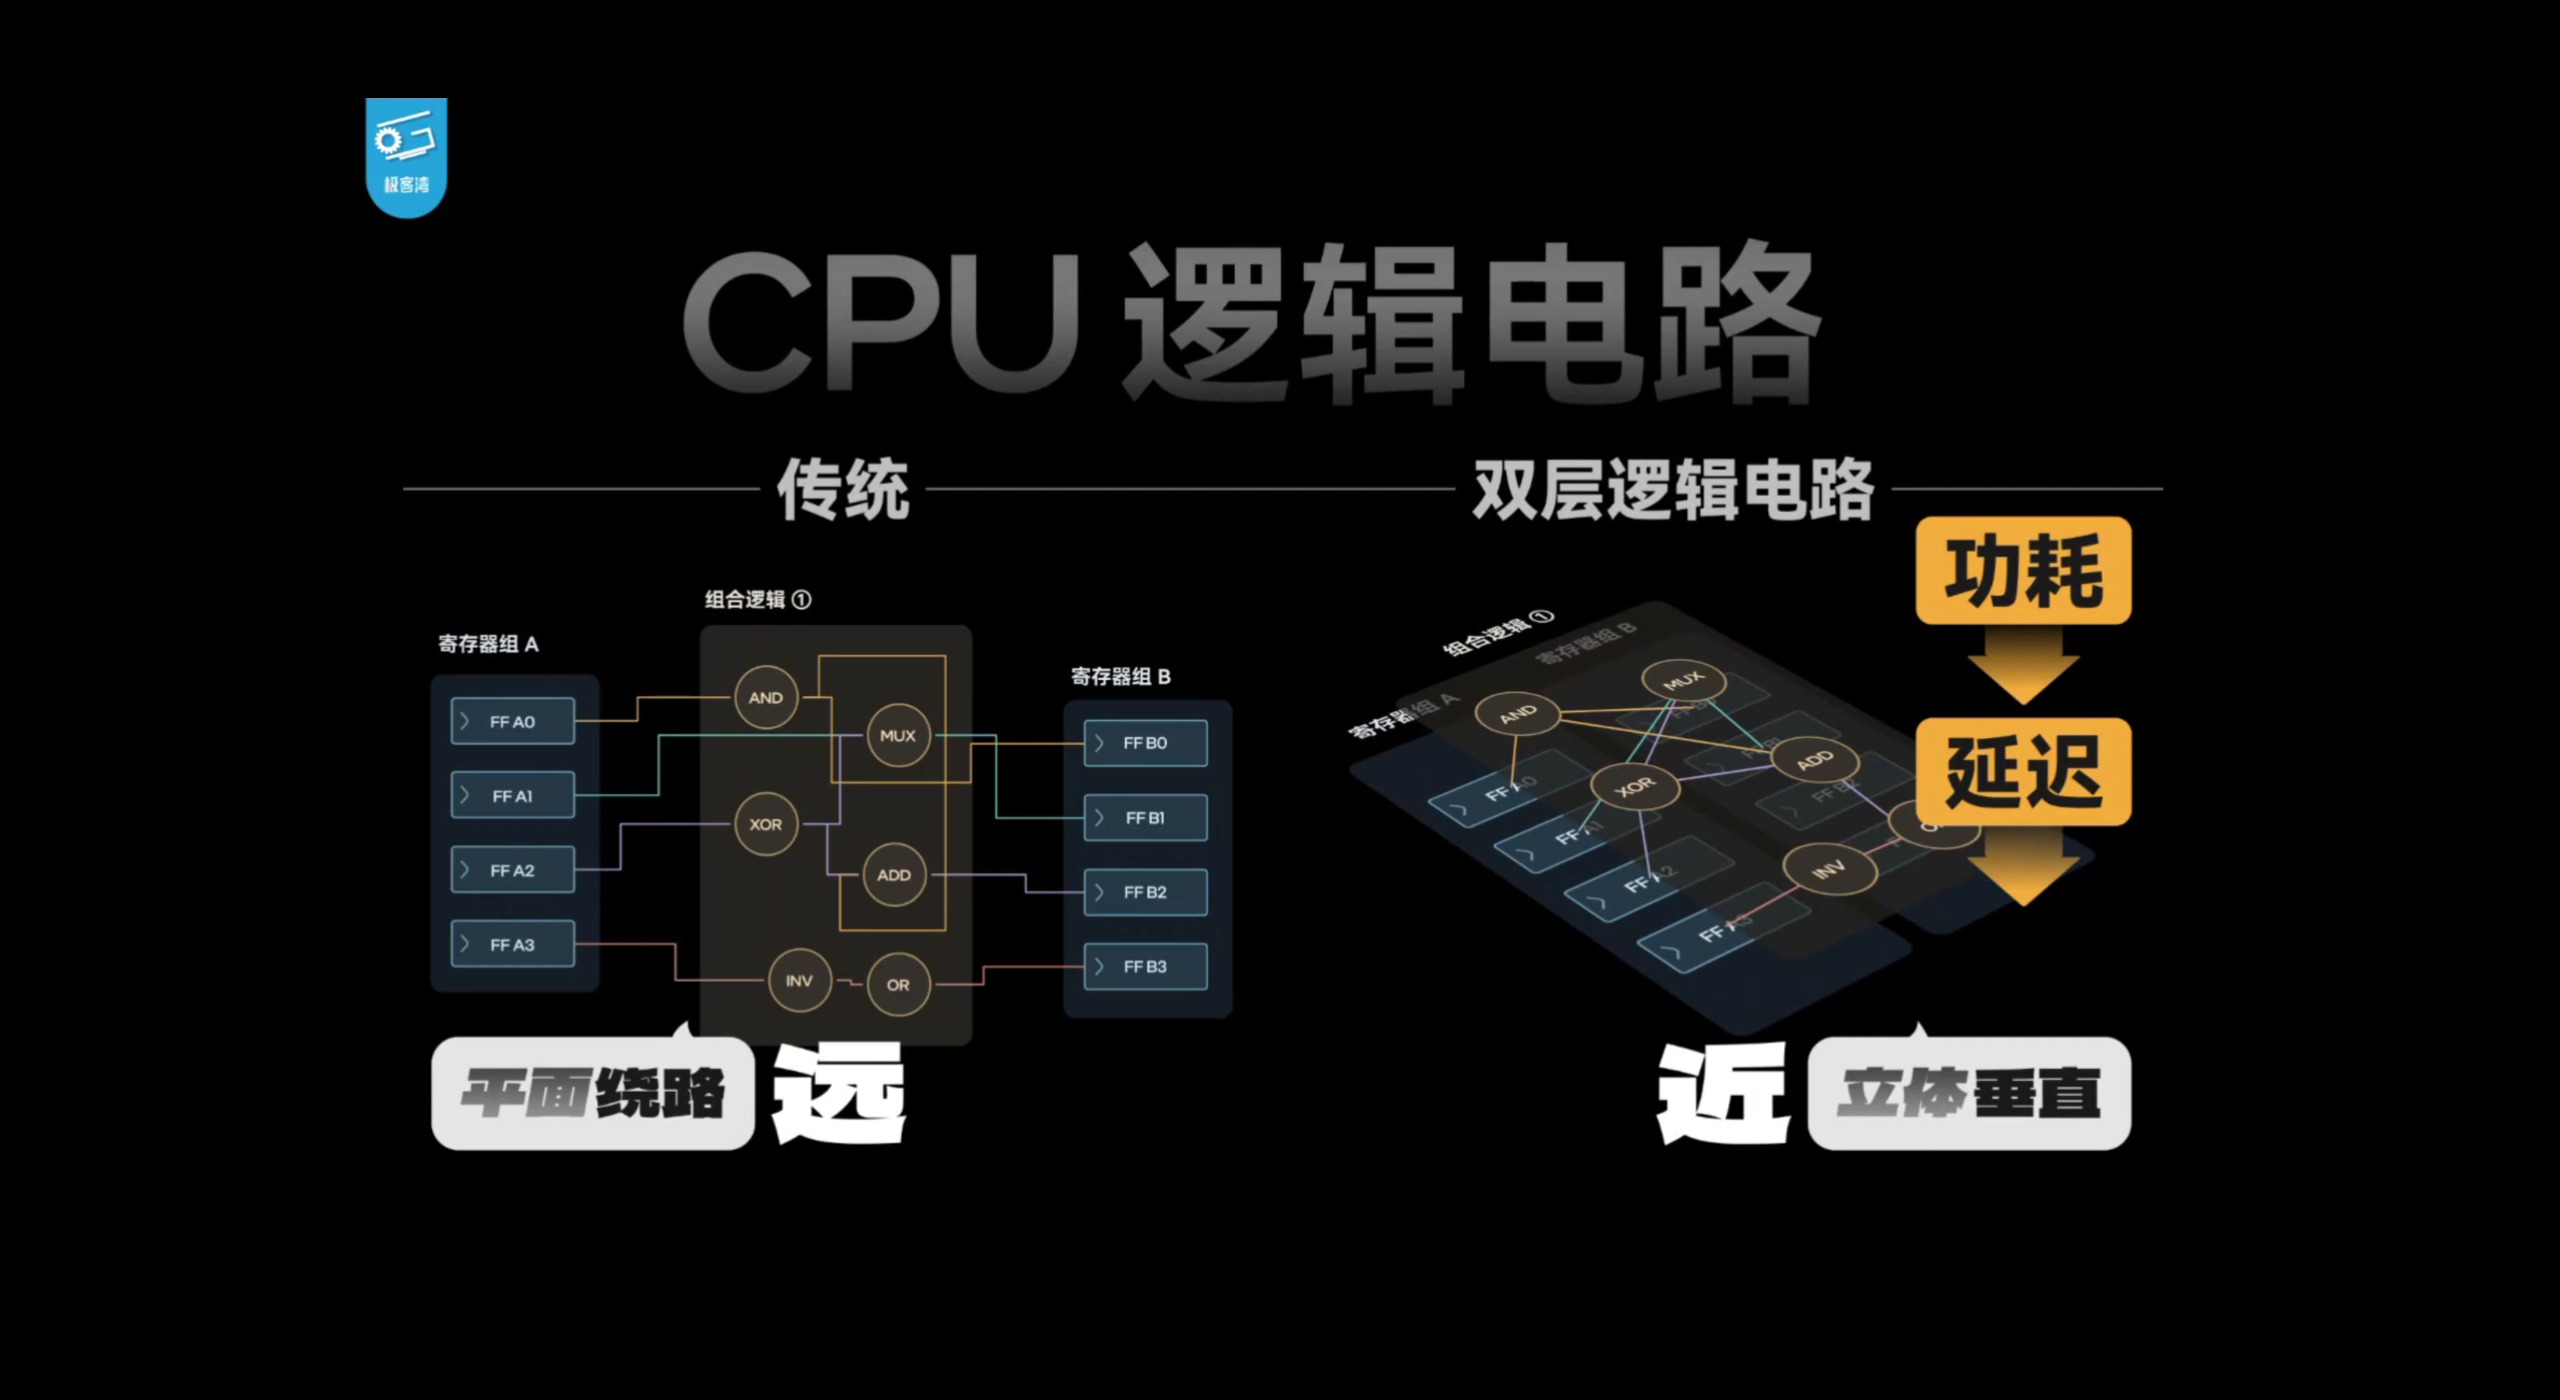
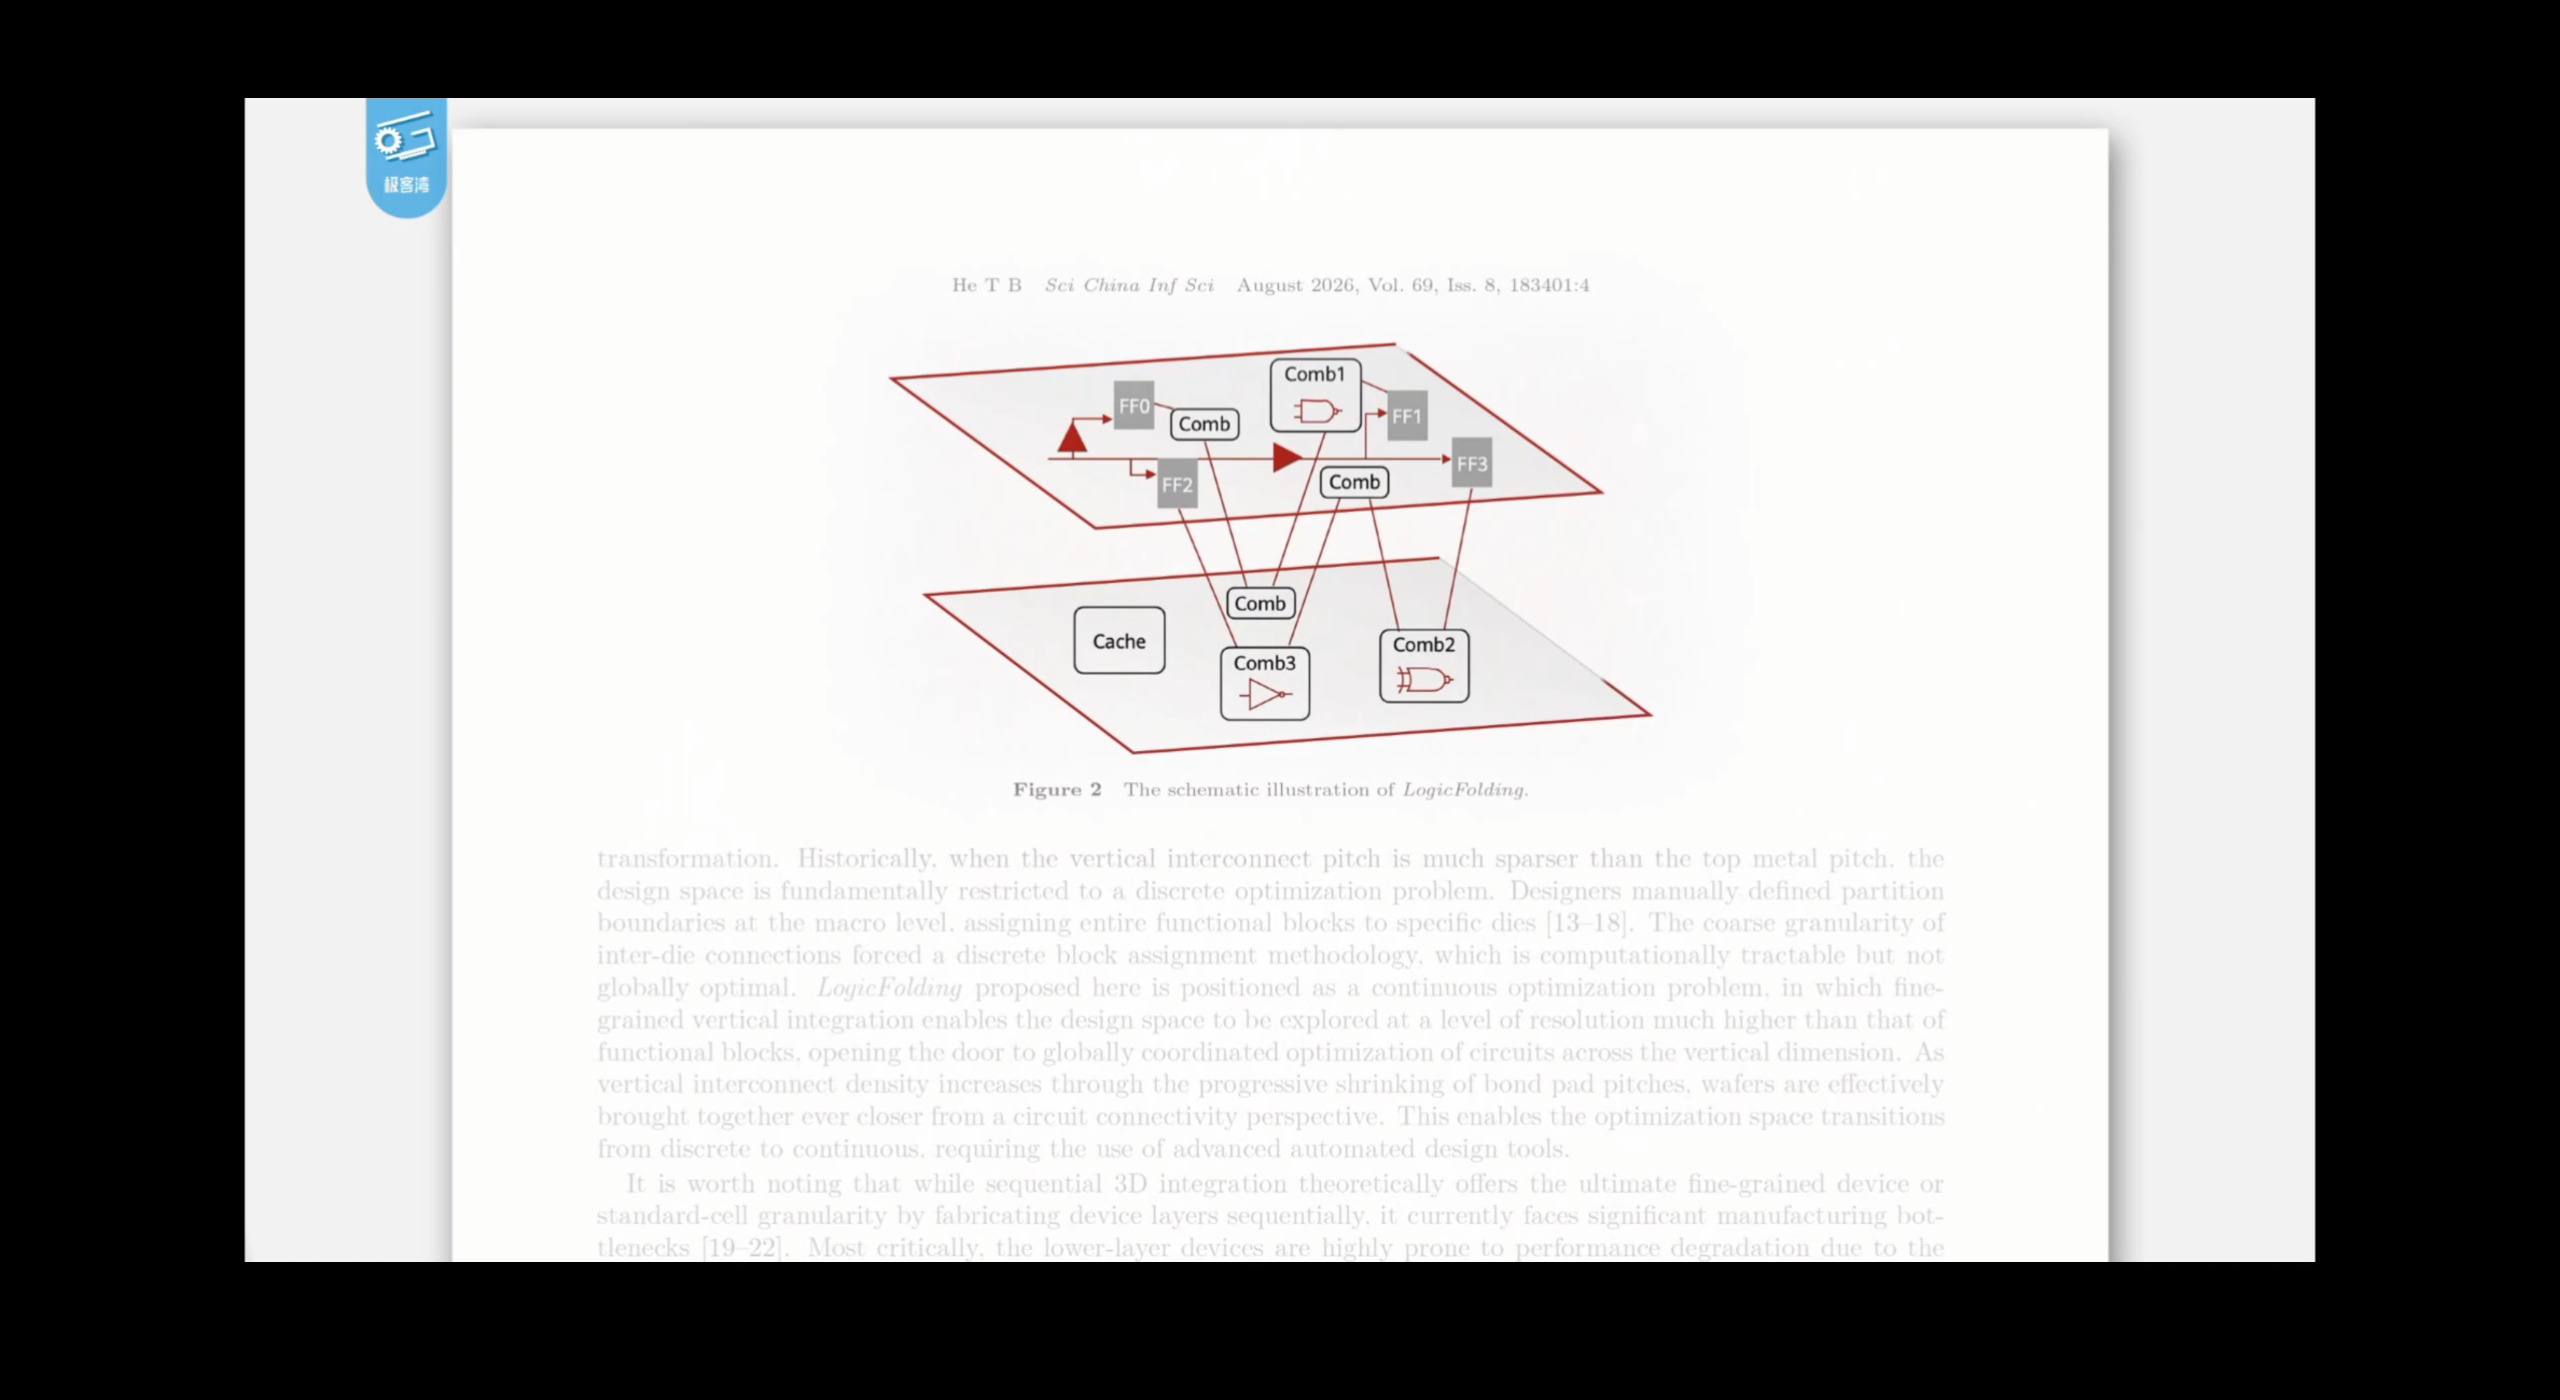
逻辑折叠的做法,是把同一级流水线里的逻辑单元拆成上下两层,做垂直互联。路径从"平面上绕远路"变成"立体上走直线",线短了,RC 延迟小了,功耗和延迟同时下降。这就是这一代能把超大核频率重新推回 3.1GHz 的底层原因。
三、论文里的数字:电压 1.1V → 0.9V,同性能功耗降到 0.59
极客湾在讲解里直接引用了论文原文。出处是《中国科学:信息科学》(Sci China Inf Sci)2026 年 8 月第 69 卷第 8 期(He T B, 183401),核心概念正是 Logic-Folding。
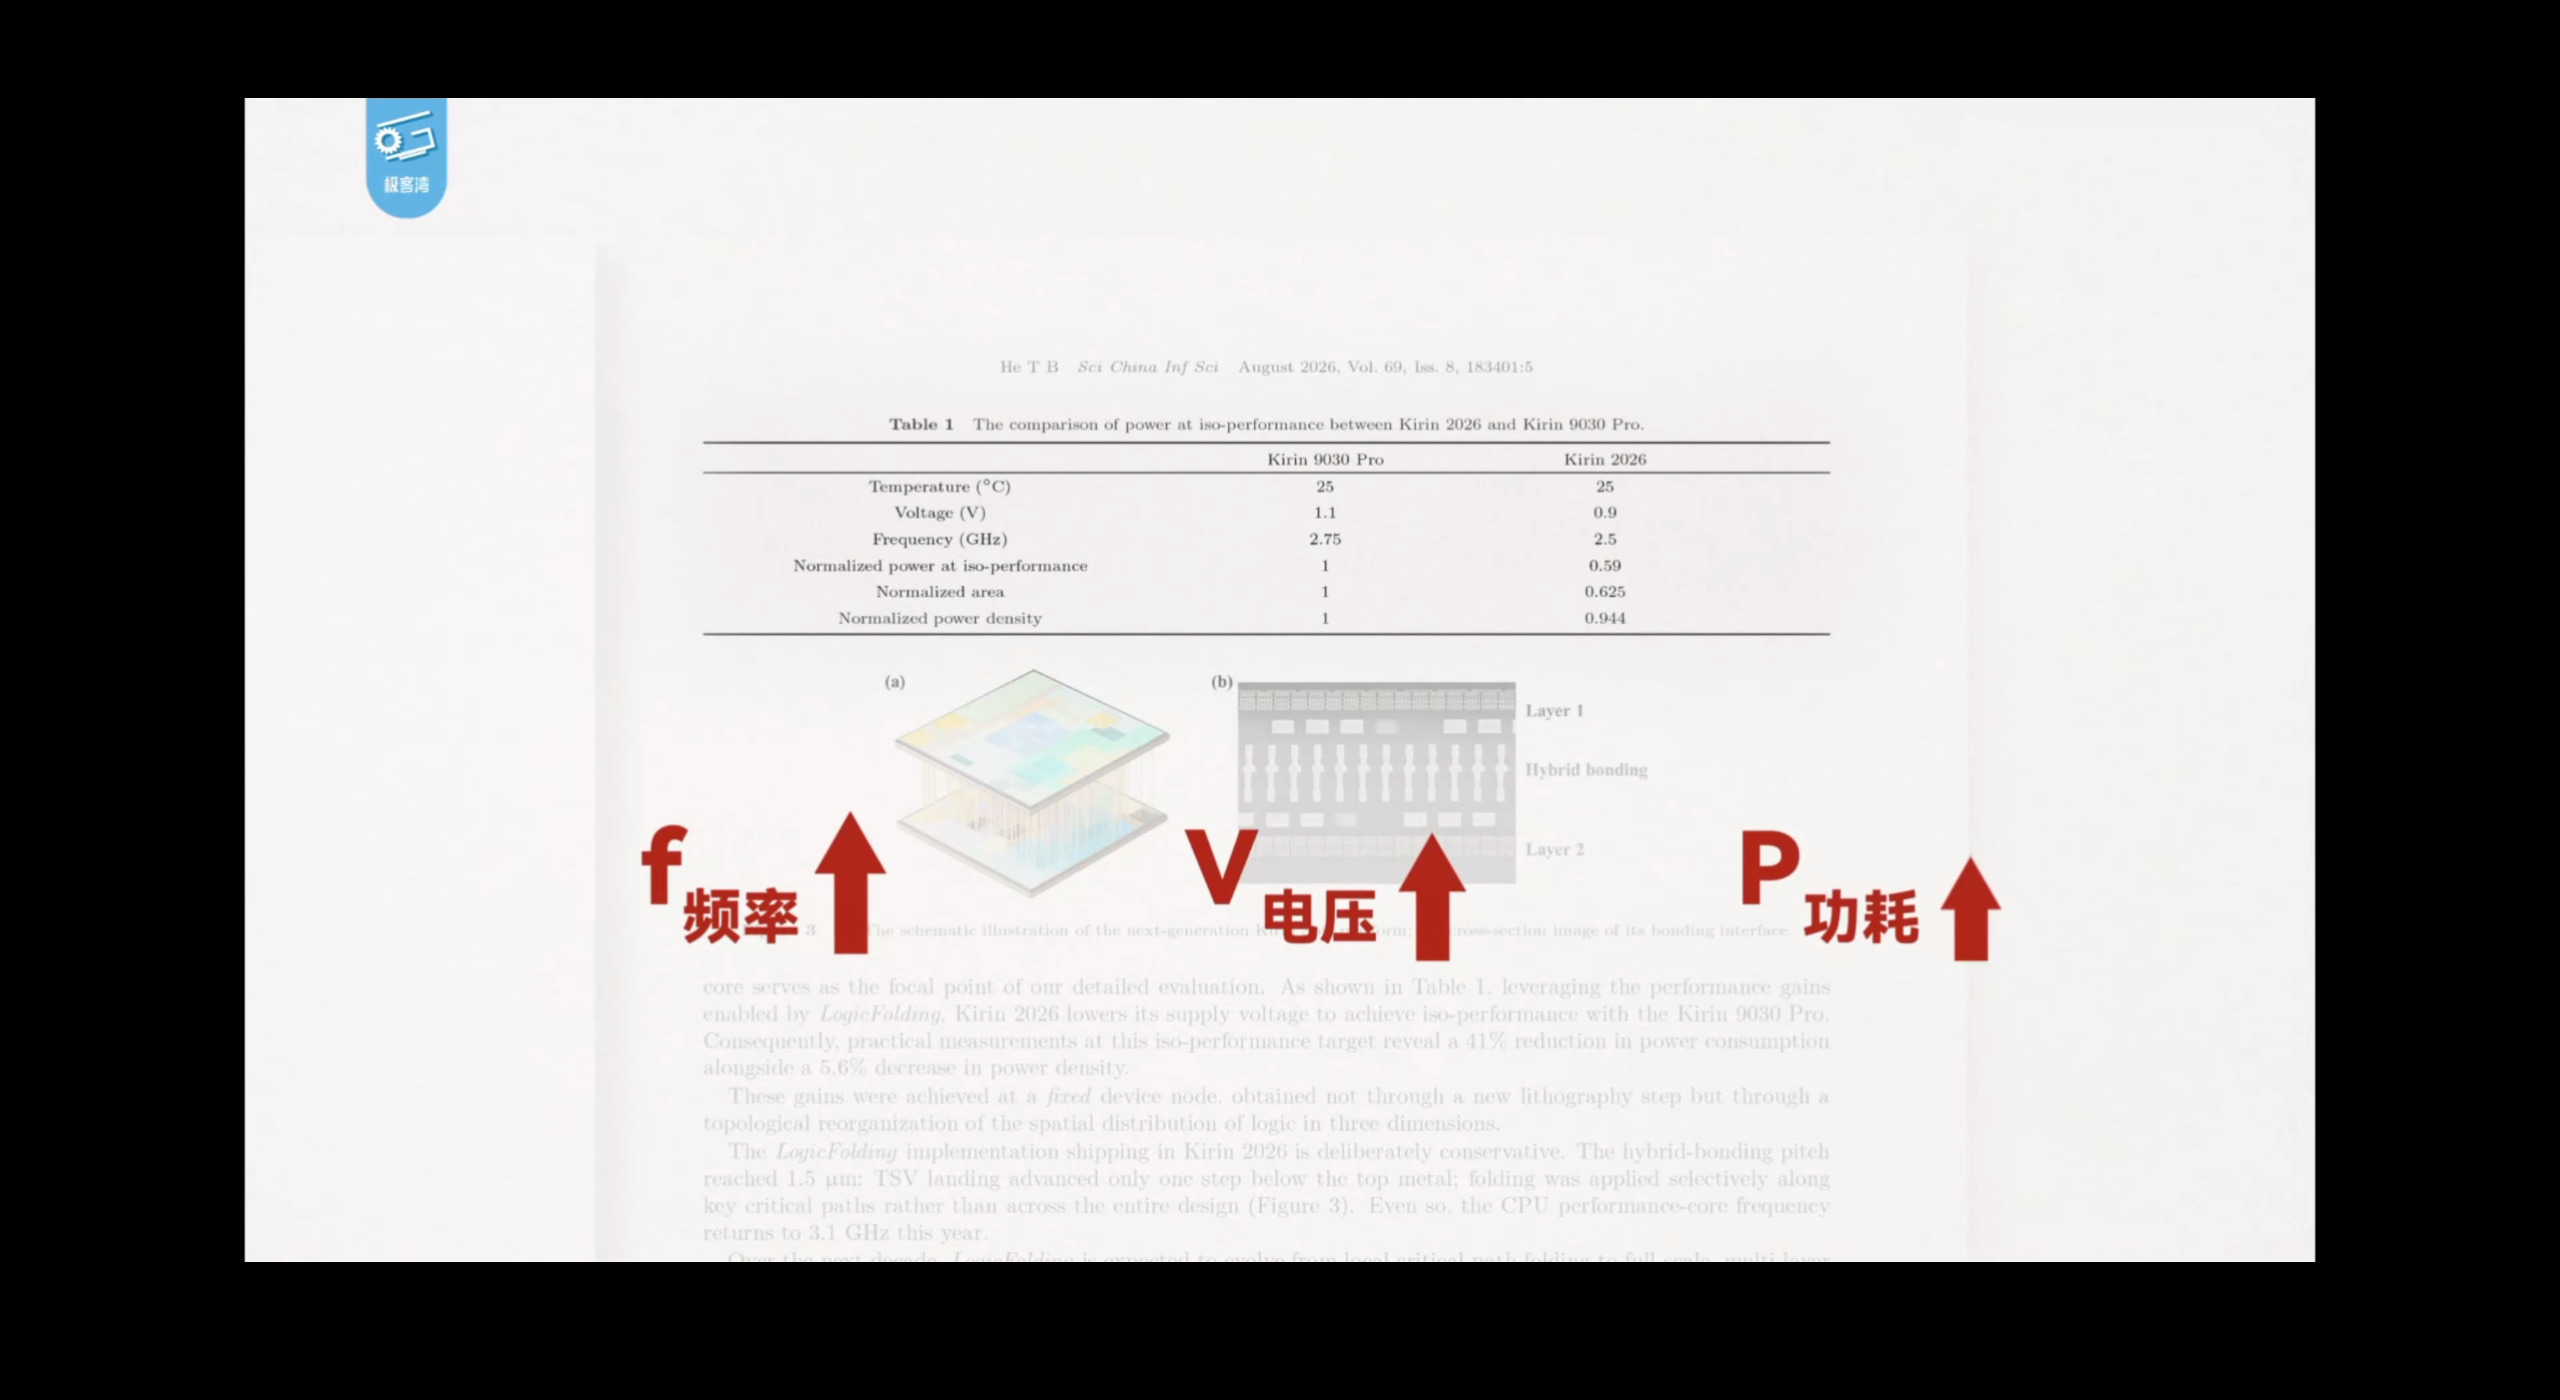
| 参数 | Kirin 9030 Pro | Kirin 2026 |
|---|---|---|
| 温度(℃) | 25 | 25 |
| 电压(V) | 1.1 | 0.9 |
| 频率(GHz) | 2.75 | 2.5 |
| 归一化功耗(同性能) | 1 | 0.59 |
| 归一化面积 | 1 | 0.625 |
| 归一化功耗密度 | 1 | 0.944 |
论文给出的结论很直接:靠逻辑折叠,Kirin 2026 用更低的供电电压就能达到与 Kirin 9030 Pro 相同的性能,功耗降低 41%;代价是功耗密度上升 5.6%。同时这一代 CPU 性能核的频率回到 3.1GHz。
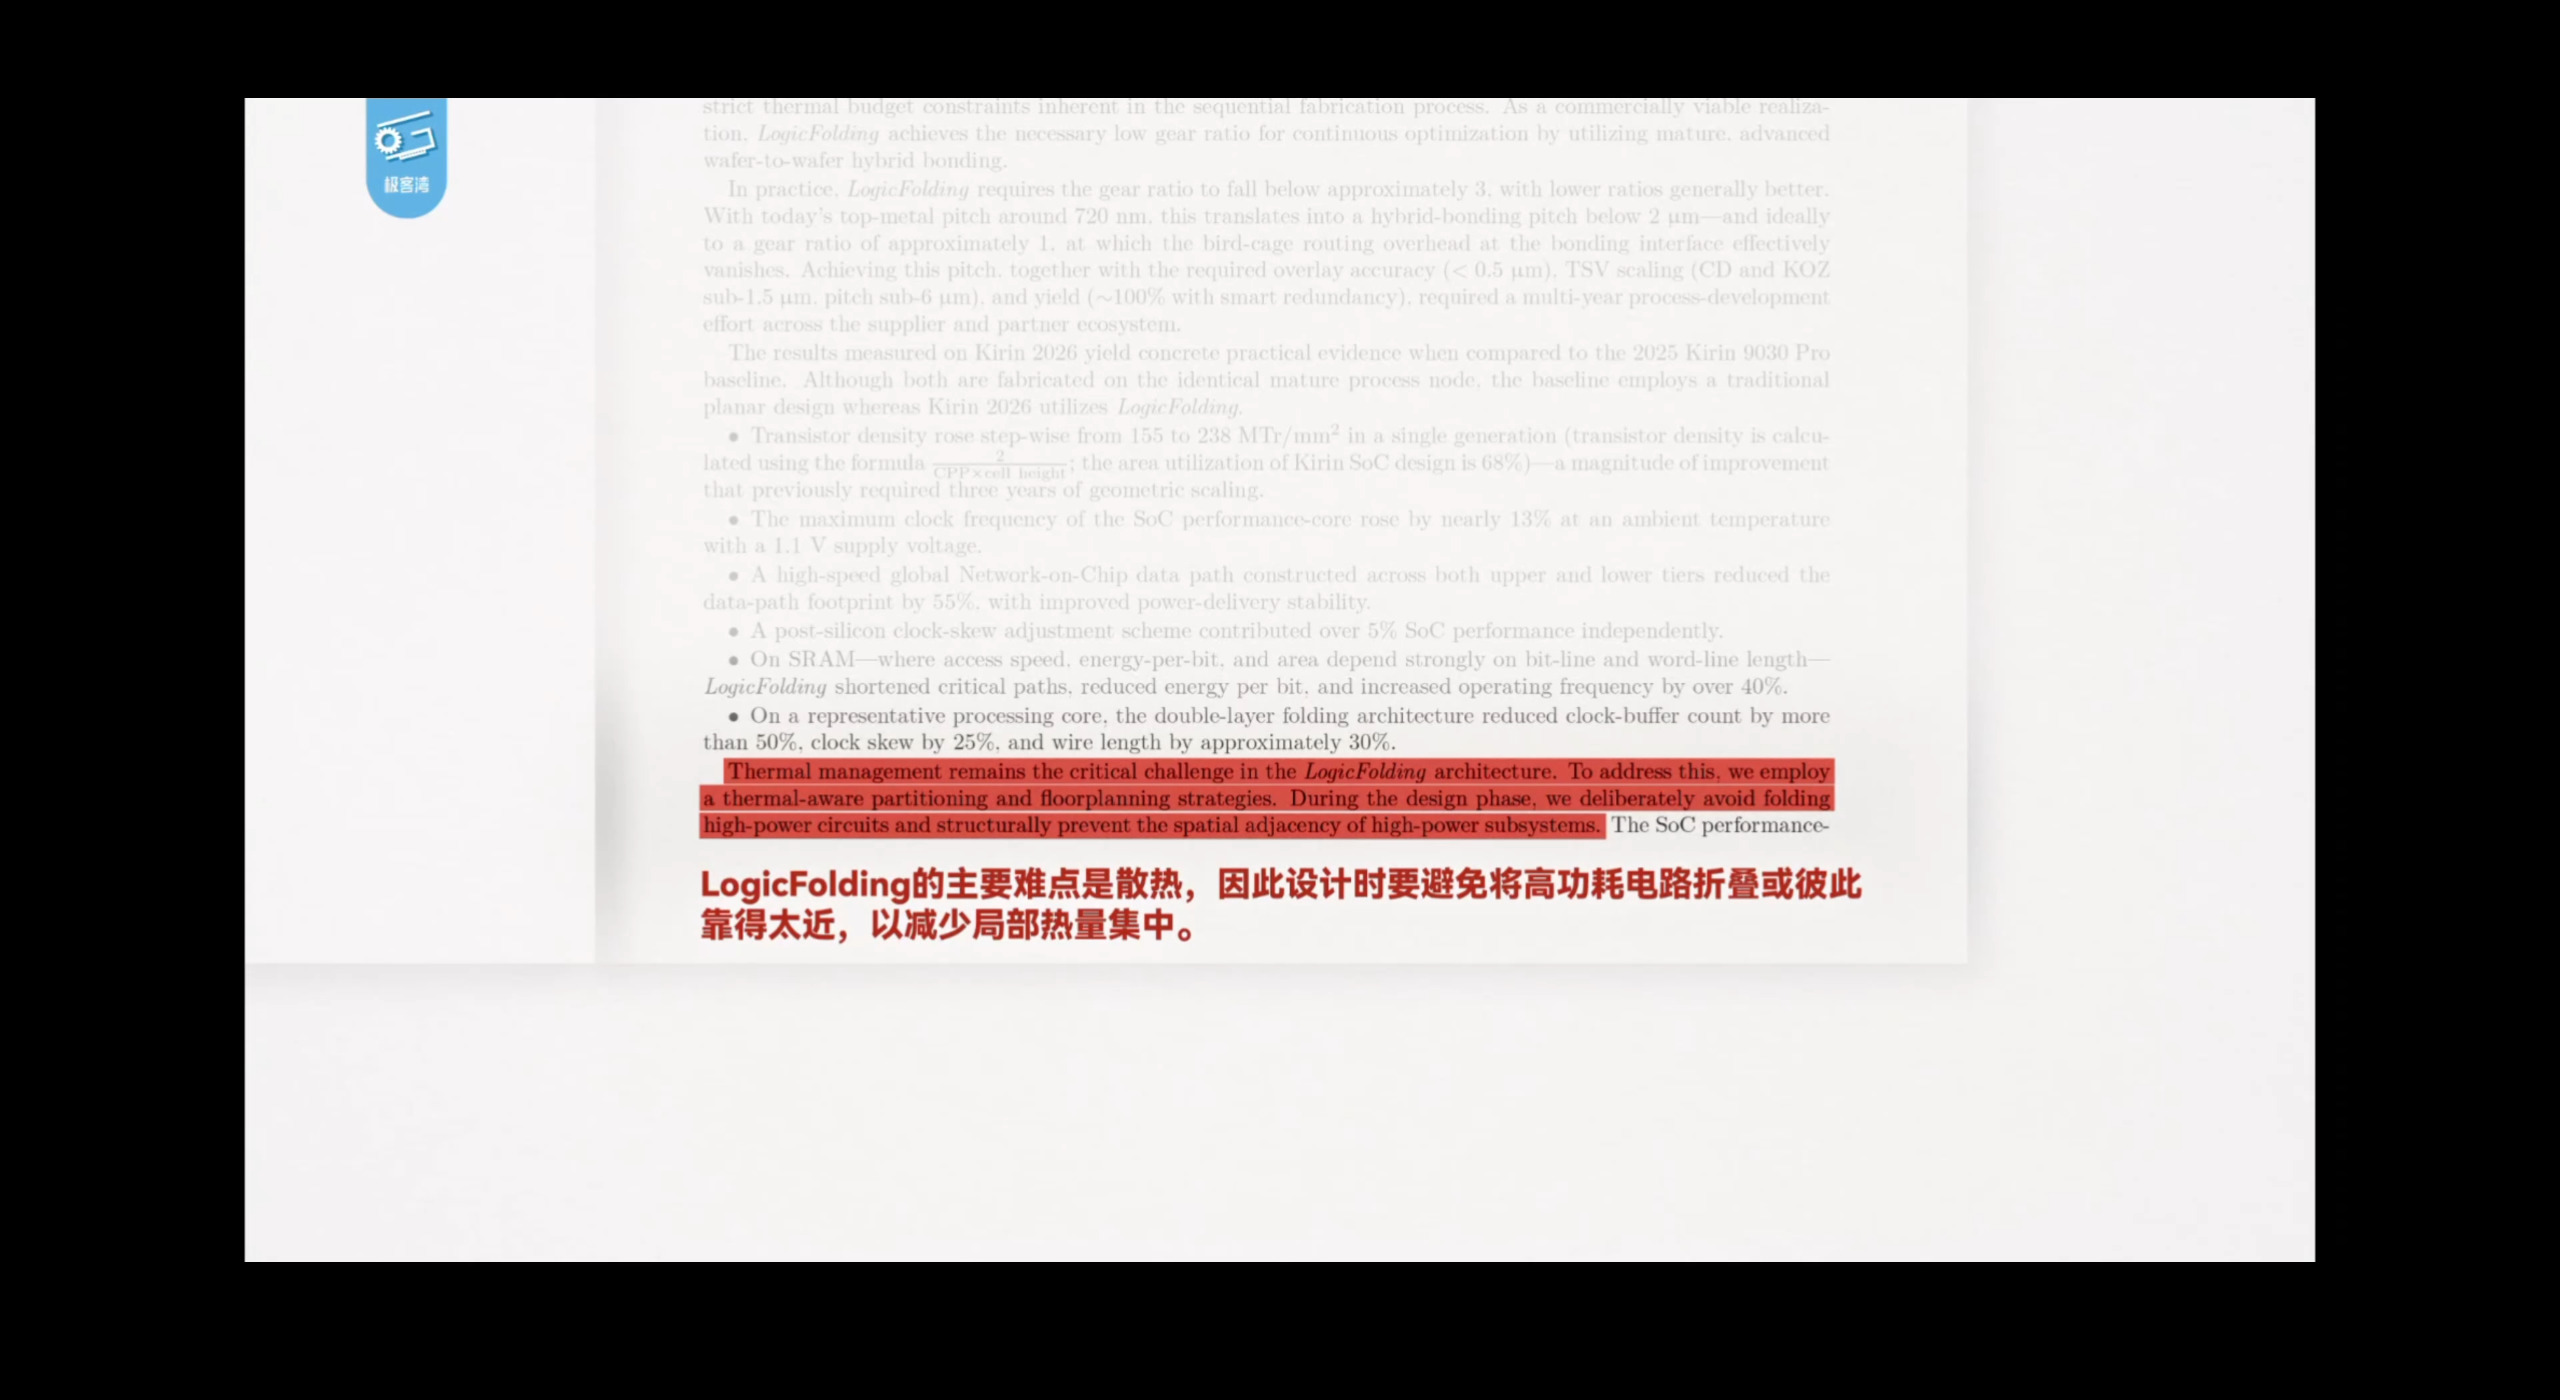
论文里还列了一串具体收益,都是可以用数字衡量的:
- 晶体管密度:135 MT/mm² → 236 MT/mm²,面积利用率 68%,相当于一次性吃掉过去约三年的几何微缩红利
- 5G 性能核在 1.2V 下,同性能频率提升近 15%
- 高速全局 NoC 数据通路减少 55%
- 硅后时钟偏斜调整,带来约 6% 的 SoC 性能提升
- SRAM 关键路径缩短,每比特能耗降低,工作频率提升超 40%
- 双层折叠架构让代表性核心的时钟缓冲器数量减少超 50%、时钟偏斜减少 25%、线长减少约 30%
但论文也把话说明白了:逻辑折叠最大的敌人是散热。所以设计时必须刻意避开"把高功耗电路折叠在一起或靠得太近",减少局部热量集中。这也解释了为什么这项技术目前只用在关键路径上,而不是全芯片铺开。
四、和 AMD 3D V-Cache、intel Foveros 有什么不一样
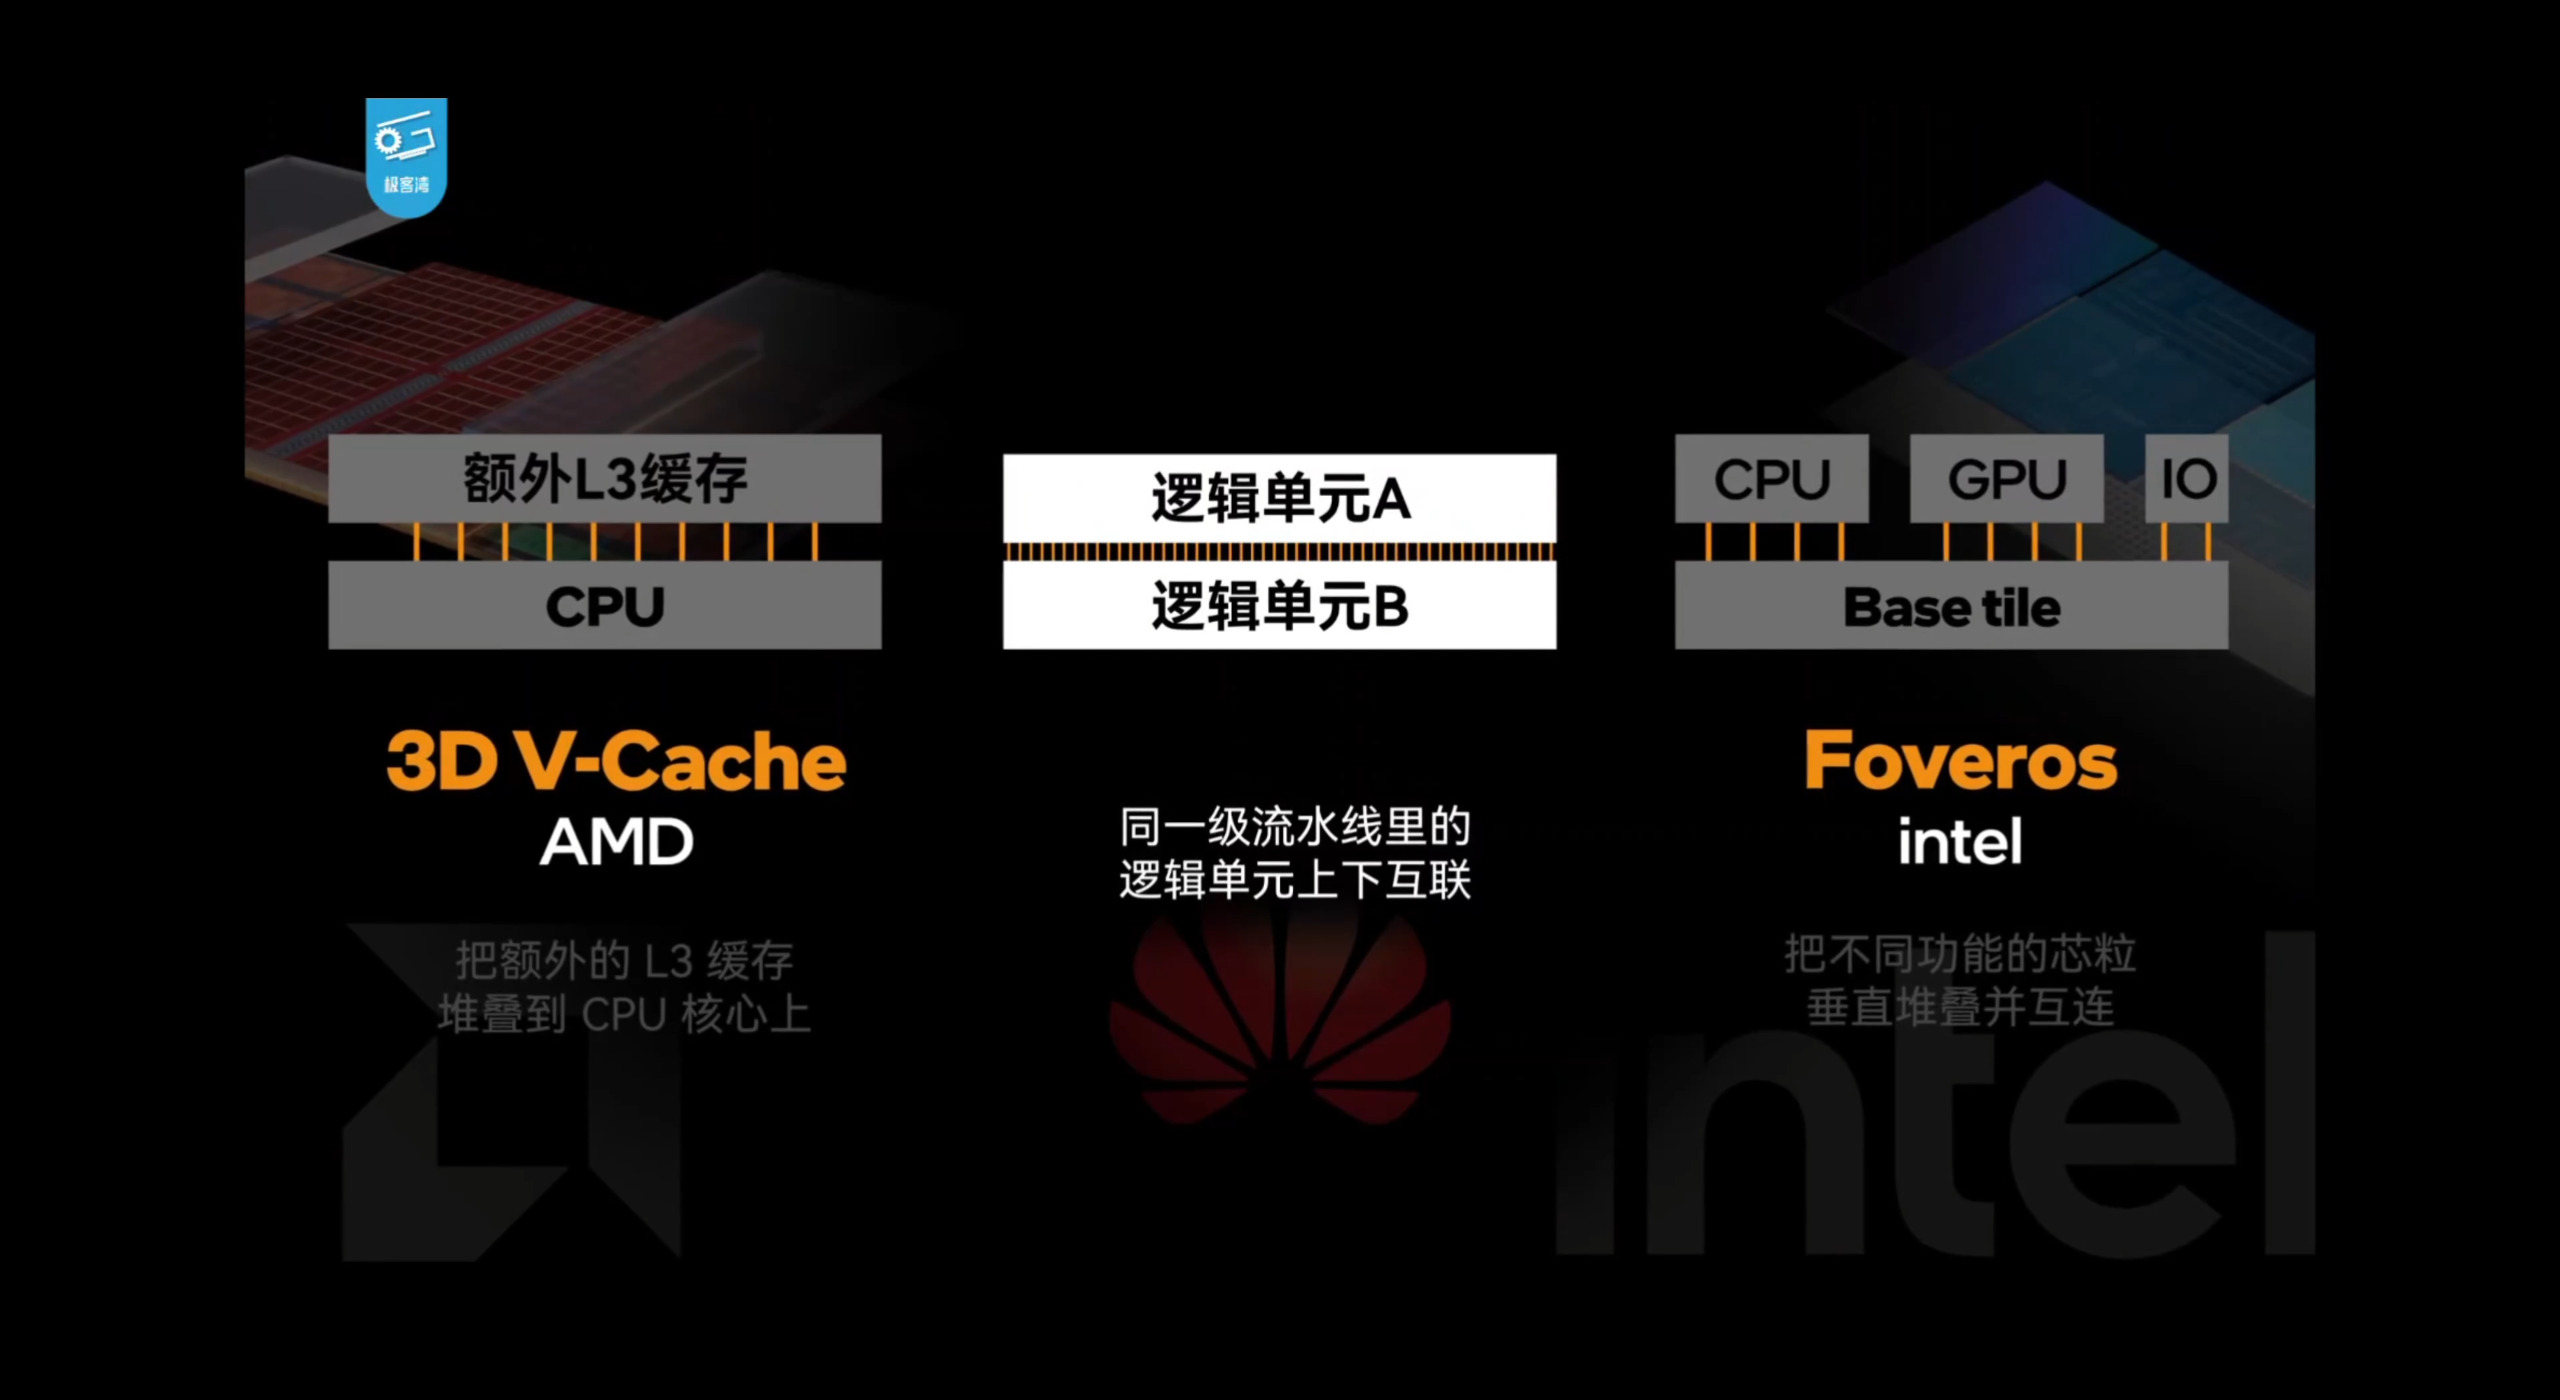
| 方案 | 厂商 | 做法 |
|---|---|---|
| 3D V-Cache | AMD | 把额外的 L3 缓存堆叠到 CPU 核心上 |
| Foveros | intel | 把不同功能的芯粒(CPU / GPU / IO)垂直堆叠并互连 |
| 逻辑折叠 | 华为 | 把同一级流水线里的逻辑单元上下互联 |
这里有个关键区别:AMD 和 intel 做的是"叠不同的东西"——一个叠缓存,一个叠芯粒;而华为这次是在同一个核心内部,把同一级流水线的逻辑单元拆成两层再互联。粒度更细,好处是不依赖新制程、靠拓扑重构就能拿到能效;难处是它对后端设计和散热的要求都更高。
五、CPU 内核微架构:超大核的队列和解码宽度
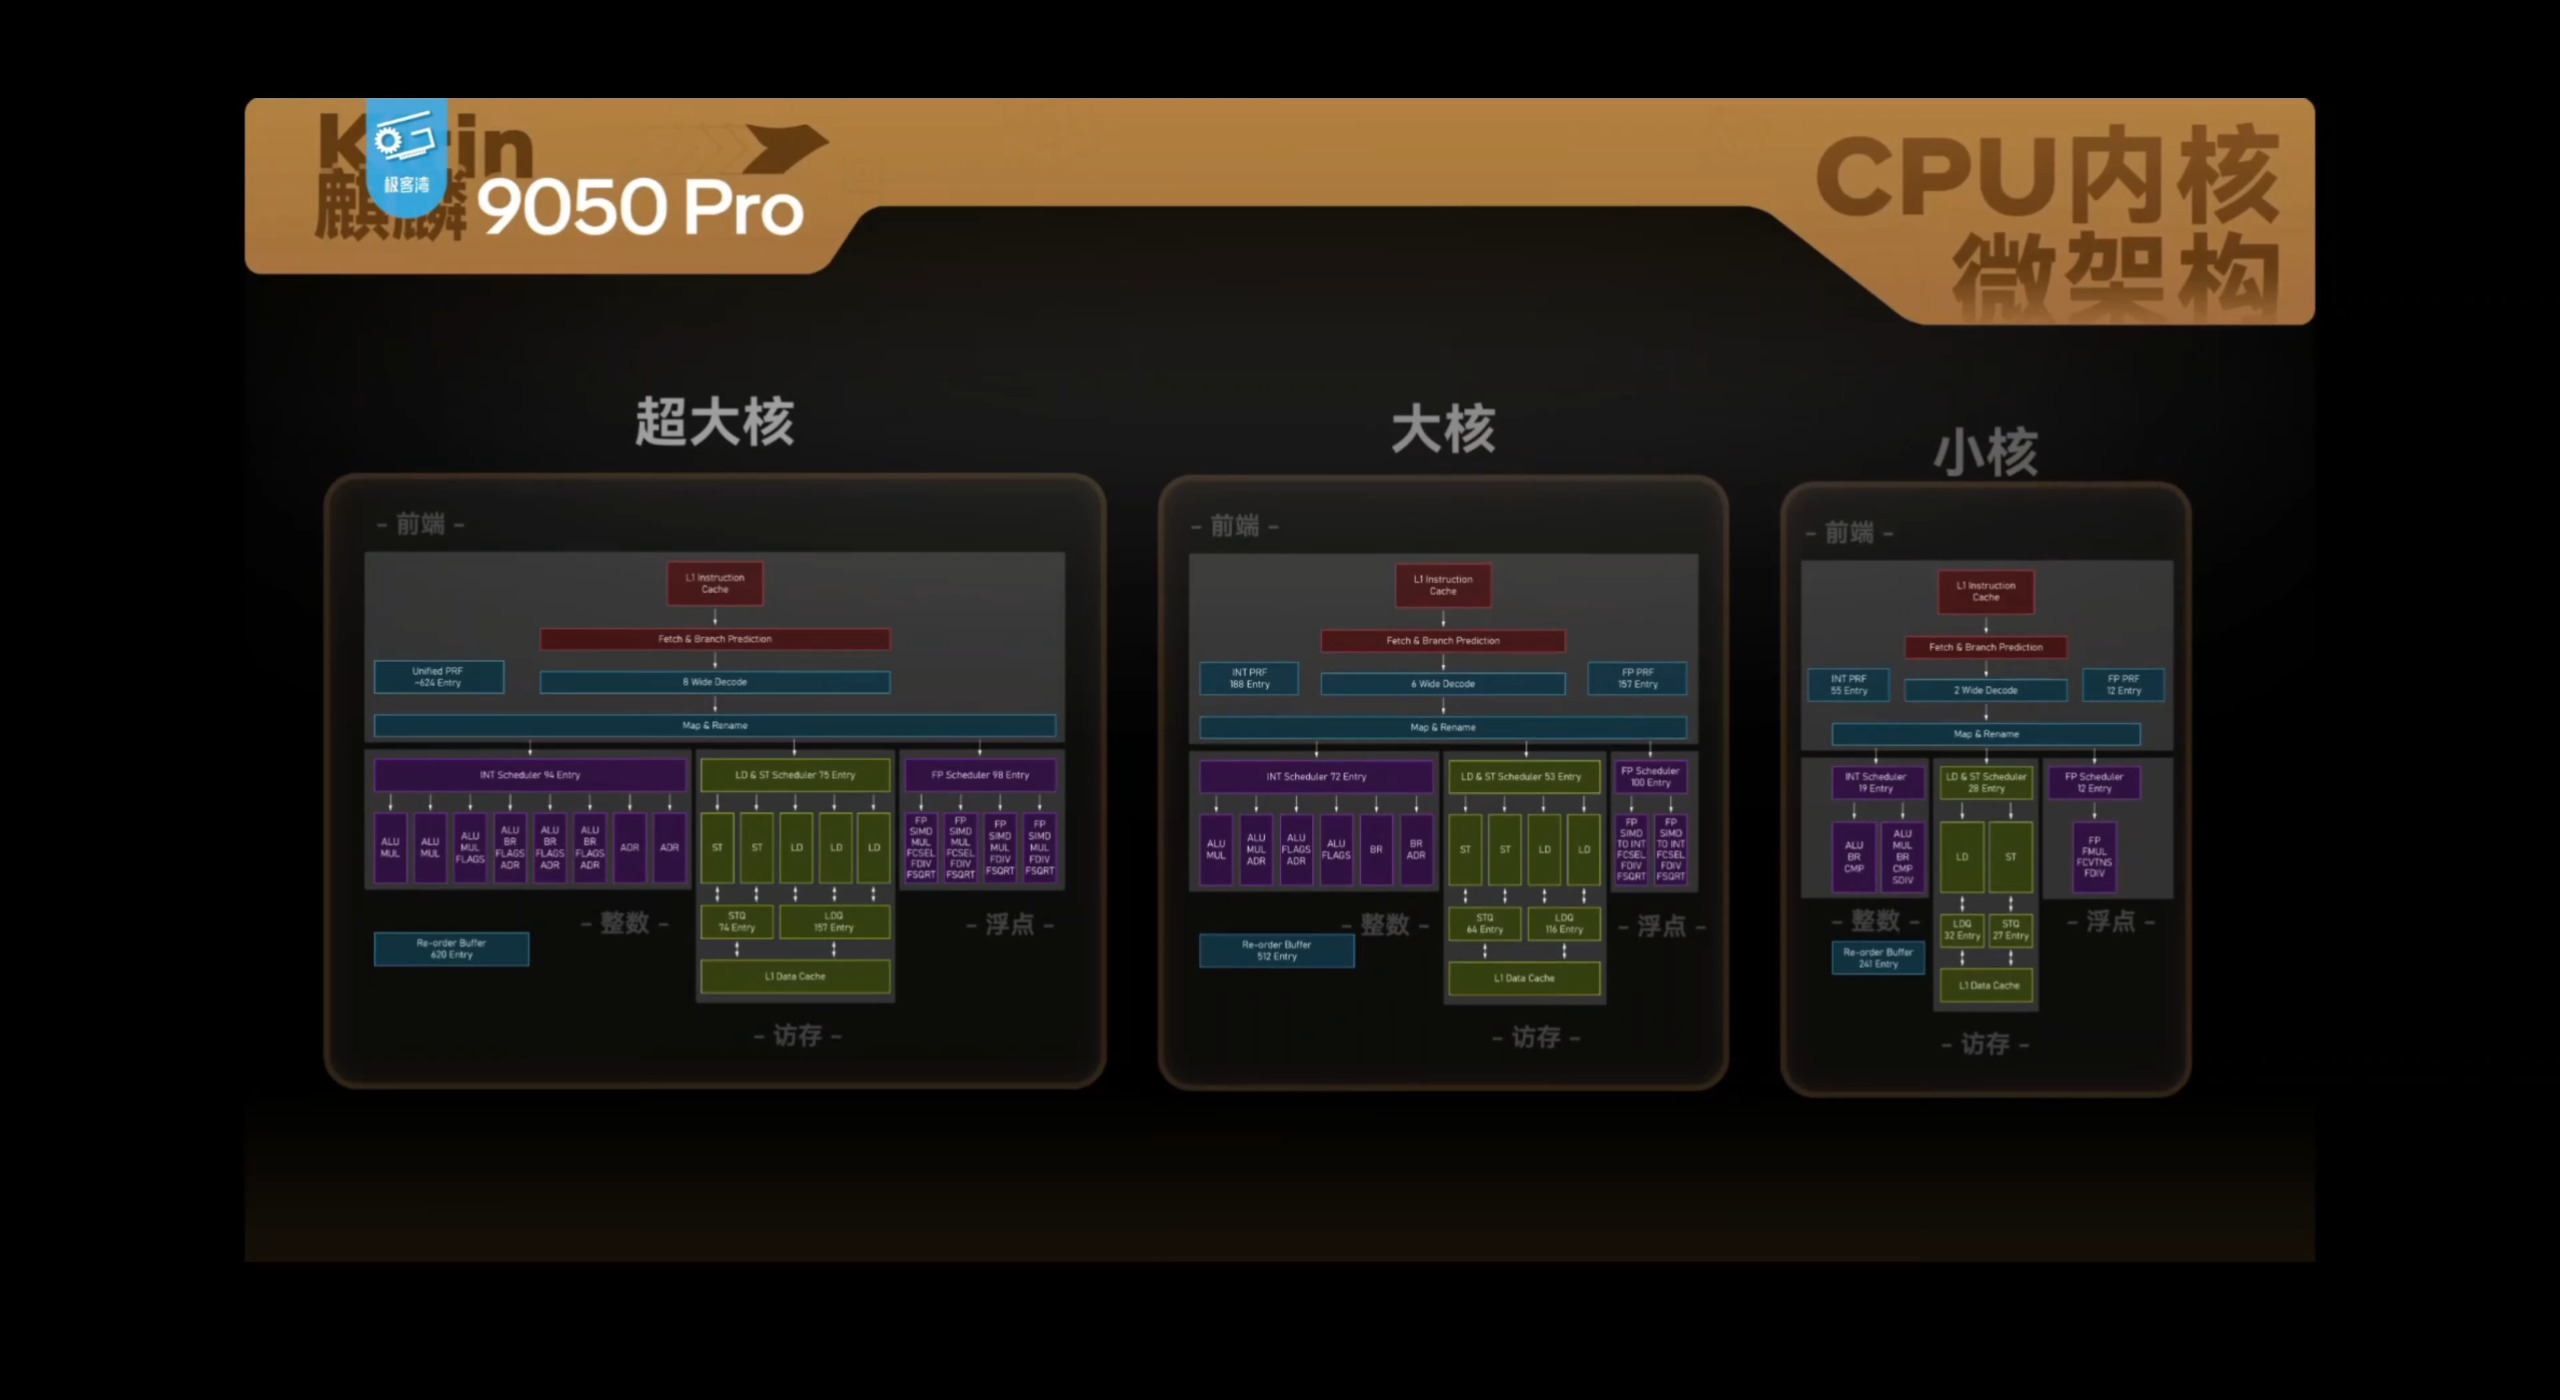
从超大核的框图里能读到的结构参数:
- 前端:L1 指令缓存 → 取指与分支预测 → 8-wide 解码 → 映射与重命名
- 物理寄存器堆(Unified PRF)约 624 entry,重排序缓冲(ROB)620 entry
- 整数:INT Scheduler 94 entry,执行端口为 4×ALU/MUL + 4×ALU/BR/FLAGS/ADR + 2×ADR
- 访存:LD & ST Scheduler 75 entry,5 条访存端口;STQ 74 entry、LDQ 157 entry,接 L1 数据缓存
- 浮点:FP Scheduler 98 entry,5 组 FP/SIMD 执行单元(含 MUL / FCSEL / FOV / FDIV / FSQRT)
六、CPU 能效实测:曲线跑到 A17 Pro 之上
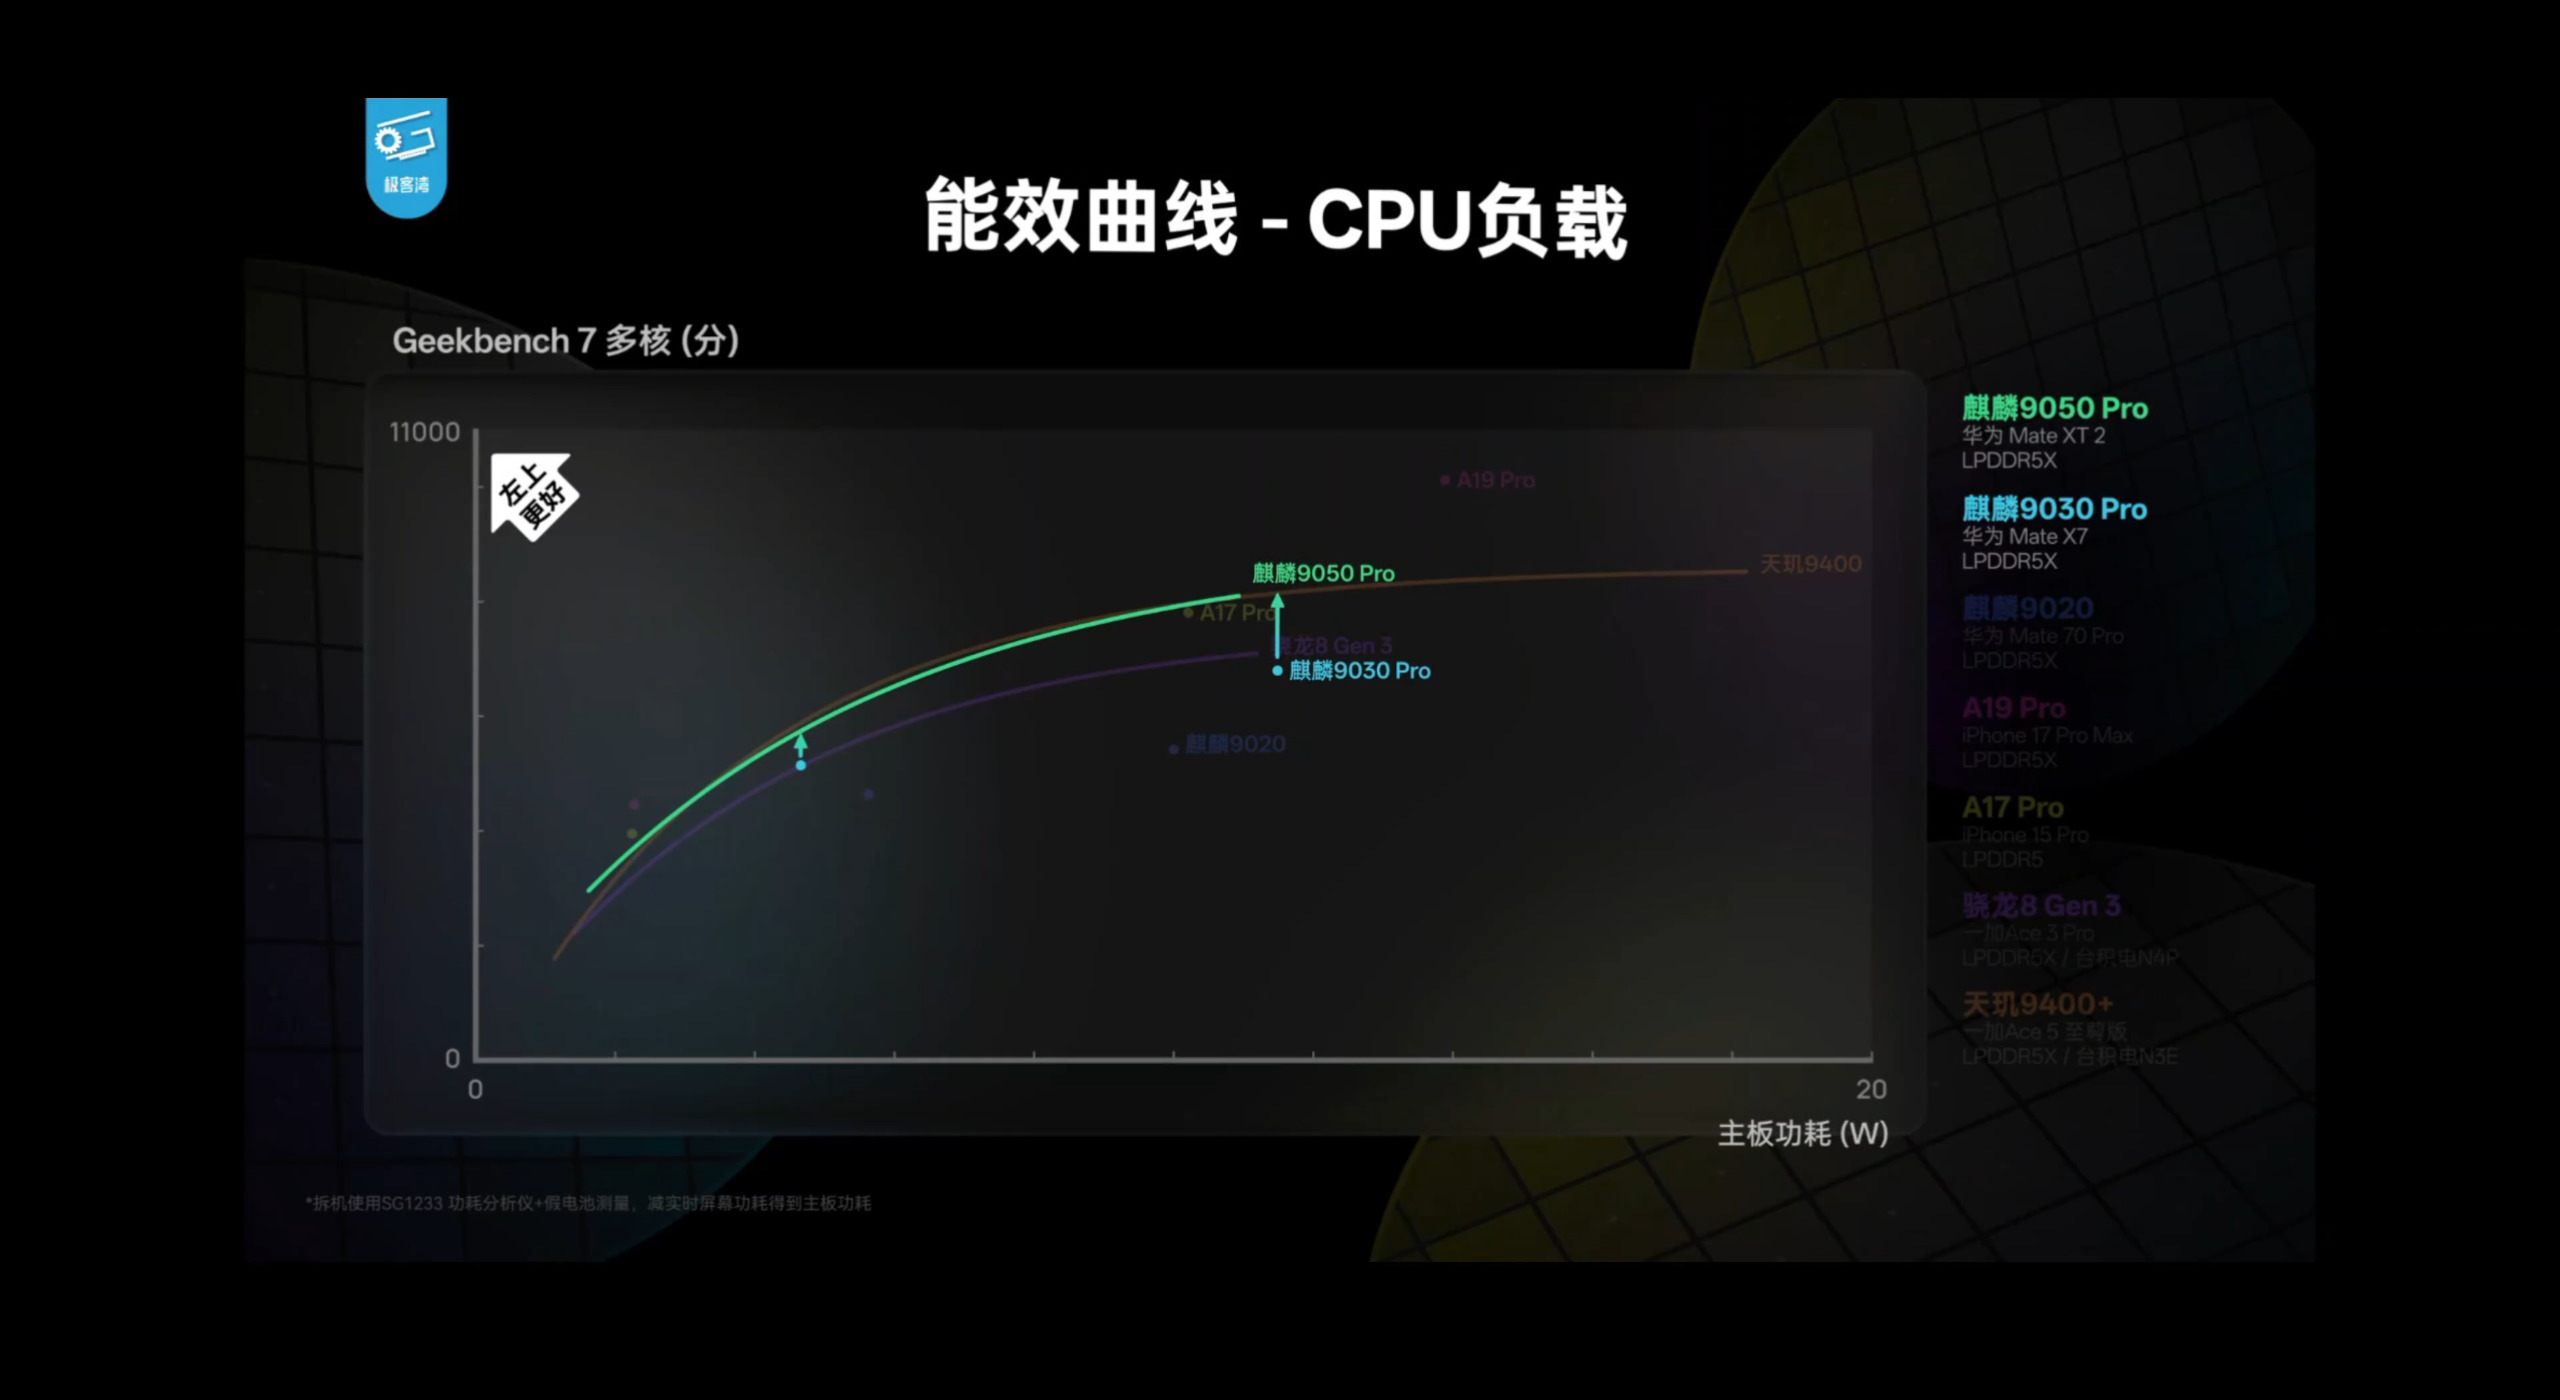
这张是"能效曲线",横轴是主板功耗而不是频率,纵轴是 Geekbench 7 多核分数。同场对比的有麒麟 9050 Pro(Mate XT 2)、麒麟 9030 Pro(Mate X7)、麒麟 9020(Mate 70 Pro)、A17 Pro、A19 Pro(iPhone 17 Pro Max)、骁龙 8 Gen 3 和天玑 9400+。
图上能直接读到的关系是:麒麟 9050 Pro 的整条曲线位于 A17 Pro、骁龙 8 Gen 3、麒麟 9030 Pro、麒麟 9020 之上;在标注的等性能参考线处,它已经越过 A17 Pro,但天玑 9400+ 仍在上方。
这里必须提一句图上脚注:所有跑分是用 SPEC2013 单核分换算成 Geekbench 的,测试机制与常规处理器跑分规则不同。所以看这条曲线时,重点看"曲线之间的相对位置",不要把纵轴数字直接当成 Geekbench 官方成绩。
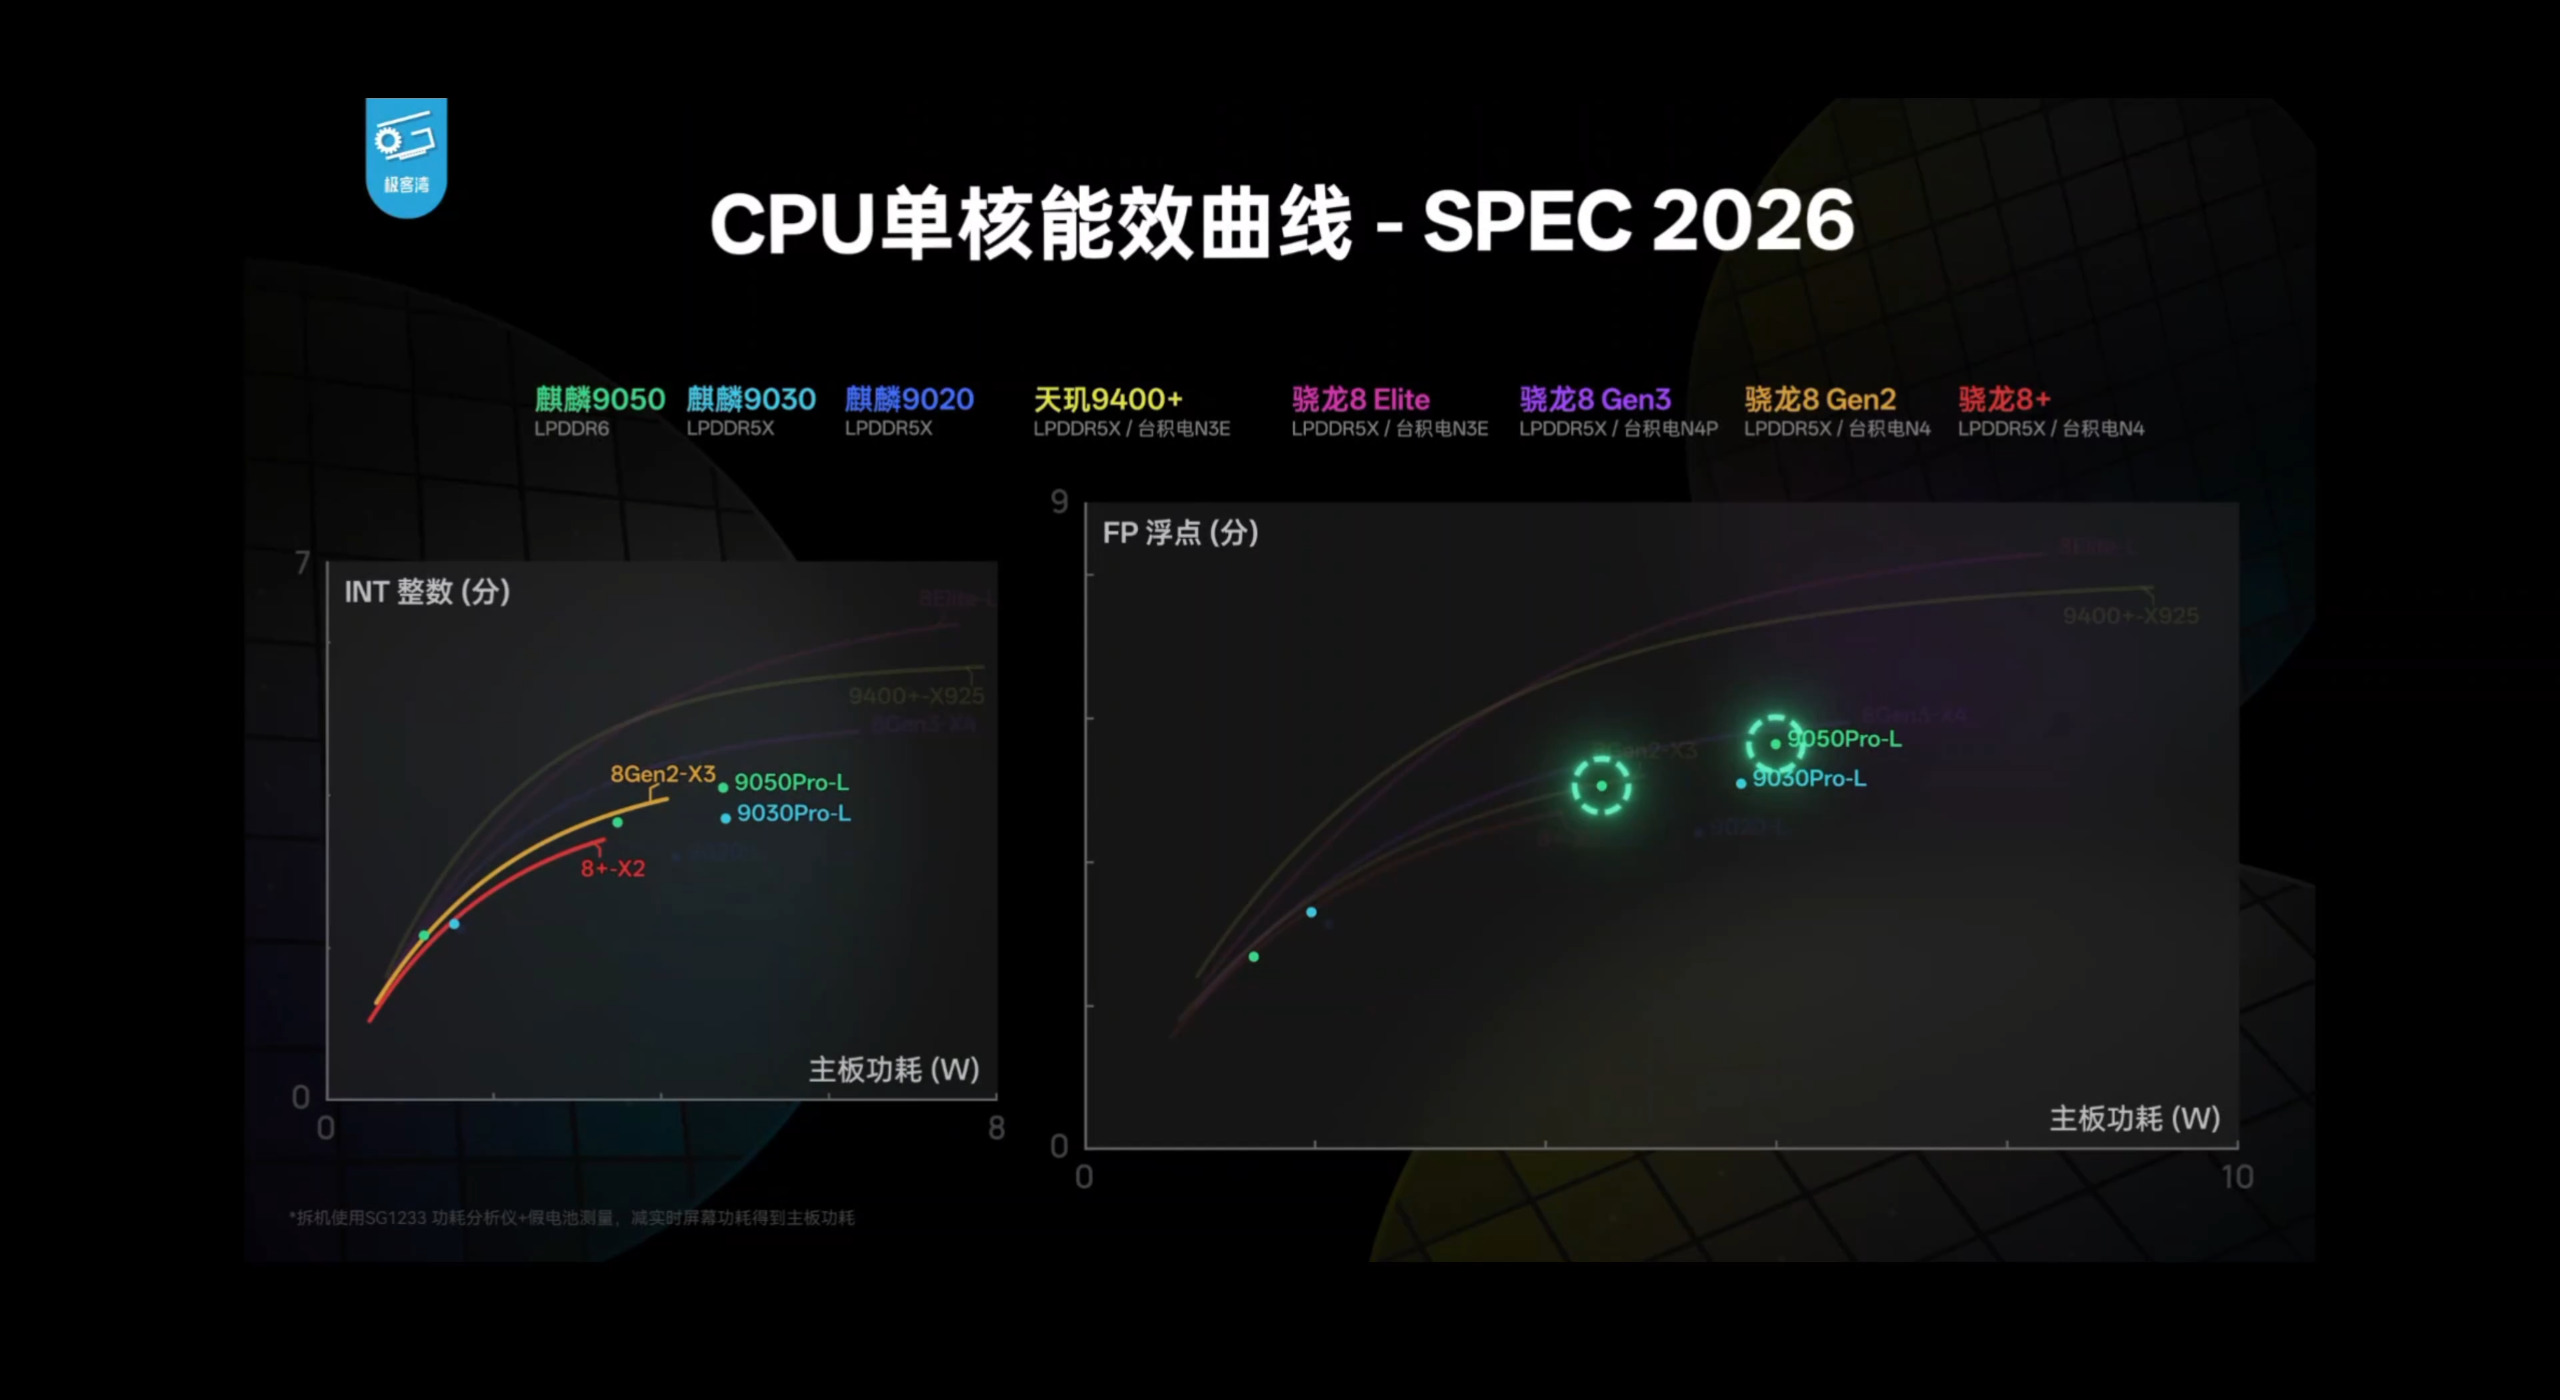
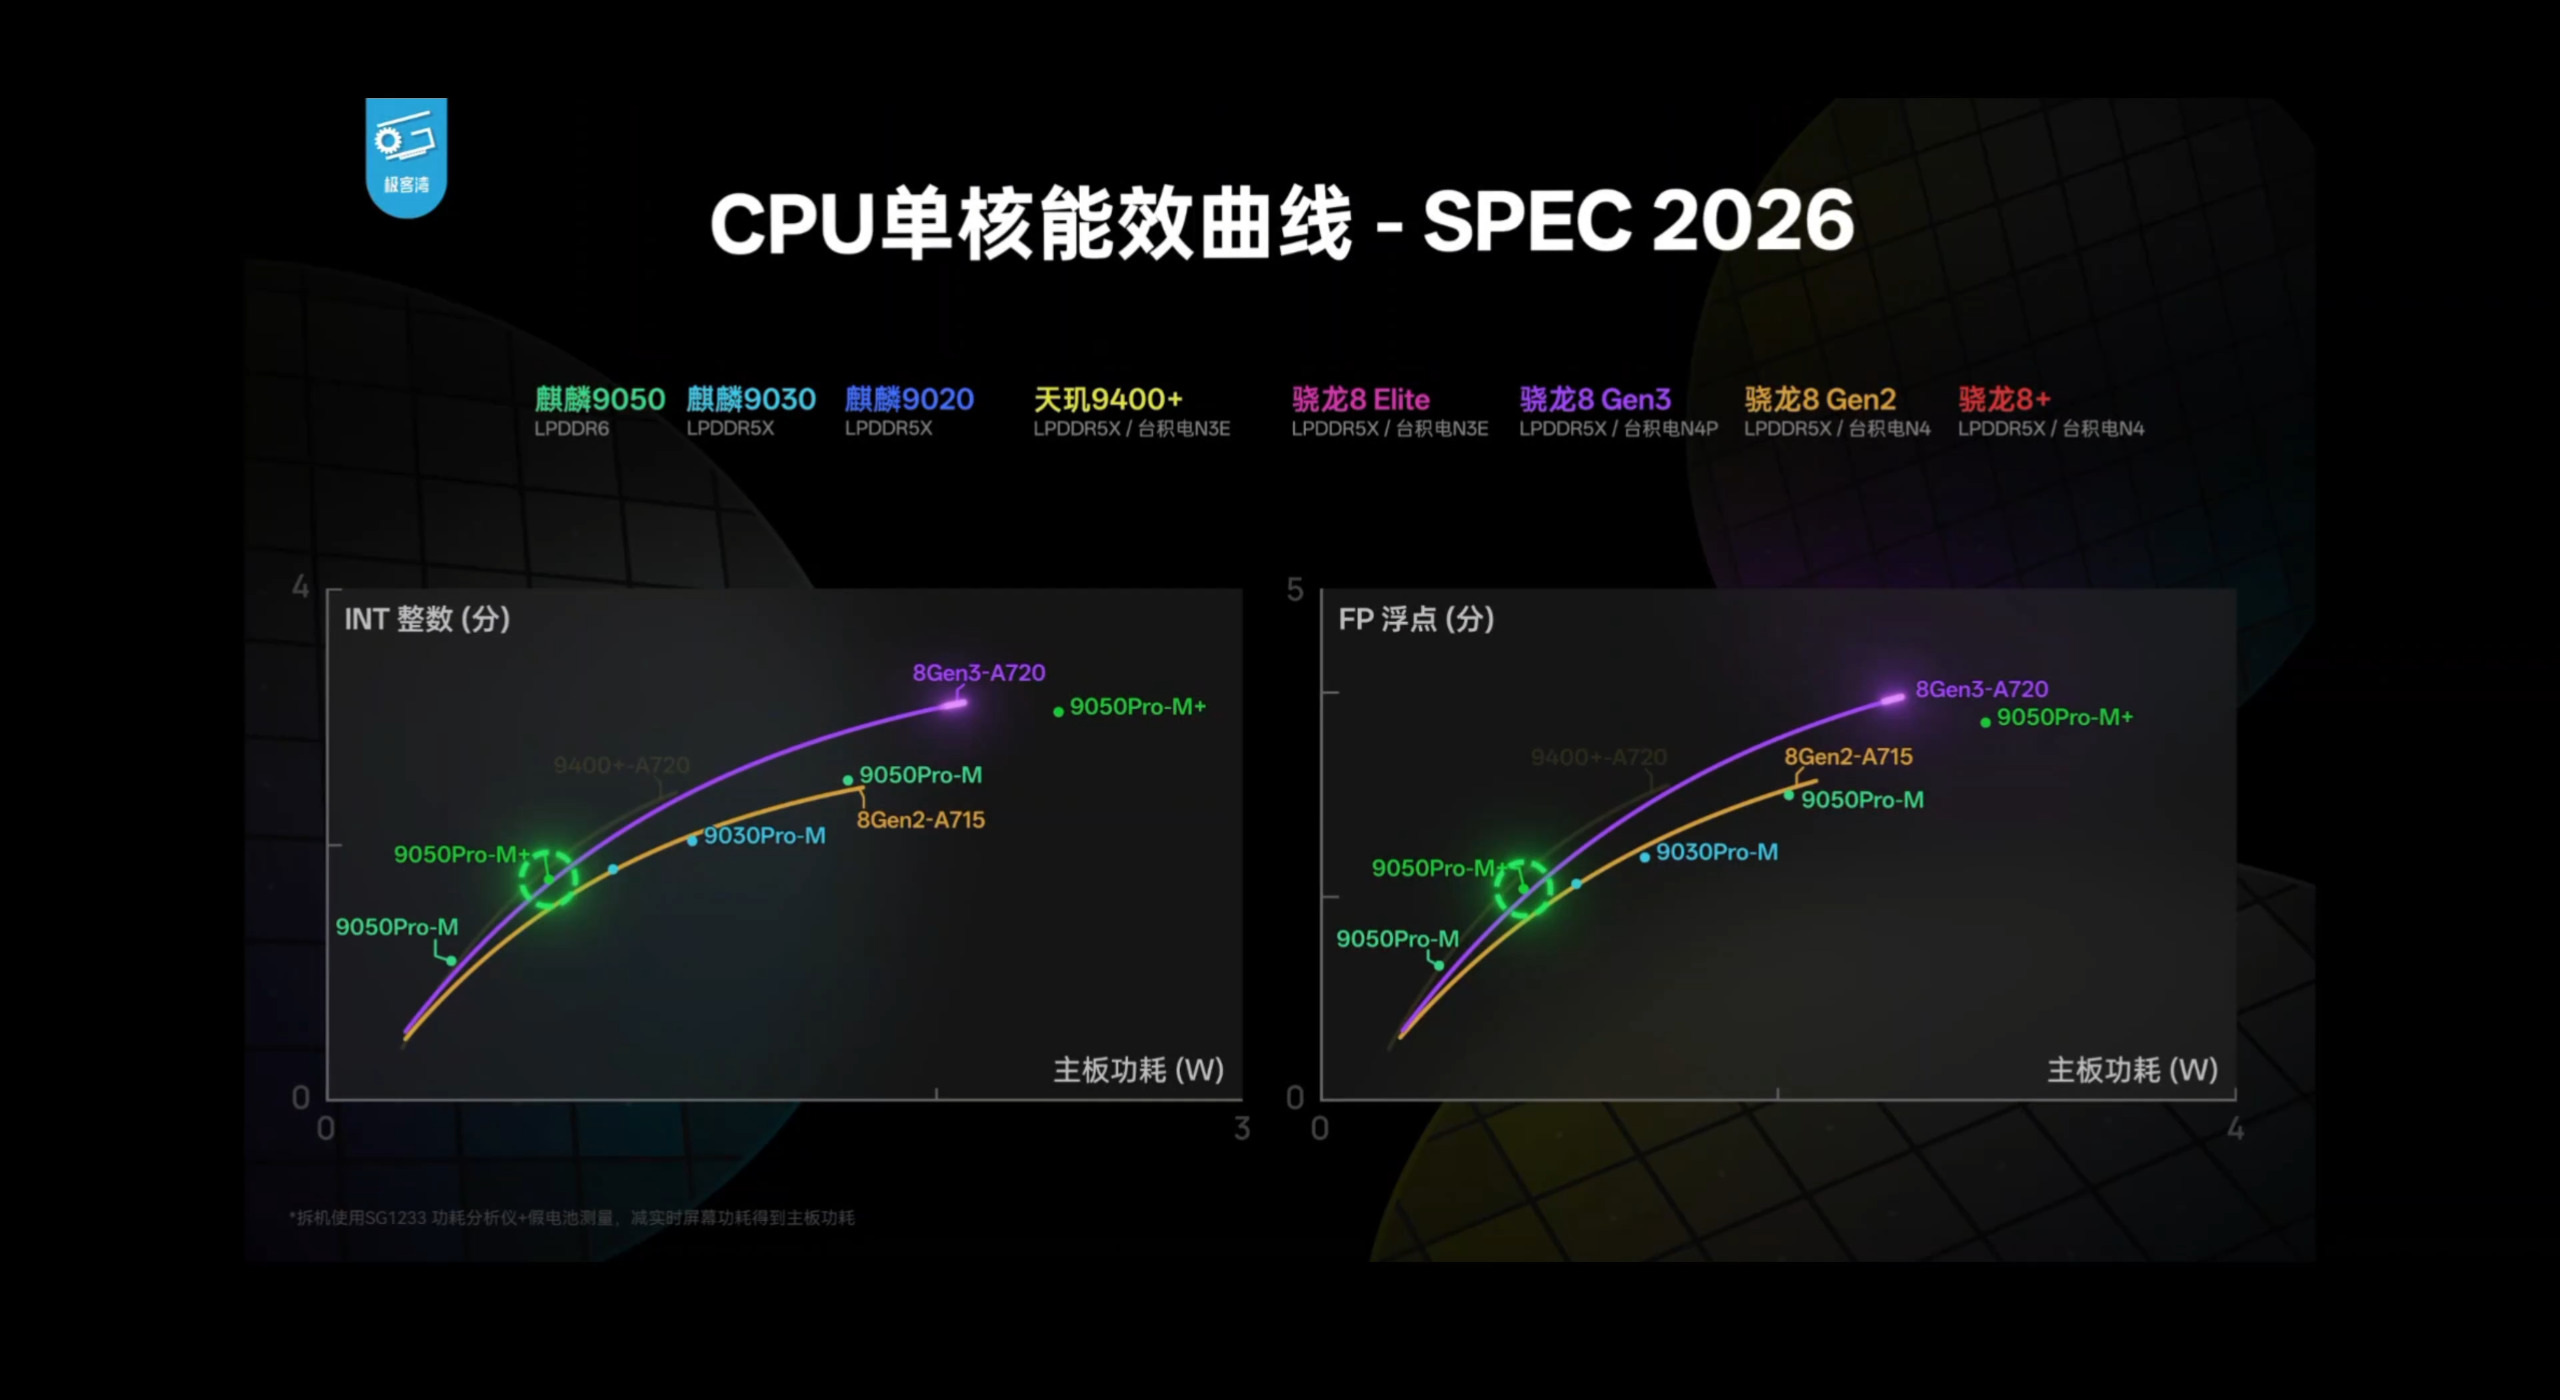
把低功耗区间单独放大,能看到更贴近日常使用的表现:在 3W 以内,麒麟 9050 Pro 的 M 与 M+ 两个采样点都高于上一代 9030 Pro,但距离骁龙 8 Gen 3 的 A720 核心还有一段距离。这说明这一代在中低负载的能效上进步是实打实的,但还没到"同功耗反超"的程度。
七、GPU:3DMark Steel Nomad Light 与能效曲线
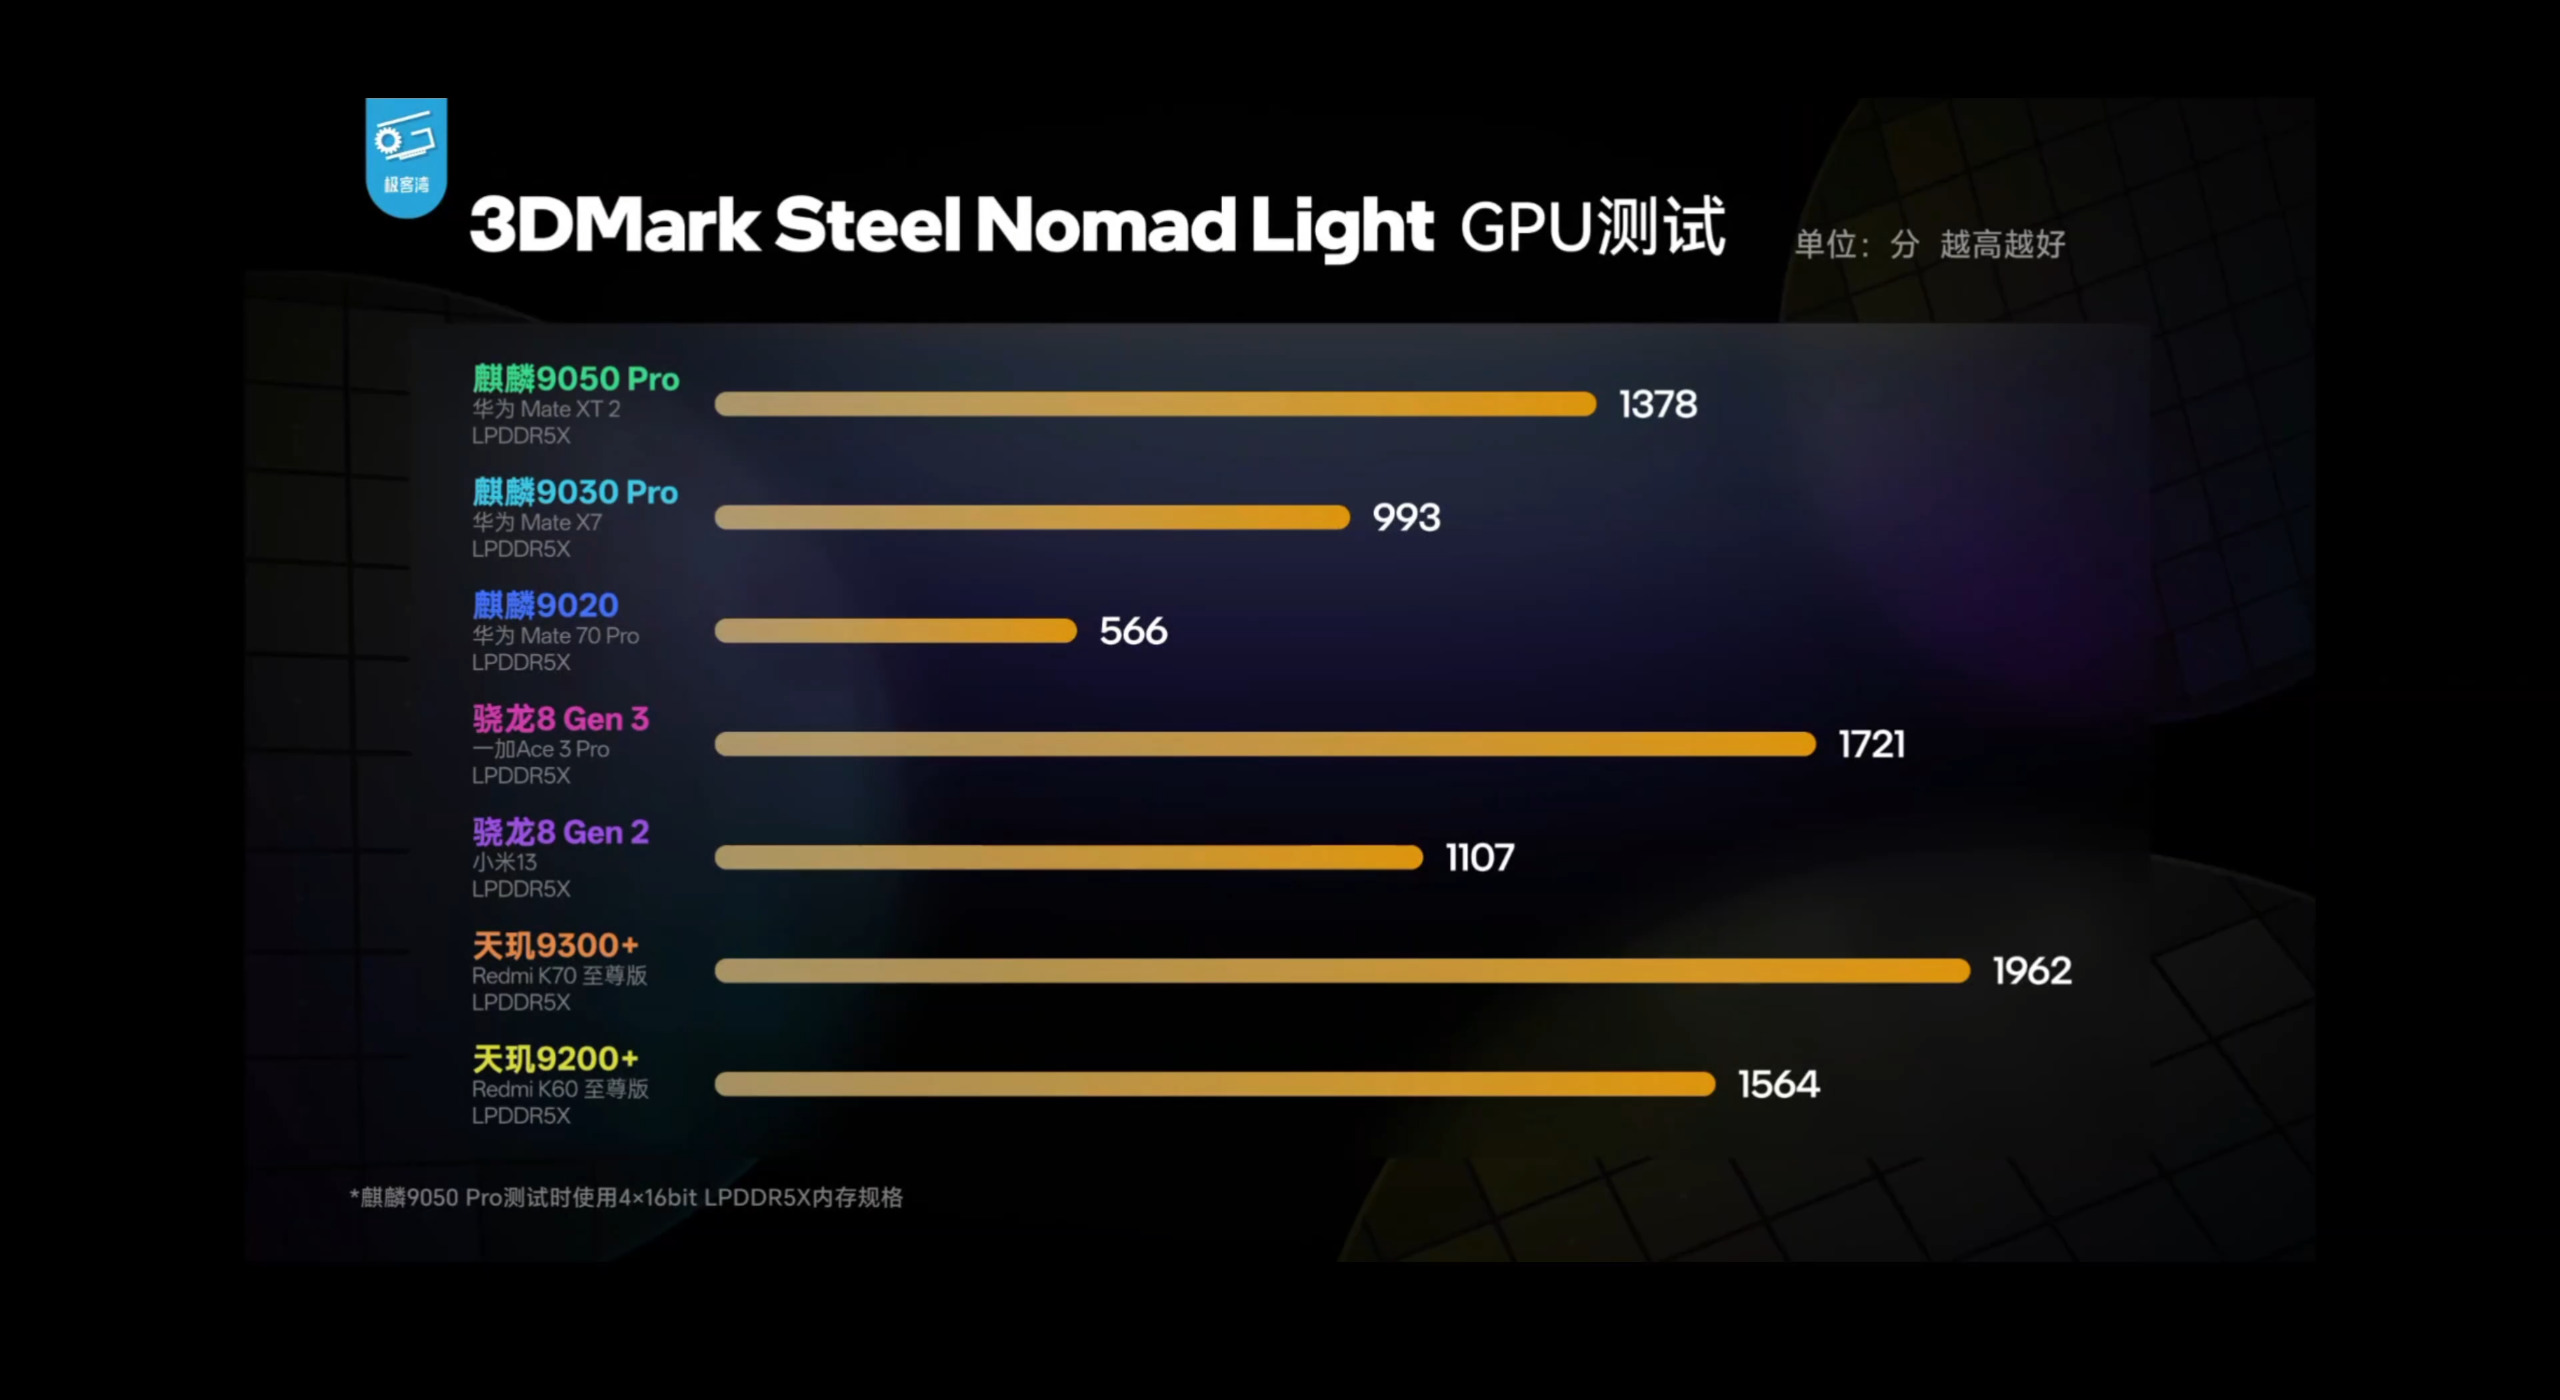
| 机型 | SoC | 分数 |
|---|---|---|
| iQOO Neo10 至尊版 | 天玑 9300+ | 1962 |
| 一加 Ace 5 Pro | 骁龙 8 Gen 3 | 1721 |
| Redmi K60 至尊版 | 天玑 9200+ | 1564 |
| 华为 Mate XT 2 | 麒麟 9050 Pro | 1378 |
| 小米 13 | 骁龙 8 Gen 2 | 1107 |
| 华为 Mate X7 | 麒麟 9030 Pro | 993 |
| 华为 Mate 70 Pro | 麒麟 9020 | 566 |
麒麟 9050 Pro 拿下 1378 分,比上一代 9030 Pro 的 993 分提升约 39%,比 9020 的 566 分提升约 143%。跨代进步很明显,但放在横评里看,它仍然低于骁龙 8 Gen 3(1721)和天玑 9300+(1962)——GPU 依旧是相对短板。需要说明的是,Mate XT 2 是三折叠机身,散热条件与直板机不完全可比。
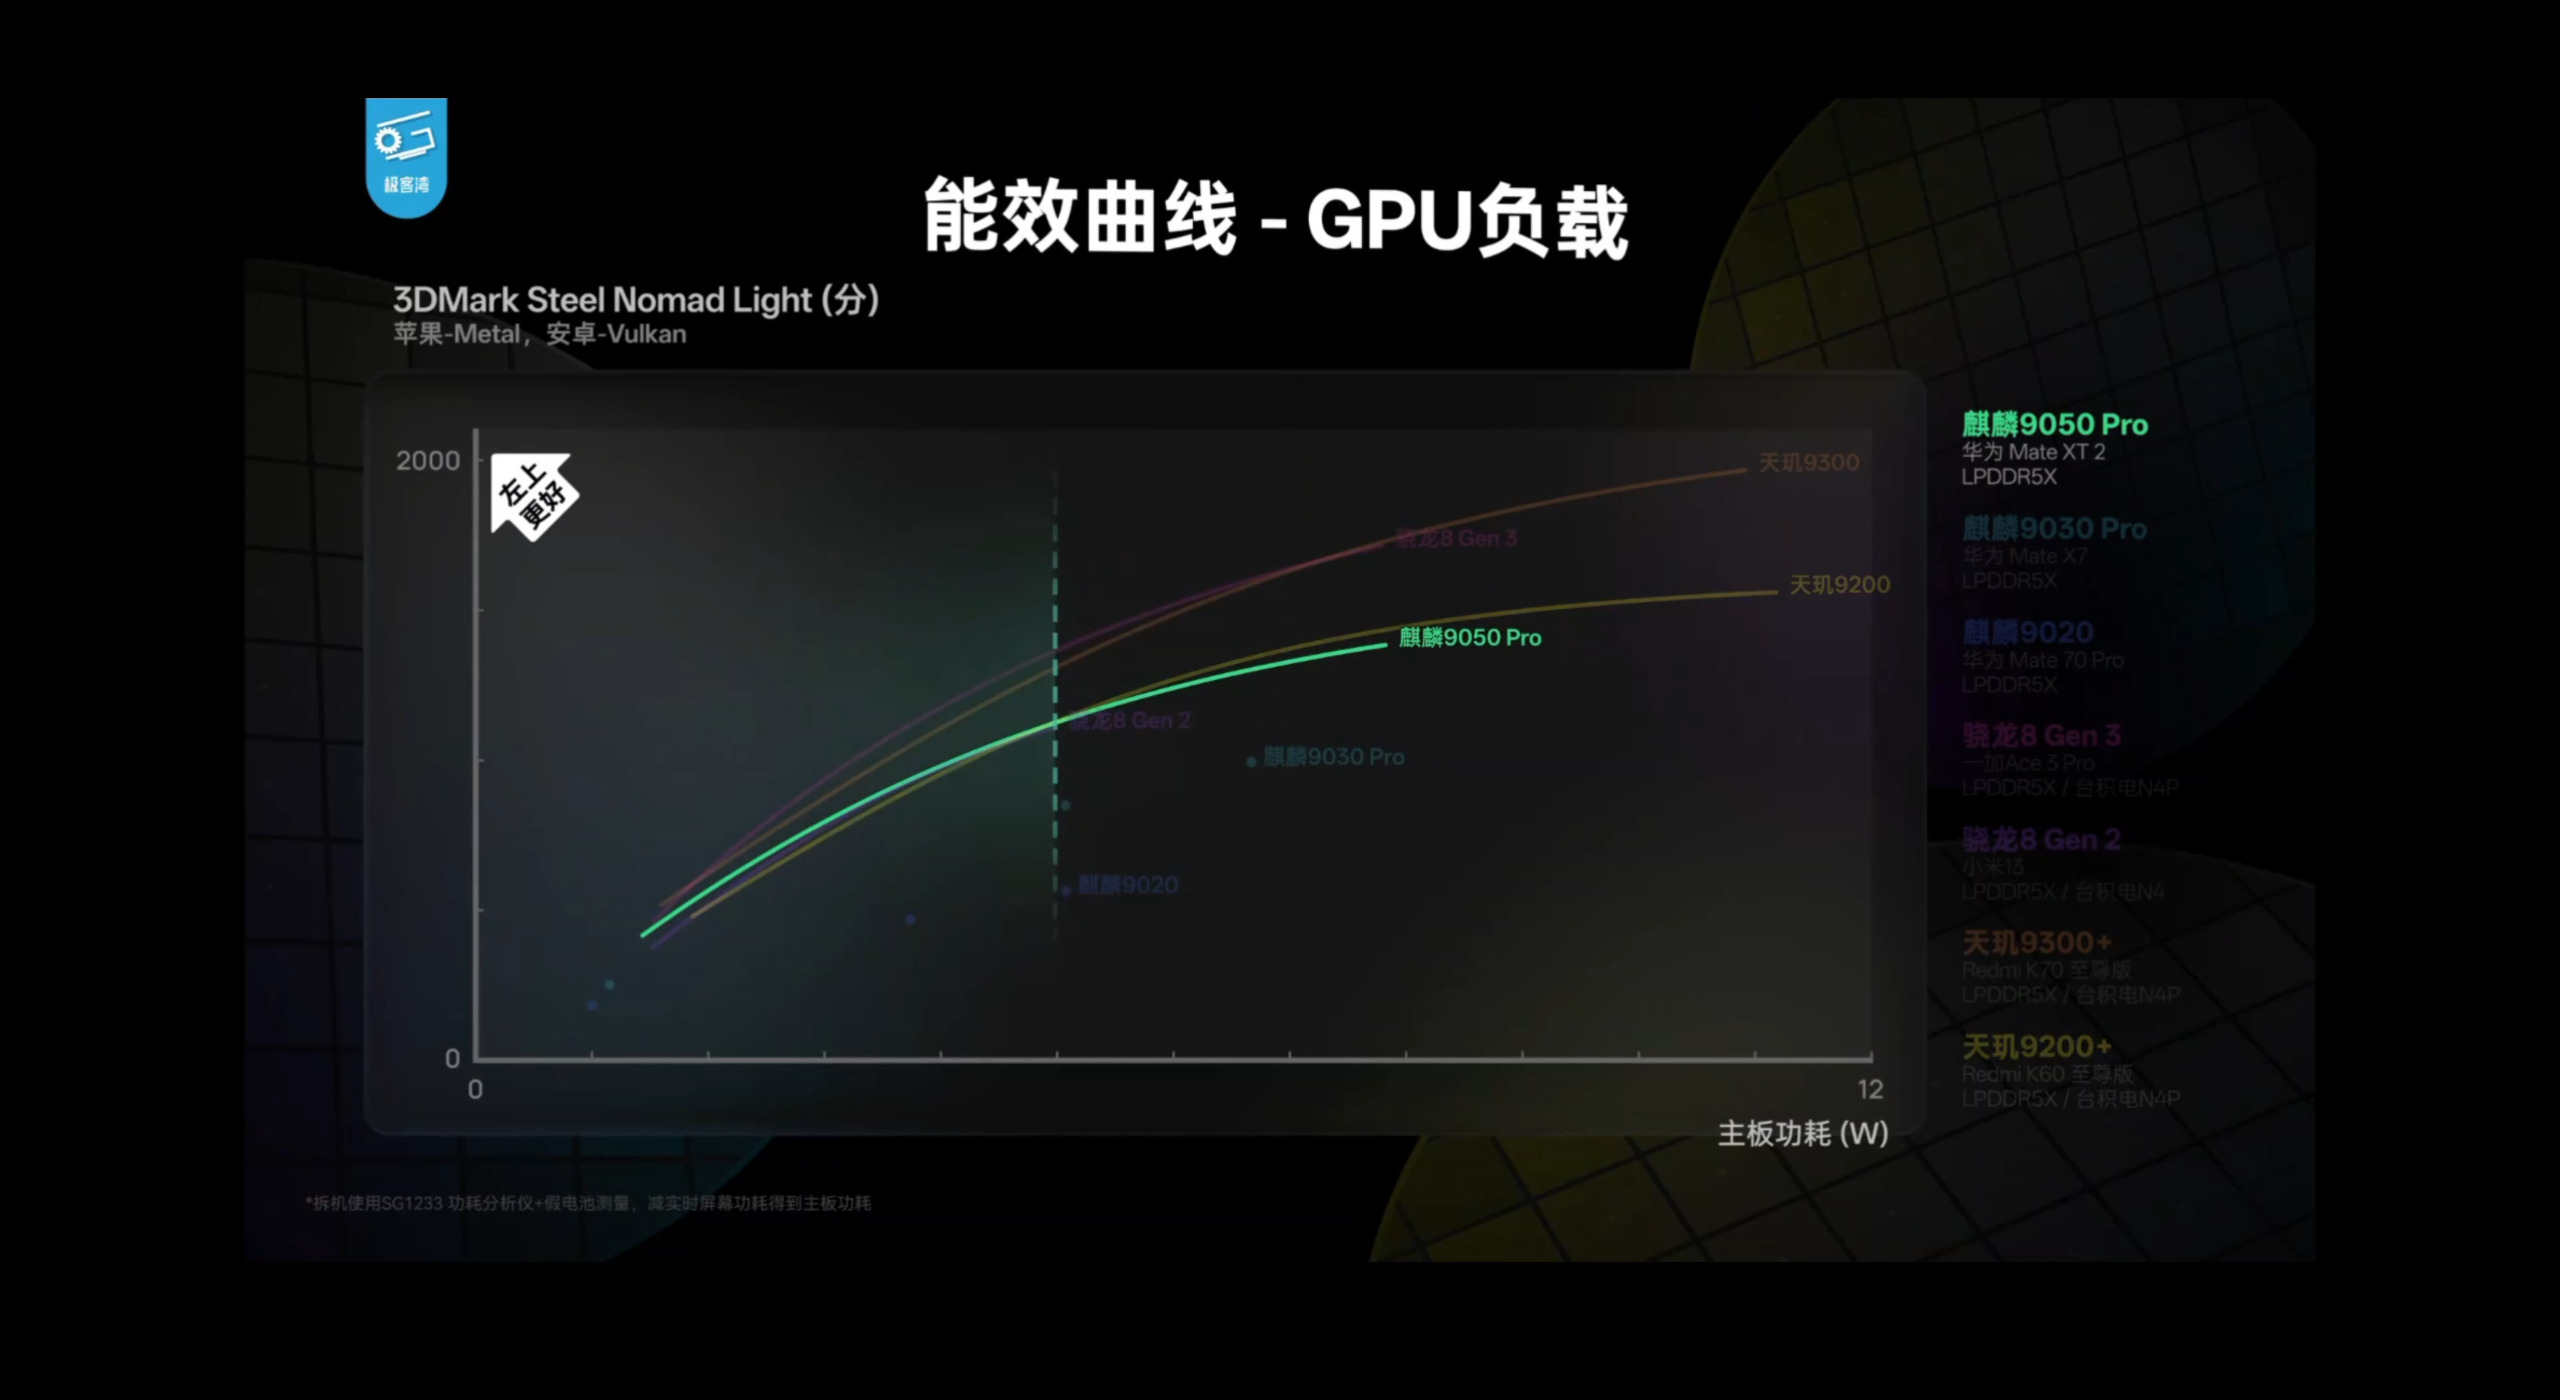
换成能效视角看 GPU:在整段功耗区间里,麒麟 9050 Pro 的曲线稳定地位于 9030 Pro、麒麟 9020 和骁龙 8 Gen 2 之上,但与天玑 9200 / 9300 系列还有明显距离。GPU 这一代的进步主要在"补短板",而不是"反超"。
八、NPU:INT8 吞吐量从 27 到 67.7 TFLOPS
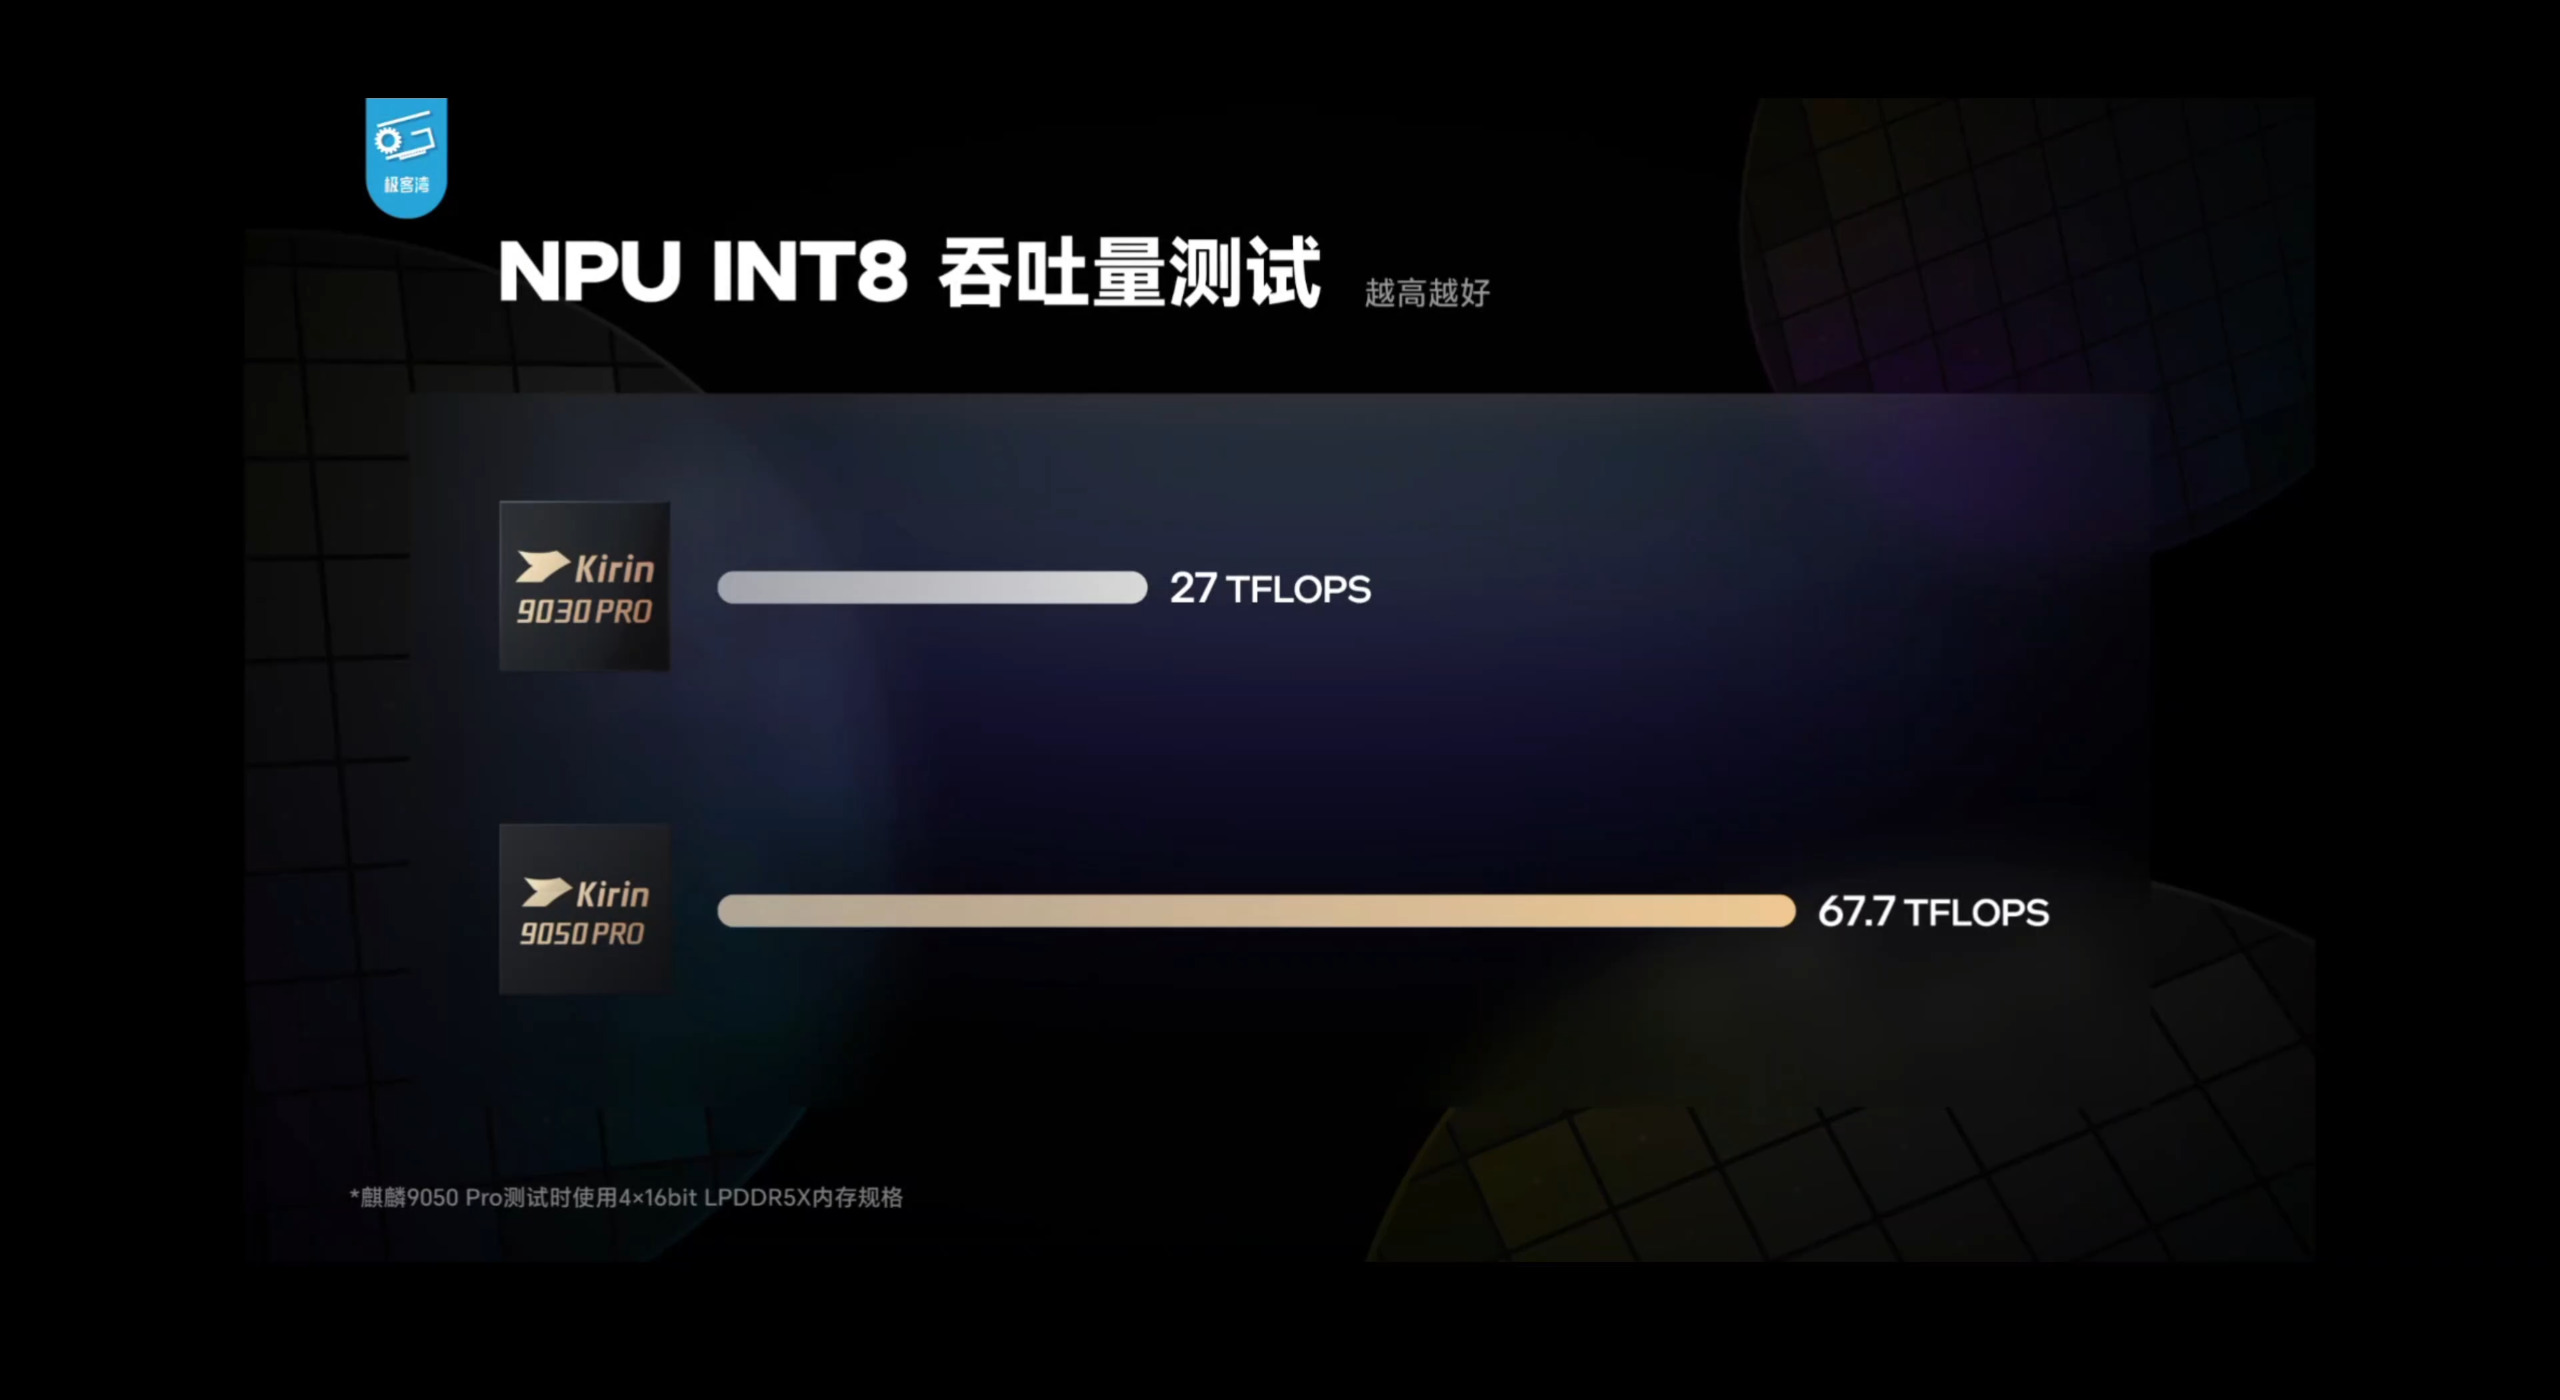
这是本篇跨度最大的一项:NPU 的 INT8 吞吐量从 9030 PRO 的 27 TFLOPS 拉到 9050 PRO 的 67.7 TFLOPS,提升约 2.5 倍。在端侧大模型越来越多落到手机上的背景下,这项指标的提升比 CPU 多核跑分更有现实意义。
九、游戏实测:三款大作,各跑 30 分钟
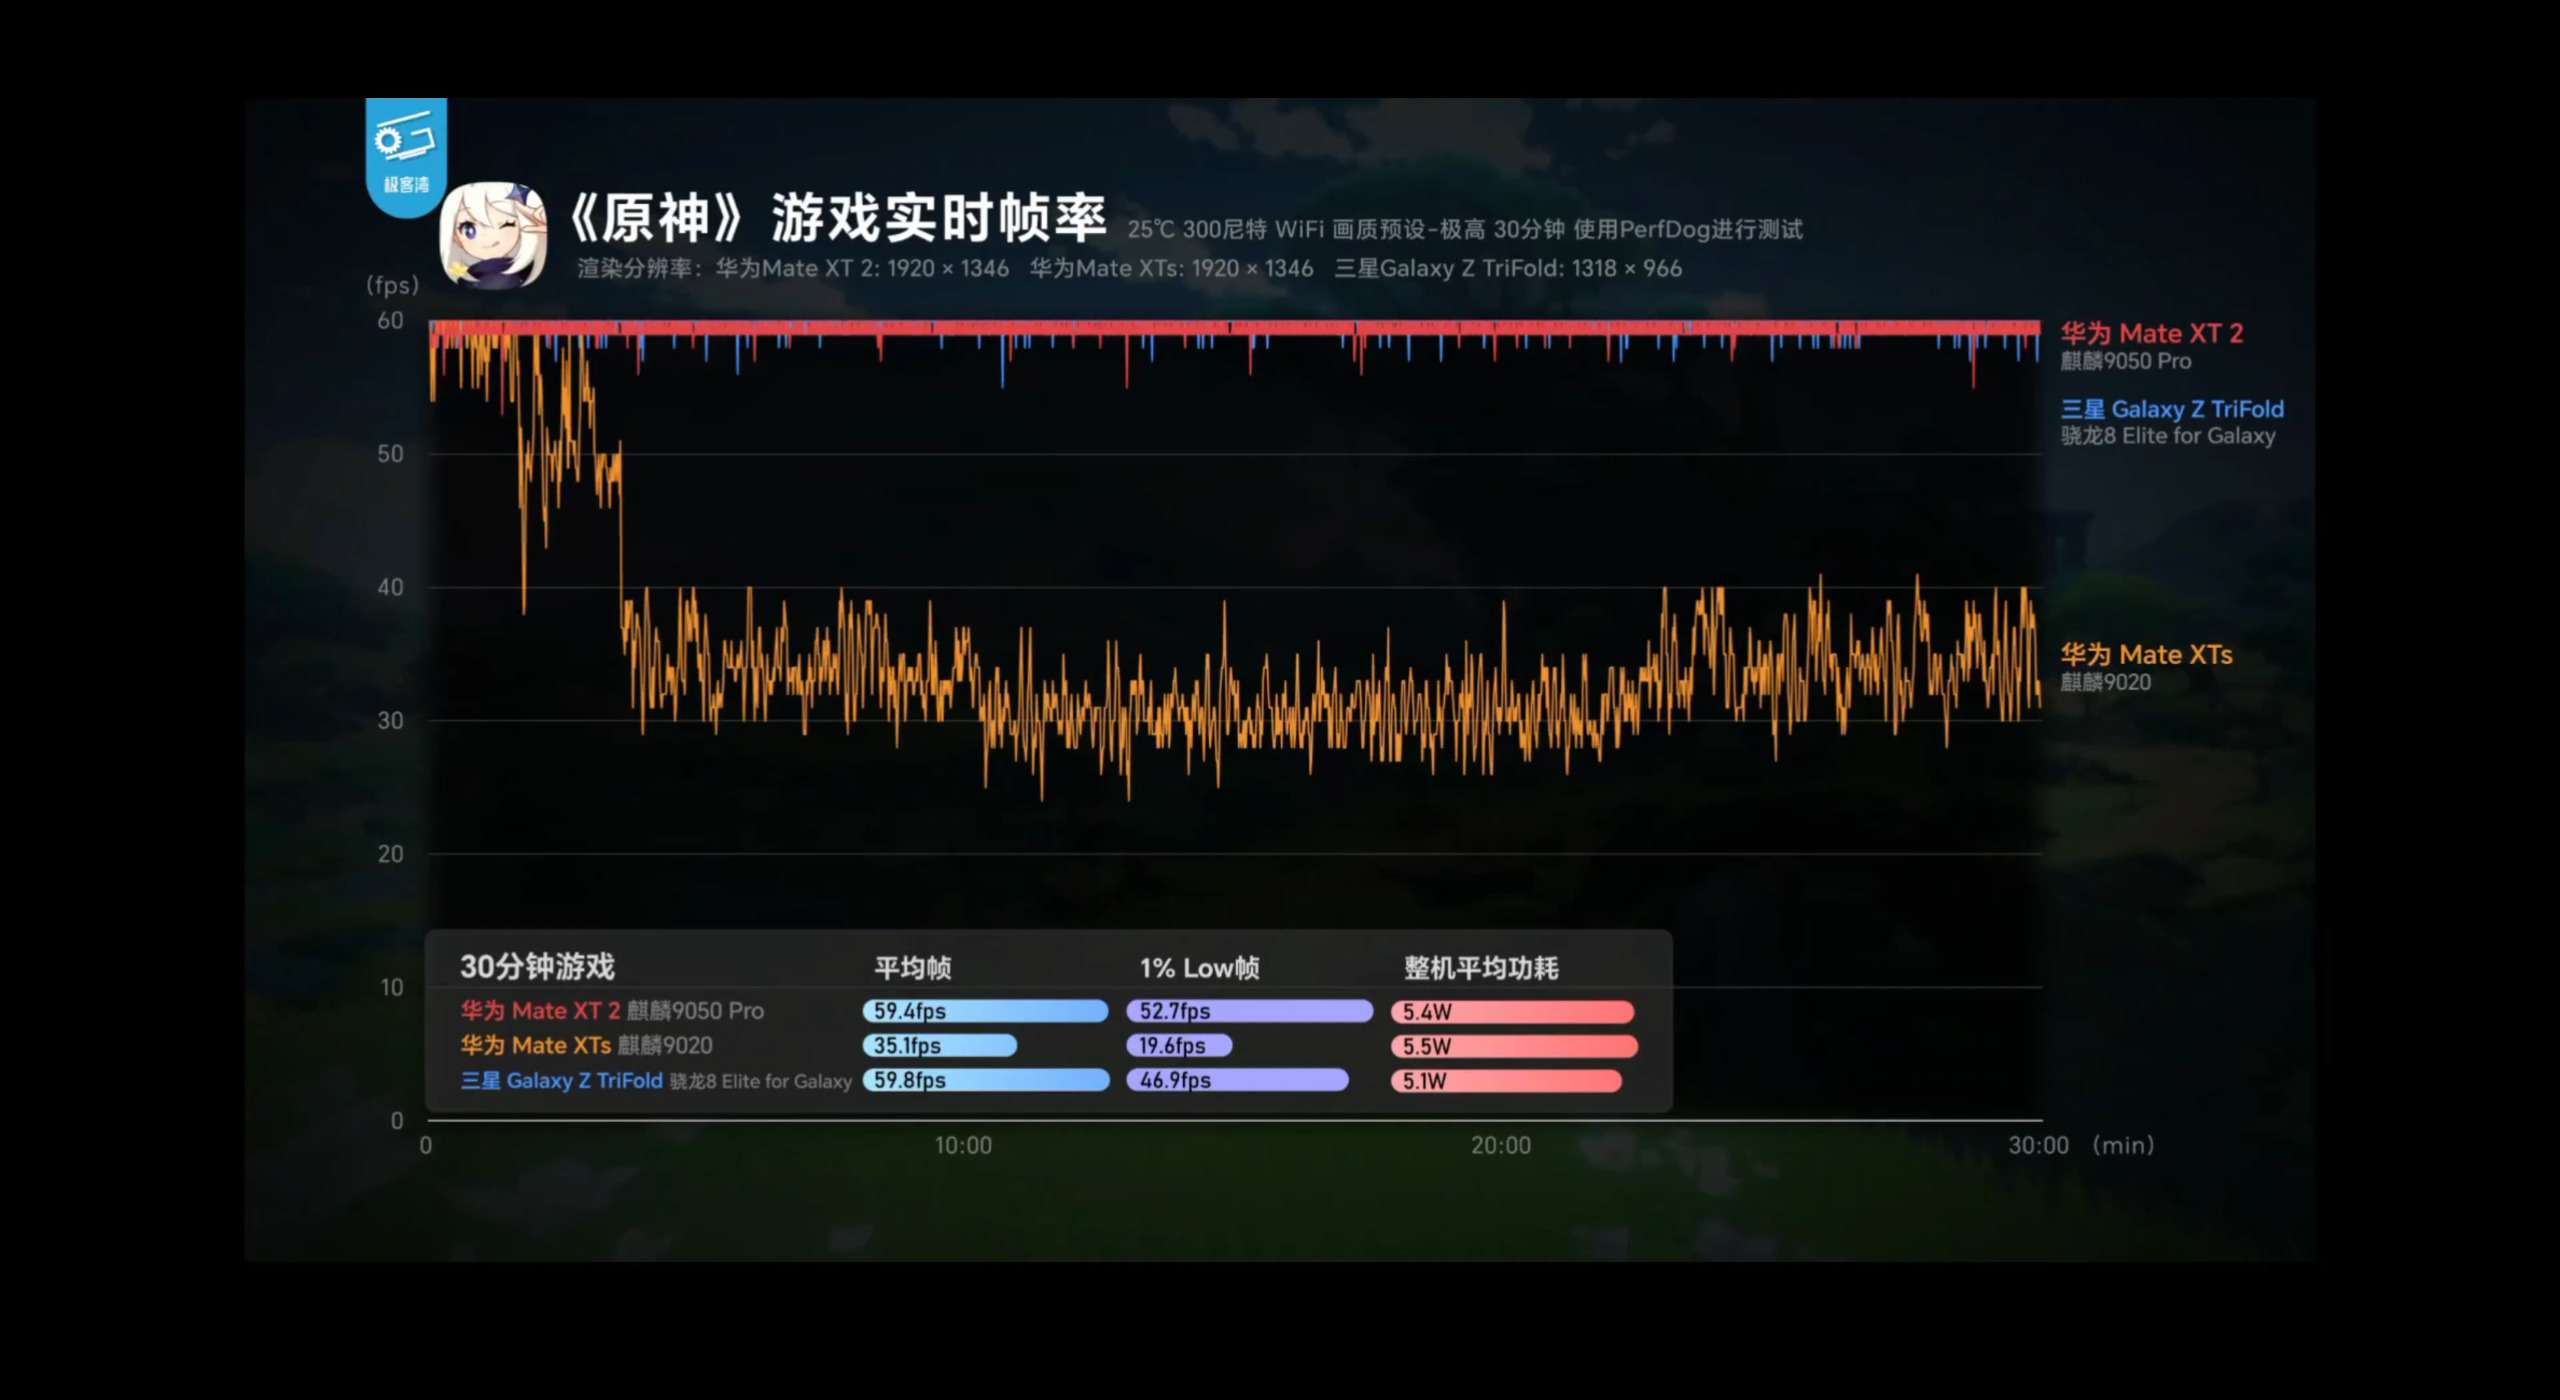
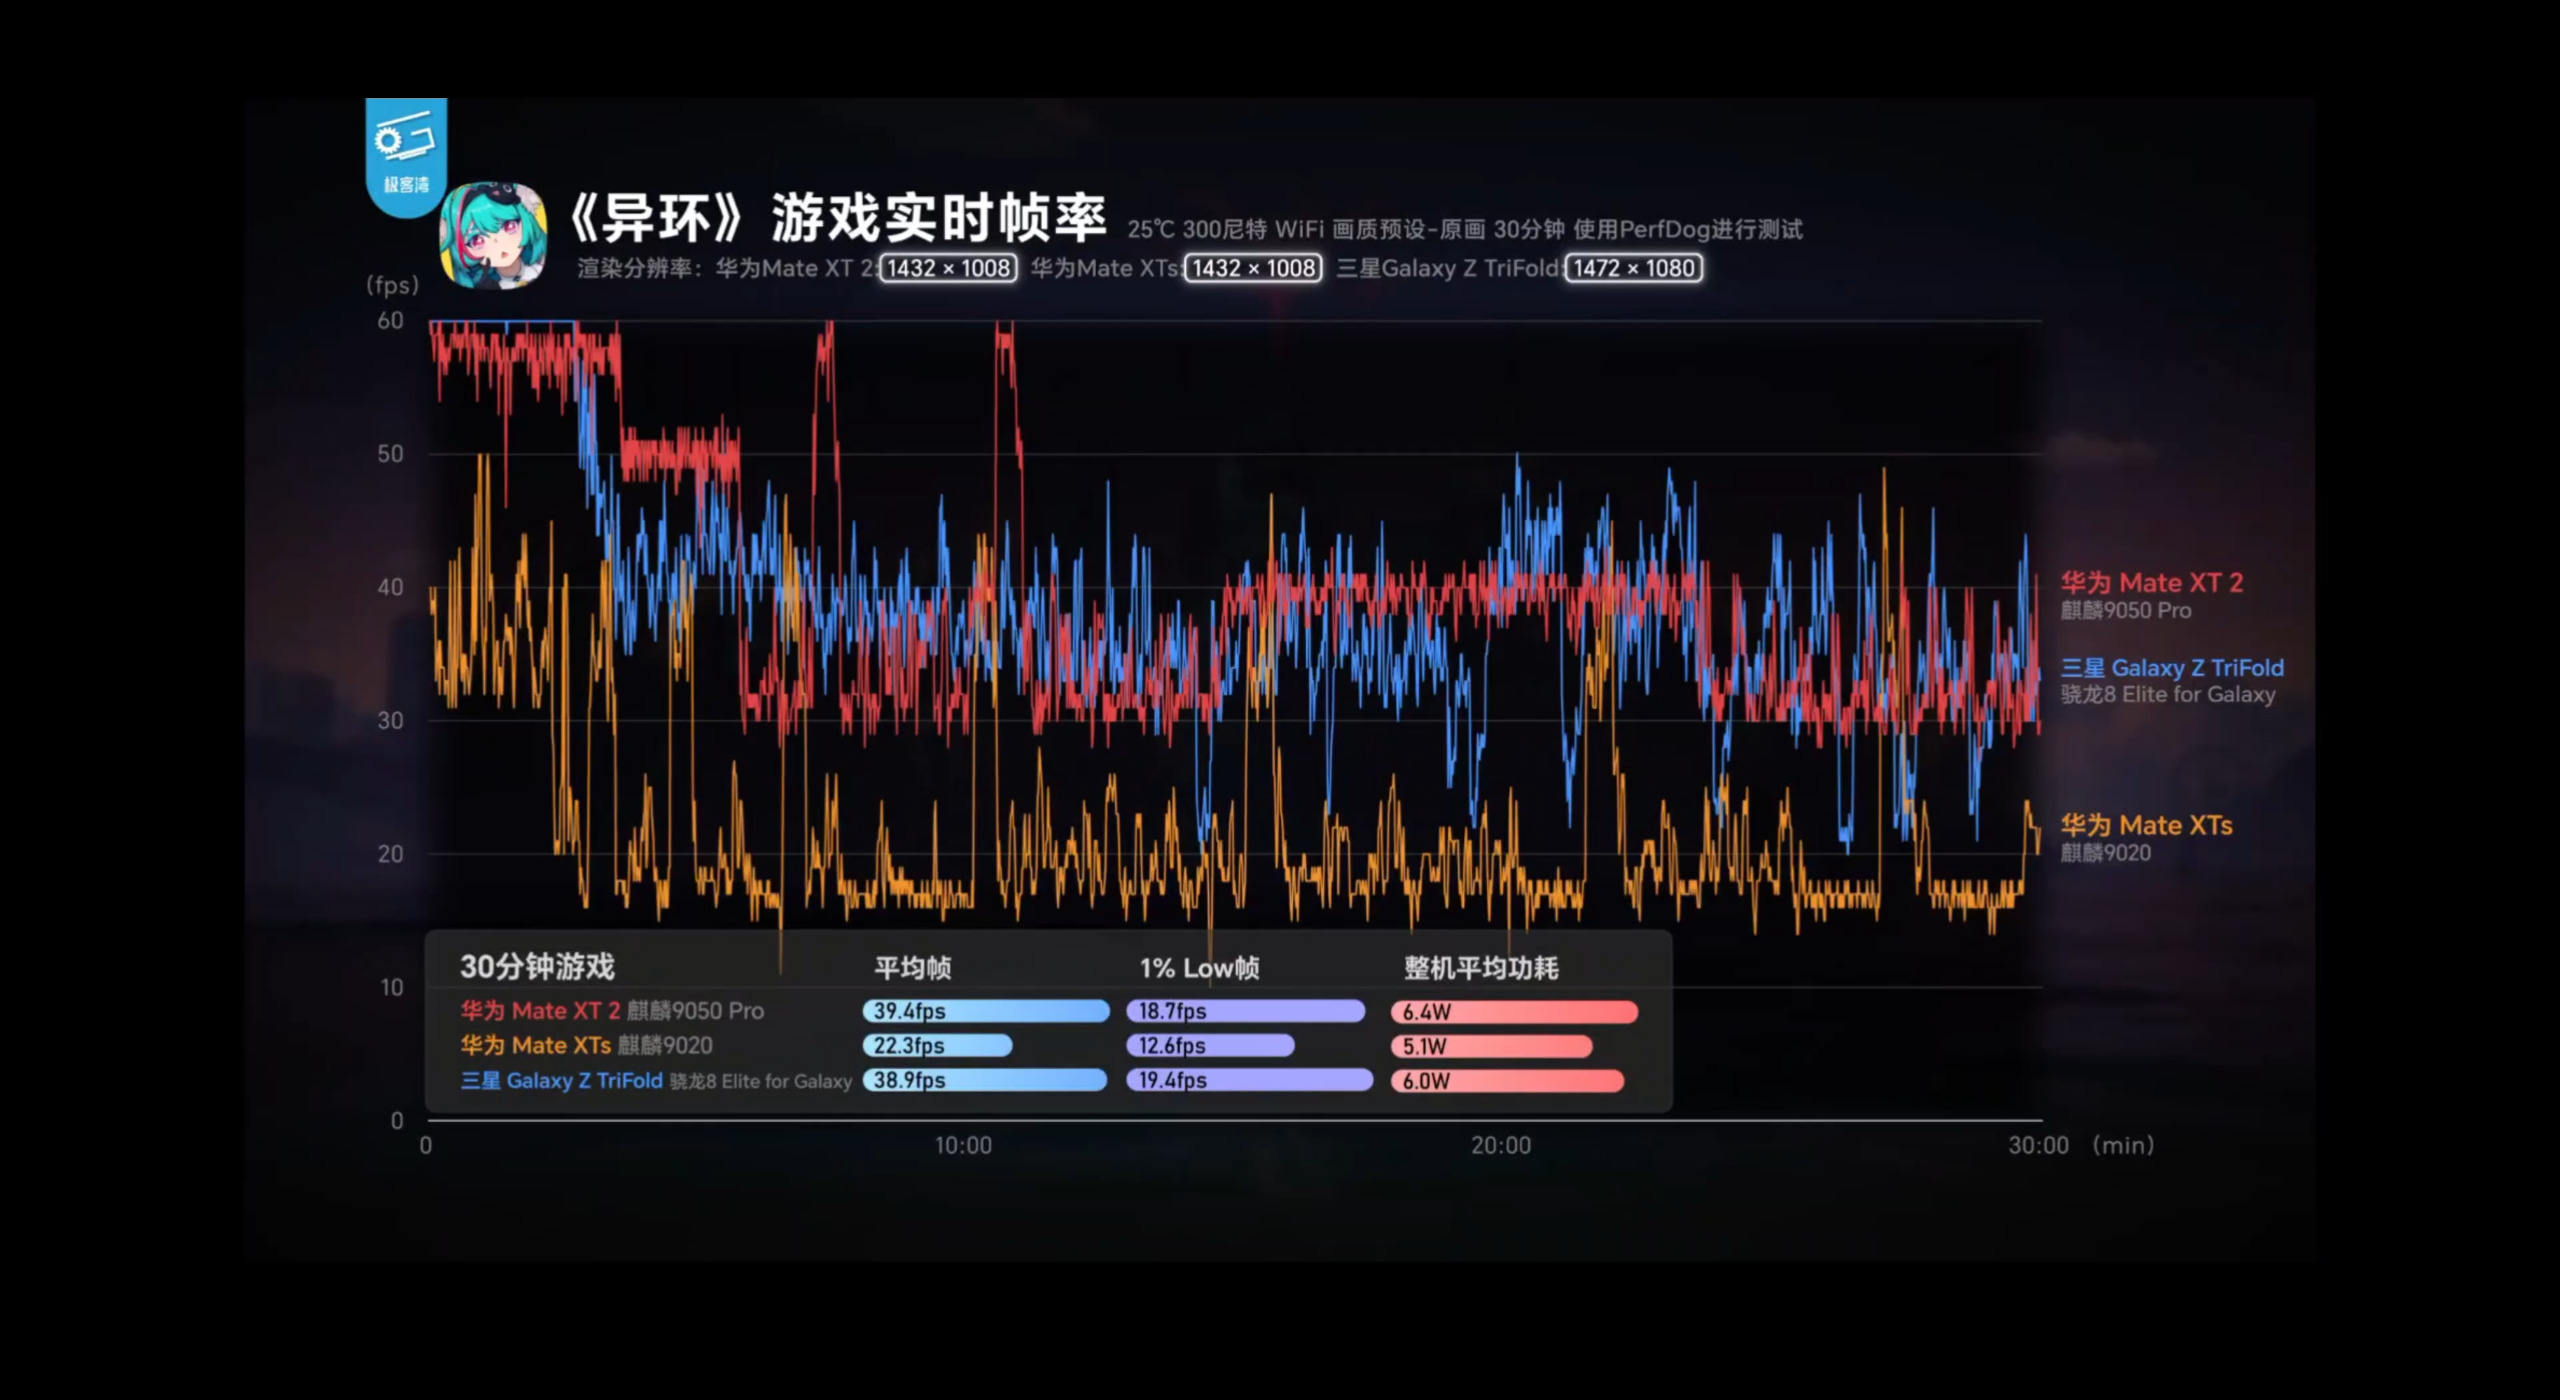
游戏部分统一测试条件:25℃ 环境、300 尼特亮度、WiFi 连接、30 分钟、PerfDog 采样。同场对比的三台都是折叠屏:华为 Mate XT 2(麒麟 9050 Pro)、华为 Mate XTs(麒麟 9020)、三星 Galaxy Z TriFold(骁龙 8 Elite for Galaxy)。
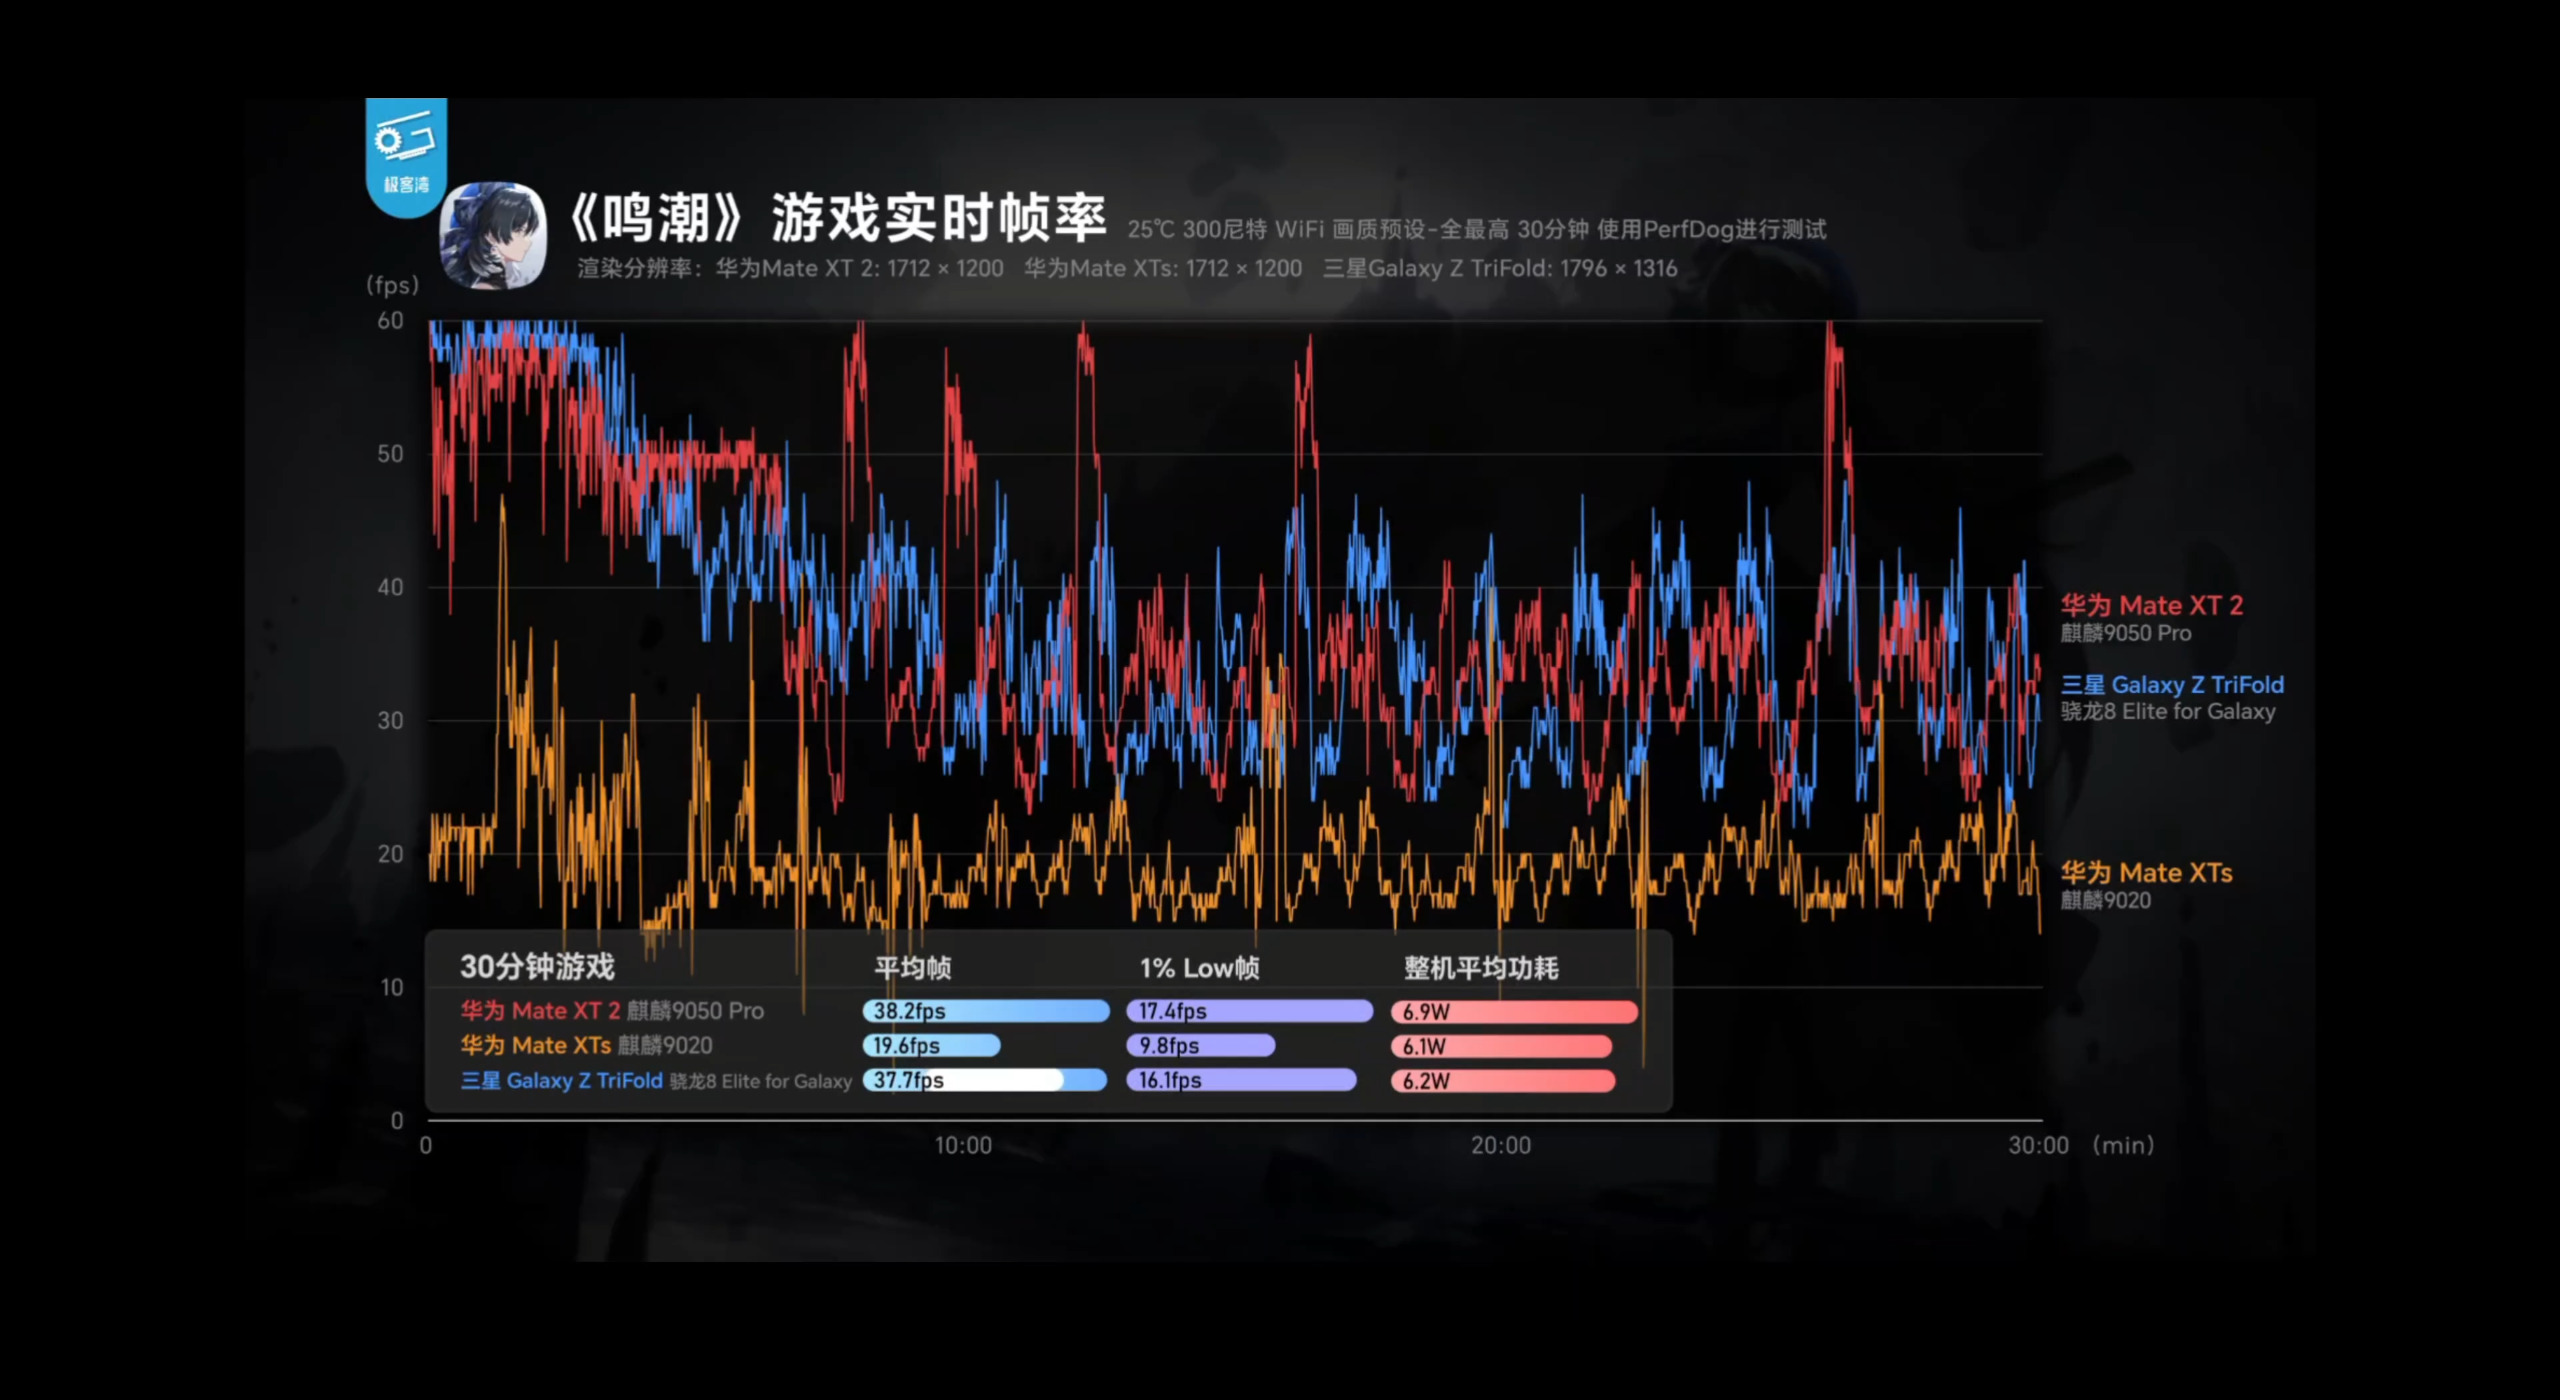
| 游戏 | 机型(SoC) | 平均帧 | 1% Low 帧 | 整机平均功耗 |
|---|---|---|---|---|
| 原神 | Mate XT 2(麒麟 9050 Pro) | 59.4 | 52.7 | 5.4W |
| 原神 | 三星 Z TriFold(骁龙 8 Elite for Galaxy) | 59.8 | 46.7 | 5.1W |
| 原神 | Mate XTs(麒麟 9020) | 35.1 | 12.6 | 5.5W |
| 异环 | Mate XT 2(麒麟 9050 Pro) | 39.4 | 15.7 | 5.4W |
| 异环 | 三星 Z TriFold(骁龙 8 Elite for Galaxy) | 38.9 | 17.4 | 6.0W |
| 异环 | Mate XTs(麒麟 9020) | 22.3 | 12.6 | 5.1W |
| 鸣潮 | Mate XT 2(麒麟 9050 Pro) | 38.2 | 17.4 | 5.9W |
| 鸣潮 | 三星 Z TriFold(骁龙 8 Elite for Galaxy) | 37.7 | 18.1 | 6.2W |
| 鸣潮 | Mate XTs(麒麟 9020) | 17.6 | 9.8 | 6.1W |
三款游戏读下来,有三个结论:
- 原神:几乎满帧,而且更稳。9050 Pro 平均帧 59.4,贴着 60 帧跑;关键是 1% Low 帧 52.7,明显好于骁龙 8 Elite for Galaxy 的 46.7——平均帧打平的同时,掉帧更少
- 异环 / 鸣潮:与骁龙 8 Elite for Galaxy 基本打平,功耗更低。异环 39.4 vs 38.9(功耗 5.4W vs 6.0W),鸣潮 38.2 vs 37.7(功耗 5.9W vs 6.2W)
- 上一代吃力明显。麒麟 9020 的 Mate XTs 在三款游戏里分别是 35.1 / 22.3 / 17.6 帧,与这一代不在一个量级
另外从帧率曲线能看出一点:9050 Pro 的曲线整体更平,尤其是鸣潮里三条线纠缠在一起的那段,它的波动幅度要比对手小——这与 CPU 侧"同性能功耗下降到 0.59"的论文数据是对得上的。
十、小结:频率回来了,但短板还是短板
- 规格:超大核回到 3.1GHz,大核拆成 2.7GHz 性能档与 2.2GHz 能效档,GPU 换成马良 955 @1050MHz,NPU INT8 从 27 提升到 67.7 TFLOPS
- 原理:逻辑折叠把同一级流水线的逻辑单元做双层垂直互联,路径变短、RC 延迟下降。论文数据是同性能功耗降到 0.59(-41%),代价是功耗密度 +5.6%、散热压力变大
- 实测:原神几乎满帧且 1% Low 帧更高;异环、鸣潮与骁龙 8 Elite for Galaxy 打平但平均功耗更低;CPU 能效曲线越过 A17 Pro
但有三件事需要保持清醒:一是 GPU 仍是短板,3DMark Steel Nomad Light 的 1378 分还没追上骁龙 8 Gen 3 和天玑 9300+;二是所有测试都跑在 4×16bit LPDDR5X 上,芯片支持的 LPDDR6 还没被用上;三是逻辑折叠这项技术最大的敌人是散热,而折叠屏机身的散热余量本来就比直板机更窄。数字很漂亮,但这些前提条件同样重要。
(文中跑分、能效曲线、游戏帧率等数据图均来自极客湾;逻辑折叠相关的电压、频率、功耗等参数引自 Sci China Inf Sci, 2026, 69(8): 183401 论文,已在文内逐张标注来源。)
Comments NOTHING