

上周被人从公众号后台捞进了一个十个人的群。群里除了我,剩下九个全是懒猫微服的人——客服、工程师、还有一个专门负责拉人的。开场白大意是:「这位是从公众号过来的老板,对 DeepSeek V4.1 Flash 本地部署比较感兴趣,辛苦给老板详细介绍一下。」
然后客服喊了我一声大佬,我回了个您好。接下来的四十分钟,是一段四十五秒的录屏,加上一顿讲解。
聊完我把资料翻了一遍。这台机器叫懒猫算力舱 X5,Thor 芯片,2070T 算力,128GB 内存,双11 到手 43999 元。同样 128GB 内存的 Mac 和显卡方案,五万块都下不来,纸面上看它确实还行。
但聊完我最大的感受不是「值」,是这东西能干的活比宣传页上写的窄得多。本地部署 AI 一直是企业的事,一台四万块的机器塞进家用场景,市场在哪,我按自己见过的和算得清的部分写。
先把结论摆出来
- 它的真实身份,是英伟达 Jetson AGX Thor 开发者套件的整机版。官方套件 3499 美元,模组型号 T5000。多出来的钱买的是机身、散热、盘位、系统,以及三年后还有人接你电话。
- 128GB 统一内存是它唯一不可替代的东西,273GB/s 的带宽是它唯一绕不过去的天花板。别指望它比云快,它只保证两件事:不用联网,数据不出门。
- 对个人用户和中小工作室,绝大多数情况下不该买。按现在国产模型的 API 价,四万块够你按每天十万字的强度写到这台机器报废。
- 真正会掏钱的只有四类人:被保密协议卡住的、被平台封过号的、要在没网的地方跑的、要交付给客户的。剩下的人买了大概率在吃灰。
- 短板不在算力也不在价格,在 Arm64 的软件生态和厂商的寿命。前一个问题能靠时间熬,后一个问题只能靠运气。这是我唯一犹豫的地方。
另外有个细节我在群里问得比较直接:这东西为什么不挂到京东自营,非要在微信群里一对一聊?客服的回答大意是目标客户少、每个人要配的模型不一样。翻译过来就是,买的人不多,需求又各不相同,标准化的货架页卖不动。这个销售方式本身,比任何一页参数表都更能说明它面向谁。
它其实是一块机器人板子,外面套了个壳
先把血统说清楚,因为这决定了它能干什么、不能干什么。X5 的核心是英伟达的 Jetson T5000 模组,属于 Thor 系列。这块板子在英伟达那边的正式定位是「物理 AI 与机器人计算平台」,2025 年 8 月发布,开发者套件官方价 3499 美元,明确写着面向人形机器人、工业机械臂、医疗辅助机器人这类场景。
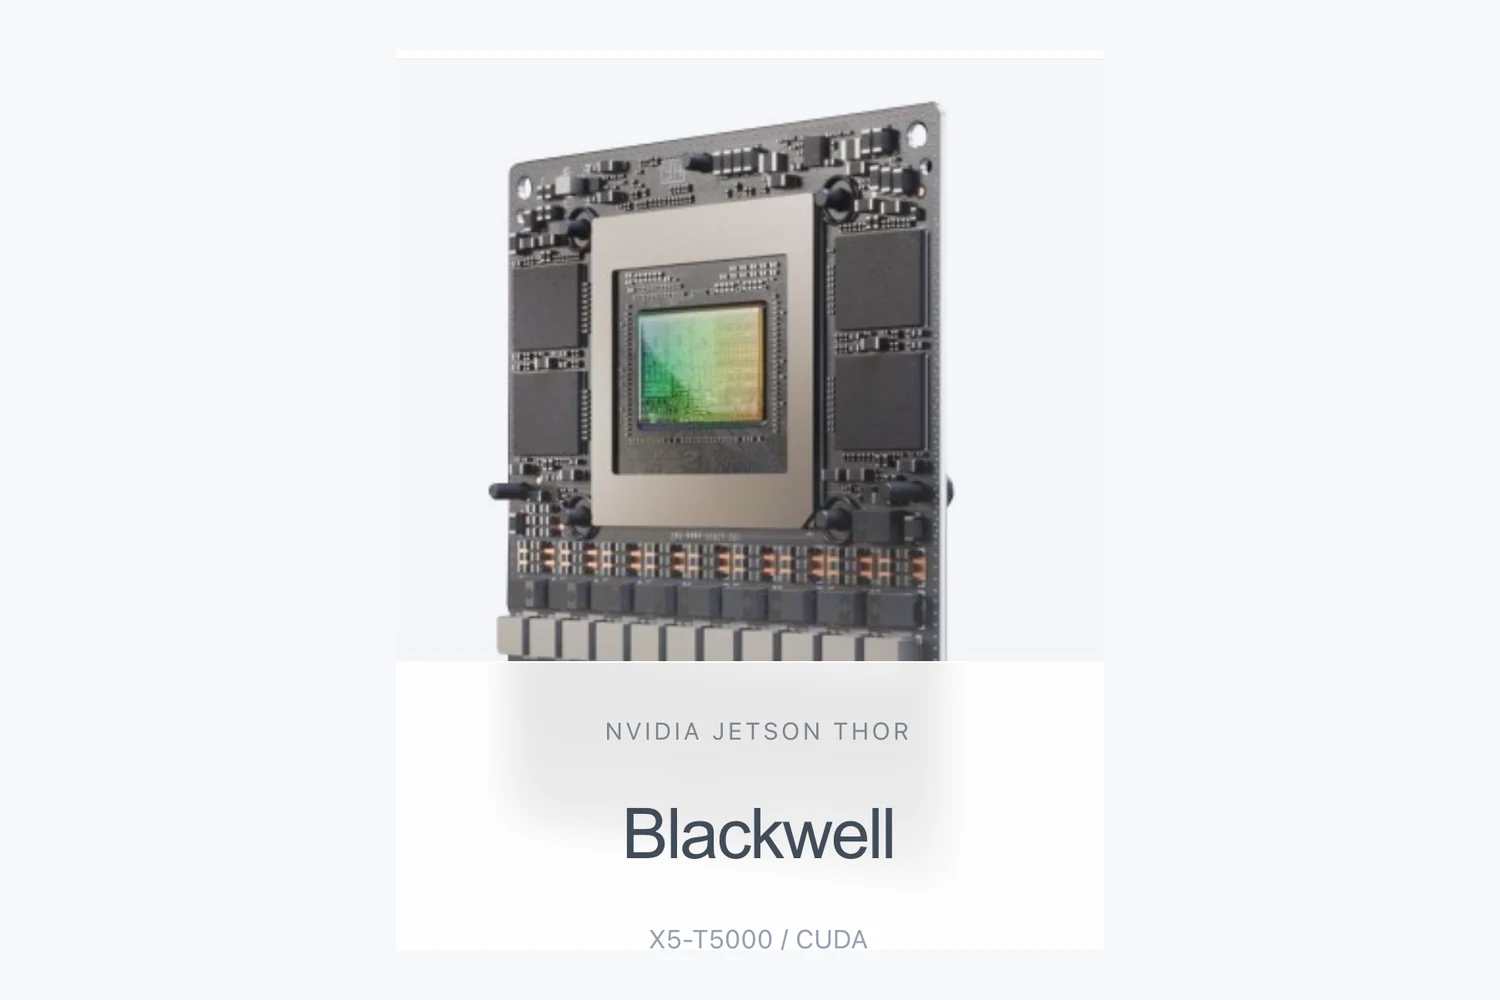
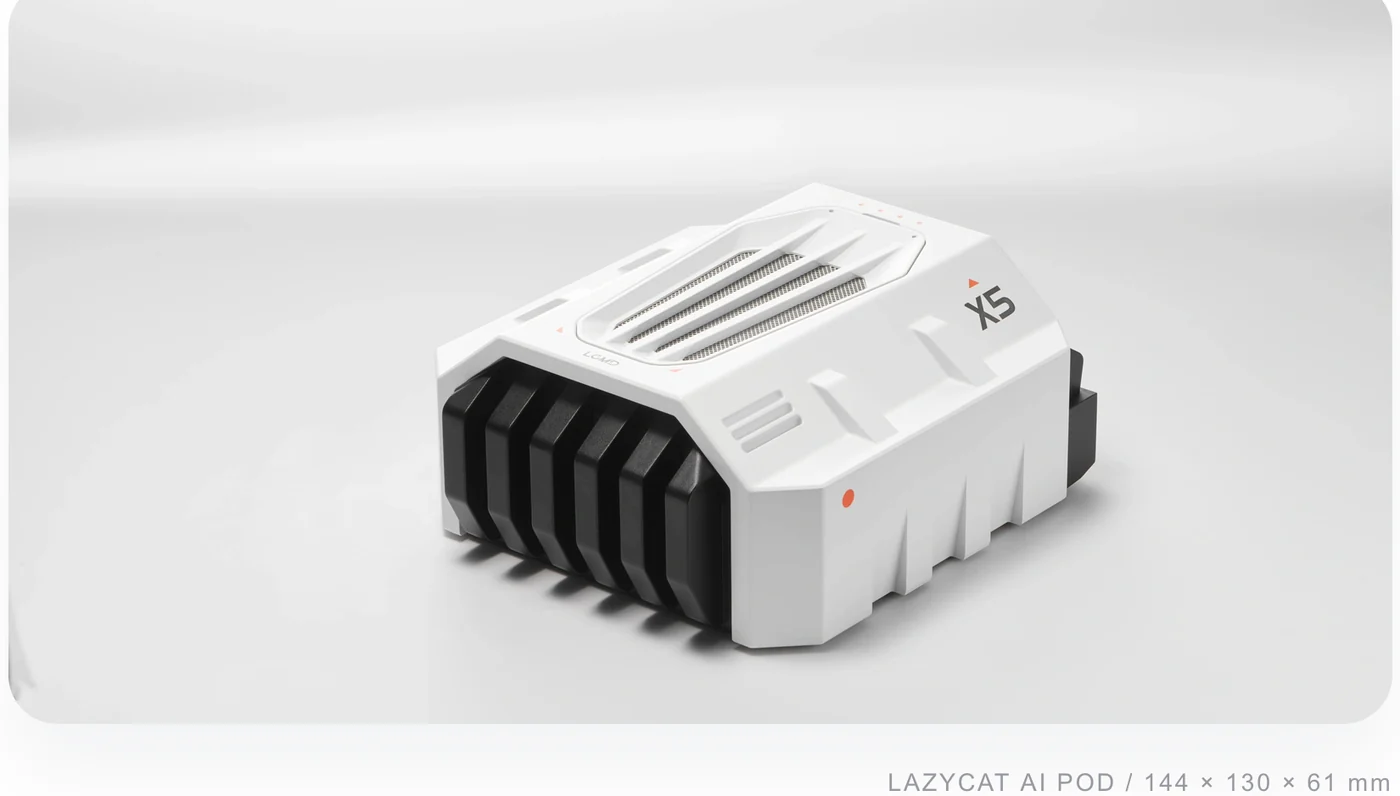
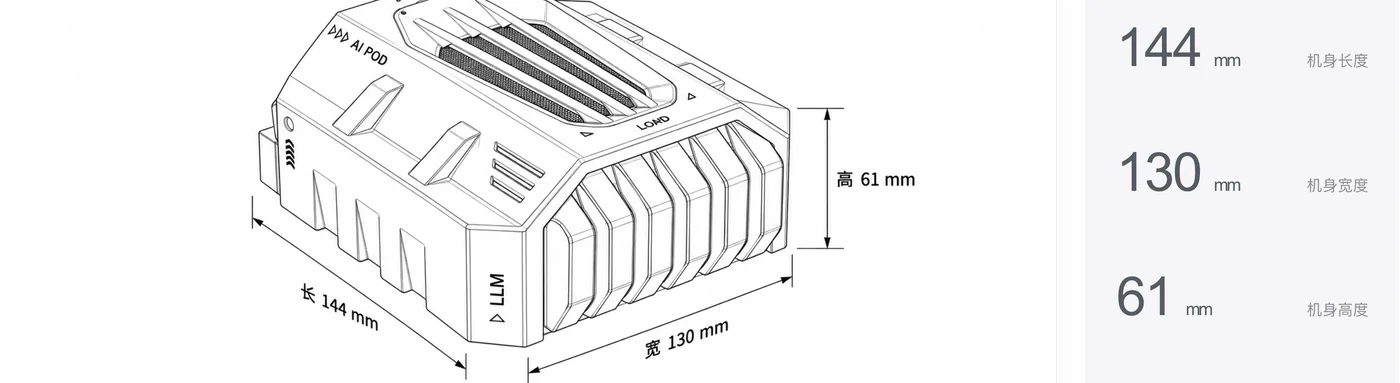
也就是说,它原本不是给坐在电脑前聊天的人准备的。懒猫做的事是把模组塞进 144×130×61 毫米、2.3 公斤的铝合金壳子,配好散热和两个 M.2 盘位,装好系统,再套一层自家图形界面。这个活在业内叫整机化,听起来不酷,但对不想折腾的人价值很大。
我第一反应是这尺寸不像服务器,像个被压扁的 NUC。144 毫米什么概念,一张 A6 明信片横过来。所以它真能放在书架上,不用单独腾个机柜。
| 项目 | 规格 | 备注 |
|---|---|---|
| 型号 | X5-T5000(Jetson T5000 / Thor) | 官方称「LYCAT AI POD」 |
| AI 算力 | 2070 TFLOPS(FP4 稀疏)/1035 TFLOPS(FP8) | 稀疏口径,别当稠密算力看 |
| GPU | 2560 核 Blackwell,96 个第五代 Tensor Core | 支持 MIG 切分 |
| CPU | 14 核 Arm Neoverse-V3AE,最高 2.6GHz | Arm64 架构,不是 x86 |
| 内存 | 128GB LPDDR5X,273GB/s,CPU/GPU 共享 | 统一内存,不是显存 |
| 存储 | 2×M.2,单盘最大 32TB | 盘要自己买 |
| 网络 | 万兆 RJ45、QSFP28 100Gbps、Wi-Fi 6E | QSFP28 用来双机串联 |
| 视频 | HDMI 2.1(8K60)、2×USB-C 10Gbps | 接显示器就是台 AI 电脑 |
| 功耗 | 40–130W 可配 | 满载一天三度电上下 |
| 系统 | 预装 Ubuntu 24.04(Arm64)+ CUDA | 软件生态的麻烦从这里开始 |
表里有两行值得单独讲。一是功耗 40 到 130W,满载一天三度电,一年电费六百块左右。这个数字比一张显卡低一个量级,意味着它可以 7×24 开着——「一直在线」这件事,对本地部署来说比峰值性能重要,因为你要跑的是随时在的 Agent,不是偶尔跑一次的批处理。
二是「统一内存」这四个字。128GB 不是显存加内存的总和,是 GPU 和 CPU 抢同一块。好处是模型能装到 128GB 的池子里,坏处是系统、权重、KV 缓存、你开的浏览器全在抢这 128GB,官方 FAQ 里自己也承认这一点。真实可用大概一百出头,跑 70B 级别的 INT8 模型没什么富余。
双11 三档价,差价买的到底是什么
活动给了三个组合,我按差价重新算了一遍,这个角度看比看原价清楚。
| 组合 | 配置 | 原价 | 到手 | 比单机多花 |
|---|---|---|---|---|
| 活动 1 | 算力舱单机 | 47199 | 43999 | — |
| 活动 2 | 算力舱 + 私有云(16GB/2TB) | 52698 | 48399 | +4400 |
| 活动 3 | 算力舱 + 私有云(48GB/2TB) | 55998 | 50999 | +7000 |
按这个差价,第三档其实是最划算的一档:比第二档多花 2600 块,内存从 16GB 涨到 48GB。16GB 的私有云能装什么,说实话装不了什么,跑个网盘加两个小服务就见底了。如果一定要选,要么买最便宜的单机,要么直接上 48GB 那档,中间那档最尴尬。
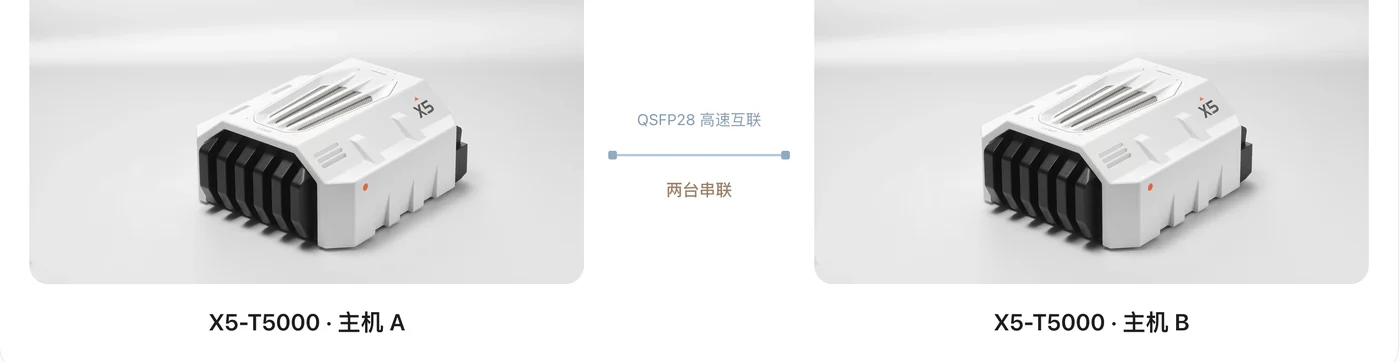
再说私有云这个东西本身。LC03 的定位是文件存储、图形界面入口和远程访问,带 P2P 内网穿透,作用是让你人在外面也能连回家里的算力舱。这个组合在逻辑上说得通——算力舱不该长在工位上,它应该蹲在家里某个角落,你在笔记本上连它。
但换个角度想:你已经有 NAS 了,这一项对你就是重复购买;你没有 NAS,一台两千块的家用 NAS 加 Tailscale 也能干同样的事。它真正值钱的地方是和算力舱打通的那层界面,不用自己配端口映射、不用管证书。这是一笔典型的「花钱买省事」,不是花钱买性能。
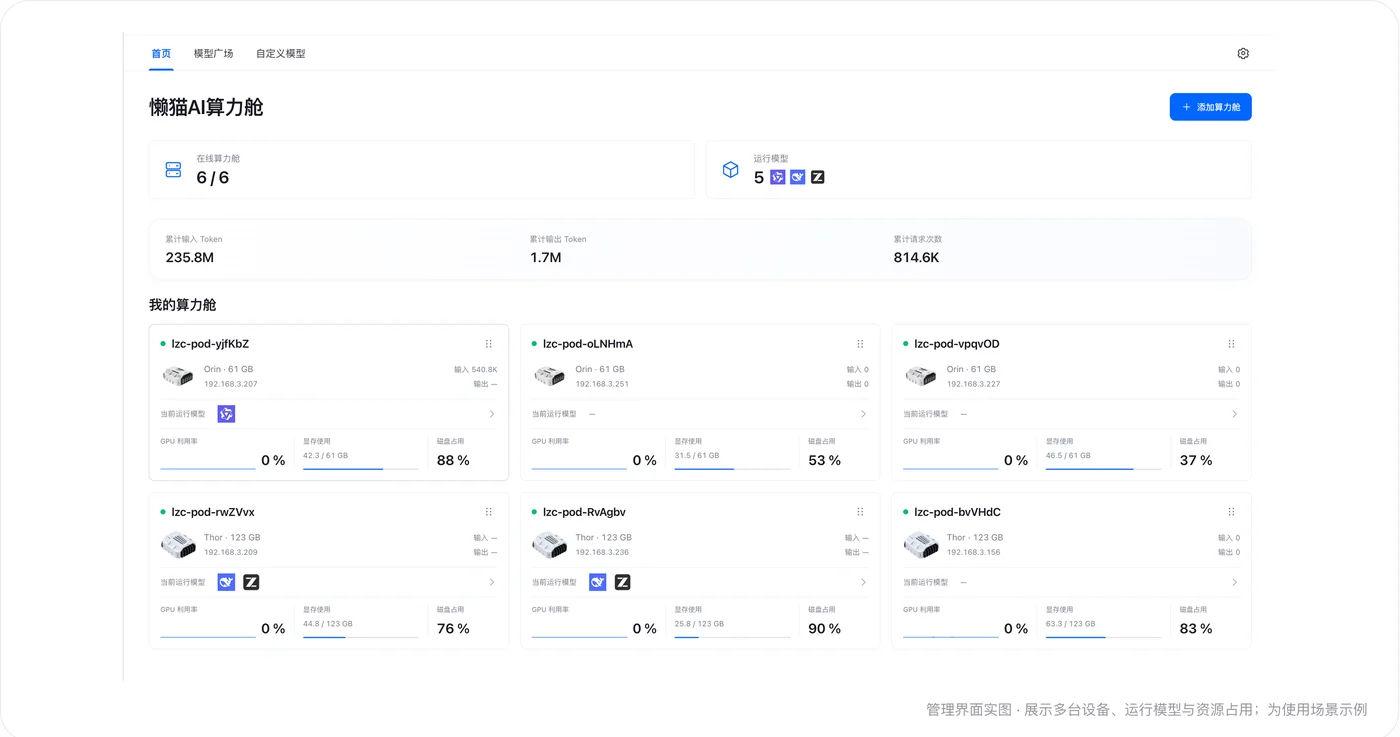
另外两个促销话术我得提一句:限量 11 台,和小程序下单送一台 AI 摄像头。限量这件事在四万块的价位上没有意义,这个量级本来就是一对一的销售;摄像头是个小配件,不值得为它改变购买渠道。促销只影响你什么时候下单,不影响你该不该下单。
76 TPS 是什么水平?
官方给了两组数,我先原样贴出来,再说人话。
- Qwen3 8B 这一档小模型,单机:单流 61.28 TPS,8 并发合计 218.28 TPS
- DeepSeek V4.1 Flash,两台串联:单流 76 TPS,8 并发合计 177.49 TPS
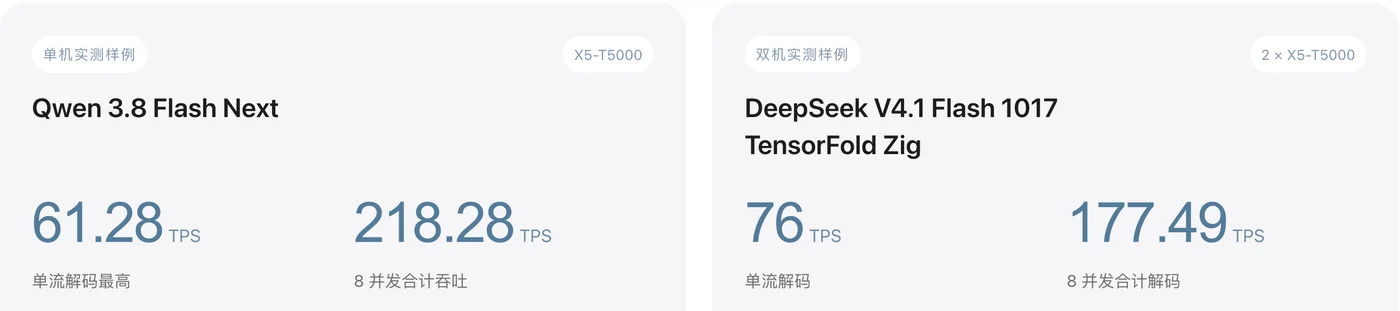
这两组数我一开始以为是同一台机器跑的两个模型,直到把官方页面那张卡片放大才看明白:左边那张标的是「单机实测样例 · X5-T5000」,右边那张标的是「双机实测样例 · 2×X5-T5000」。76 TPS 是两台机器串起来跑出来的,正文里没提,字全藏在标签上。
这个细节很重要,因为它把「四万块能不能跑 DeepSeek」这个问题,变成了「你得先买两台,八万八」。单机跑同一个模型会掉到多少,官方没给数,我也不替它算。
TPS 是每秒 token 数,中文大概一个 token 对应一到两个字。所以 76 TPS 就是每秒五十到七十个汉字,比人阅读速度快一倍多。这个体感跟云端大模型差不多,云端通常在 30 到 80 TPS 之间晃,不会让你觉得慢。
真正有问题的是并发那一栏。8 并发合计 177 TPS,除下来每个人 22 TPS,只有单人时的三分之一。这说明什么?它是一台单人机器。你一个人用很流畅,两个人同时提问开始等,四个人一起上就回到了几年前的感觉。
原因在带宽,不在算力。生成 token 的过程要反复把权重从内存里读一遍,273GB/s 就那么多,模型越大,每个 token 要读的字节越多,速度就越慢。我按这个逻辑反推了一下:76 TPS 意味着每生成一个 token 平均只读了 3.6GB 权重,折算下来激活参数只有几个 B 的量级,而且是激进量化过的。所以它跑的不是全精度原模型,这一点别被「DeepSeek V4.1 Flash」这个大名头唬住。这个数是我自己拿带宽除的,官方没给模型的具体配置,只能当参考。
还有个指标容易被忽略:上下文一长,速度就掉。因为 KV 缓存也要占内存,还要跟着每一步生成读一遍,你把上下文从 4K 拉到 64K,同样的模型能慢掉三成以上,这是在所有本地部署方案上都成立的事,不是这台机器的毛病。所以你看到的所有 TPS 数字,都要先问一句:上下文多长、几个人一起用。不带条件的跑分,基本只有广告价值。
顺便说,官方页面那张「模型实测」的截图,我数了一下有五十多个模型,从 Qwen、DeepSeek、GLM 到各种多模态。这张图的说服力在于「能跑起来」,不在于「跑得多好」。128GB 的内存能装下大部分开源模型,但能装下和能当生产用,是两码事。
谁会真的掏这四万块
这是我最想写的一节,也是标题里那个「适合谁」的答案。我把自己见过的、聊过的整理成四类,每一类都给一个能算的数。
第一类,被保密条款卡住的人。律所处理卷宗、医院处理病历、设计公司接甲方的未发布产品、财务公司看客户的原始数据。这些场景的共同点不是技术难,是「数据出不了门」这条硬规定——甲方合同里写一句「不得上传至第三方平台」,云端方案当场出局。这类人不缺钱,缺的是一个能盖章的采购单。
第二类,被平台封过号的人。这一类数量比第一类多得多,但没人会在群里说。内容审核是一道黑箱,你做的东西可能在某个环节被判违规,账号一封,接口一断,之前跑了大半年的流程当场作废。本地部署解决的不是能力问题,是可持续性问题。它的价值不在「能做云端不让做的事」,在「云端允许你做的事不会突然不让你做」。之前拆过一份流出的AI 中转站站长内部文档,里面最刺眼的一句就是账号池的封禁率——对做长期项目的人来说,这个概率不是风险,是成本。
第三类,要在没网的地方跑的人。工厂产线的边缘质检、野外的设备巡检、展会现场的演示、车里的离线助手。这类场景里,插一张 4090 的台式机根本不成立:现场没有稳定电源,也没有机柜给它,更没人愿意为一次巡检去租云主机。40W 到 130W、2.3 公斤、塞进设备柜就能跑,这几个参数在这类场景里比算力重要得多。
第四类,要交付给客户的集成商。给医院做一套影像预筛系统,给学校做一个本地知识库,给企业做一个内网助手。他们买的不是算力,是「一个能装箱发走的标准件」。自己攒一台 4090 主机也能跑,但客户那边出了问题,你得解释显卡驱动、电源、散热、系统四层东西;整机只解释一层。
四类人有个共同的判断标准:你愿不愿意为「确定性」付溢价。愿意,这台机器就值;不愿意,它就是个贵的玩具。
官方页面不会写的特殊需求清单
下面这段是我聊完之后的私人判断,下面是一些特殊场景和用户的需求,主要集中在一下传统模型无法输出的地方:
安全测试、渗透、漏洞验证、恶意代码分析、软件逆向、外挂研究……这一整条线上的工作,用到模型的时候会遇到同一个墙:厂商的接口会先审一遍你的输入,然后再决定回不回你。写得含糊它拒答,写得明确它封号,而且封的是账号不是请求。对做这类工作的人来说,本地部署不是升级,是把脖子从别人手里抽回来。
还有一类是内容本身过不了审的,包括成人内容、某些题材的写作、某些化学品和工艺的资料整理。我不打算讨论这些事该不该存在,那是另一个层面的问题;我只说市场事实:这类需求真实存在,而且付费意愿极高,因为它没有替代方案。
但这里有一条线必须说清楚。买机器规避的是平台的条款,不是法律。平台封号是商业行为,法律后果是另一回事,四万块买不到豁免权。之前写过一篇从提示词注入到权重消融的六个层次,讲的就是这类事的技术边界——越往下走,越不是「技巧」,是「你愿不愿意承担后果」。
顺带说一句实在话:如果你只是想试试破甲、看看模型会不会松口,租一台按小时计费的云 GPU 更合适,几十块钱能玩一晚上,没必要为好奇心买四万块的东西。
买之前,我替你们把六个问题问了一遍
官方 FAQ 里那六条,我逐条对着问过一遍,答案我认,但每一条后面都想补一句自己的判断。
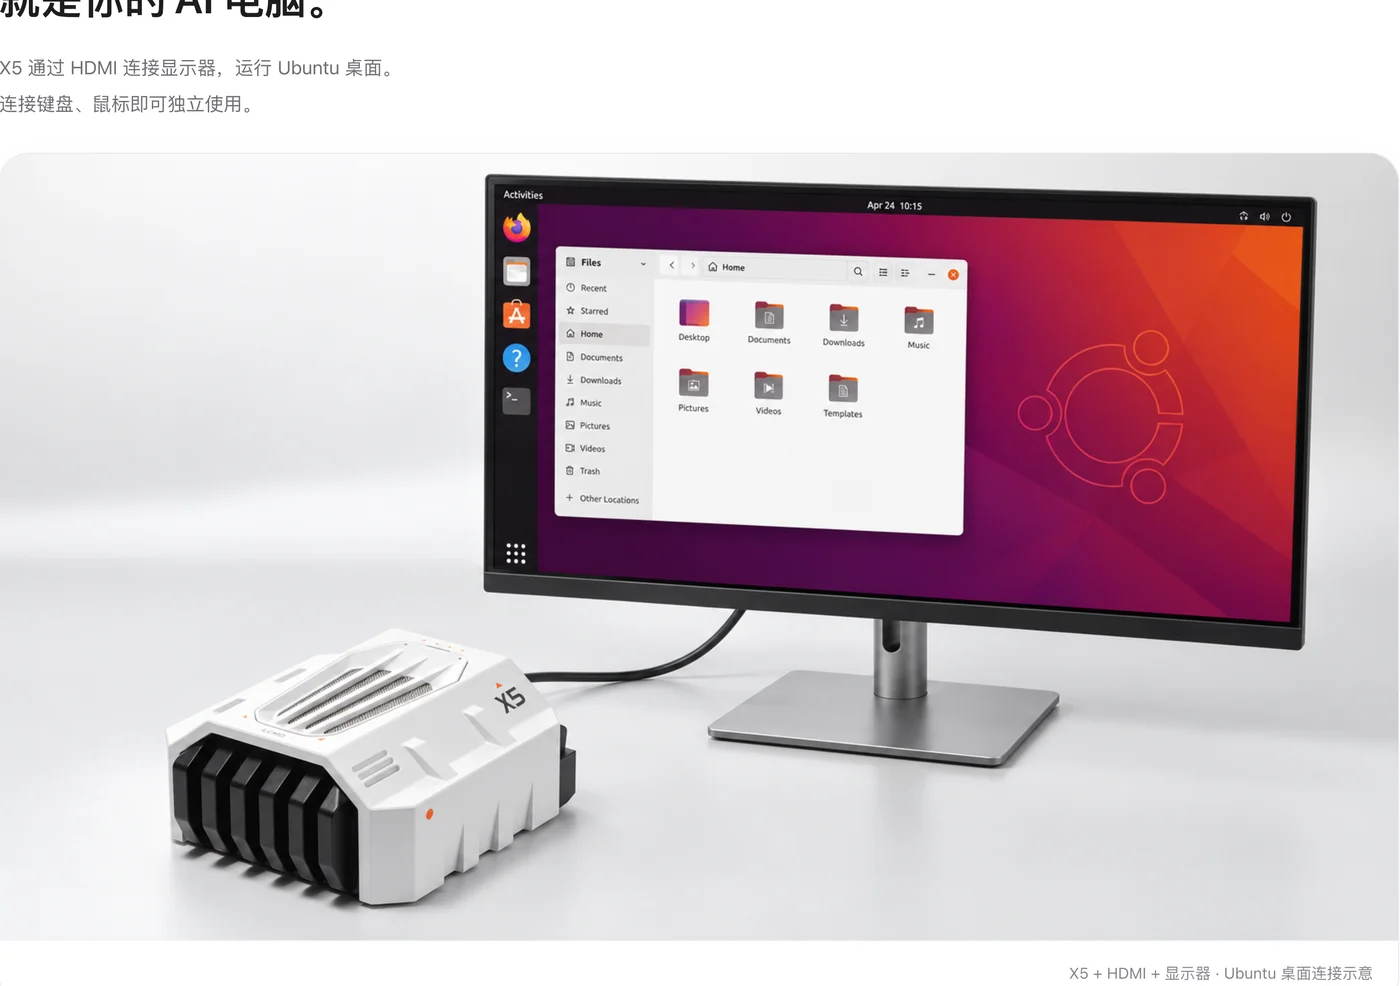
只买算力舱,不买私有云,能独立用吗?能。接上显示器和键鼠,它就是一台跑 Ubuntu 桌面的 AI 电脑,装 Ollama、ComfyUI、Jupyter 都行,独立办公完全够。但你要接受两件事:它在局域网里,出门连不上;所有应用得自己一个个装,没有那个图形化面板帮你管。想省这两个麻烦,就得上私有云——所以私有云卖的不是存储,是「出门能连」和「不用敲命令」。
算力舱和懒猫微服是同一个东西吗?不是,是两件互补的硬件。微服管存储、管入口、管你那堆文件和服务的收纳,算力舱只管算力。官方那个比喻我觉得挺准:微服负责把应用装起来,算力舱负责把模型跑起来,两边分工,谁也替不了谁。
128GB 都能拿来装全量模型吗?不能,这是最容易被参数表误导的一条。128GB 是 CPU 和 GPU 共享的统一内存,系统要占、运行时(CUDA、TensorRT、容器)要占、上下文越长 KV 缓存越大,模型权重只是其中一块。按经验,能留给权重的部分大概一百出头,跑 70B 的 INT8 刚好卡在边缘,跑 120B 只能上 4bit 量化。这个数字官方没给,是我的估算。
想跑 DeepSeek 这种大模型,怎么选?官方的建议是先定模型和量化格式,再决定单机还是双机。顺序是对的:先想清楚你跑 671B 的哪一档量化,需不需要长上下文,几个人同时用,这些都想明白,配置自然就定了。反过来先买机器再找模型,八成会买到一台「能跑但很慢」的机器。
已经有 Mac 或者 Windows 电脑了,还需要它吗?官方答得很克制:看你需不需要本地模型推理。我把这句话展开一下——你现有的电脑如果有 24GB 以上显存的独显,跑 7B 到 32B 的模型体验不会差太多,缺的只是「大模型装得下」和「一直开着不心疼电费」这两点。这两点对你重要就买,不重要就不买,跟你手上已经有几台电脑没关系。
AI 请求会不会发到外网?本地推理不出门,但联网搜索、第三方 API 调用、模型下载这些会出去。这条我觉得写得很实在,很多宣传页会把「本地部署」说成「绝对离线」,实际上你自己装个联网搜索插件,数据就出去了。真正的离线要靠自己把出口关掉,不是靠买一台机器。
三个短板,一个比一个难解决
第一个是高精度算力。2070T 这个数字很唬人,但它是 FP4 稀疏口径,稠密 FP4 要打个折,到了 FP16/BF16 更是另一回事。算这个要看 CUDA 核数:X5 是 2560 个,DGX Spark 是 6144 个。纸面 AI 峰值它反而更高(2070 对 1000,都是稀疏口径),但真到微调、训练、高精度推理这些场景,核少就是慢,这个差距没法靠软件补。
官方页面其实很诚实,它写的是「模型部署、应用与适配」,不是「训练」。这中间的差别,做过的人一看就懂。
第二个是 Arm64 生态,这个比算力麻烦得多。你在 x86 上一句 pip install 就完事的东西,在这台机器上可能要现场编译,编译失败还要去找 aarch64 的轮子。Docker 镜像同理,GitHub 上大部分项目的默认镜像只有 amd64 版本,你得自己 build,或者找第三方的多架构版本。这不是懒猫的问题,是所有 Jetson 的通病,英伟达自己也知道,所以搞了 NGC 那套预编译容器。
第三个是厂商寿命,这是我最在意的。四万块里有一部分钱,买的是「三年后还有人给你推固件」。懒猫原来做微服(小主机加私有云)起家,算力舱是它的第二条产品线,销量未知、迭代节奏未知。如果哪天这条线不做了,硬件还能当开发板用——NVIDIA 的 JetPack 一直在——但壳子里的图形界面、内网穿透、应用商店就没人管了。
这事没法定量评估,只能自己判断。我的做法是把它当成一笔五年折旧的采购,而不是一次消费:五万块摊到五年,一年一万,一个月八百多。这个价钱租云 GPU 能租到更好的卡,但你租不到「数据不出门」。
同样四万块,还有别的选择
把候选都摆在桌上,比一个个讲清楚更省事。
| 方案 | 大约价格 | 强在哪 | 弱在哪 |
|---|---|---|---|
| 懒猫 X5(就是这台) | 43999 起 | 128GB 统一内存、130W、整机开箱即用、有人管 | Arm64 生态、厂商寿命未知 |
| DGX Spark 128GB | 京东第三方挂 45999,历史低价见过 29999 | DGX OS + NGC 全家桶,CUDA 生态最顺,6144 核 | 体积大、功耗高(整机 200W 以上,估算)、国内渠道乱 |
| 自攒 RTX 5090 主机 | 3 万上下(看卡价) | 微调最快、生态最熟、随时换件 | 显存只有 32GB,70B 级别模型塞不进去 |
| Mac Studio 大内存版 | 3 万到 7 万,看内存档位 | 安静、省电、带宽高、能当主力机 | 没有 CUDA,很多训练框架跑不了 |
| 云 API / 按小时租卡 | 几十到几千 | 便宜、随时升级、零维护 | 数据出门、随时可能被停、长期成本高 |
这张表里最有意思的是 DGX Spark。它在国内的价格很乱,官方渠道和第三方店铺能差一万五,历史低价记录到过 29999。如果你不介意渠道风险,它在软件生态上确实比这台顺——DGX 那套 OS、NGC 容器、TensorRT-LLM 全都现成,代价是体积、功耗和售后。
没有一台是全能,选的是你愿意牺牲哪一项。牺牲显存换内存,牺牲生态换功耗,牺牲自由度换省心,三选一,看你最不能忍哪个。
什么情况下我会劝你别买
这段是给还没下单的人看的,四条,中一条就别买。
- 你只是想用大模型写东西、修图、写代码。打开网页或者装个客户端就行,四万块省下来能干很多事。你现在缺的不是算力,是把活干完的耐心。
- 你想「学一学本地部署」。二手 3090 加一台旧主机,五千块能学到的东西一样多,学完不喜欢还能卖掉。上来就四万,学不动的时候退不掉。
- 你想跑 70B 以上的稠密模型还要求速度。273GB/s 的带宽摆在那,一台不够。官方给了两台串联跑 DeepSeek V4.1 Flash 的 76 TPS,但没说那两台合并之后可用内存是多少、用的哪一档量化,也没给单机跑同一个模型的数字——缺的正是最该有的那个数。
- 公司采购,但没人会 Linux。这台机器预装的是 Ubuntu,没有 Windows,日常维护要敲命令。谁买谁维护,别指望 IT 部门。
反过来,如果你已经能一句话说清「我买它是为了跑哪个模型、给谁用、为什么不能上云」,那这个价该出手就出手。双11 的降幅是真实的 3200 块,下一波不知道什么时候。
要不要等明年
后台和群里都有人问同一句话:现在买还是再等等。我给不出准确答案,但可以把这个判断拆开。
先说说不利的一面。Thor 这代模组刚上市一年多,价格由英伟达定,短期内没有松口的理由;128GB LPDDR5X 的成本今年还在往上走,我在内存那篇里算过,这轮涨价至少延续到明年上半年。所以「明年同样的东西便宜一万」这种期待,概率不大。
再说有利的一面。这类机器的价格从来不是被成本压下来的,是被竞品压下来的——等第二家、第三家做出同样的方案,溢价自然就没了,这个过程在 NAS 上走过一遍,在小主机上也走过一遍,我猜算力舱会走第三遍。你要等的不是时间,是第二个玩家。
还有一个变量是政策。今年各地对「人工智能+」的补贴口径不一样,企业采购能不能算进技改、能不能开专票、能不能走科研经费,这些对一家公司来说比降价一千块重要得多。个人买家就不用想了,这块跟你没关系。
写到这儿
回头看,这台机器的定位其实很清楚:它不是给个人用户的性能玩具,是给一小撮人的合规工具。128GB 内存、130W 功耗、能塞进书架、开箱能跑,这四个条件同时满足的机器,市面上不多。但它也就值这四个条件,别的都别多想。
如果你正在犹豫,我的建议是先花两百块租一天云 GPU,把你要跑的模型真跑一遍,看看输出质量是不是你要的。模型不行,换什么机器都没用;模型行,再回来算这笔账。
四万块买的不是算力,是「不用联网的确定性」。确定性这东西,等你真的需要它的时候,价格就不重要了;你还没需要它的时候,它就是个很贵的念想。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING