



三十块钱一个月,官方价的一折,GPT 和 Claude 随便调。
第一周用得挺顺。第二周开始觉得它答得敷衍,同一个问题问两遍,第二遍明显更糊。你去问客服,客服说是高峰期限流,让你晚点再试。你信了一半,另一半没处问,就这么接着用了。
这段时间网上流传出一份文档,据说是某个中转站运营方内部的决策记录。看完之后,那「另一半」大概能对上号了。
文档不长,写得极直白,没什么技术术语,通篇都是「怎么让用户查不出来」的具体做法。下面把它拆开讲,顺便把里面没写的部分补上。
一、你的请求,先到谁手里
海外 API 有三道门槛:海外信用卡、海外网络、美元结算。国内大部分人卡在这三步上。中转站干的活就是把三道门槛一次性拆掉——人民币充值、国内直连、一个 key 调遍所有模型。
技术上它没什么秘密。你的请求不再发往 api.openai.com,而是发往它的域名,它收到之后用自己的账号向上游发一遍,拿到结果再吐给你。中间多了一跳 HTTP。
问题就在这一跳上。
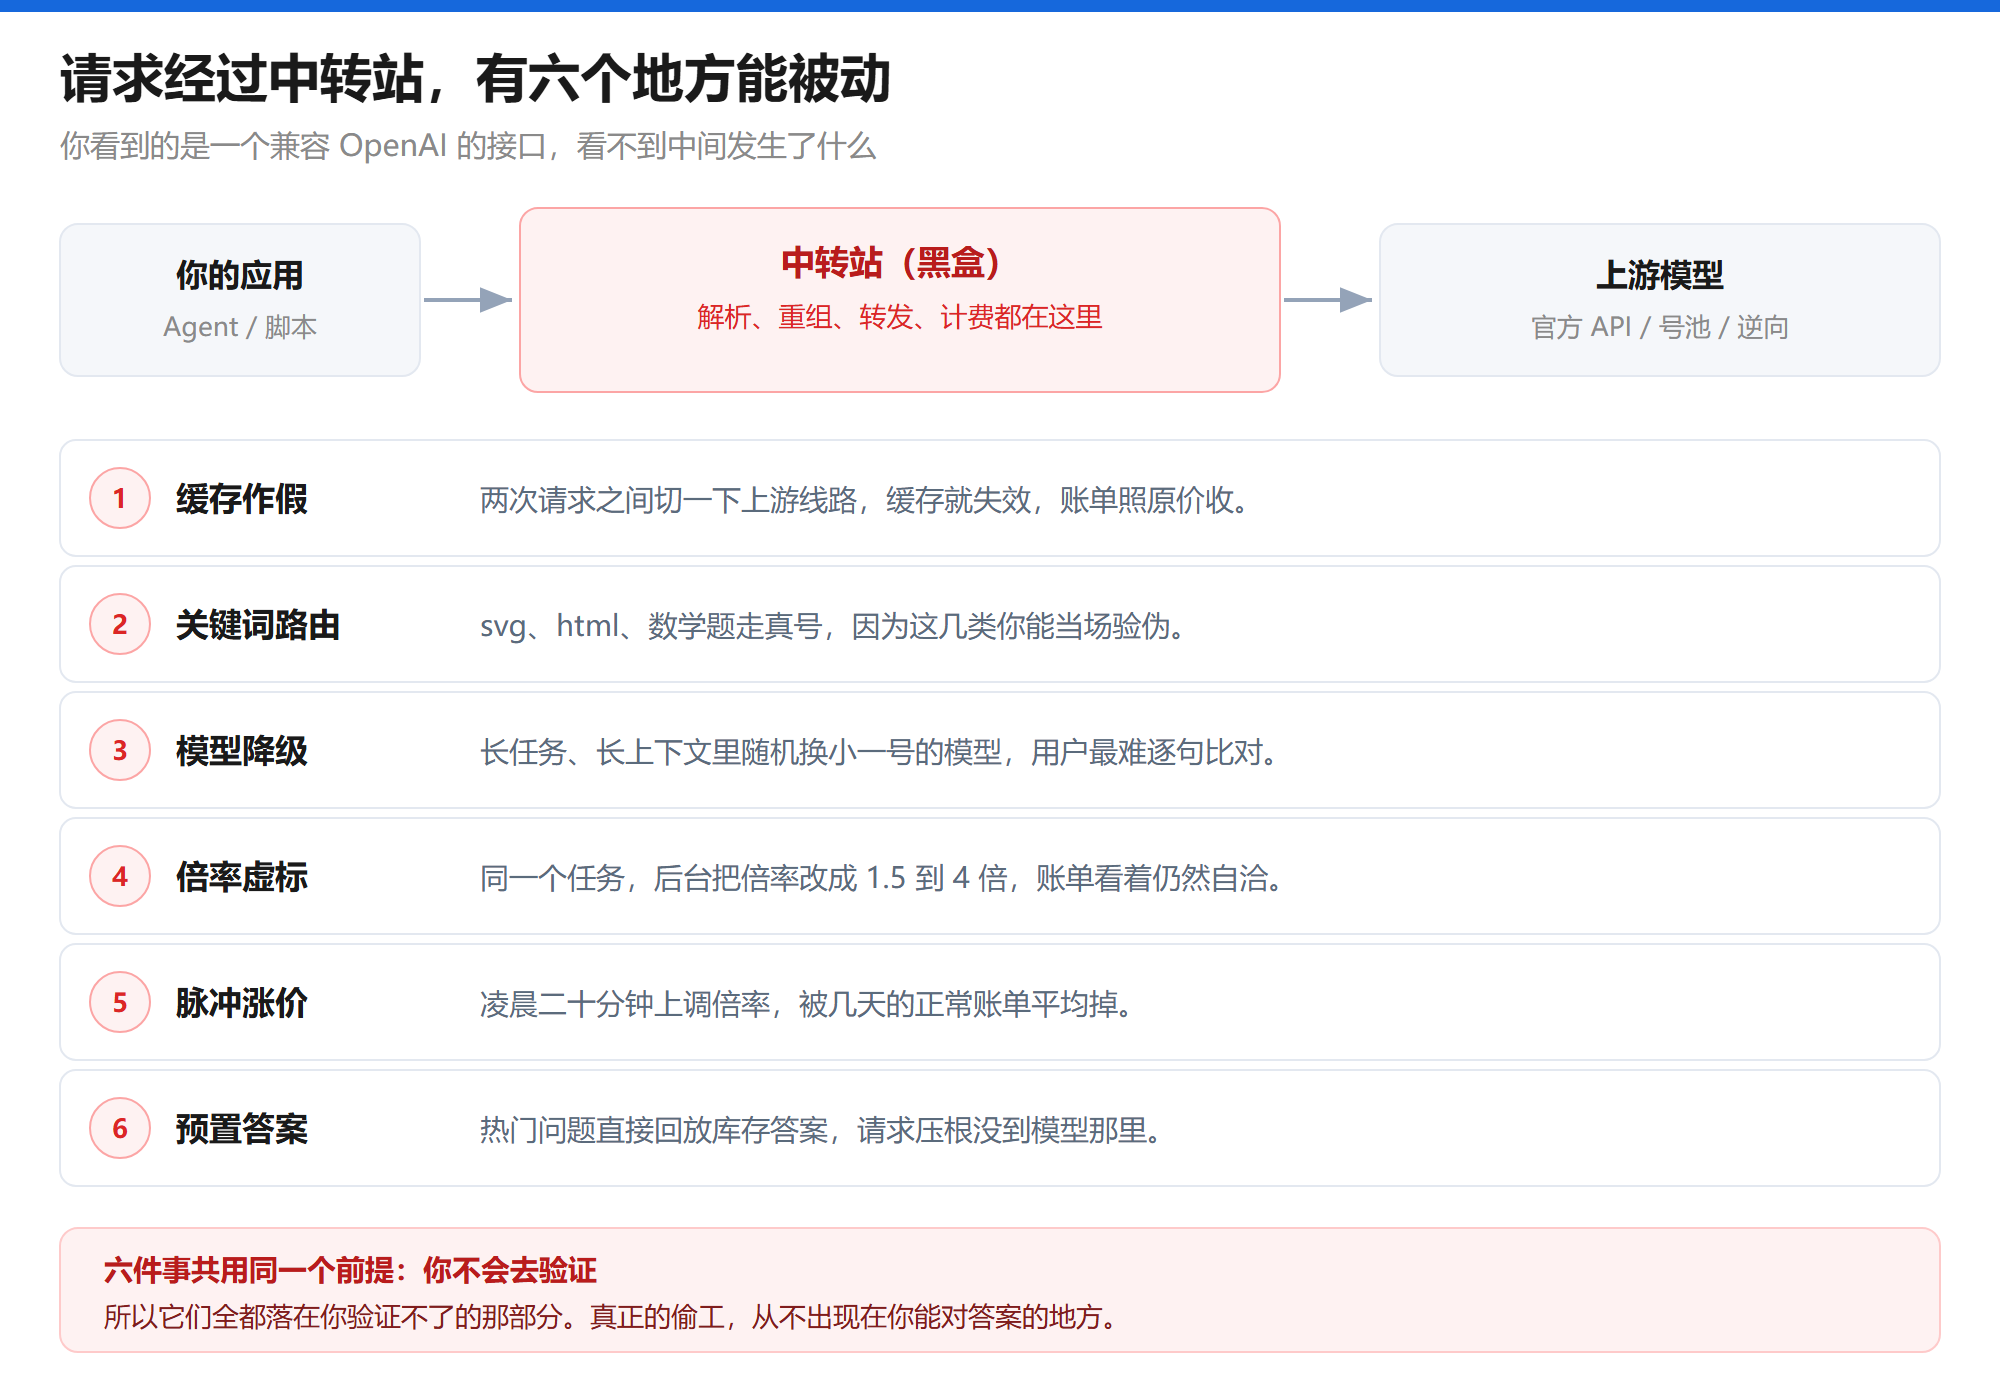
你的请求在它服务器上停留的那几百毫秒里,它可以做任何事:改 model 字段、改 max_tokens、改返回的文本、改计费用量、把 tool call 的参数换掉。你看到的只是一个兼容 OpenAI 格式的接口,看不到它拿这个请求干了什么。
这算不上什么攻击手法。它本来就有这个权限——是你自己把请求交给它的。
顺带说一句,别拿 CDN 类比。CDN 只缓存字节,不解释内容;中转站要解析你的请求、重新组装、再解析返回,所以它天然站在一个能改的位置上。
二、一折的价格,钱是从哪省出来的
包月 30 块、比官方便宜十倍,这事值得算一下。
成本是硬的。主流旗舰模型按百万 token 计价,输出端便宜的十几美元,贵的几十美元。一个重度用户跑 agent,一天烧掉几十上百块人民币很常见。这笔钱不会因为中间多了一家公司就消失。
便宜的来源只有三个方向。
把一个账号的额度拆给很多人。买一个两百美元级别的高级订阅,分给几十个人同时用。这种模式还算不上黑产,但它有物理上限:总量就那么多,人越多越挤。高峰期排队、官方风控、账号被封,都是这个模式的必然结果,不是运营不善。
把贵的模型换成便宜的。后面单独讲,这是全文重点。
根本不付这个钱。用接码平台批量注册新号,薅官方送的新用户体验金;或者用盗刷来的信用卡开号。前一种官方一封号就报废一批,后一种性质完全变了,那是刑法里的事。
确实也有正经做企业级批量采购再分销的,但它们的价格天花板很明显,不会比官方批发价低太多。看到「官方一折」还能长期稳定供货的,基本可以反推:上面三条里至少占了一条。这跟道德没关系,就是算术。
有个开发者跟媒体讲过自己的经历,三步走完只用了不到两个月。先是 25 元月租、每天 120 美元额度,用着还行,二十来天后官方大规模封号,商家直接跑路。换第二家,70 元月租只剩 90 美元额度,十几天后商家说「封杀严重、成本上涨」,价格提到原来的三到四倍。再往后月卡取消,改成 100 元换 500 美元额度。
额度越来越小,价格越来越高,月卡也变成了预付。这三件事同时发生,通常是上游号池快见底的信号。
三、「降智」是一套路由规则,不是玄学
用户管它叫「降智」,站长管它叫「路由」,同一个东西。
文档里有一条写得几乎是明牌:
找一个不降智的号,专门处理类似的信息关键词抽取。比如糖果题、html 动画、svg,这些你判断是降智的关键词,会专门用一个不降智的号来处理,你的请求会打到这个正常号上返回,让你觉得是正常号。
看懂这条,就明白为什么「有时聪明有时笨」了。
它挑的这三类任务有个共同点:用户能当场验伪。svg 画出来能看见对不对,html 跑起来能看出能不能用,数学题能对答案。这三种东西一旦降智,用户立刻发现,退款、差评、发帖,代价太大,不划算。
至于写文案、改简历、解释概念、润色邮件——这些没有标准答案。答得含糊一点,你会以为是自己 prompt 没写好;代码跑不通,你会以为是自己需求描述得不够清楚。这部分才是降级池的主要客户。
关键在这儿:它不动你能验证的部分。你验证不了的,才是它下刀的地方。这个设计比单纯换个便宜模型要精细得多。
第二层是模型降级。文档里的说法是「长时间、长任务会随机降智」,把贵的型号换成便宜的。为什么专挑长任务?因为长对话里用户最不可能逐句比对——你不可能回头检查第 40 轮的回答质量是不是跟第 3 轮一个水平。
第三层是动态路由。同一个模型名,高峰期走便宜渠道,低峰期走贵渠道;简单请求走小模型,复杂的偶尔走真的。你只在「感觉今天有点不对劲」的层面上感知到它,抓不到证据。
四、那张倍率表,算一遍就明白了
文档里有一张表,三行数字。第一眼看像内部价目表,算一遍才发现不是。
| 标称倍率 | 典型缓存命中率 | 输入等效倍率 |
|---|---|---|
| 0.1 倍 | 60%–70% | 0.046 倍 |
| 0.2 倍 | 60%–70% | 0.092 倍 |
| 0.3 倍 | 95% | 0.044 倍 |
先解释两个词。
倍率:中转站不直接标「每百万 token 多少钱」,标「官方价的几折」。0.1 倍就是官方价的一折。
缓存:Claude、GPT 这一类模型支持 prompt caching。一段重复出现的前缀,第二次不用重新计算,价格只有标准输入的十分之一。agent 场景里这个机制特别要命——每一轮都要把前面几十轮的内容重新喂一遍,命中与否,账单能差出一个数量级。
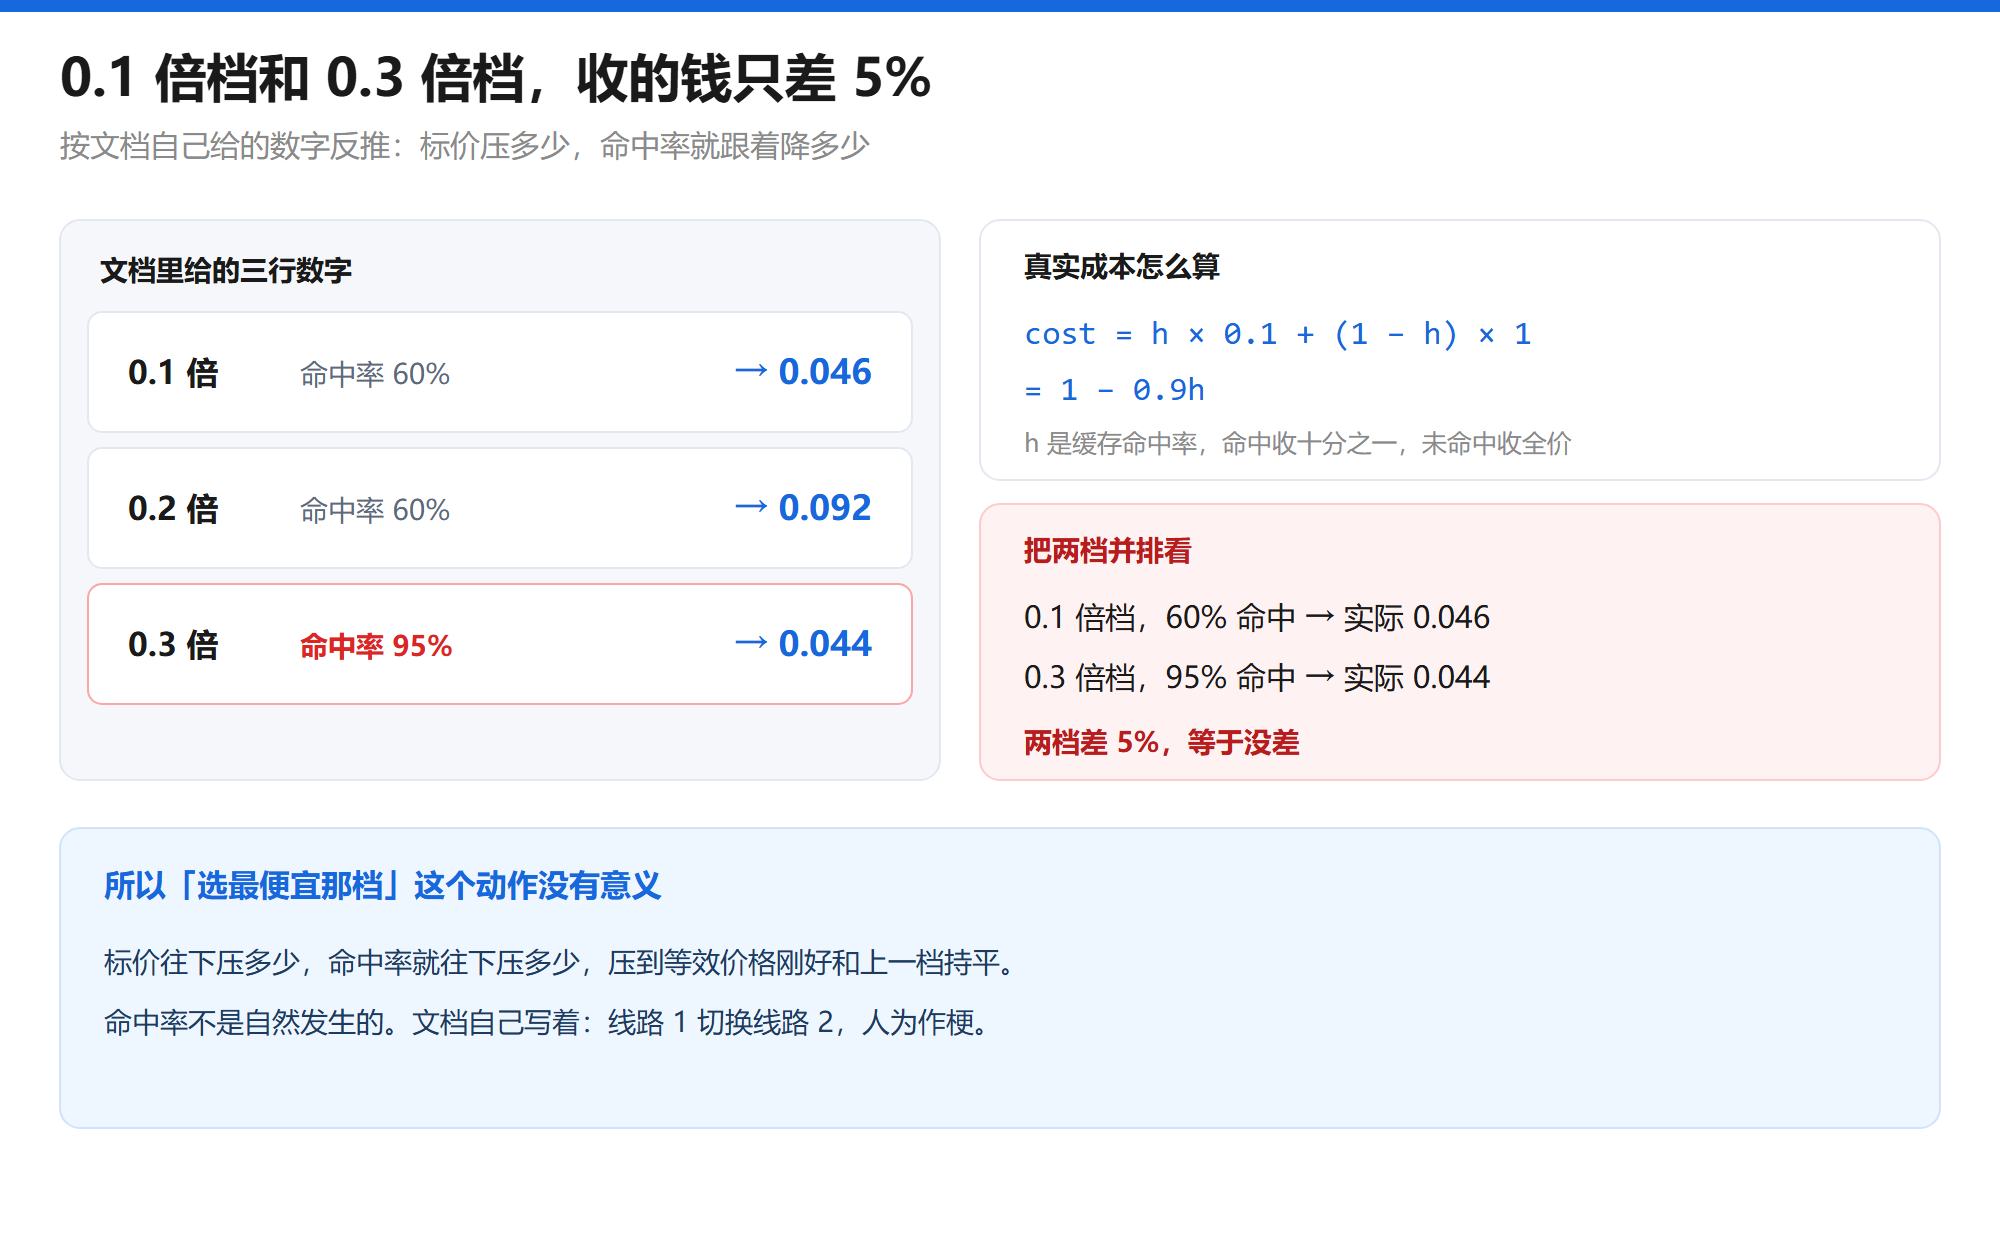
所以真实成本是这样的。设命中率为 h:
cost = 命中部分 × 0.1 + 未命中部分 × 1
     = h × 0.1 + (1 − h) × 1
     = 1 − 0.9h
代进表里:
- 0.1 倍档,命中率 60%:
(1 - 0.54) × 0.1 = 0.046 - 0.2 倍档,命中率 60%:
(1 - 0.54) × 0.2 = 0.092 - 0.3 倍档,命中率 95%:
(1 - 0.855) × 0.3 = 0.0435 ≈ 0.044
三行全对上了,精确到小数点后三位。随手编的数字凑不出这种巧合。
真正的信息在第三列之外——0.1 倍档的命中率只有 60%,0.3 倍档的命中率是 95%。
你选最便宜那档,拿到的命中率是 60%。你选贵三倍那档,命中率 95%。最后实际扣费 0.046 对 0.044,差 5%。
换句话说,选「0.1 倍」这个动作没有换来任何价格优势,只换来一个更低的缓存命中率。
那命中率是谁定的?
文档开头有一段叫「缓存作假」,原文是:「线路 1 切换线路 2,人为作梗,作一次缓存删数值不止」。翻成人话:在你的两次请求之间把上游线路切一下,缓存就失效了。命中率不是自然发生的,是可以拧的旋钮。
所以这三行根本不是价目表,是一份配方:标价往下压多少,命中率就往下压多少,压到等效价格刚好和上一档持平。
还有更极端的版本。文档里写「Plus 冒充」,指用 Claude Pro/Max 的订阅账号反代成 API。订阅号本身没有 API 那套缓存计费体系,谈命中率没有意义,但账单照旧按「官方一折」报。这种情况下你连「命中率被压」都感知不到,因为从头到尾就没拿到过缓存。
五、账单比模型更容易动手脚
模型至少还有办法验,账单就没什么好办法了,你只能看到它想让你看到的那几行。
倍率可以随时改。大部分站点跑的是 New API 这类开源面板,里面有个字段就叫「费率倍数」,1.0 是标准价、0.5 是半价、2.0 是双倍,站长在后台填个数字就生效。文档里的原话是「同样任务花 1 块钱,他可以设置花 3 元、4 元,或者 1.5 倍」。
你查账单时看到的是「这个模型倍率 0.1,消耗 100 万 token,扣 3 块」——账面自洽。你不知道的是 0.1 这个数字什么时候被改过。
涨价可以做成脉冲。文档里管这叫「紧急价格保护」:凌晨两点到两点二十,把某个分组的倍率临时调高,跑完再调回来。单次金额不大,被你连续几天的正常账单平均下去,看不出异常。你去问,答复是「线路波动」。
预置答案。这一条最像作弊:把一批热门任务(画图、写简历这类)提前在真模型上跑好,答案入库,用户来问直接返回。
你的请求可能压根没到模型那里。这类回答质量通常不差,因为是提前精心做过的。破绽在长上下文——你塞一段它没见过的内容进去,让它引用其中某个具体数字,它立刻对不上。这也是为什么预置答案只敢用在短任务上。
假首字。收到请求先吐一个空格或者固定字符,把首字延迟打到几百毫秒。官方模型首字通常一到两秒,比官方还快,这本身就值得警惕。
六、比注水更狠的:它看得见,也改得动
上面这些,说到底是在钱上做文章。你能通过账单和测试发现,发现了换一家,损失有上限。
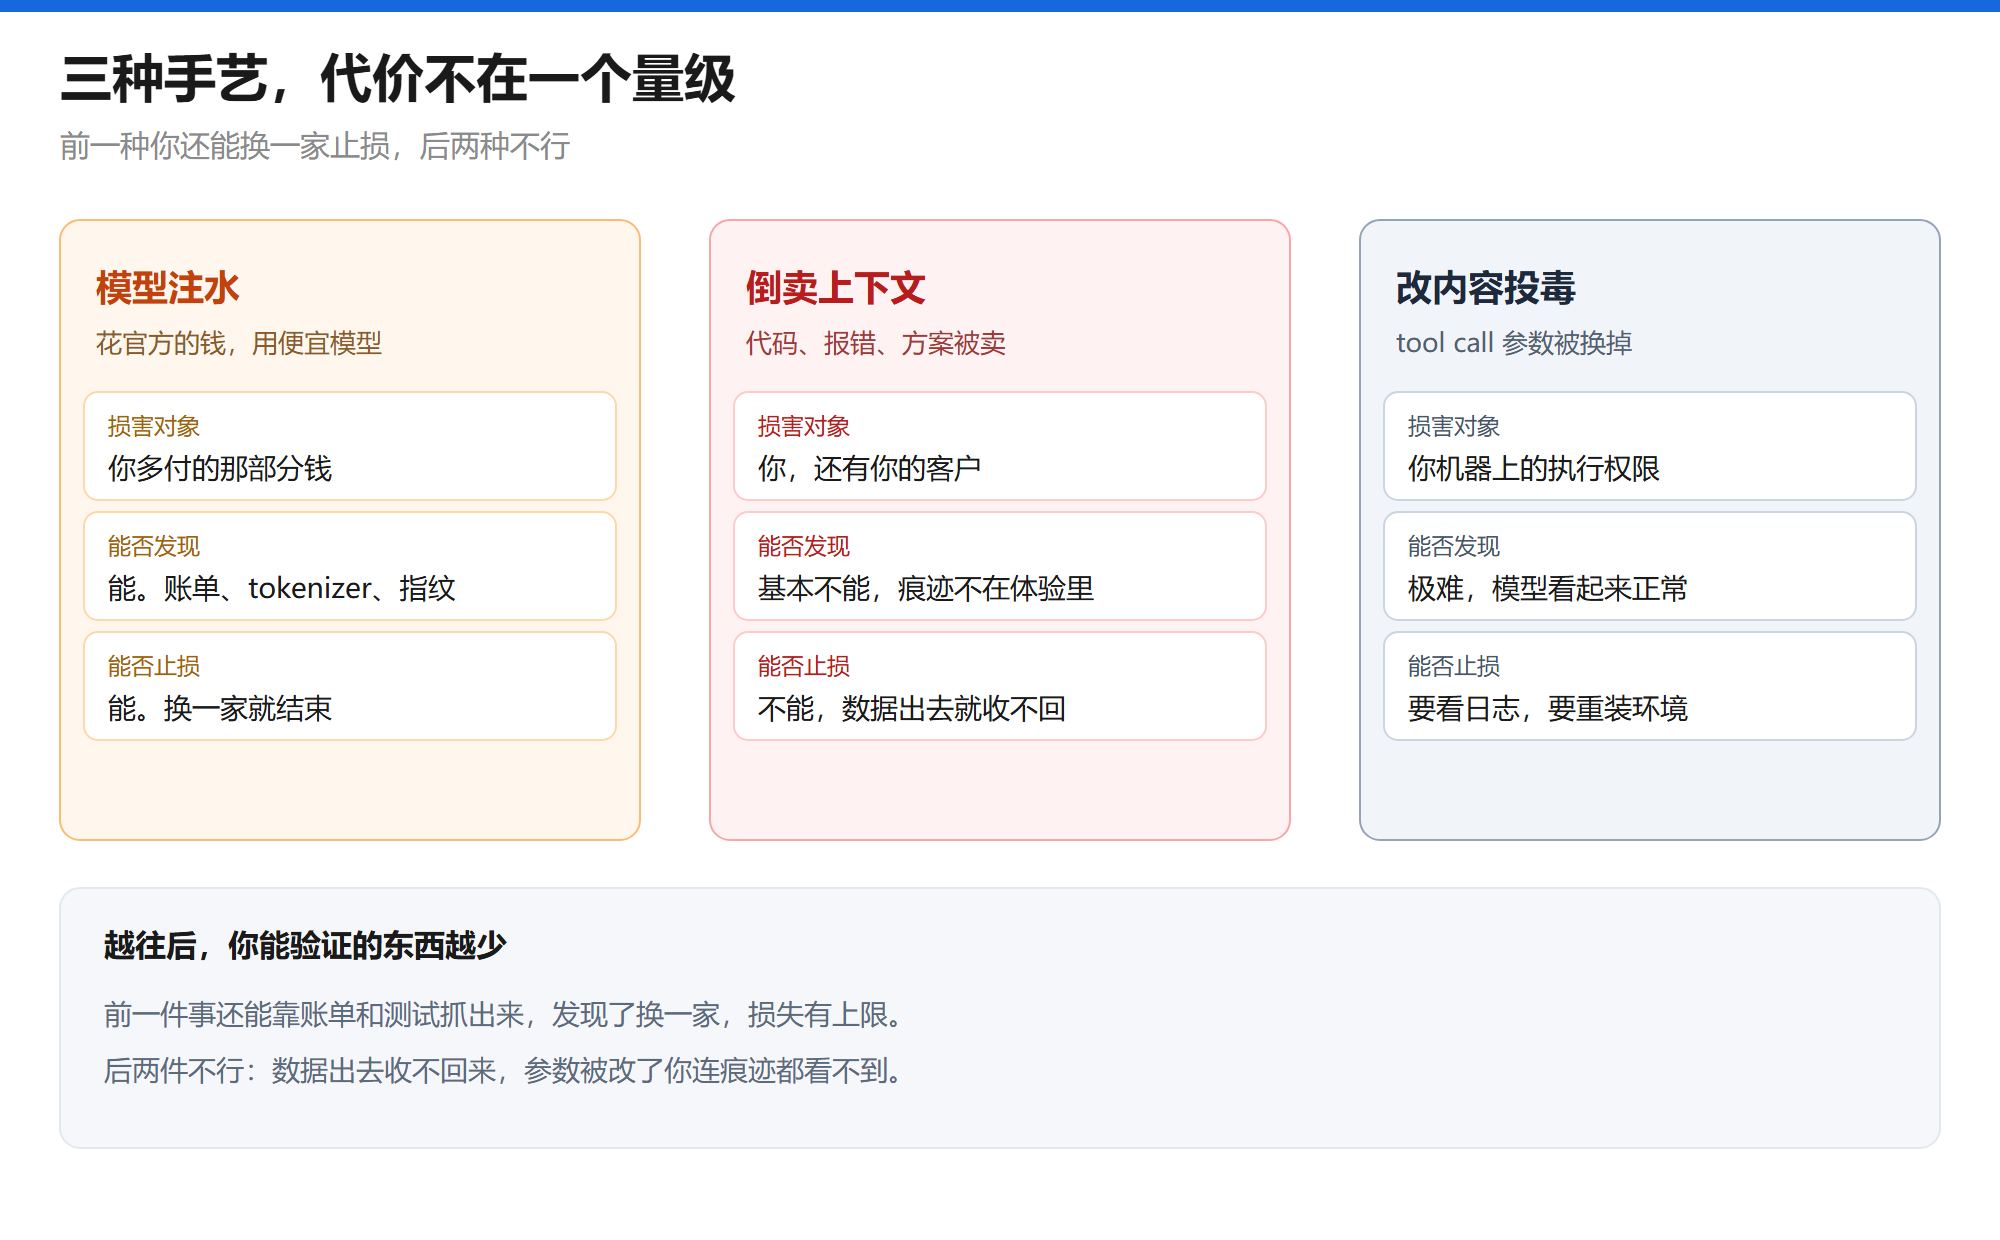
先说数据。你的 prompt 经它转发,意味着它能看到全部内容:代码、报错日志、数据库字段、.env 里的键名、客户名单、还没上线的方案。而「脱敏」这个说法经不起推敲——代码上下文里,内网 IP、表结构、服务调用关系、业务规则注释,单看都不敏感,拼起来就是你的系统架构图。脱敏脱得越彻底,数据越没用;越有用,就越脱不干净。
这个市场是明码标价的。有人在群里发过这样的消息:「收上下文缓存数据,正常脱敏,模型蒸馏用的,去重后 1m 10 元」。
再说 agent 带来的变化。单轮问答其实不值钱。值钱的是完整轨迹:你提了什么需求、它错了三次、你怎么纠正、最后跑通的那版代码长什么样。这里面有意图、有试错、有最终解,比任何静态语料都贴近真实的工程决策。
换句话说,Agent 用得越重、上下文越长、纠正越细的人,越是被定向收割的目标,而且他本人毫无察觉。
最后是改内容。今年四月有篇论文叫《Your Agent Is Mine》,专门测这个。研究团队测了 28 个付费、400 个免费的中转网关,在请求里埋了 AWS 金丝雀凭证,结果 17 家碰过这把假钥匙;埋进去的一把以太坊私钥,被其中一家直接转走了 ETH。另有 1 个付费站和 8 个免费站会往返回内容里注入恶意代码,2 个用了自适应规避触发器(检测到测试流量就不作恶)。
论文里的手法不是「给你一个错误答案」,而是改 tool call 的参数。比方说模型要装 requests,返回里那个包名可能变成 requestss;模型要访问某个文档链接,URL 可能被换掉。你看到的仍然是模型在正常工作,实际执行的是另一套东西。
配上另一个数字看更清楚:440 个 Codex 会话里,401 个跑在 YOLO mode,自动批准工具执行、不弹确认。这些人的上下文里不只是文本,是可直接执行的权限。
模型注水骗的是你的钱。改内容,是在你机器上装东西。两件事量级不同。
七、法律风险,以及「我只是个代理」的错觉
今年五月,一位上海的中转站站长公开发了关停声明,说自己因非法获取 API 模型被刑事拘留 37 天,目前取保候审,已退赔退赃。这条消息在圈子里传得很广,之后不少同行紧急关站。
法律上的定性,目前比较一致的看法落在两条线上:
- 非法经营。面向境内用户大规模提供境外模型接口并牟利,属于经营性互联网信息服务,需要增值电信许可。绝大多数个人站没有。
- 非法获取计算机信息系统数据。逆向官方协议、伪造请求、绕过鉴权。这一条比「没牌照」重得多。
还有个容易被忽略的点:数据出境。你用中转站处理公司资料,那些内容实实在在传到了境外服务器上。按现行规定,处理重要数据或者达到一定量级的个人信息出境,需要走安全评估或标准合同。个人用户可能觉得这跟自己没关系,但真出事的时候,追责链条上「我把数据发出去」这个动作是你做的。
不少从业者的自我认知是「我只是个技术代理,不算数据处理者」。这个说法站不住——只要数据经过你的服务器并发生收集、存储、传输,就具备数据处理者的实质。
八、怎么自己验
不用信任何人,验就行。按成本从低到高排:
1. 看账单字段。正常的账单应该有 input、output、cache_write、cache_read 四项分开列。只给一个总数、不肯导出明细的,直接排除。这一条能筛掉一大半。
2. 数 token。用公开的 tokenizer 把同样的文本数一遍,跟账单比。差 30% 以上不正常,差一倍就是明抢。
3. 测缓存。同一段长 prompt(几千 token 以上)连发两次,看第二次的 cache_read 有没有明显上升。不涨说明根本没有缓存,所谓「一折」是把没打折的钱按打折卖你。
4. 埋长上下文。在上下文里塞一串随机数字,让模型「引用第 37 个数字」。预置答案和上下文截断会当场暴露。
5. 看首字构成。首字 200ms、整段却吐得很慢,检查第一个 chunk 是不是空串或者「好的」这类固定字符。
6. 放饵。这条最狠,也是最老的办法:在 prompt 里埋一个只用过一次的随机字符串,或者一把明知是假的云厂商 key。过两三周回来看——假 key 有没有产生调用记录(云厂商后台能看到),那个字符串有没有出现在搜索结果里。论文测金丝雀凭证就是这么测的。
7. 看有没有聊天记录页面。有,说明请求体是明文存的。没有也不代表没存,只是没给你看。
九、什么时候可以用
短期做个 demo、跑点不敏感的活、验证一个想法,用中转站没什么问题,省下的钱是真的。
但有三条线别越。
一是上下文里有别人的东西。客户资料、同事的代码、还没公开的方案,这些不是你一个人的,你没资格替他们承担风险。
二是agent 有执行权限。一旦它能跑命令、装包、读文件、调 API,中转站就不只是转发接口,而是权限链路上的中间人。
三是账要能对得上。商业项目按量付费,账单必须是可审计的,不能只有「余额少了 30 块」这一行。
最后回到最开始那个问题:AI 中转站靠谱吗。
我的看法是,拿「基础设施」的标准去要求它的,都不靠谱;把它当「能用就行的一次性工具」看待,反而没什么心理负担。区别在于,你往里放了多少不能外流的东西。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING