



新手机到手第三天,你把去年那台旗舰翻出来,两台并排刷同一段短视频。二十分钟以后,新手机背面明显更烫。跑分它比旧机高出一截,游戏帧数也更好看,可温度就是压不住。这不是你的错觉,也不是运气不好碰上体质差的那一台。
10 月 27 日极客湾那期旗舰芯片横评,把六颗芯片放在同一间屋子里、同一条屏幕亮度、同一张 WiFi 下测了一遍。结论里最难看的一条给了骁龙 8 Elite Extreme Gen 6(下面简称 8EE6):中核的能效全频段往回退,最好的情况是跟上一代 8E5 打平,最差的时候能退回两三代前的水平。
一颗用台积电 2nm N2P、主频头一回冲到 5GHz 的旗舰,为什么偏偏在「省不省电」这件事上往回走?这篇只讲芯片本身,四个被做反的设计取舍我一条一条说:当初想解决什么问题,实际发生了什么,最后为什么会走到这一步。
一、先把「开倒车」这三个字说准
跑分和能效测的根本不是同一件事。跑分测的是上限,它把芯片一路推到最高功耗点,看这颗最快能跑多快,测十分钟就结束;能效测的是整条曲线,说的是干同一件事你要吃掉多少电。这两个数字的方向经常是反的,一颗芯片完全可以跑分更高、能效更差,8EE6 就是这样的例子。
手机不是台式机。它没有风扇,均热板能铺多大就那么大,电池也就那么点容量。同样一件活多吃一瓦,最后都会落在两件事上——你手上摸到的温度,和晚上十点剩下的电量。
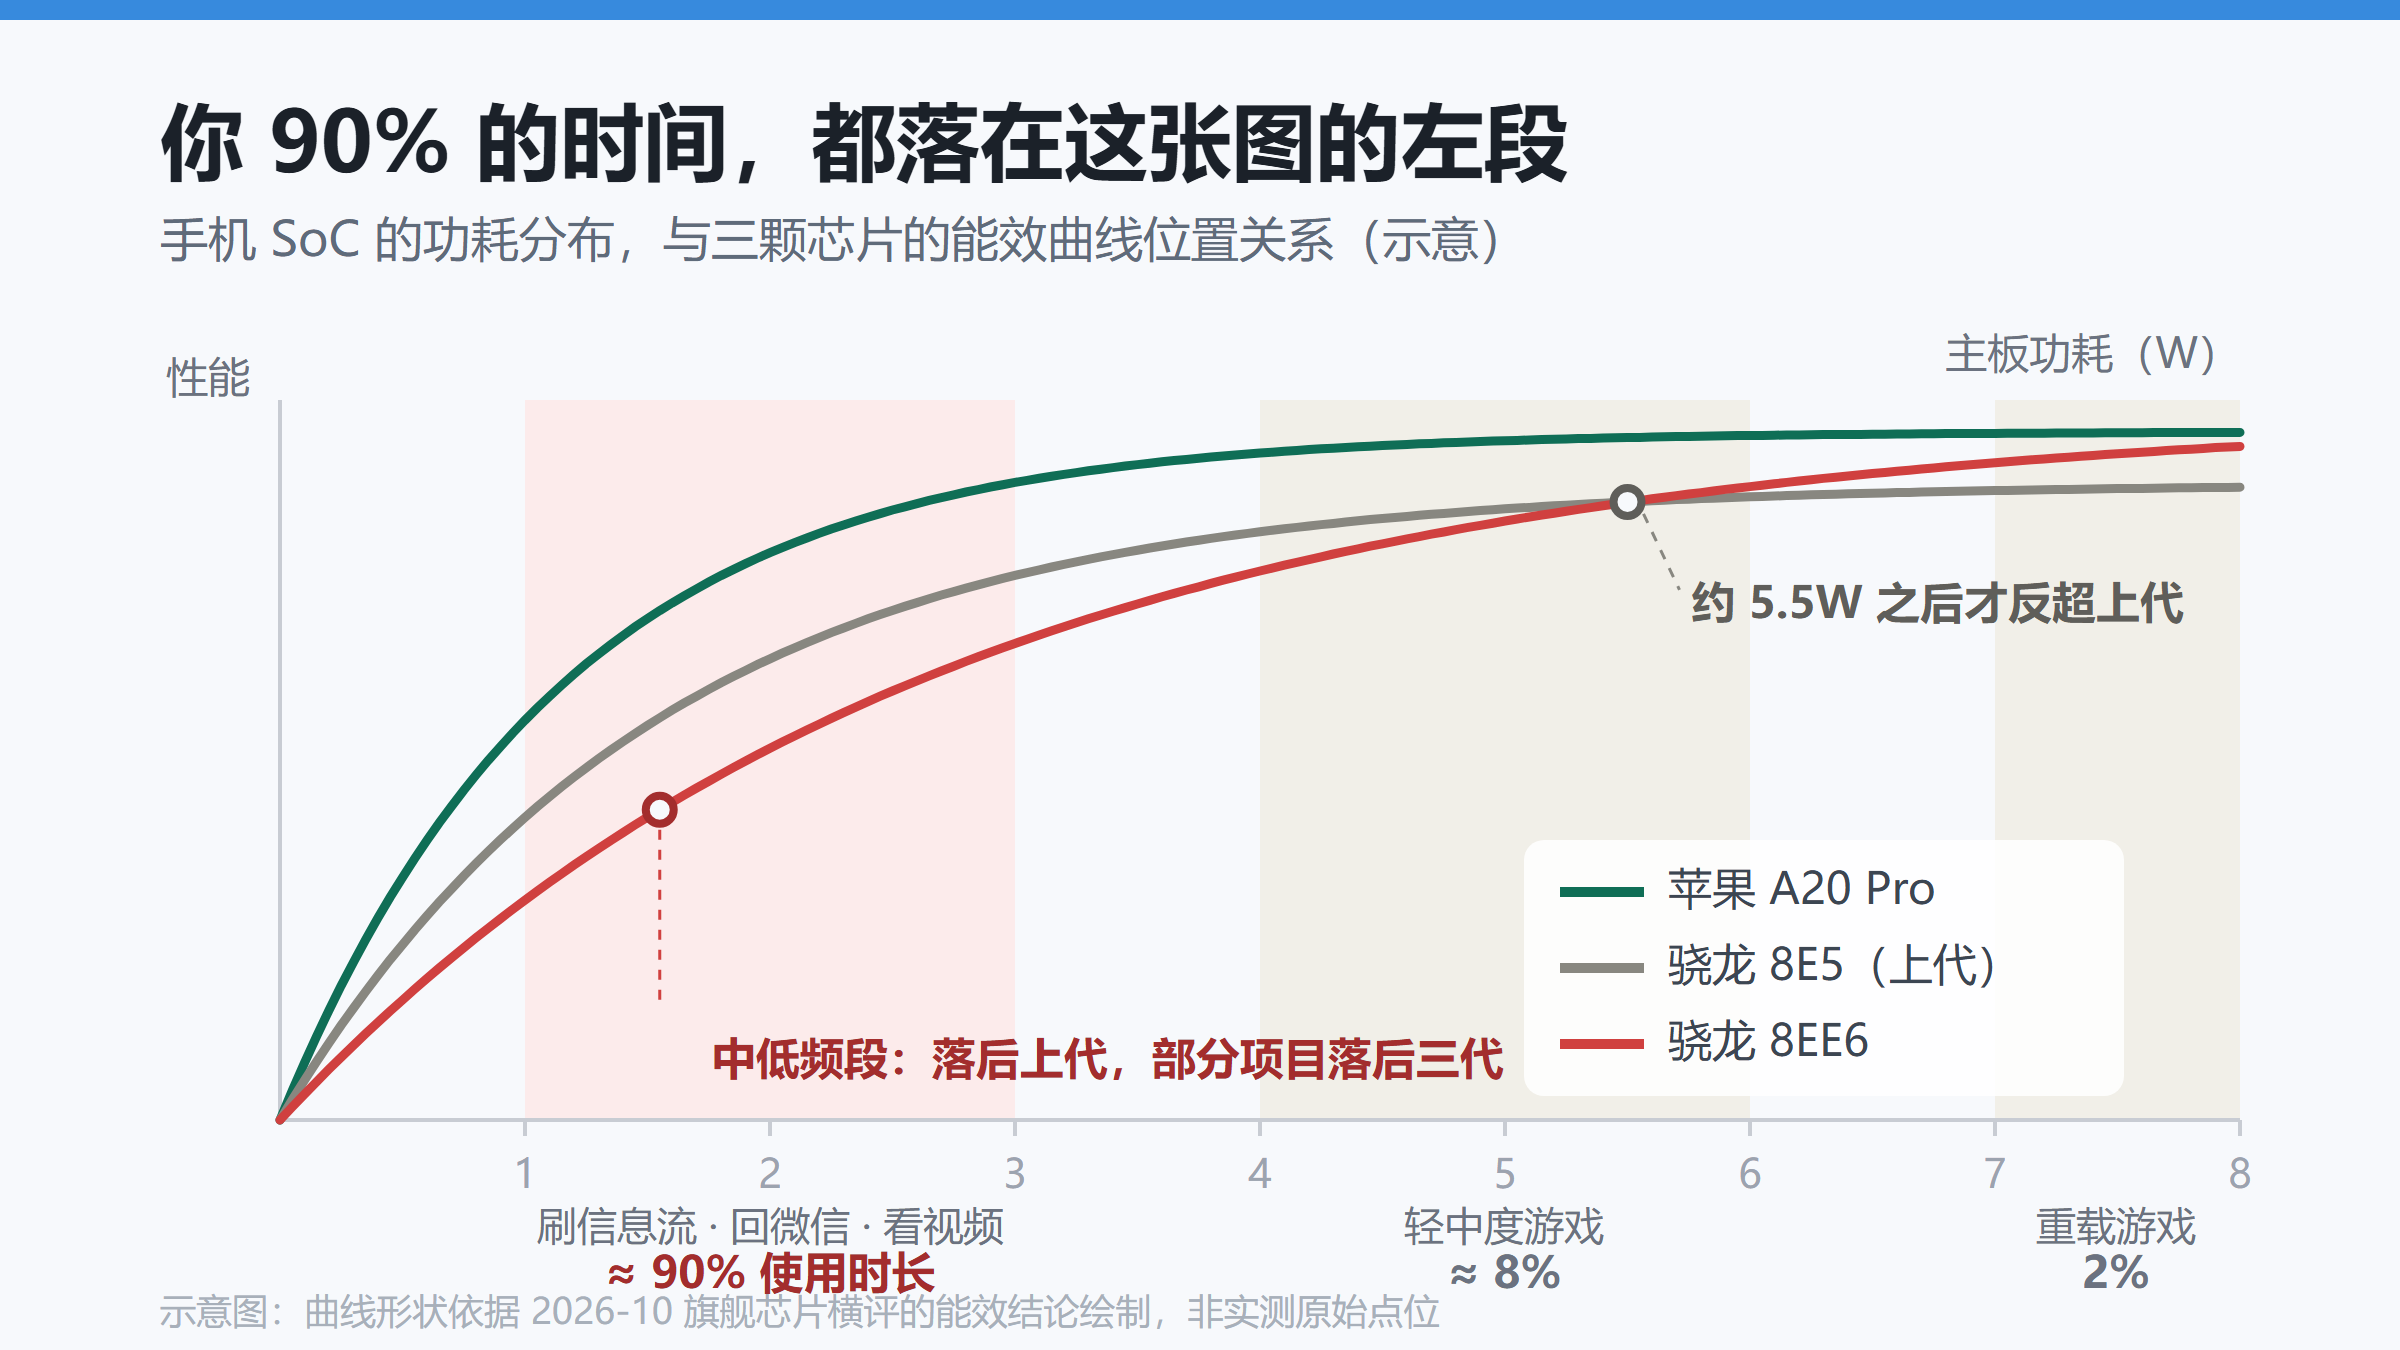
而在整条曲线里,真正决定体验的并不是最右边那一段。你刷信息流、回微信、看视频的时候,SoC 大概跑在 1 到 3W;打轻中度游戏是 4 到 6W;只有重载手游才摸得到 7W 以上。最左边那一段,占了绝大多数人的绝大多数时间。
而 8EE6 这一代的退步,恰恰就压在这个区间上。按横评那张能效曲线,它在低中频段一路落在上一代下面,要拉到 5.5W 以上才反超——换句话说,它不是在你偶尔才碰的峰值段掉队,而是在你每天待得最久的那一段掉队。
按横评的数据,它的中核 IPC 比上一代低了 11%,同频功耗反而高了 12%。这两个数放在一起是什么意思?同样跑 2.6GHz,它每个时钟周期干的活更少,吃的电还更多。中核的能效整体落到三年前骁龙 8 Gen 3 那颗 A720 后面去了。
一台 2026 年的 2nm 旗舰,中核打不过 2022 年的 4nm 中核。这话没法用「工程机没调好」糊过去——横评用的是自购零售机,不是厂商送测的样机。
中核为什么这么要紧?因为日常活都是它在干。绝大多数 App 的线程调度会优先落到中核上,超大核只在瞬时爆发的时候才被拉起来。中核的能效塌了,整颗芯片的体验地基也就跟着塌了。下面四条,就是这块地基塌下去的过程。
二、取舍一:把 TLB 按 16KB 页来设计
手机里的内存不是按字节管的,是按「页」管的。现在绝大多数 Android 应用还跑在 4KB 一页的体系上。CPU 每次要访问内存,都得先把虚拟地址翻译成物理地址,翻译的结果会存进 TLB——你可以把它想成一本很小的快捷记事本,里面只有几十到几百条记录。
如果 TLB 表命中,几个时钟周期就能拿到物理地址,核心拿着地址就能去读数据干活。不命中,就得顺着多级页表一级一级查下去,每一级都是一次真实的内存访问。假如按一级 100ns 算,四级就是四百纳秒上下。这段时间核心光在等查表,数据拿不到,没活干,但是它还在持续通电发热。
安卓往 16KB 页迁移,这个方向是确定的。同样多的 TLB 条目,如果每一条能覆盖 16KB,能管住的地址空间就大得多。高通显然想抢这个提前量,这个想法本身没错。
问题是,今天手机上跑的东西还活在 4KB 的世界里。为 16KB 页设计出来的 TLB,扔到 4KB 页的负载上,等效覆盖范围就大幅缩水了。你的工作集稍微一大,超出它能管住的范围,就变成了反复翻页表。横评里 L2 和 TLB 的未命中次数,最高出现了十倍于前代的差距,个别子项的波动到了 74%。
更麻烦的是它还连带拖住了前端。这一代中核的解码宽度从上一代加宽到了 5 宽,纸面上这是实打实的架构升级。可真跑起来,利用率大幅下降——取指和地址翻译在后面堵着,前面宽度再大也只是空转。
所以这一条的错不在方向,在提前量。它让今天买手机的人,替两年后才会普及的标准付了钱。
三、取舍二:把两套独享 L2 合成一套共享缓存
L2 是核心和内存之间的中转站。这个东西有两个属性最要命:一个是容量,一个是延迟。
上一代的做法是每个核心簇各配一套 12MB,彼此独立。这一代改成了 16MB 统一共享,名字叫 FlexCache。共享听起来总比独享高级,可我们先看总量:两套 12MB 是 24MB,一套 16MB 是 16MB。合池以后,总量反而变小了。
比容量更关键的其实是供电。这一代的 L2 和超大核共用时钟、共用电源轨,不能独立调节。这意味着中核要用缓存、缓存想提频的时候,这个频率得跟着超大核的档位走。
中核满负载跑着,缓存响应慢,它在等数据。系统一看缓存频率不够,想把频率抬起来,就只能把整条轨道抬上去。而这条轨道上还挂着超大核——于是超大核被无谓地唤醒,什么活都不干,照样吃电。
中核在干活,超大核在旁边陪着烧电,而缓存的延迟其实并没有真正降下来。横评把这个叫「L2 缓存连坐」。
从设计动机上猜,这么做能省面积、省一套电源管理、让一致性逻辑简单一些。可缓存恰恰是那种「不产出跑分、只影响体验」的部件——在 PPA 里它是最容易被砍的一项,也是最不该砍的一项。
四、取舍三:把主频拉到 5.01GHz
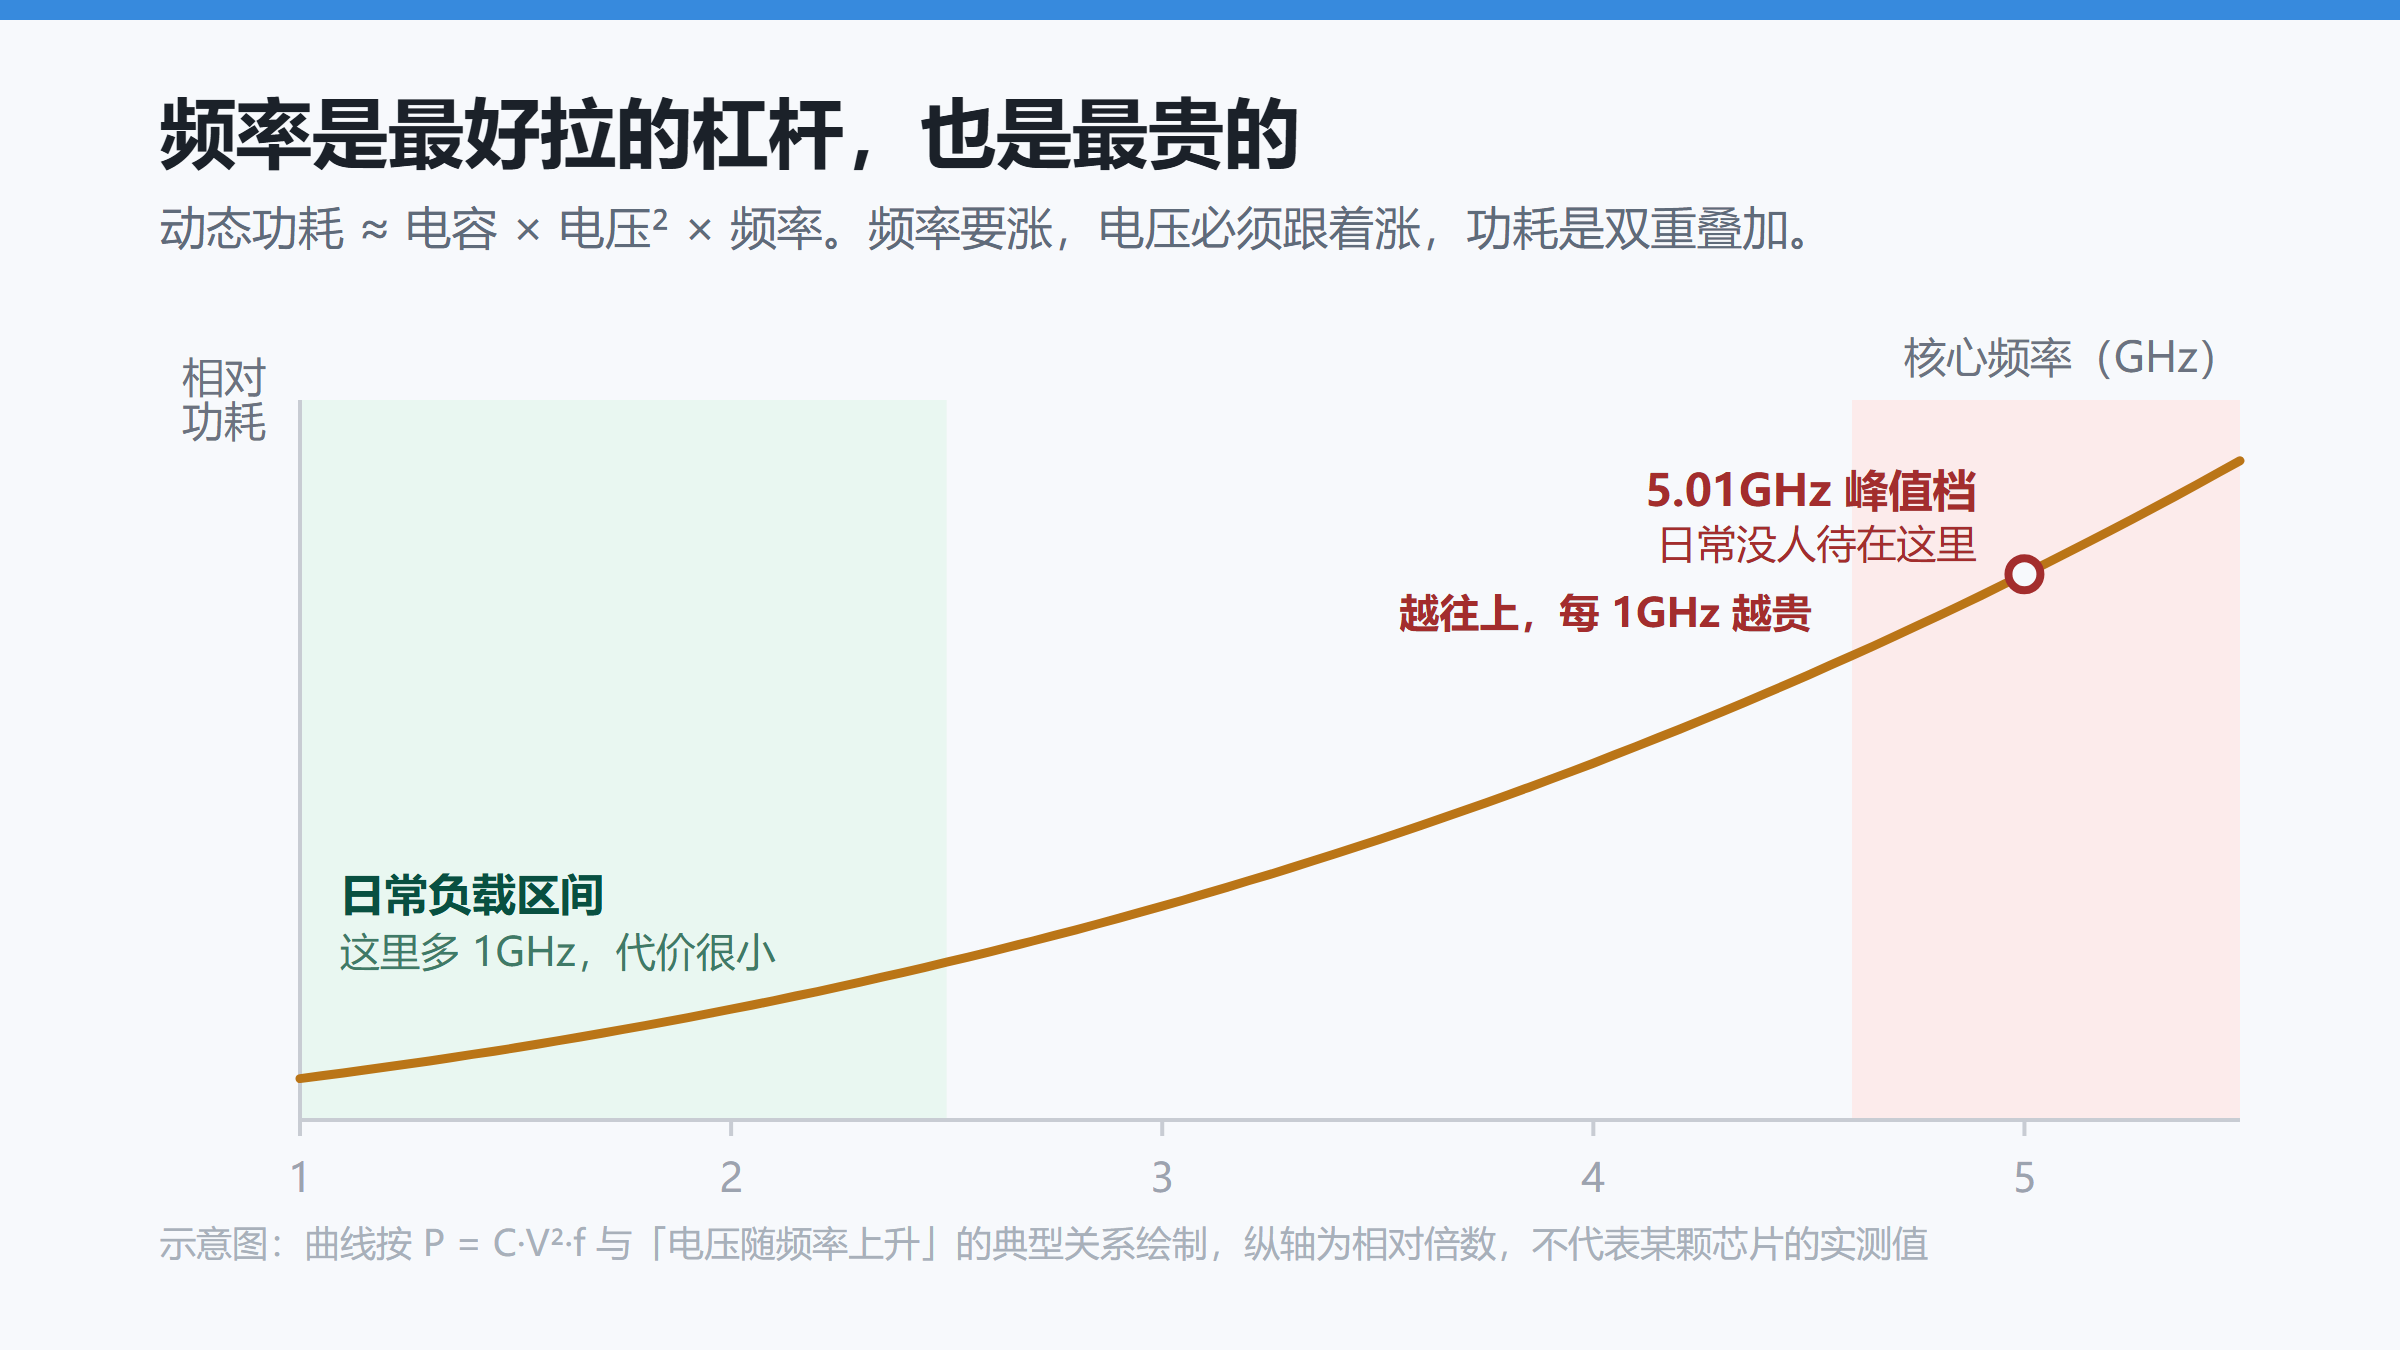
前两条还算是设计上的判断,这一条更像「总得做点什么」。5GHz 对手机 SoC 是个有仪式感的数字,能写进发布会第一页,能在跑分榜上拉开身位。这一代两颗 Prime 超大核拉到了 5.01GHz,剩下的六颗中核拆成三颗高频加三颗低频。
代价就写在公式里:动态功耗 ≈ 电容 × 电压² × 频率。频率往上走,电压必须跟着往上走才能维持时序,而电压是平方项。所以到了高频段,你每往上挪一点,功耗涨的幅度都远大于频率涨的幅度。这也解释了为什么低功耗段的单核成绩只比上一代只好一点点,峰值却能拉开一大截——那个高分是堆频率堆出来的,不是架构的 IPC 变强了。
还有一个更直接的后果。为了在能效难看的前提下把温度压住,终端厂商只能往下压电压。电压压到余量不够,体质差一点的芯片在某个频率下就不稳了。首发那批机器出现的黑屏、重启,来源就在这。极客湾自己买的那台测试机也遇到过。
OTA 之后黑屏确实少了。但你得看清楚它是怎么少的:锁频率,降电压。所谓修复,本质上是把 5GHz 这个卖点自己关掉。
五、取舍四:把软件适配的活交出去
这一条跟前三条性质不太一样。前三条是设计上的权衡,这一条是责任上的让渡。
Oryon 是高通自研的 CPU 架构。一个架构得告诉编译器、告诉系统调度、告诉运行时:「我是谁,你该怎么优化我。」极客湾排查的时候发现,8EE6 的超大核疑似没有被纳入 Oryon 优化路径的启用判断范围——系统根本没认出来这是颗新芯片,优化就直接缺席了。
这不是技术难题,是协作缝隙。芯片厂把 BSP 和优化建议交出去,整机厂各自二次调校,中间那一段「谁该为这颗核负责」,就空在那儿了。硬件上的缓存缺陷,再加上软件优化的整体缺席,中核的能效崩成这个样子,几乎是一种必然。
六、为什么苹果不这么干
把这几件事摊到 PPA 三角上看就清楚了,无非是性能、功耗、面积这三者怎么分。苹果 A20 Pro 用 99mm²,基带外挂,面积几乎全部留给算力,缓存能堆多大堆多大,走的是「用面积买能效」这条路。骁龙 8EE6 用 133mm²,要摊集成基带、要摊 ISP 和 NPU,还要切成至尊版、超级至尊版、次旗舰好几个 SKU,缓存就成了第一个被砍的对象,走的是「用频率买性能」。
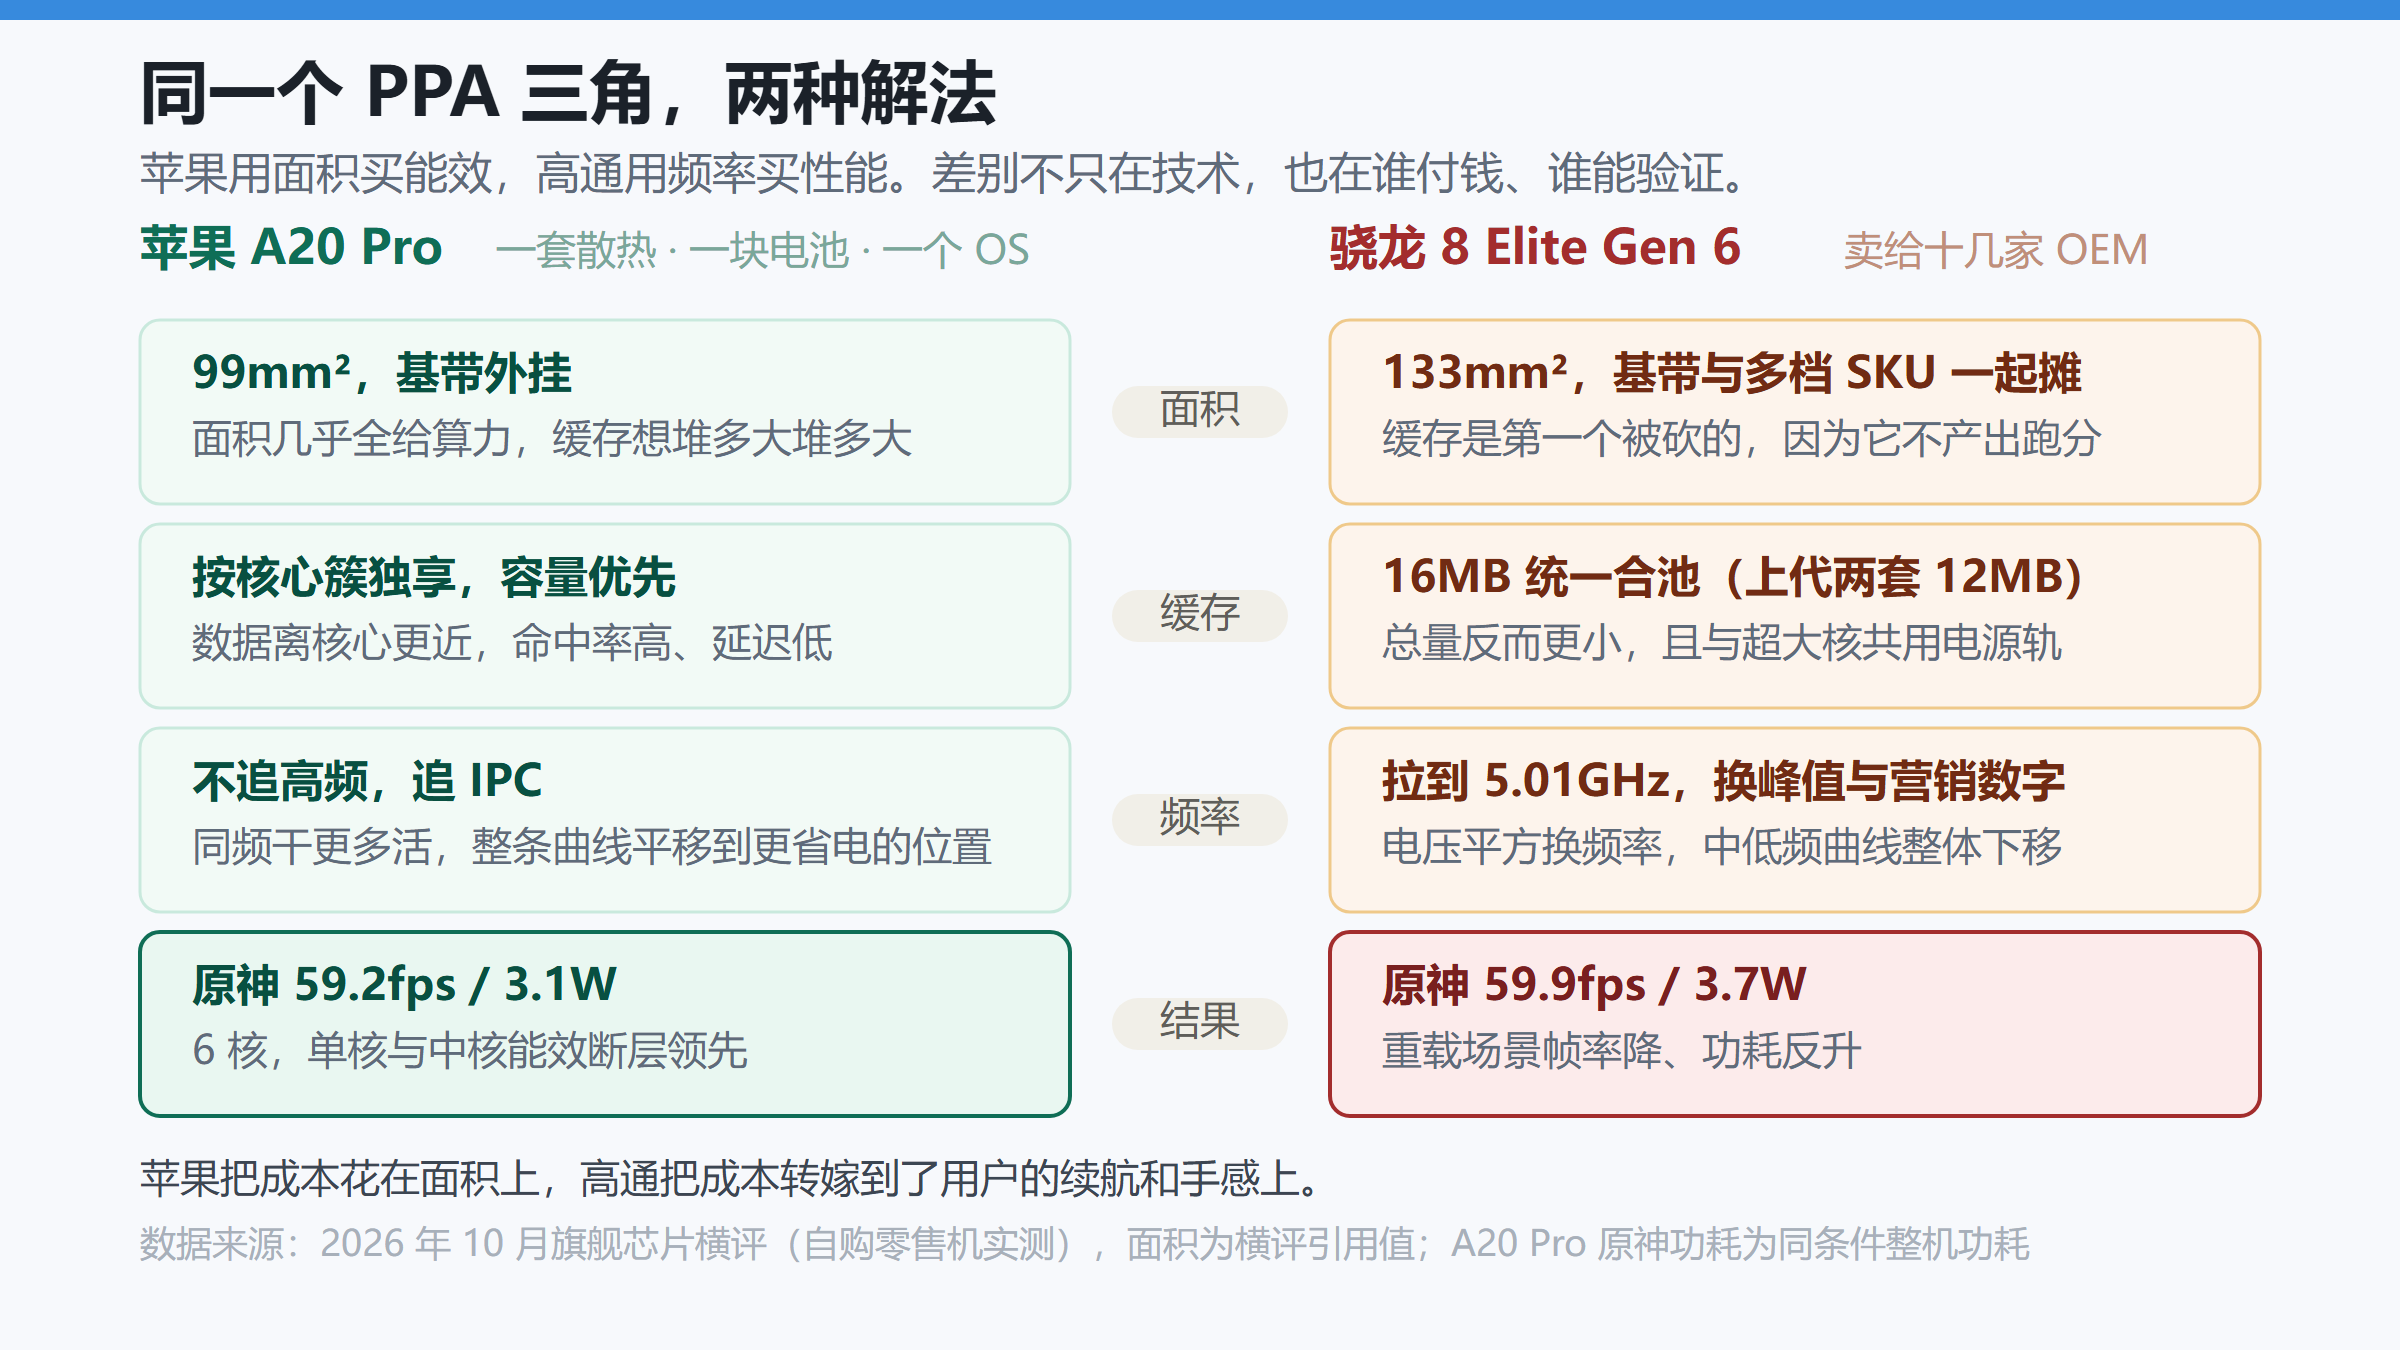
这不是高通不想,而是有三条约束压在那儿,而且任何一条都不是靠工程师加个班能解决的。
- 第一是归因难。跑分低了,那是高通自己的事;能效差了,表现出来的样子是「这台手机烫、掉电快」,锅会自动落到整机厂头上。所以没有哪家 OEM 愿意替芯片的能效背书,而「568 万分」这种荣誉,谁都愿意贴在自己海报上。
- 第二是采购逻辑。高通的直接客户是做产品的人,他们要的是能写进对比表、能在发布会上念出来的硬指标。苹果对面坐着的就是消费者,中间没有一层需要说服的人。
- 第三是验证成本。用户跑个安兔兔十分钟就完事,要验证能效,得用假电池加功耗仪,得统一固件和室温,极客湾为这颗芯片多花了十天。营销方向是厂商自己定的,但它只能定「自己最强、而且最容易验证」的那一项。
所以真正的差距不在于「设计不出来」,而在于「没有动机按苹果的方式去设计」。这条路技术上通不通是一回事,做出来有没有人买单是另一回事。
顺手排掉两个干扰项。A20 Pro 用的是 N2,8EE6 用的是 N2P,工艺上还更新一档,能效照样输——制程这条可以出局。小米玄戒 O3 用更老的 N3P,138mm² 堆了十核,多核能效拿了第一,说明「堆面积换能效」这条路是通的。高通是不能,不是不会。
七、这颗芯片到底该怎么看
它不是一句「行」或者「不行」能打发的,得看你是拿它来玩什么。《原神》须弥城那张图,8EE6 跑 59.9fps / 3.7W,比上一代的 4.3W 还省——因为 Adreno 850 的低频能效确实是这一代唯一实打实的进步,偏 GPU 的场景它能赢。
换到《鸣潮》玄方城摩托跑图,上一代是 58.7fps / 6.7W,8EE6 两台零售机分别是 53.6fps / 7.0W 和 48.5fps / 7.0W。帧率更低,功耗更高。重载混合负载把 CPU 的短板全给暴露出来了。所以这台机器值不值得买,答案要分人来看:
- 手里是 8E5 的,这一年不用换,你没损失什么。
- 已经在用 8EE6 的,先更新系统补丁。OTA 能把黑屏压下去,但救不回中低频能效。反复黑屏的留好记录走售后,别自己 root 改电压。
- 准备买的,先想清楚主要玩什么。散热堆得狠、主打手游的机型它能打;看重续航和通勤的,上一代旗舰或者本代更稳的平台,是更理性的选择。
写在最后
这一代最值得记住的,其实不是某颗芯片翻车,而是发布会上那个「能效提升 37%」的百分比。它是第一个被一台功耗仪当着几百万人打穿的官方数字。
以后再看到旗舰发布,别只问峰值多少分,问它敢不敢写一句「某游戏 60 帧,整机多少瓦,连续跑三十分钟不降频」。敢写,说明设计的时候就是照这个目标做的;只敢写百分比,说明那个数字是测出来的,不是设计出来的。
数据来源与口径说明
- 能效曲线、游戏帧率和功耗数据,来自 2026 年 10 月那期旗舰芯片大横评,六颗芯片全部是自购零售机实测,另有公开转述可对照。
- CPU 能效 +37%、GPU 能效 +40%,是高通发布会上的官方口径。
- die 面积、核心数、制程工艺,取自同一期横评的规格表。
- TLB、共享 L2、优化路径这三处的归因,是评测方给出的技术推断,高通没有就架构细节做完整说明;至于团队变动和降本的说法,属于业内传闻,我没有找到能坐实的来源。
- 正文两张动图是机制示意。这颗芯片的 TLB 条目数、电源轨拓扑、时钟域怎么划分,都没有公开,图里的数值不代表实际参数。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING