

结论放前面:这台 Rocky Linux 主机的网卡调优,真正有效的只有两件事——把 offload 打开,把软中断从单核里摊出去。做完这两步,接收速率从 895 Mbps 压到 967 Mbps,硬中断不再把 CPU5 一个人顶满。剩下的 ring buffer、中断合并、MTU,要么驱动不让改,要么改了会更糟。参数很多,能动的没几个。
我一开始也以为网速慢是网卡的问题。测速只有 300M,家里宽带是千兆,别的设备都正常,就这台不对劲。查了一圈温度、链路协商、丢包计数全正常,最后发现是机器上跑着一个吃带宽的容器,出口被自己顶满了。网卡啥事没有。这段经历让我把整条收包路径的参数都翻了一遍,这篇就是那个过程的记录。
先看一个包是怎么进到 CPU 里的
调优最容易犯的错,是在错误的层使劲。比如想解决软中断把 CPU 打满,却去调 ring buffer;想解决丢包,却去改 MTU。得先知道每个参数落在路径的哪一段上。
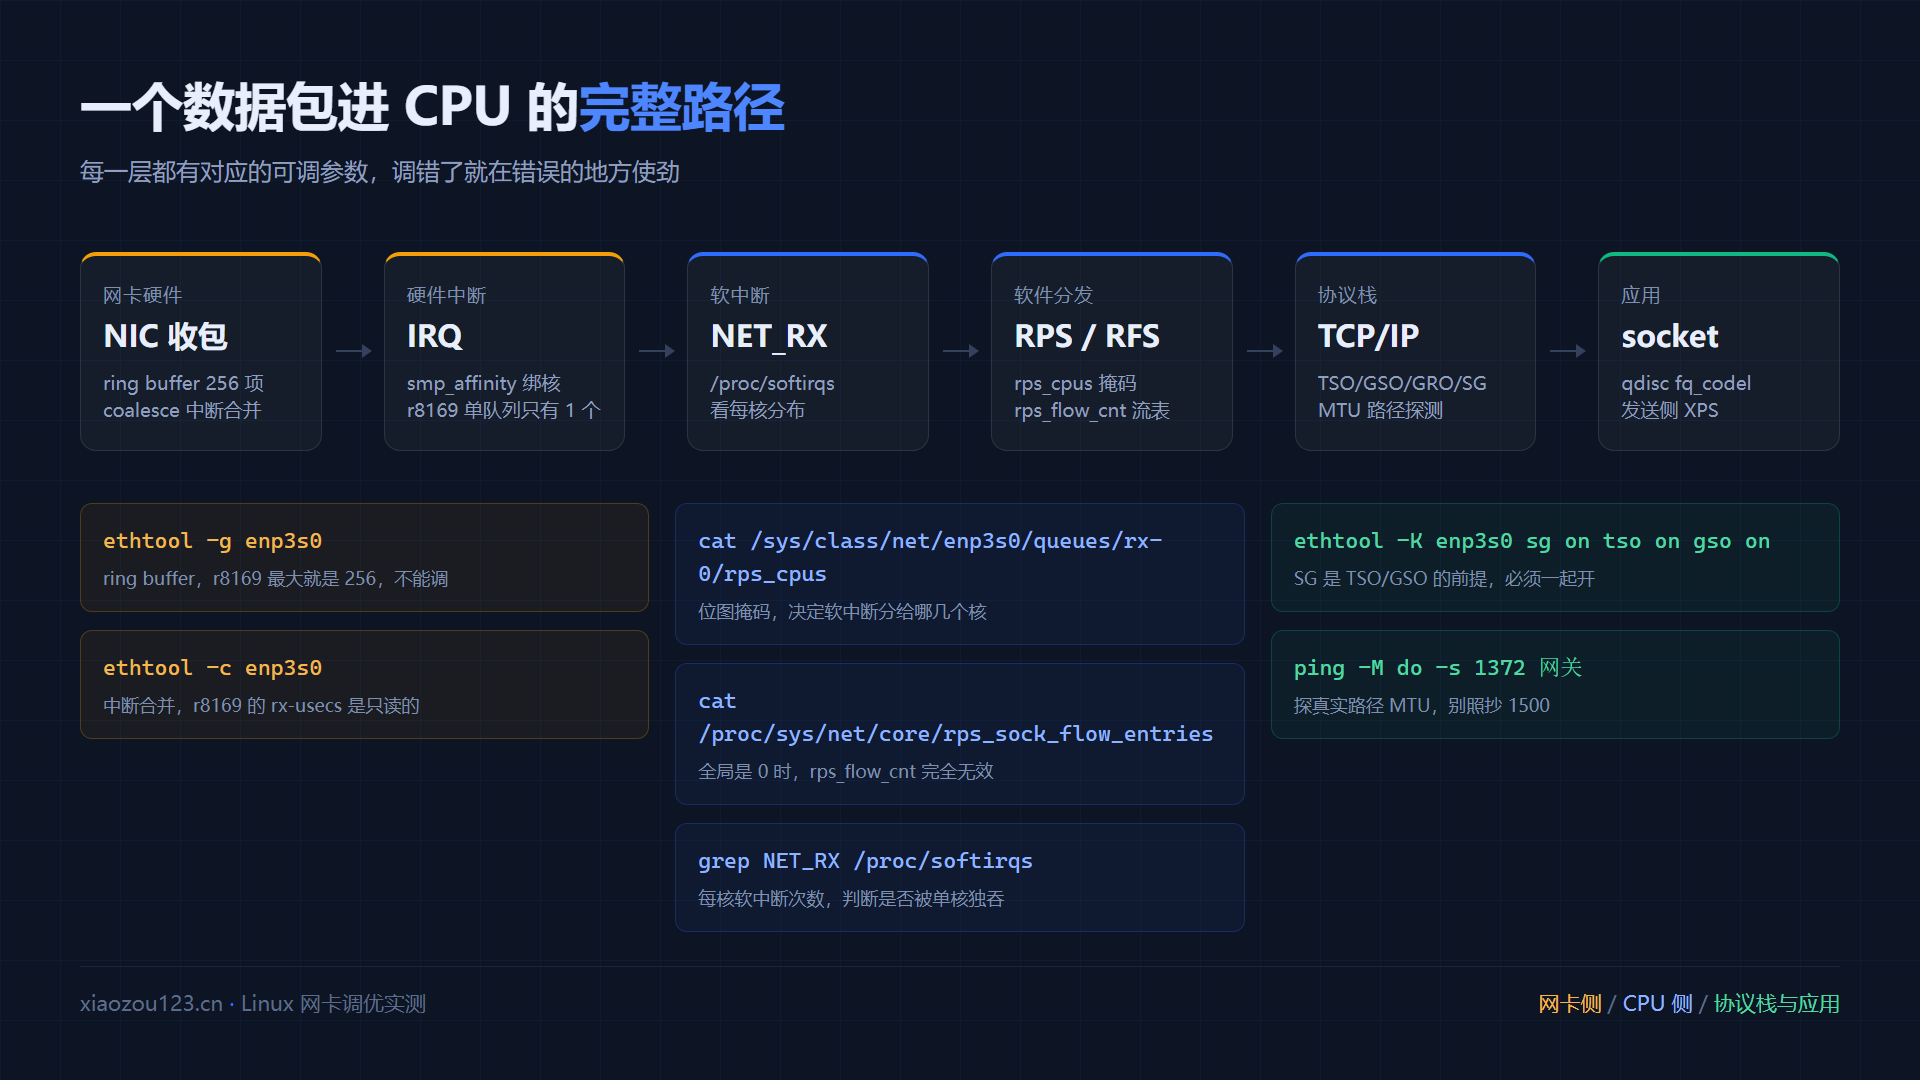
左边三段是网卡侧:ring buffer 决定网卡能缓存多少未处理包,硬中断决定哪个核先知道“来包了”,软中断 NET_RX 才是真正跑协议栈起点的地方。中间三段是 CPU 侧:RPS 负责把包分给别的核,协议栈做 TCP/IP 处理,offload 和 MTU 都在这一层生效。最右边是应用,qdisc 管发包排队,XPS 管发出去的包走哪个核。
第一步永远是量基线,别凭感觉
我这台机器是 i5-8500T 六核,网卡是 Realtek RTL8168H,走内核自带的 r8169 驱动。驱动和芯片信息先确认,后面所有参数能不能调,都取决于它。
ethtool -i enp3s0输出里 driver 是 r8169,firmware-version 是 rtl8168h-2_0.0.2。记住这个型号,下面有两个坑都是它特有的。接下来看链路状态,这里只看三件事:速率、双工、有没有错误计数。
ethtool enp3s0 | grep -E 'Speed|Duplex|Link detected'
ethtool -S enp3s0 | grep -E 'err|drop|miss|collision' | grep -v ': 0$'
ip -s link show enp3s0
我这边 1000Mb/s、Full、Link detected yes,错误计数一条都不剩,说明链路层干净。如果这里出现 rx_crc_errors 或者 rx_errors 持续增长,那才是真硬件问题,网线、水晶头、交换机端口挨个换。这一步能省掉后面一半的瞎折腾。
然后是两个最容易被忽略的软指标。第一个是软中断在核间怎么分布,第二个是网络栈有没有背着错误在跑。
grep NET_RX /proc/softirqs
cat /proc/net/softnet_stat
nstat -az | grep -E 'TcpRetransSegs|TcpExtTCPLostRetransmit|IpInDiscards'
softnet_stat 的每一列都有讲究,第一列是处理的包数,第二列是 drop,第三列是 time_squeeze(软中断一次没处理完就被打断的次数)。我调优前读到的是:CPU5 一个人处理了 769 万次,其余五个核加起来不到 200 次。这就是典型症状,单队列网卡 + 没有 RPS,全网流量堵在一个核上。
MTU:别抄 1500,先探出真实路径
这条我一开始判断错了,值得单独说。我看到网卡 MTU 是 1400,第一反应是“配错了,PPPoE 应该是 1492”。差点就改成 1500。后来用 ping 探了一下路径,脸被打得挺响。
ping -c 1 -M do -s 1372 192.168.100.1
ping -c 1 -M do -s 1420 192.168.100.1
ping -c 1 -M do -s 1420 223.5.5.5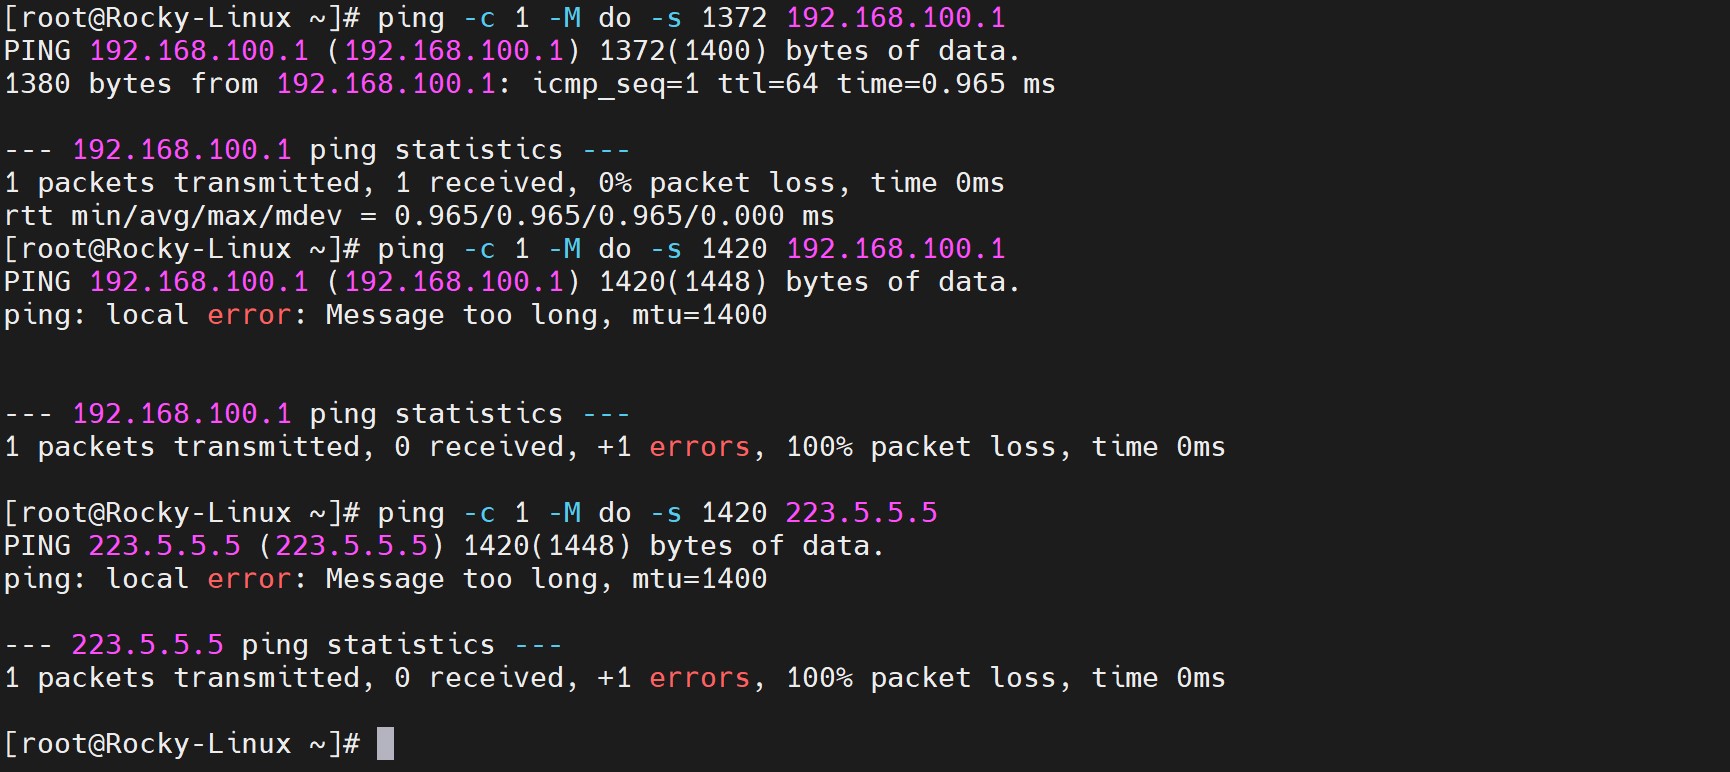
1372 字节载荷(加 28 字节 IP/ICMP 头正好 1400)通,1420 直接报 Message too long, mtu=1400,连网关都过不去,更别说公网。说明上游路径的真实 MTU 就是 1400,路由器那边很可能挂了隧道。这个值不是谁随手写的,是配对了的。改成 1500 会直接 PMTU 黑洞,网页打不开、SSH 卡死,比不改还惨。
所以 MTU 这条的正确姿势是:先量,再定,量不出来就别动。探测的方法就是从大到小二分,找到不报错的那个值,加 28 就是路径 MTU。以太网默认 1500、PPPoE 是 1492、IPsec 和 WireGuard 常见 1420 到 1400,这些都只是起点,不是答案。
offload 四兄弟:SG 是 TSO 和 GSO 的地基
这是整篇里收益最直接的一项。offload 的意思是把本该 CPU 干的活交给网卡硬件干,四个参数之间有依赖关系,很多人只开了其中一半,等于白开。
| 参数 | 全称 | 干什么 | 依赖 |
|---|---|---|---|
sg | Scatter-Gather | 允许网卡直接读写分散的内存块,不做数据拷贝 | 无,它是基础 |
tso | TCP Segmentation Offload | 把 TCP 分段交给网卡,CPU 只提交大块数据 | 需要 sg 打开 |
gso | Generic Segmentation Offload | TSO 的软件兜底版,非 TCP 协议也能用 | 需要 sg 打开 |
gro | Generic Receive Offload | 收包时把小包合并成大包再交给协议栈 | 无 |
我这台机器调优前的状态是:scatter-gather: off、tcp-segmentation-offload: off、generic-segmentation-offload: off [requested on]、只有 gro 是 on。中括号里那句 [requested on] 是内核在告诉你:有人请求开启过,但驱动拒绝了。原因就是 sg 被关着,TSO 和 GSO 没有运行的前提。
所以开启顺序不能反,必须 sg 先上,其余跟上,一条命令里写完也可以,内核会按依赖顺序处理。
ethtool -K enp3s0 sg on tso on gso on gro on
ethtool -k enp3s0 | grep -E 'scatter-gather|segmentation|generic-receive'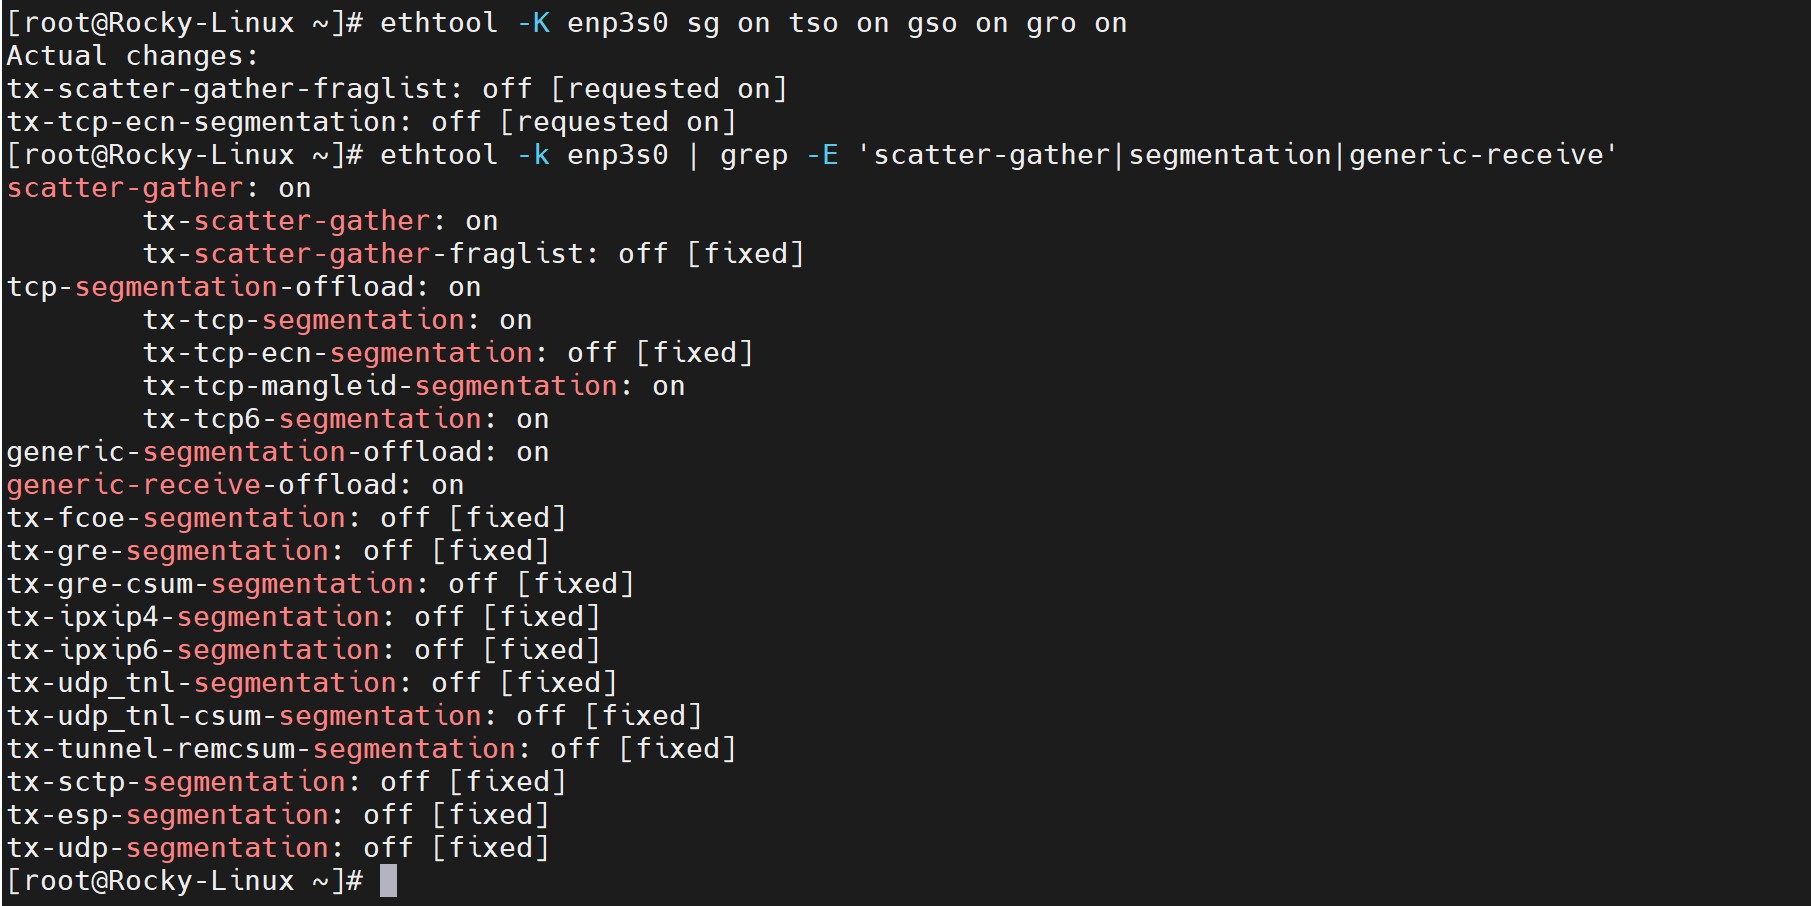
开完再读一遍确认,四个都得是 on。如果 gso 还是显示 [requested on],基本就是驱动不支持,别折腾了。效果可以从平均包大小直接看出来:我这边开之前平均 795 字节一个包,开之后变成 1479 字节,说明 GRO 真的在合并,协议栈要处理的包数少了一截。
r8169 有个历史包袱要提一句:老的 RTL8168B/C 系列在某些内核上开 TSO 会出现数据损坏,所以不少发行版和教程默认把它关掉。RTL8168H 这一代相对安全,我开了之后跑了几个小时没有异常,但如果你用的是更老的芯片,开完先用 ping -f 和大文件传输压一阵,确认没 CRC 错误再上生产。
中断与 RPS:把软中断从单核里抠出来
先说一个前提:网卡有多少个接收队列,决定了你能玩到什么程度。r8169 是单队列,numrxqueues 1,意味着硬件中断只有一个入口,天生就只能绑到一个核上。这一点改不了,能改的是硬中断之后那段。
grep enp3s0 /proc/interrupts
cat /sys/class/net/enp3s0/queues/rx-0/rps_cpus
中断号是 127,smp_affinity 是 20,这是个十六进制位图,20 表示第 5 位,也就是绑在 CPU5 上,可以用 lscpu 的编号对一下,别数错。我用 top 看了下,改之前 si 占 9.2%,其中绝大部分集中在 CPU5。
RPS 就是来解决这个的。它不改硬件,而是在硬中断收下包之后,按四元组 hash 算一个目标核,把包塞进那个核的 backlog,发 IPI 叫醒它处理。CPU5 只负责入队,真正的协议栈处理分散到别的核。
# 分发到 CPU0-4,把 CPU5 留给硬中断
echo 1f | tee /sys/class/net/enp3s0/queues/rx-0/rps_cpus
掩码是位图,1f 是 CPU0 到 CPU4 全开,3f 连 CPU5 也一起。我这里把 CPU5 排除掉,是因为它还扛着硬中断,再把软中断压上去没意义。设完十秒内就能看到变化,用这个命令读每核软中断次数:
grep NET_RX /proc/softirqs
改之前是 CPU5 一个人扛 769 万次。改之后按十秒采样算,CPU5 只占 62%,CPU0 占 14%、CPU4 占 13%、CPU2 占 10%,剩下两个核吃零头。硬中断独占率从 100% 掉到 62%,瓶颈解除。
这里有个反直觉的地方要提前打预防针:si 的总占比会上升。我这边从 9.2% 涨到 13.8%,看着像变差了。原因是 RPS 跨核转发本身要付 enqueue 和 IPI 的开销,而且采样时吞吐也更高了。判断标准不是总 si,而是单核有没有饱和——CPU5 现在硬中断 10%、软中断 7.8%,整体 busy 27.6%,离顶满差得远。
新问题紧跟着来了:CPU4 的 softirq 冲到 36.2%,成了新热点。这是纯 hash 分布的固有毛病——机器上就几个长连接的大流量,四元组 hash 算下来正好都落在 CPU4 那一位。flow 越少,分布越偏。这个没法靠调参数根治,只能靠打散掩码缓解,或者接受它。
RFS 和 rps_flow_cnt:一个绝大多数人设错的参数
RPS 只按 hash 分,不管哪个核在跑对应的应用线程。RFS 是它的加强版,以“哪个 CPU 正在处理这个 socket”为准来分发,好处是软中断和应用线程在同一个核上,缓存命中率高。要记住“这个流上次由谁处理”,就得有张表,rps_flow_cnt 就是每队列允许记录多少条流。
cat /proc/sys/net/core/rps_sock_flow_entries
cat /sys/class/net/enp3s0/queues/rx-0/rps_flow_cnt
关键在这:rps_flow_cnt 单独设置没有任何作用,它的前提是全局的 rps_sock_flow_entries 大于 0。我一开始让 rps_flow_cnt 设成 512 是白设的,因为全局那个值是 0,RFS 根本没启用,内核在这个队列上只做纯 RPS hash。网上一堆文章只教你设前者不提前者,照抄就是不生效。
# 两个一起设才生效,队列数 = 1 所以给满就行
sysctl -w net.core.rps_sock_flow_entries=32768
echo 32768 | tee /sys/class/net/enp3s0/queues/rx-0/rps_flow_cnt
如果你的网卡有多个接收队列,rps_flow_cnt 应该按 全局值 / 队列数 来分,别每个队列都给满,表会爆。不过说实话,这台机器上 RFS 的收益我持保留意见:真正跑流量的是容器里的 Java 进程,socket 待在容器自己的 network namespace 里,RFS 记的 CPU 亲和跨 netns 命中率会打折。裸机跑单进程服务时它才香。
ring buffer 和 coalesce:先确认驱动让不让你改
这两个参数最容易被教程吹上天,实际在消费级网卡上经常是只读的。先读一遍再动手。
ethtool -g enp3s0
ethtool -c enp3s0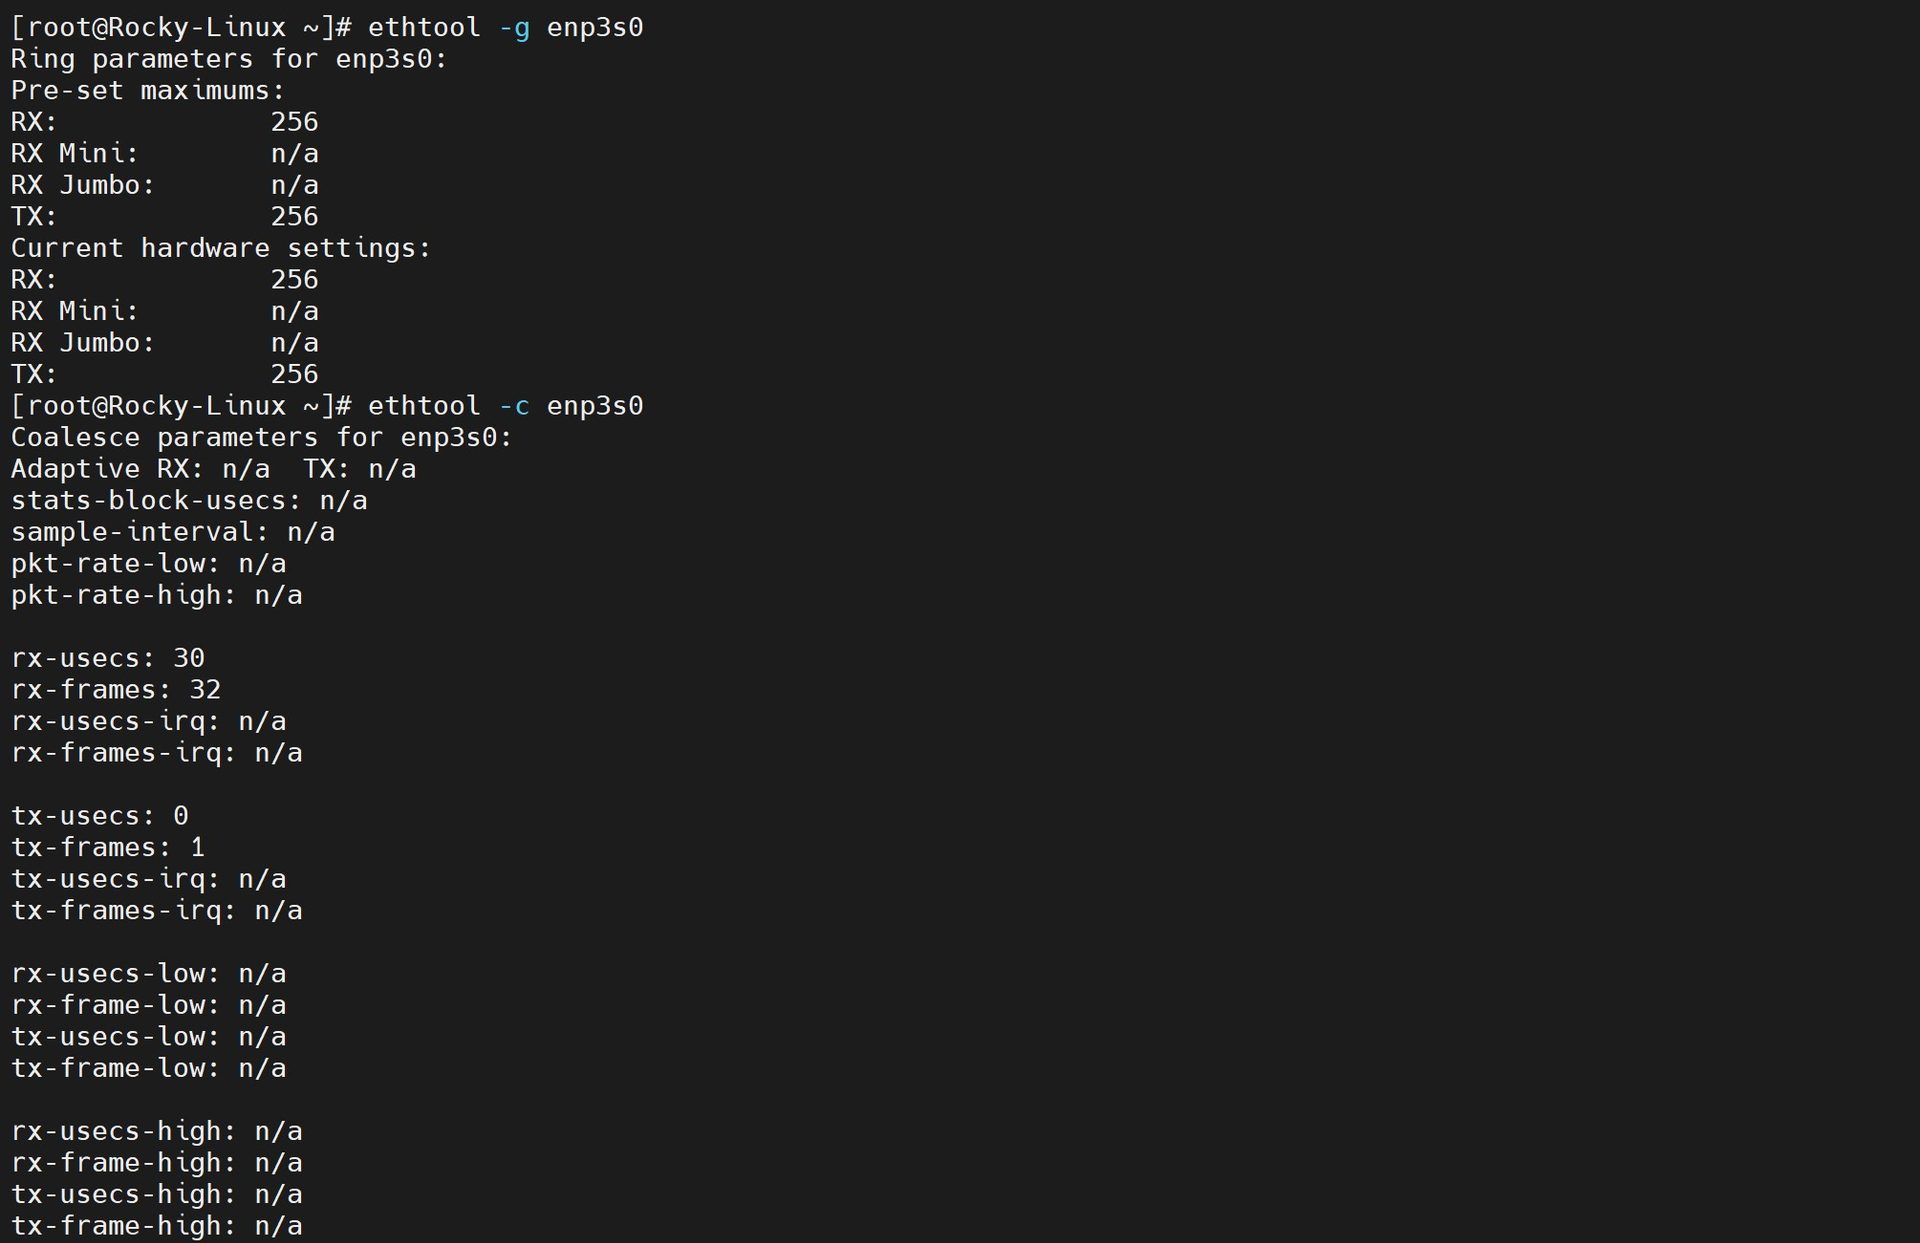
ring buffer 我这边是 RX 256 / TX 256,而且 Pre-set maximums 里最大也就是 256,没有任何调整空间。千兆以下一般够用,2.5G 以上就得换网卡了。
中断合并那边读到 rx-usecs: 0、rx-frames: 1,意思是每来一个包就发一次中断,不做任何聚合。理论上调成 rx-usecs 30 能大幅降低中断频率,但 r8169 的 coalesce 参数是只读的,Adaptive RX 显示 n/a 已经说明了。硬要写会直接报 Cannot set coalesce。所以这条在我这儿属于看得到摸不着,想做只能换驱动(r8168 厂商驱动)或者换硬件。
qdisc 与发送侧:fq_codel 够用,别乱换
收包方向调完,发包方向其实没那么讲究。
tc qdisc show dev enp3s0
默认就是 fq_codel,配合 qlen 1000,对千兆口足够。真想上花活可以换 cake,但那是给软路由做整形准备的,一台跑容器的服务器没必要。发送侧真要调就调 XPS,把发包队列绑到固定的核上,减少跨核迁移。
# 单队列网卡只有 tx-0,XPS 收益有限,做之前先看队列数
ls /sys/class/net/enp3s0/queues/
我这边队列目录里只有 rx-0 和 tx-0,单队列结构,XPS 能做的事情基本为零,直接跳过。
验收:用数据判断,不用手感判断
调完之后最忌讳的是“感觉快了”。我的验收方式是固定窗口采样,同一套命令改前改后各跑一次,看同一批指标。
# 吞吐(5 秒窗口)
R1=$(cat /sys/class/net/enp3s0/statistics/rx_bytes)
sleep 5
R2=$(cat /sys/class/net/enp3s0/statistics/rx_bytes)
echo "$(( (R2-R1)*8/5/1000000 )) Mbps"
# CPU 各时间片占比(10 秒窗口)
awk '/^cpu /{print $2,$3,$4,$5,$6,$7,$8,$9}' /proc/stat
sleep 10
awk '/^cpu /{print $2,$3,$4,$5,$6,$7,$8,$9}' /proc/stat
两次输出对应字段相减就是这十秒的真实占比。我这轮的完整对比:
| 指标 | 调优前 | 调优后 | 说明 |
|---|---|---|---|
| 接收速率 | 895 Mbps | 923–967 Mbps | 贴近千兆线速 |
| 平均包大小 | 约 795 B | 1479 B | GRO 合并生效 |
| CPU5 软中断占比 | 100%(769 万次累计) | 62% | RPS 分摊 |
softirq 总占比 | 9.2% | 13.8% | 跨核转发有固定开销 |
user 占比 | 7.7% | 3.4% | 分段交给网卡了 |
system 占比 | 5.5% | 2.8% | 同上 |
idle | 76.0% | 78.2% | 整体更闲 |
rx_dropped | 646 | 2723 | 占比百万分之三,可忽略 |
注意 softirq 那行是涨的,user 和 system 是降的,总 busy 反而从 23.9% 降到 21.9%。这就是 offload 的本质:把 CPU 上的活挪到网卡上,代价是软中断次数变多。只看 si 涨了就以为调坏了,是把收益当成了损失。
重启就没了:怎么把这些设置留住
上面所有命令都是临时的,重启全部还原。要持久化有两个办法,我更推荐前者,因为它能保证网卡一有状态变化就重新应用,而不是开机时抢跑。
# 文件内容:/etc/NetworkManager/dispatcher.d/90-nic-tuning
#!/bin/bash
IFACE="$1"
[ "$IFACE" = "enp3s0" ] || exit 0
ethtool -K enp3s0 sg on tso on gso on gro on
echo 1f | tee /sys/class/net/enp3s0/queues/rx-0/rps_cpus
内容写好后给可执行位,这一步漏了脚本永远不会跑,而且 dispatcher 不报错,只会在 journal 里留一行权限不足。
chmod +x /etc/NetworkManager/dispatcher.d/90-nic-tuning
journalctl -u NetworkManager -n 20 | grep -i tuning
脚本会被 NetworkManager 以 root 身份调用,第一个参数是网卡名,第二个是动作。必须加可执行位,否则 dispatcher 直接跳过不报错,这个坑我踩过——放进去没生效,查了半小时才发现是权限。
另一个办法是 systemd unit,用 After=network-online.target 挂在网络就绪之后。缺点是开机那一次如果网卡还没完全起来,命令会失败且不重试,不如 dispatcher 稳。真要写 unit 的话记得加 Restart=on-failure。
最后:网卡调优能修什么,修不了什么
把话说透。这套调整能解决的是 CPU 被软中断打满、单核成为瓶颈、满速时吞吐抖动这几类问题。它修不了带宽不够、线路质量差、上游限速、以及对端服务器慢。我这台机器测速只有 300M,根因是机器上跑着一个满速吃流量的容器,出口被自己占满,网卡一点毛病没有。
所以顺序永远是:先确认链路干净、先查有没有东西在占带宽,再谈调优。上来就 ethtool -K 一顿开,大概率是在错误的层解决不存在的问题。参数值得反复打磨这句话没错,但前提是你知道自己在打磨哪一段。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING