

先说结论:大部分人的 SQM 配了跟没配一样
我见过太多 SQM 配置是这样:勾了启用、选了接口、上下行填了两个数字,然后就没然后了。速度确实降了一点,游戏该卡还是卡。问题不在 SQM 本身,在于这套东西是三个互相依赖的子系统,任何一个填错,整条链就是断的,而且断了不报错。
这篇把 iStoreOS(OpenWrt)里 网络 → SQM QoS 三个页签的 22 个参数逐条拆开讲:每个参数管什么、该填多少、填错的后果是什么。前面两节讲原理,如果你只想要参数,可以直接跳到第三节。
先说清一件事——SQM 不增加带宽,它只是让延迟少一点。我这台机器之前测过的记录是:2000M/150M 线路,单台 PC 有线接路由器,waveform 压力测试,无 SQM 时满载延迟增量 +59.9ms,开 CAKE 双向整形后降到 +0.4ms。代价是下行从 2262 Mbit/s 掉到大约 1950 Mbit/s。这个交易值不值,取决于打不打游戏、开不开视频会议。
Bufferbloat 到底发生在哪一段
带宽跑满的时候 ping 从 9ms 涨到 300ms。多数人第一反应是路由器性能不够,我一开始也这么以为,还去查了 CPU 占用,结果才 30%。延迟根本不产生在路由器里。路由器的转发是线速的,包离开网卡就提速了,真正排队的地方是运营商的 OLT 或上游交换机的缓冲区,那玩意儿深到几百毫秒。你控制不了它,也看不到它,唯一能做的是在包流进那个缓冲区之前,自己先用一个更小的速率往外发。这就是整形(shaping)的全部含义——把瓶颈从运营商手里抢回自己路由器上,让它变成一个你能配置、能观测、能丢包的队列。
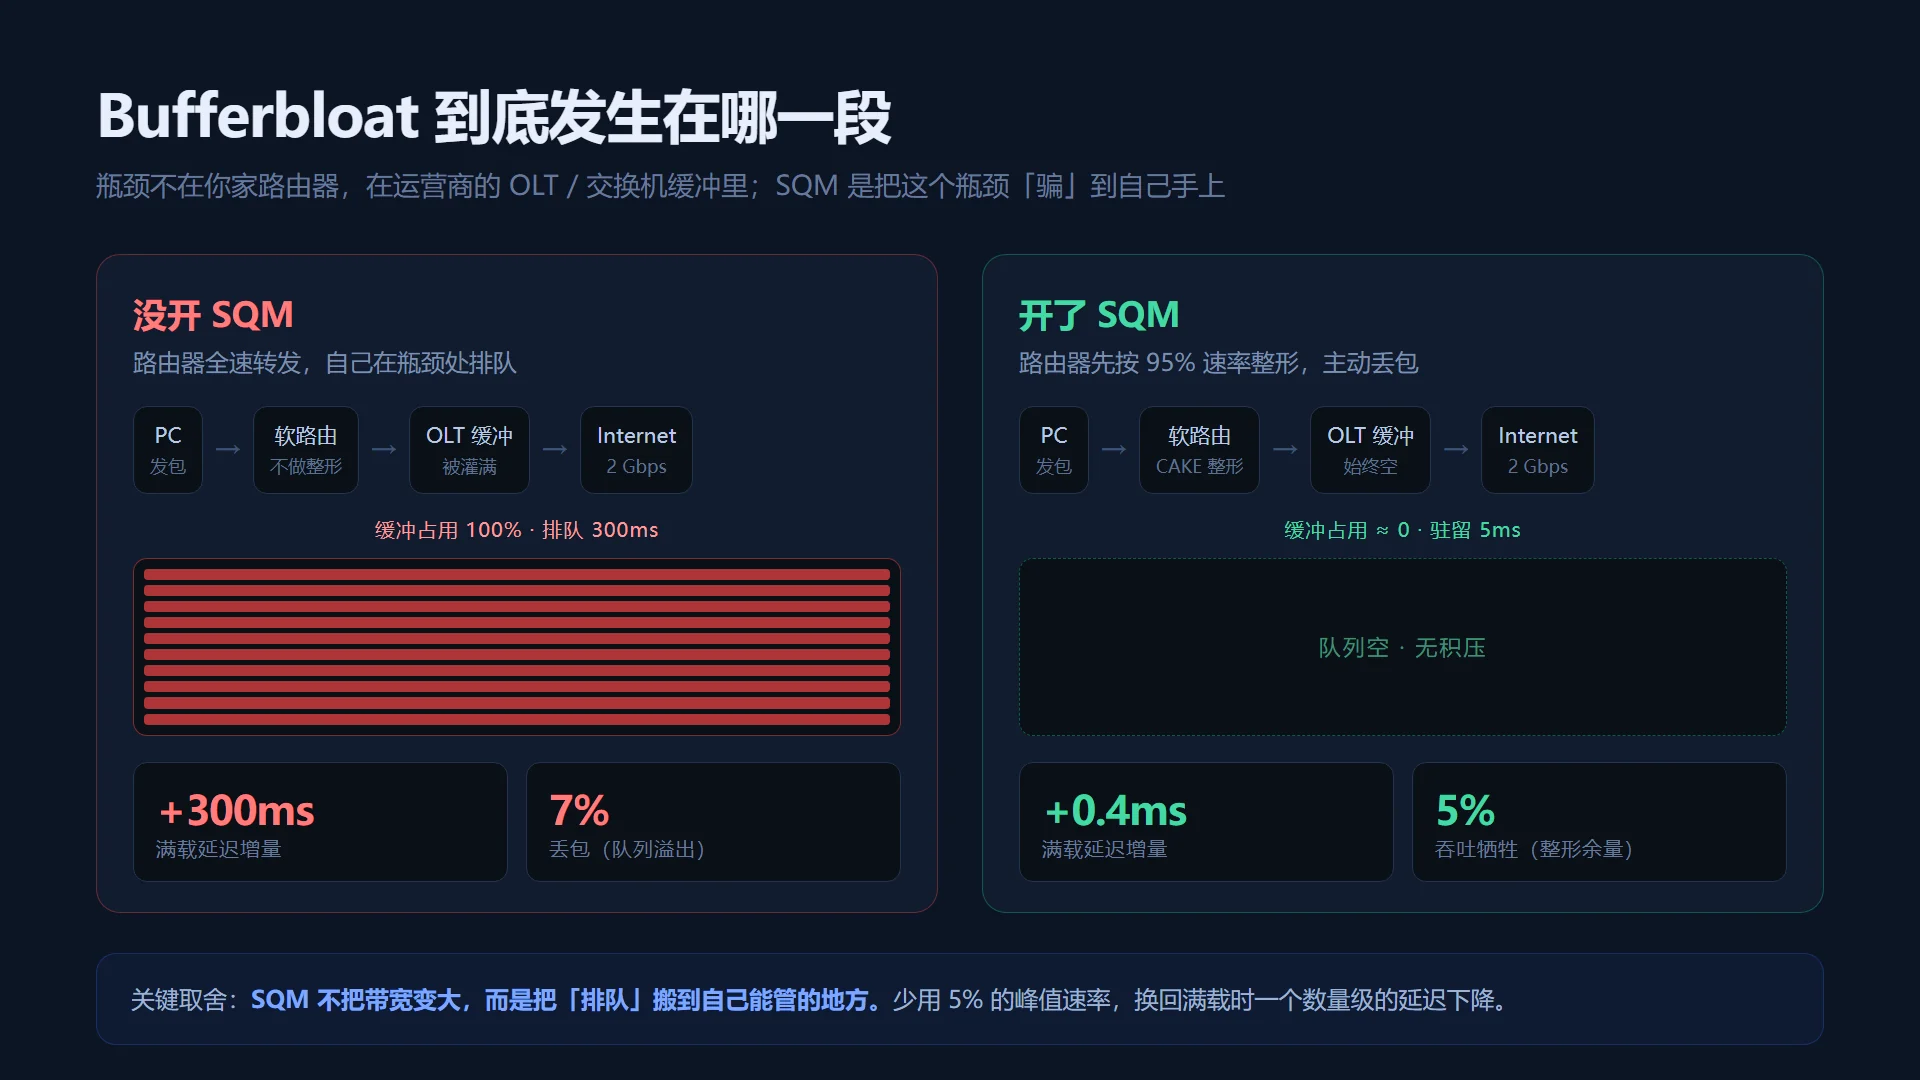
代价必须说清楚:整形速率设成物理速率的 95%,意味着你永远跑不满那 5%。加上封装开销的修正,实际测速会比不开 SQM 低 8% 左右。这是买延迟稳定付的钱,不是配置出错。
三个页签,三组参数,缺一条链就断
LuCI 里这三个页签不是「进阶设置」的层层递进,它们是三个正交的职责:
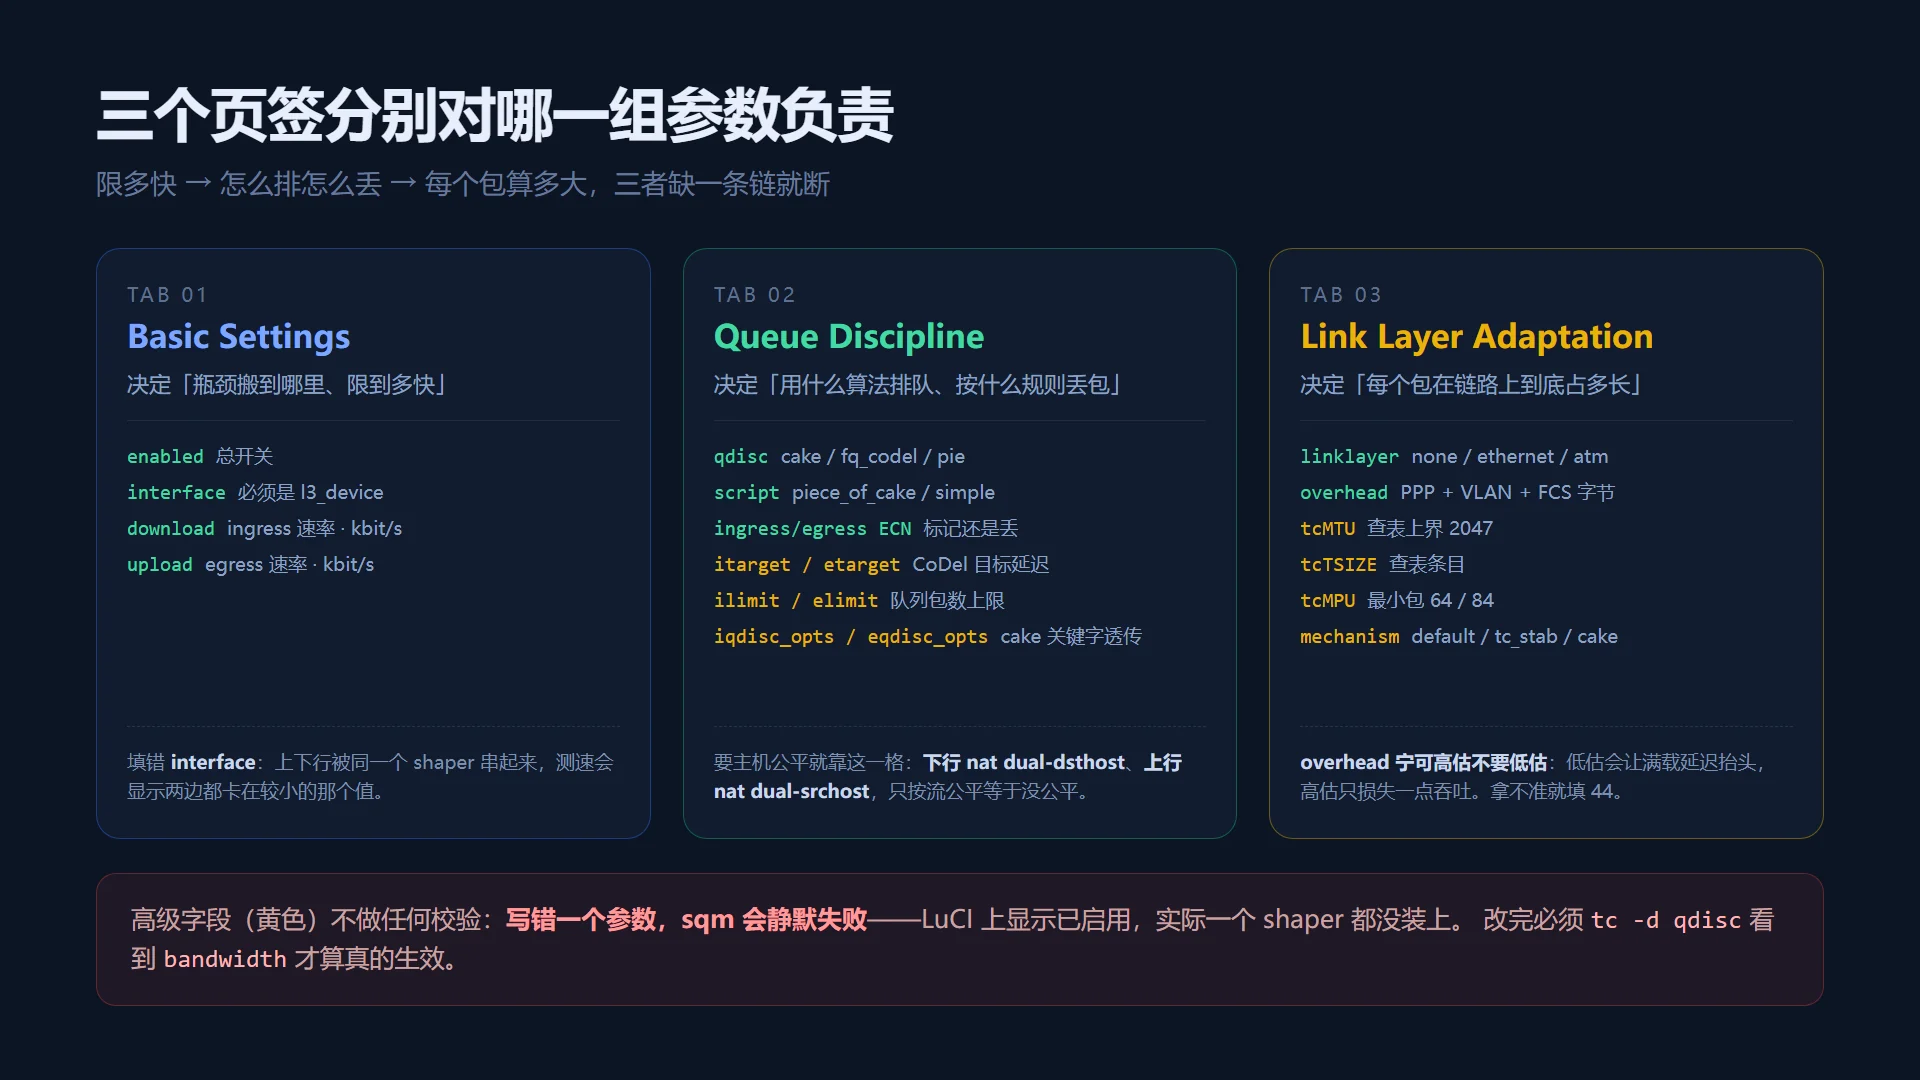
- Basic Settings 决定瓶颈搬到哪里、限到多快。
- Queue Discipline 决定包进来之后怎么排队、按什么规则丢。
- Link Layer Adaptation 决定每个包在链路上到底占用多少时间。
前两个填错,症状是「速度不对」或者「延迟还是高」。第三个填错最阴——大包不受影响,小包被系统性低估,表现是「下载跑满了,但游戏和语音照旧卡」,而且你从测速网站上看不出任何异常。
Basic Settings:整形器本身
Enable
勾选之后还要点「保存并应用」才会真正重跑 /etc/init.d/sqm 的重启流程。只勾不应用,配置文件改了、内核里什么都没发生。
Interface
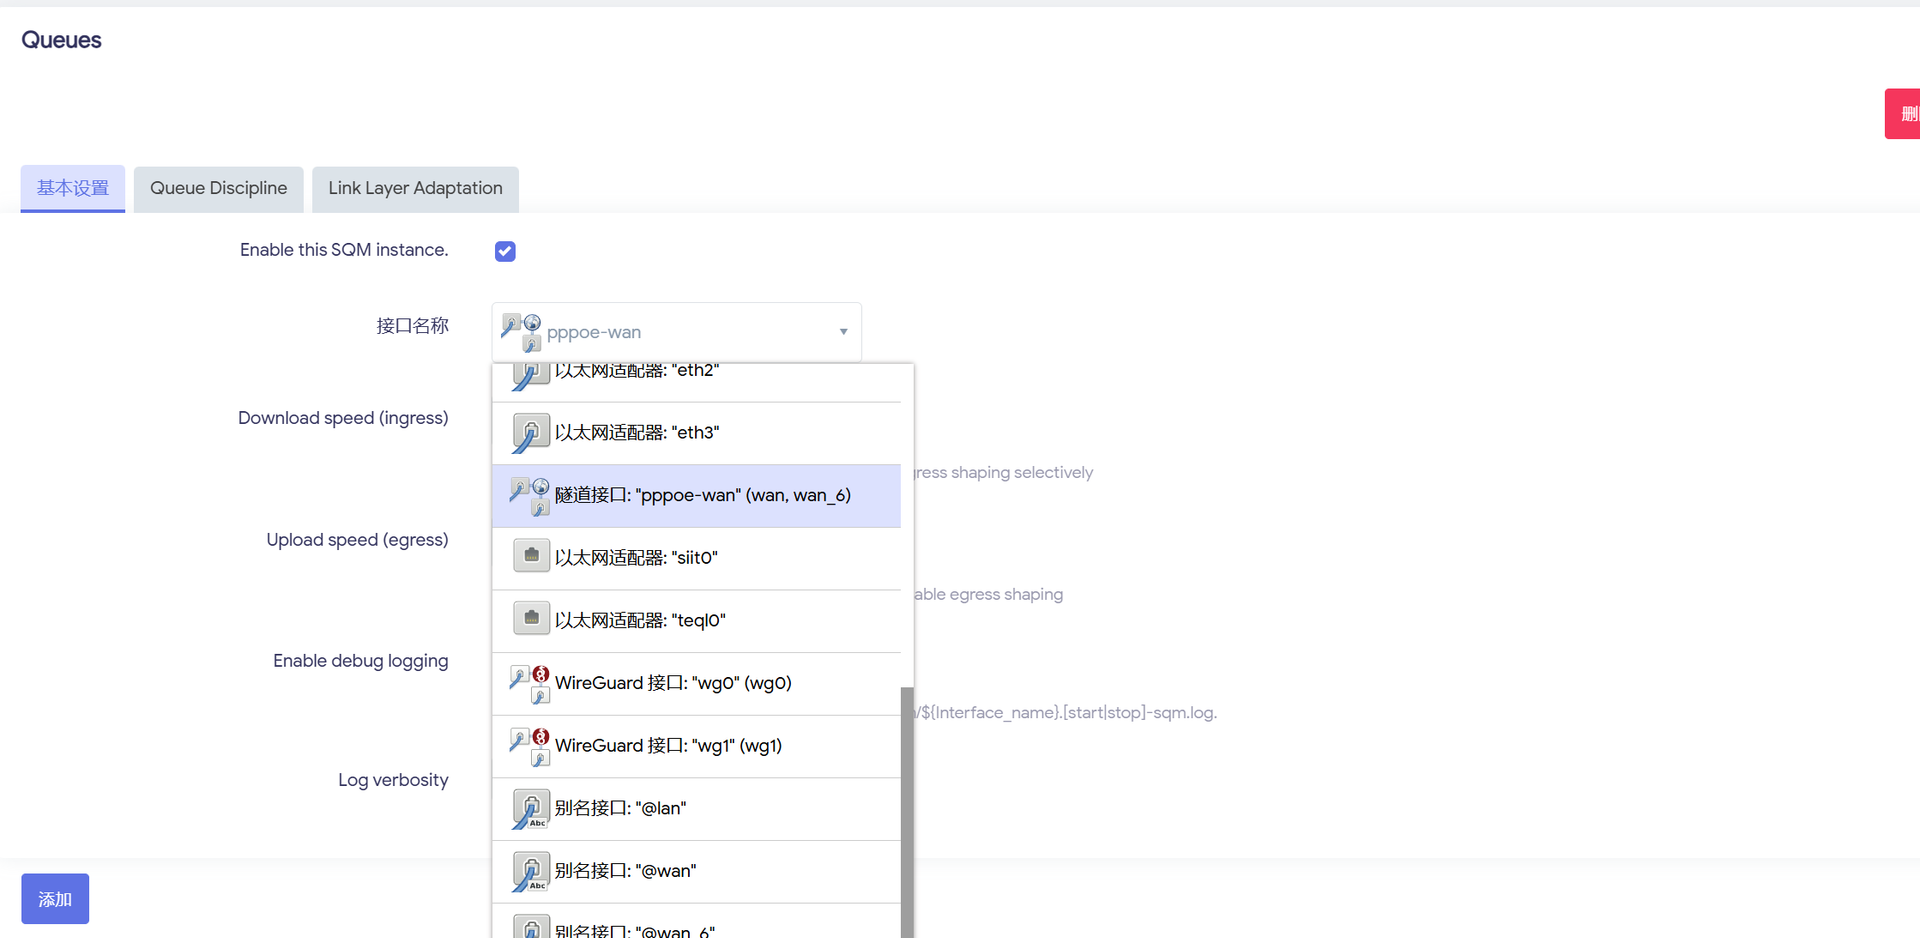
最容易填错的一项。这里要选真正承载 WAN 三层流量的那个设备,不是物理网口。PPPoE 拨号的机器上,答案是 pppoe-wan,不是 eth1,也不是 wan。查法:
ifstatus wan | grep l3_device返回 "l3_device": "pppoe-wan",就选它。
选错的后果很多人理解反了:如果你选成底层 eth0,上行整形(挂在 eth0 的 egress)会同时作用于 PPPoE 的发出方向,而下行整形又通过 ifb 绕回 eth0,两个方向被串到一起,最终上下行都被压到两者中较小的那个值。表现出来就是「我填了 1000/50,测速只有 50/50」。
另一个坑是单网口交换机做 WAN 的机器(eth0.2 这种 VLAN 子接口):必须选 VLAN 子接口。选 eth0 会把 LAN 方向的流量一起限了。
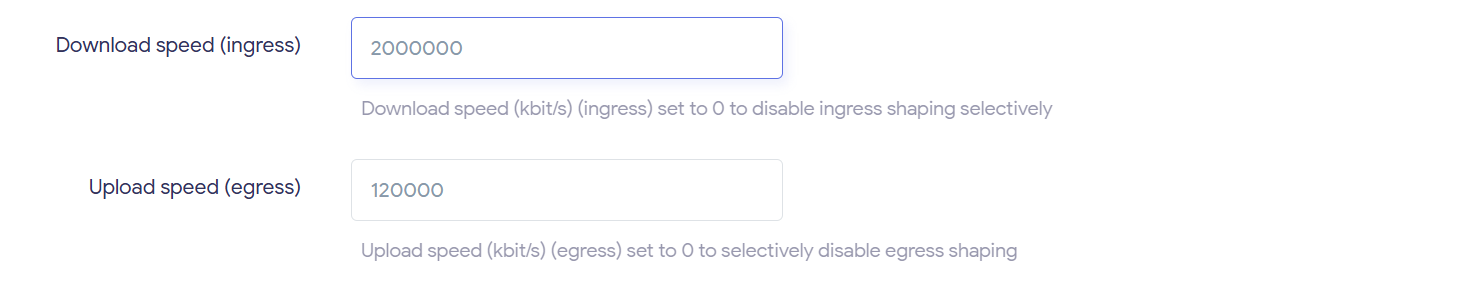
Download speed (kbit/s) 与 Upload speed (kbit/s)
这里填的是 gross 速率(含链路封装开销),而测速网站报的是 goodput(TCP 载荷)。两者差一个固定比例:
goodput ≈ gross × (1500 - 20 - 20) / (1500 + overhead)overhead 取 44 的时候,goodput 比 gross 低 5.5% 左右。所以填 100% 必然炸,填 90% 是给这层误差留余量。
具体取值:先在关闭 SQM 的情况下测出净速率,然后填它的 85% ~ 95%。想榨到极限就按二分法来——从 50% 起步,先只抬 upload,一直抬到 waveform 报告的 latency under load 的 95% 分位数开始明显抬头(比如从 +1ms 跳到 +20ms),回退一档;锁定 upload 之后再抬 download。DSL 线路要注意反直觉的一点:ATM 分帧有大约 9% 的额外开销,最终取到的 shaper 速率可能比测速值还高,这是正常的。
两个字段都可以单独设 0 来关掉一个方向。只做上行整形在某些场景(比如上行窄、下载用不满)是合理的,但如果你发现下载时的延迟照样飙,那是下行没管。
Queue Discipline:排队和丢包的规则
先理解下行为什么要绕一圈 ifb
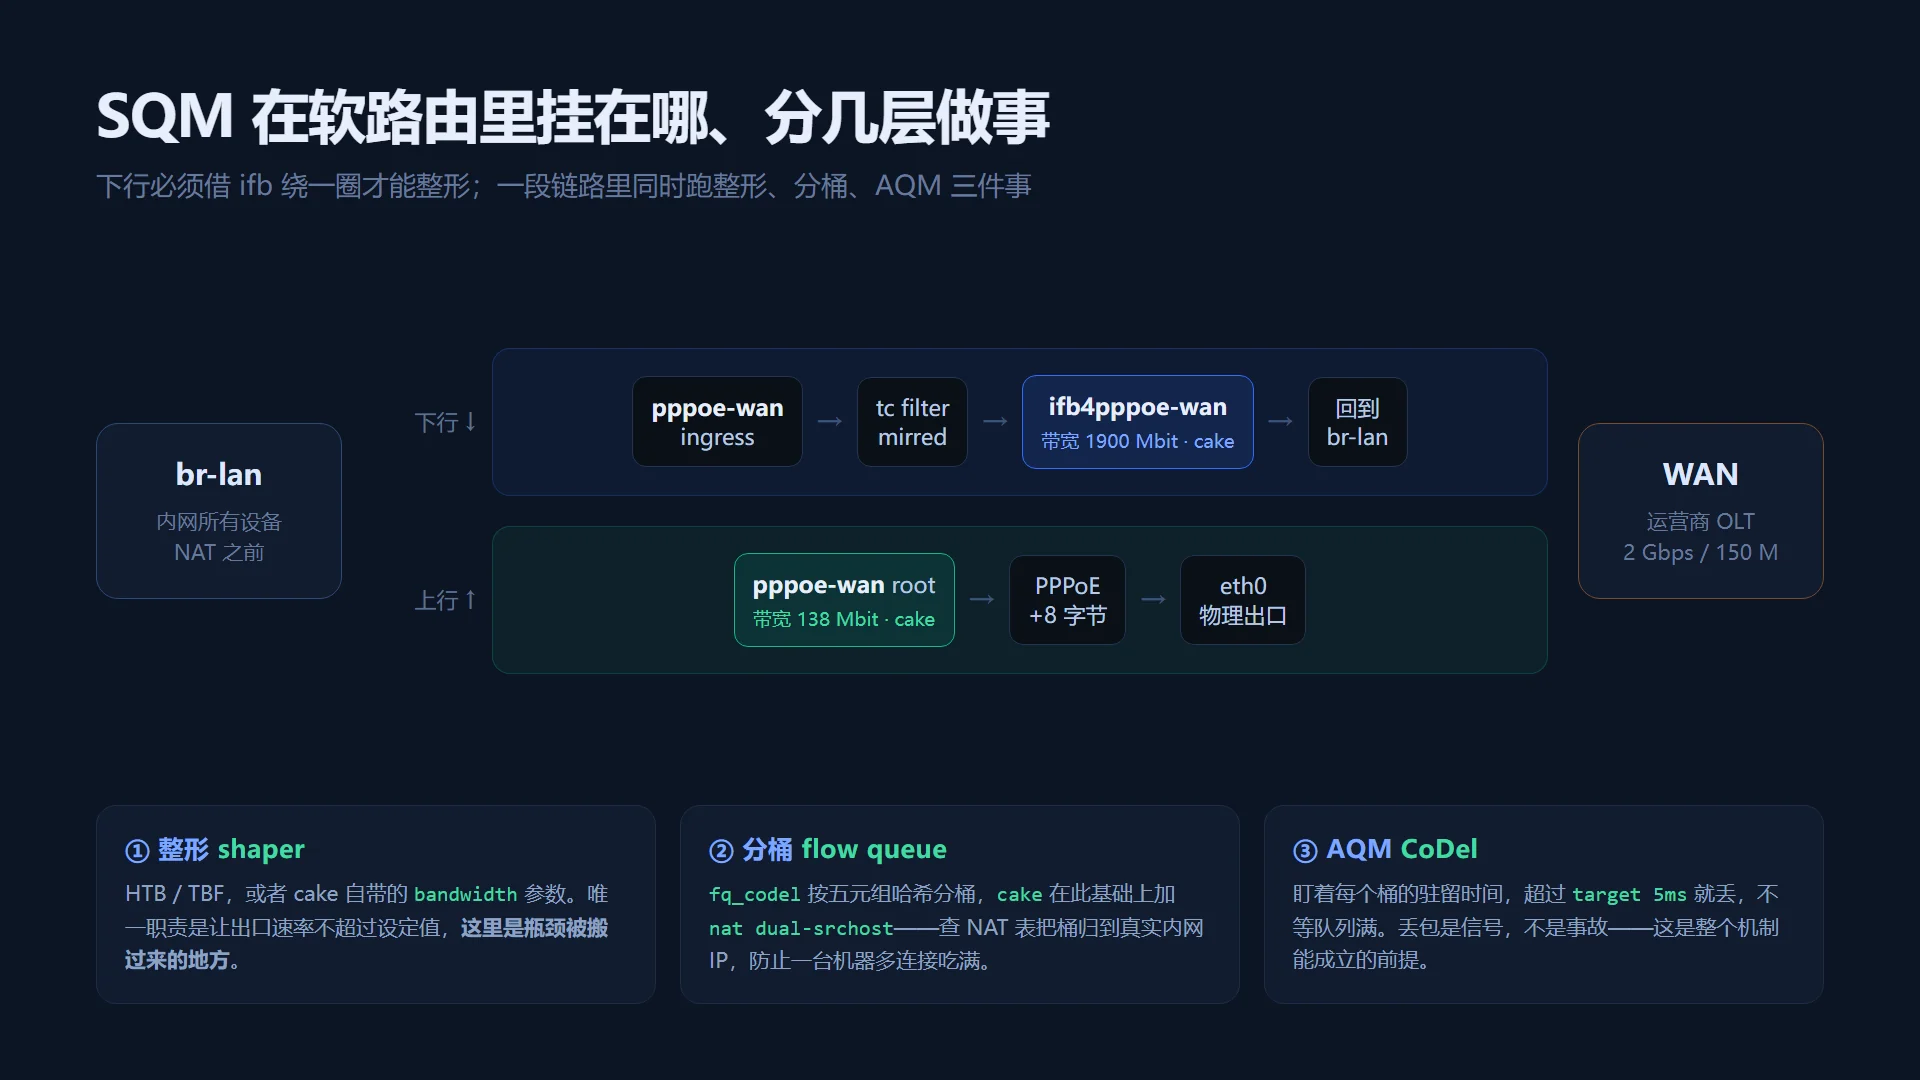
Linux 的 tc 队列规则只能挂在设备的 egress 上。而下载流量是 ingress 方向——包从 WAN 口进来,还没进任何队列就已经被交给协议栈了。所以下行整形的唯一实现路径是:在 pppoe-wan 的 ingress 上挂一个 tc filter,把包 mirred 重定向到一块虚拟网卡 ifb4pppoe-wan,然后在那块网卡的 egress 上挂整形器。绕一圈,但这是内核给的正路。
你不需要手动配置这一步,sqm-scripts 会自动建 ifb 设备和 filter。但你要知道它存在,因为后面查 tc 状态时看的是 ifb4pppoe-wan 而不是 pppoe-wan。
顺带一提,一段链路里同时跑着三件事:整形(限速)、分桶(按流或按主机公平分配)、AQM(按驻留时间丢包)。cake 把三件事做在一个 qdisc 里,fq_codel 只做后两件、需要外面套 HTB 或 TBF 来限速。
Queueing Discipline(qdisc)
| 选项 | 说明 |
|---|---|
| cake | 默认,也是绝大多数情况唯一该选的。自带整形、自带 per-flow 公平、自带 DRR 分层、能看穿 NAT、能做主机级隔离。代价是吃 CPU |
| fq_codel | 老牌,更省 CPU。CPU 受限时实测吞吐能比 cake 高 15% 左右,但少了主机隔离和优先级分层 |
| pie | 单队列 AQM,无 per-flow 公平,家庭场景基本不用 |
| codel | 同上,更原始 |
| sfq | 纯公平队列,没有 AQM,不控延迟,只适合做带宽分配 |
| ns2_codel / efq_codel / nfq_codel | 实验性或特殊用途,别碰 |
选哪个,看 CPU 余量。判断方法在最后一节。

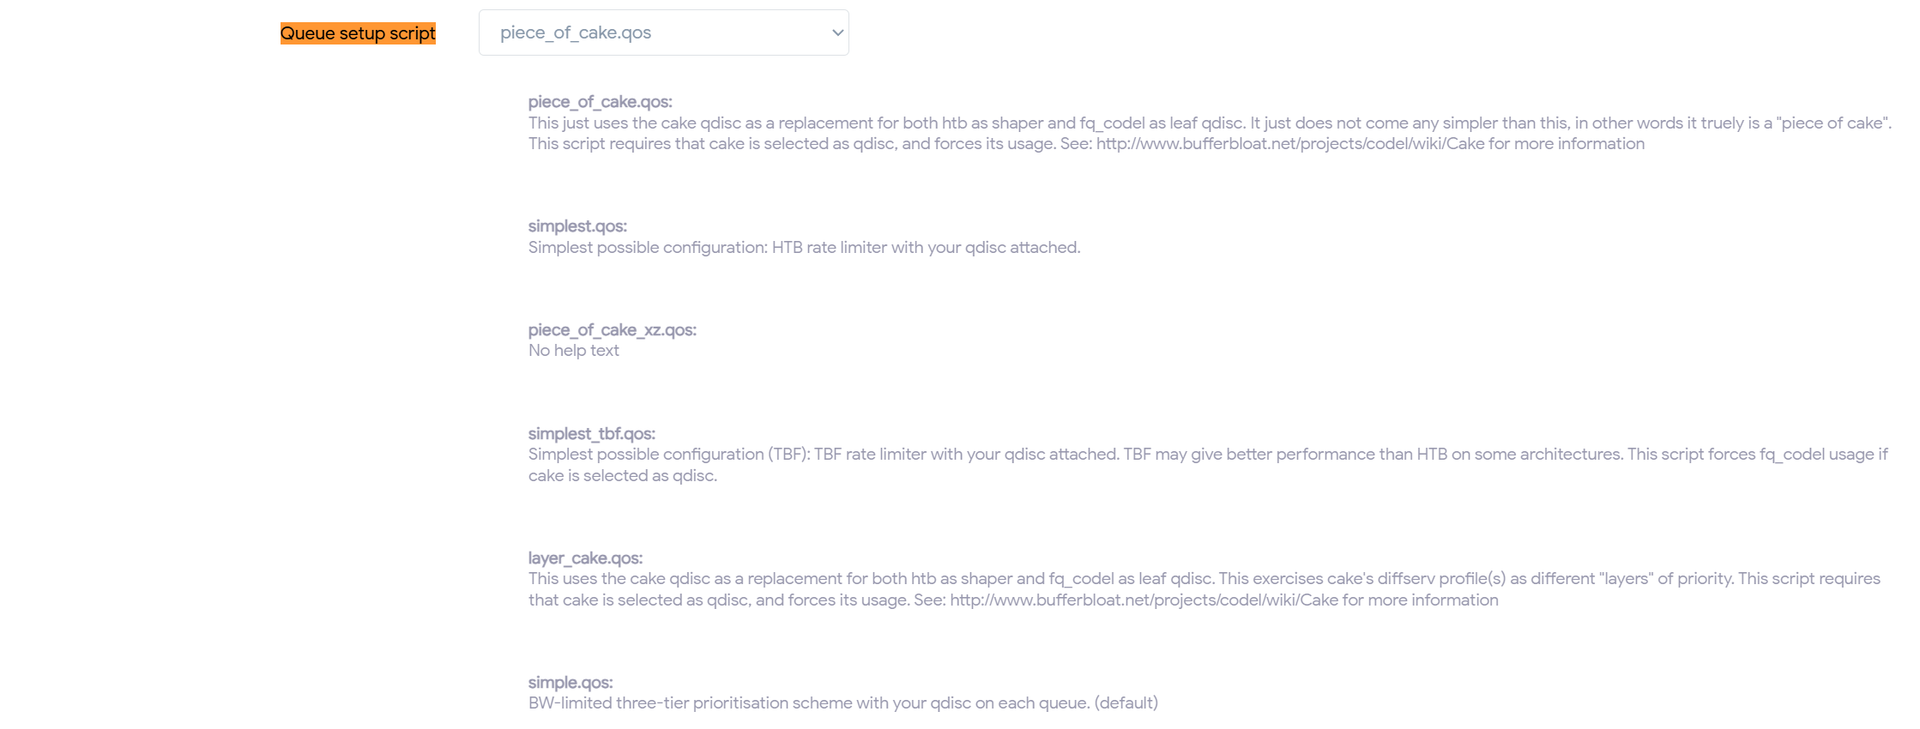
Queue Setup Script
qdisc 决定「用什么算法」,script 决定「怎么把包分进队列」,两层是分开的。
| 选项 | 说明 |
|---|---|
| simple.qos | 三层优先级(Bulk / Best Effort / Priority),每层下面挂 fq_codel。真 QoS,靠 DSCP 分优先级 |
| simplest.qos | 一个 HTB 限速加你的 qdisc,无任何优先级。最省 CPU |
| simplest_tbf.qos | 同上但限速器用 TBF,某些架构上比 HTB 快。CPU 吃紧时优先试这个加 fq_codel |
| piece_of_cake.qos | cake 自带整形,不额外套 HTB。和 cake 搭配的正确选择 |
| layer_cake.qos | 用 cake 的 diffserv 分级当真优先级层。想按 DSCP 分 tin 才选它 |
家庭网络里 simple.qos 的三层优先级其实很难发挥——优先级要靠 DSCP 标记,而家用流量基本没人标。所以它的实际效果约等于 fq_codel 加限速。真正想分优先级,应该选 cake 加 diffserv4,那是更现代的玩法。
ECN:标记还是直接丢
两个字段,ingress 和 egress 独立。ECN 是拥塞时给包打标记而不是扔掉,让对端自己降速,避免重传,NOECN 就是直接丢。
luci-app-sqm 的默认是 ingress 用 ECN、egress 用 NOECN。逻辑是:上行方向的丢包发生在你自己的缓冲里,比标记更快更省事;下行方向标 ECN 能让远端发送端提前减速,减少反灌进运营商缓冲的量。这个默认值历史上改过几次,wiki 上两处说法也不一致,所以别把它当铁律。遇到特定站点慢或者握手卡顿,先把 egress 改成 NOECN 试试。
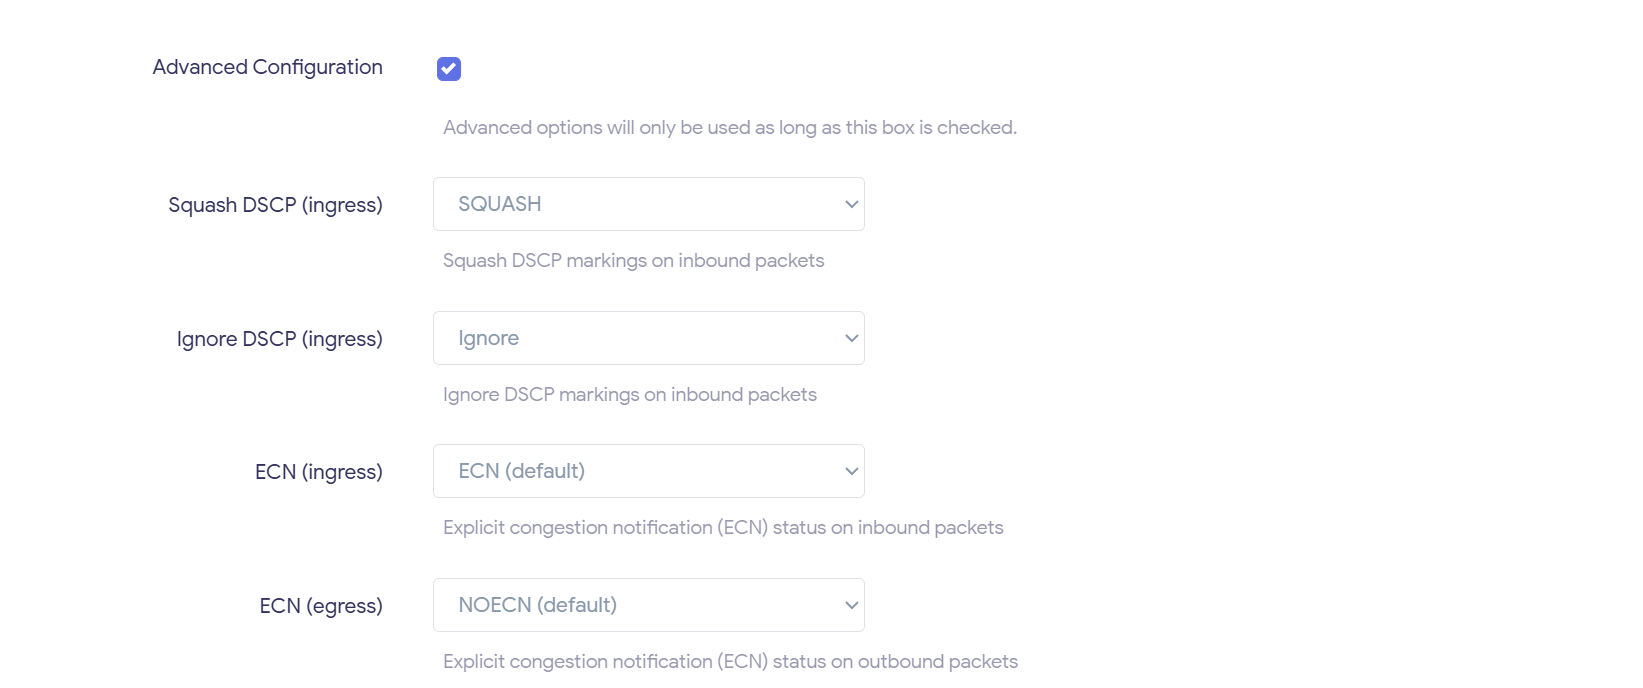
危险配置区
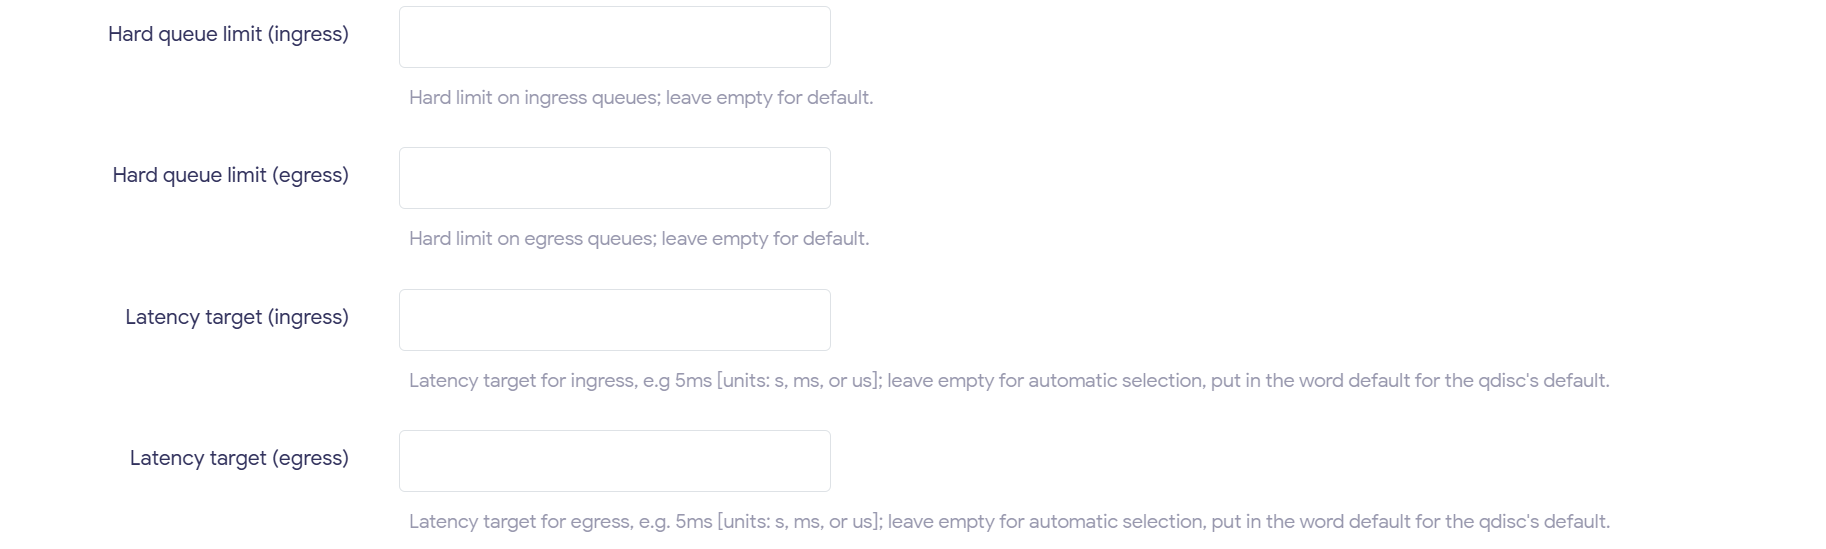
得先勾「Show Advanced Configuration」,再勾「Dangerous Configuration」,下面的字段才会出现。官方文档原话是 not heavily error checked,实际情况是完全不校验。
Hard limit on ingress / egress queues(ilimit / elimit)——队列的包数硬上限,留空用 AQM 默认。128M 内存的老机器内存紧张时可以压到 600 到 1000,代价是突发流量容易丢。
Latency target for ingress / egress(itarget / etarget)——CoDel 的目标驻留时间,单位可以是 ms、us、s。留空表示自动(低于 4Mbps 的慢链路会自动补偿),填 default 用 qdisc 内建值。cake 一般不用动,写 5ms 是常见调法,写太小会在慢链路上过度丢包。
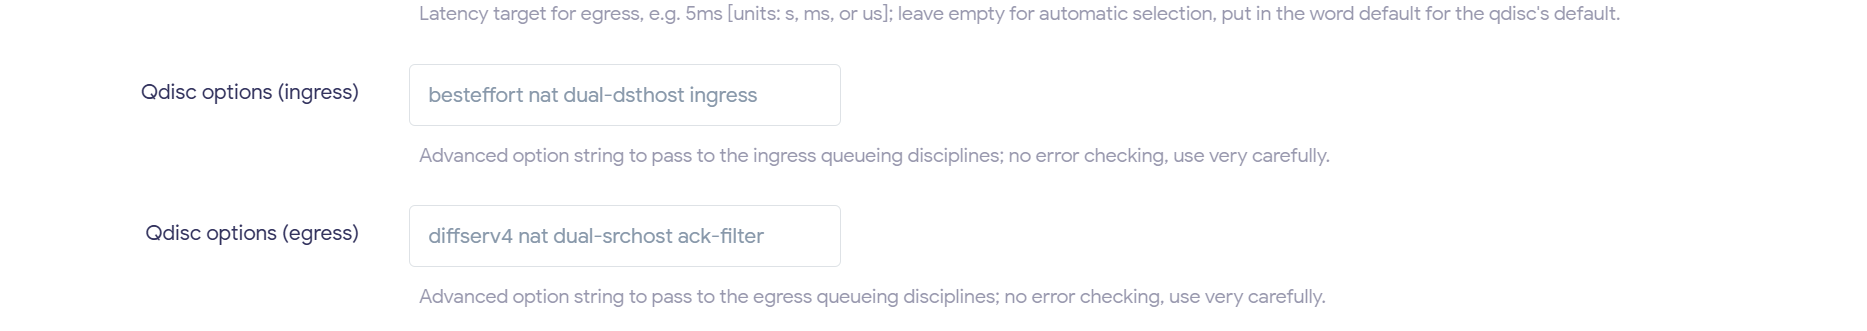
Advanced option string for ingress / egress(iqdisc_opts / eqdisc_opts)——直接透传给 tc 的参数串。这是 SQM 真正有用的地方,也是最容易把自己搞挂的地方,单独一节讲。
cake 的高级字符串:真正让它有用的那几行
先说风险:这串东西写错一个不认识的参数,sqm 会静默失败。LuCI 界面照样显示已启用,/etc/config/sqm 里参数也都在,但内核里一个 shaper 都没装上,网速和延迟跟没配完全一样。所以改完必须验证,方法见下一节。
最实用的一组,WAN 口、cake、要让每台设备公平分:
ingress 高级字符串:  ingress nat dual-dsthost
egress  高级字符串:  nat dual-srchost
这串东西解决的问题是这样的:家里所有设备的流量经过 NAT 之后,源 IP 都是同一个公网地址,cake 默认只能按「流」公平。于是开 20 个 BT 连接的机器天然拿到 20 份配额,看 4K 的电视只拿到 1 份。加了 nat 之后 cake 会去查内核的连接跟踪表,拿到真实的内网 IP,再按 dual-dsthost(下行按目的主机)或 dual-srchost(上行按源主机)分配。没有这个选项,SQM 的「公平」是假的,这是「配了但没感觉」最常见的原因。
其余关键字的价值排序:
| 关键字 | 作用 |
|---|---|
| nat | 查 NAT 表拿真实内网 IP,主机级隔离的前提 |
| dual-srchost | 按内网源 IP 隔离,用在 egress |
| dual-dsthost | 按内网目的 IP 隔离,用在 ingress |
| ingress | 声明这是后置瓶颈方向,让 cake 更激进地提前丢,压制反灌。只放在 ingress 串里 |
| diffserv4 | 分 4 个 tin(Bulk / Best Effort / Video / Voice),按 DSCP 映射 |
| wash | 抹平入方向 DSCP。运营商常乱改标记,家宽建议加 |
| ack-filter | 上行压缩纯 ACK 包,非对称链路能明显抬下载速度 |
| besteffort | 不分优先级,单一 tin。cake 默认 |
| rtt 100ms | 告诉 cake 典型 RTT,影响 CoDel 的时间窗计算 |
| mpu 84 | 最小包尺寸,替代 tcMPU |
| split-gso | 把 GSO 大包拆开计量,避免被少算 |
| raw | 关掉 cake 的 overhead 语义修正,只用于调试 |
一个容易踩的细节:下行和上行的 DSCP 策略应该不同。上行是你自己发的包,DSCP 可控,可以用 diffserv4;下行的 DSCP 是公网 CDN 打过来的,不可信,加 wash 抹掉更稳,或者干脆用 besteffort。
Link Layer Adaptation:让整形器算对每个包
这一页解决的是「150 字节的包在链路上实际占了多少发送时间」。算错的时候,1500 字节的大包几乎不受影响,但 150 字节的小包如果实际要占 194 字节的链路时间,误差就是 29%。结果就是测速网站一切正常,游戏和 VoIP 依然卡。这一页是最容易被跳过、也最容易出隐性问题的部分。
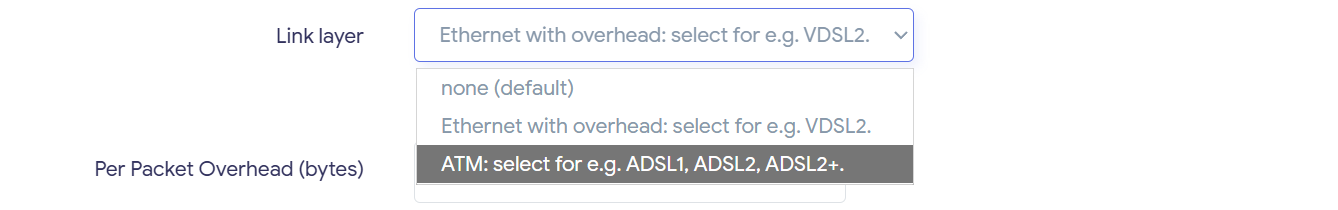
Link Layer Adaptation
none 表示不做开销补偿,其余参数全部被忽略。只有当瓶颈确实在 IP 层(运营商自己做了 shaper)才勉强能用,而且官方文档专门标注了 none 几乎永远不是正确答案。
ethernet 是默认值,绝大多数场景选它,然后靠 overhead 字段补 DSL、PPPoE、VLAN 的差。
atm 只给 ADSL / ADSL2+ 这类真 ATM 分帧的铜线用——ATM 每 48 字节加 5 字节,约 10.7% 开销。
Per packet overhead
| 接入方式 | linklayer | overhead | 配套 mpu |
|---|---|---|---|
| VDSL2 加 PPPoE | ethernet | 34 | 68 |
| VDSL2 无 PPPoE | ethernet | 26 | 68 |
| VDSL2 或 100M 以太上行 | ethernet | 42 | 84 |
| DOCSIS 有线,低于 760 Mbps | ethernet | 22 | 64 |
| DOCSIS 有线,760 Mbps 以上 | ethernet | 42 | 84 |
| FTTH 或城域以太 | ethernet | 44 | 84 |
| 纯以太,不确定就选这个 | ethernet | 44 | 96 |
| ADSL / ADSL2+ | atm | 44 | 96 |
构成拆开看:以太头 14 字节加 FCS 4 字节,一共 18;PPPoE 再加 8;VLAN tag 再加 4;DS-Lite 这种 IPv4 over IPv6 隧道要按加 40 算。原则只有一条:宁可高估,不要低估。低估会让满载延迟抬头,高估只损失一点点吞吐。拿不准就填 44。

高级链路选项
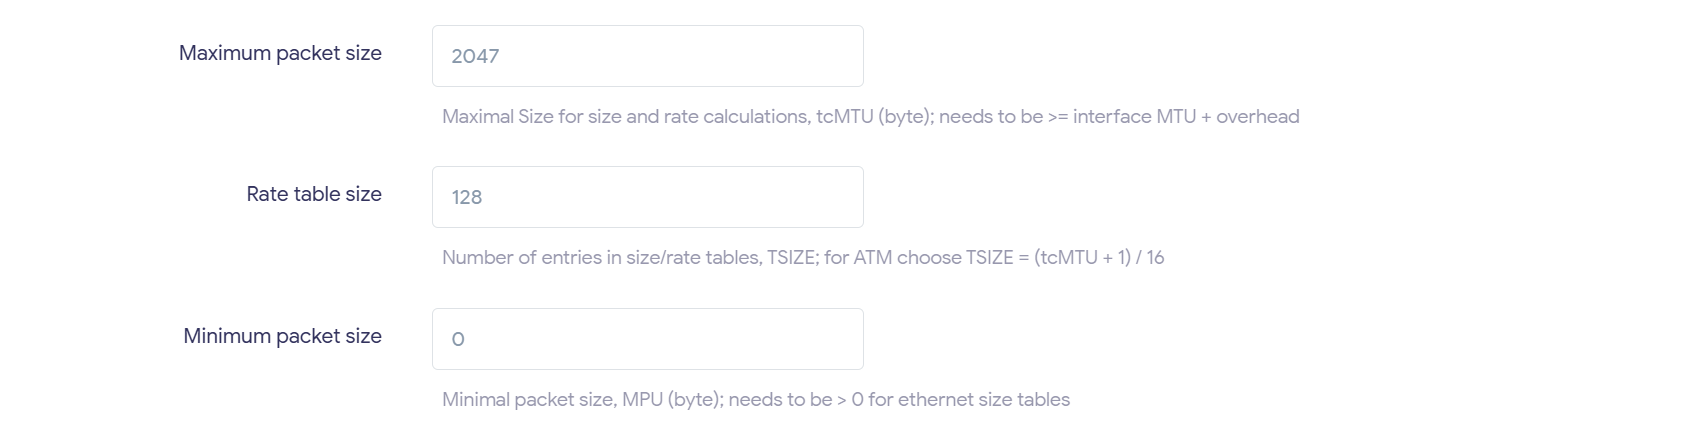
Maximal packet size(tcMTU,默认 2047)——尺寸和速率查表的上界,必须不小于接口 MTU 加 overhead。别往小改。
Size table entries(tcTSIZE,默认 512)——查表条目数。ATM 线路用 (tcMTU + 1) / 16 算。
Minimum packet size(tcMPU,默认 0)——最小包尺寸。所有现代接入(PON、DOCSIS、VDSL、以太)都传完整 L2 帧含 FCS,等价于 64 字节的下限,应该设 64 或 84。DSL/ATM 常常不含 FCS,可以留 0。这一项看着无关紧要,实际有个很具体的场景:DOCSIS 上下行经常是 40:1 的不对称,下行灌满大流的时候,上行基本被纯 ACK 占满。这些 40 到 60 字节的包如果不按 64 计费,整形器会严重低估上行负载,于是「下行跑满、上行龟速、游戏一卡一卡」。
Link Layer Adaptation Mechanism(linklayer_adaptation_mechanism)——default 表示自动(cake 用内建的 overhead 处理,其他 qdisc 用 tc_stab)。保持 default。
改完怎么确认真的生效
LuCI 上那个「已启用」完全不可信。每次改完都要跑:
tc -d qdisc要找的是 shaper 实例和它的参数,大致长这样:
qdisc cake 803b: root refcnt 2 bandwidth 138Mbit besteffort dual-srchost nat wash重点看三样:bandwidth 的数值对不对、dual-srchost 或 dual-dsthost 在不在、overhead 有没有被吃掉。如果输出里根本没有 cake 或 htb 字样,只有一个 pfifo_fast,那说明 sqm 静默失败了,第一步先把两个高级字符串清空再试。
接着看运行统计,下行方向看的是 ifb 设备:
tc -s qdisc show dev ifb4pppoe-wan盯这几个指标:
pk_delay峰值驻留延迟,个位数毫秒是健康的,几百毫秒说明缓冲在积压av_delay平均延迟,必须小于 targetsp_delay稀疏流延迟,应该接近 0memory used对比上限,贴着顶说明速率设高了backlog持续非零就是队列在堆overlimits整形生效的计数,如果是 0,说明速率设得比物理链路还大,整形根本没起作用quantum应该约等于 MTU,异常说明 overhead 配错了
最后确认 CPU 还有余量:
mpstat -P ALL 1单核 %idle 掉到 10% 以下就是 cake 已经跑不动了。CPU 打满的 cake 一样会积压,症状和没配 SQM 时一模一样,特别容易误判成「参数填错了」。这时候要么换 fq_codel 加 simplest_tbf.qos,要么把速率降下来。另外注意 CPU 调频策略也会捣乱——cake 的负载是突发型的,可能触发不了升频,把 governor 设成 performance 试一次就知道是不是这个问题。
高频故障对照表
| 症状 | 大概率原因 | 处理 |
|---|---|---|
| 上下行都卡在较小的那个值 | Interface 选成了底层 eth,没选 l3_device | 用 ifstatus 查真实设备名 |
配了完全没变化,tc 里没有 cake | 高级字符串里有不被识别的参数,静默失败 | 清空 iqdisc_opts 和 eqdisc_opts |
| 测速正常,游戏和语音照旧卡 | overhead 与 mpu 偏低,小包被低估 | overhead 补到 44,mpu 补到 84 |
| 一台下载,全家都卡 | 没加 nat dual-srchost / dual-dsthost | 两个方向各补一个 |
| 下行速率远低于设定值 | CPU 打满,或者 ingress 整形加了下行流量过大 | 换 fq_codel 加 simplest_tbf.qos |
| 开了 SQM 速度掉一半以上 | 硬件流量卸载还开着,包绕过 qdisc | 防火墙里把 Flow Offloading 设成无 |
| 下行延迟还是高,但上行很好 | 下行速率设得太接近物理值,反灌进运营商缓冲 | 下行再降 3% 到 5% |
一套可以直接抄的配置
2000M 下行、150M 上行、PPPoE 拨号的机器,定型后的参数是这样的:
interface    pppoe-wan
download     1940000
upload       138000
qdisc        cake
script       piece_of_cake.qos
ingress ECN  ECN
egress ECN   NOECN
iqdisc_opts  ingress nat dual-dsthost
eqdisc_opts  nat dual-srchost ack-filter
linklayer    ethernet
overhead     34
tcMPU        84
用 uci 写进去,绕开 LuCI:
uci set sqm.@queue[0].interface='pppoe-wan'
uci set sqm.@queue[0].download='1940000'
uci set sqm.@queue[0].upload='138000'
uci set sqm.@queue[0].qdisc='cake'
uci set sqm.@queue[0].script='piece_of_cake.qos'
uci set sqm.@queue[0].iqdisc_opts='ingress nat dual-dsthost'
uci set sqm.@queue[0].eqdisc_opts='nat dual-srchost ack-filter'
uci set sqm.@queue[0].overhead='34'
uci set sqm.@queue[0].tcMPU='84'
uci commit sqm
/etc/init.d/sqm restart这里有个必须讲清楚的坑:LuCI 的保存逻辑是「界面上显示什么值,就往配置文件里写什么值」,它不会去读你没在表单里改过的项。所以只要你先用命令行改过 /etc/config/sqm,再回界面点一次「保存并应用」,表单里那些还是旧值的字段就会把你的命令行改动整片盖掉——配置看起来没变,实际已经回到上一次 UI 的取值。命令行改完就别再回界面点保存;真要长期固化非标准参数,更稳的做法是把整形整体挪到自己写的 qos 脚本里,只留 SQM 当壳。
另外 overhead 34 是 PPPoE 场景的值。不带 PPPoE 的纯 DHCP 拨号要改成 26,FTTH 直连建议 44——大一档不会错,小一档一定出问题。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING