

2000M 宽带下打游戏还是卡?视频会议还是糊?先别急着骂运营商——大概率是你的软路由上 SQM 只开了一半。
我这台 iStoreOS 软路由的 SQM 配置是这样的:上行整形开得好好的,下行 download='0',ifb4pppoe-wan 接口趴在 DOWN 状态。而 2000M 下行的家庭网络,99% 的流量都是下行。等于花钱买的 CAKE 只保护了 1% 的流量。
下面是从排查到改完的全过程,每个参数都给「怎么看、怎么改、怎么验证」三条命令,可以直接抄。
一、先花三十秒查清现状
SSH 登录路由器,逐条跑下面这六条。全部不含重定向符号、不含循环、不含变量——这种写法怎么复制粘贴都不会坏:
uci show sqm
tc qdisc show | grep -E 'cake|fq_codel|htb'
ip -br link show | grep ifb
uci show firewall | grep -i offload
ethtool -g eth0 | tail -6
cat /sys/class/net/eth0/queues/rx-0/rps_cpus
每条在回答一个问题:
| 命令 | 看什么 |
|---|---|
uci show sqm | upload / download 有没有值,download 是 0 就是没开下行 |
tc qdisc show | grep cake | cake 有没有真的挂到内核里 |
ip -br link show | grep ifb | ifb 虚拟网卡是 UP 还是 DOWN |
uci show firewall | grep -i offload | 软件流量卸载开没开(和 SQM 冲突) |
ethtool -g eth0 | tail -6 | 网卡环形队列当前值,256 偏小 |
cat .../rps_cpus | 软中断绑在哪个核,1 就是全压 CPU0 |
判断标准只有三条:
download是 0 或不存在 → 下行没整形,这是最常见的半吊子配置tc qdisc里看不到cake,只有fq_codel或noqueue→ 整形根本没挂上firewall.@defaults[0].flow_offloading是 1 → 软件流量卸载和 AQM 互相打架,必须二选一(命令无输出就是没开,属于正常状态)
跑出来是
ash: gt: not found或/dev/null: Permission denied的话网页把
2>/dev/null里的>渲染成了 HTML 实体>,shell 收到的是2>/dev/null,于是把2和/dev/null当成两条命令去执行。这是复制路径的问题,不是命令写错了。本节六条命令完全不含重定向符号,正常不会有这个问题。后面章节里确实有必须用
>的地方(写文件、重定向),复制后如果报同样的错,在编辑器里全局替换>为>再粘。

我当时的现场:
sqm.eth1.upload='125000'
sqm.eth1.download='0'          ← 关键
sqm.eth1.qdisc='cake'
sqm.eth1.script='piece_of_cake.qos'

qdisc cake 801c: dev pppoe-wan root bandwidth 125Mbit besteffort triple-isolate nat
ifb4pppoe-wan    DOWN            ← 接口存在但没启用

计费口累计:接收 2.53TB / 发送 25.5GB
比例 100:1。所有下行流量都在裸奔。
二、CAKE 和 SQM 到底在解决什么问题
先把原理说清楚,后面所有参数才有意义。
Linux 默认的队列规则是 pfifo_fast——一个先进先出的桶。链路打满时,包全堆在这个桶里,排在前面的先走。结果就是你正在开的视频会议,它的包要等前面几百毫秒的下载流量走完。
这就是 bufferbloat(缓冲膨胀)。典型症状:下载满速时全屋网络变卡、游戏延迟从 40ms 跳到 300ms、微信消息延迟十几秒才到。
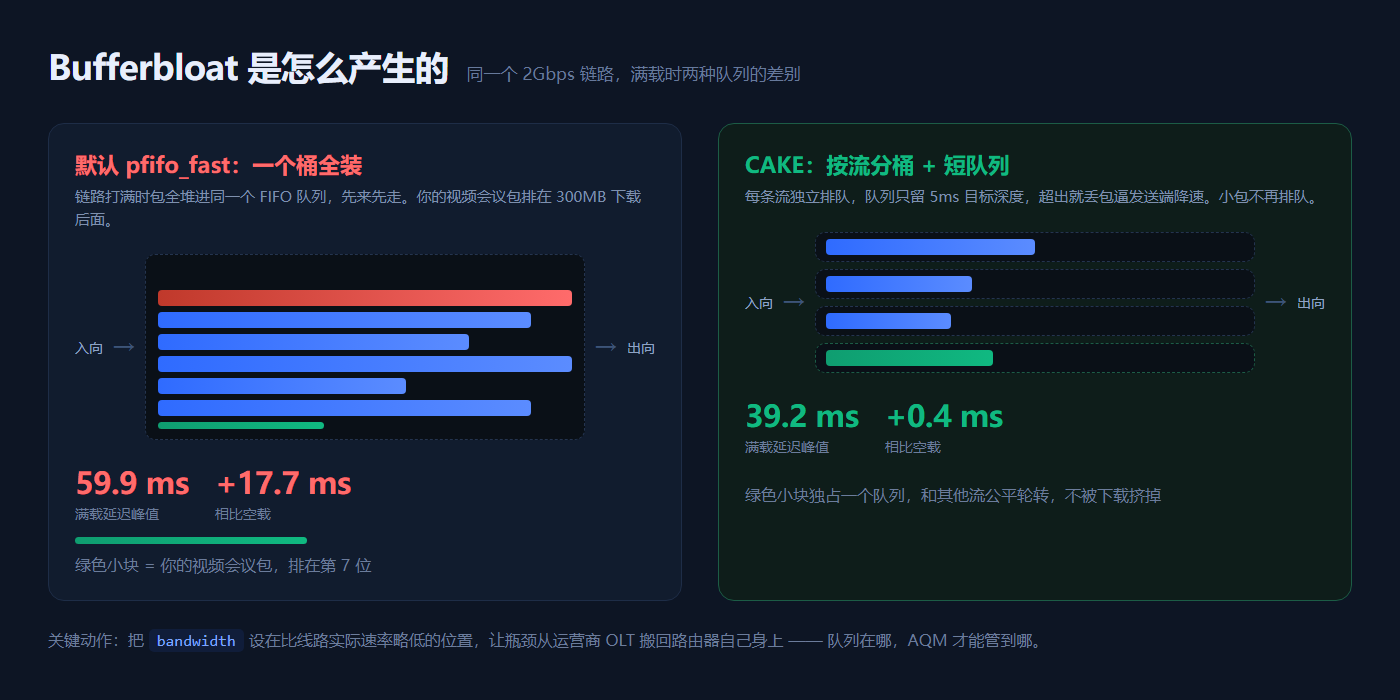
CAKE(Common Applications Kept Enhanced)干三件事:
- 给链路设一个人为的速率上限(
bandwidth参数)。让瓶颈从运营商设备转移到路由器自己身上——这是 AQM 能生效的前提,路由器管不了别人家的队列。 - 按流公平排队(
dual-srchost/dual-dsthost)。一条下载连接不能挤死十条微信消息。 - 队列变长就丢包(COBALT 算法)。丢包是给 TCP 发送端发信号让它降速,这是 TCP 拥塞控制的唯一语言。
所以:整形不是"把包缓冲住",而是"主动成为瓶颈 + 主动丢包"。理解这一点,后面"为什么丢了这么多包"的疑问就自动消失了。
SQM(Smart Queue Management)是 OpenWrt/iStoreOS 上管理这套东西的框架,负责把 cake 挂到正确的接口、正确的方向、带上正确的参数。
三、上行方向:参数逐条解释与修改
上行是 pppoe-wan 的 egress 方向,直接挂 cake,最简单。完整配置命令:
uci set sqm.eth1.enabled='1'
uci set sqm.eth1.interface='pppoe-wan'
uci set sqm.eth1.upload='155000'          # 单位 kbit/s
uci set sqm.eth1.download='2350000'
uci set sqm.eth1.qdisc='cake'
uci set sqm.eth1.script='piece_of_cake.qos'
uci set sqm.eth1.linklayer='ethernet'
uci set sqm.eth1.overhead='26'
uci set sqm.eth1.mpu='64'
uci set sqm.eth1.use_mq='0'
uci commit sqm
/etc/init.d/sqm restart
注意 sqm.eth1 里的 eth1 只是配置节的名字,跟物理网口没关系,别被误导——真正决定整形对象的是 interface 字段。
bandwidth(upload / download)
填 wire 速率,不是你测出来的应用层速率。 这个值必须比运营商标称略低一点(85%–95%),目的是让路由器成为链路上最窄的一段。
设得太高会怎样?队列根本不会在路由器里形成,AQM 变成旁观者——包全堆到运营商 OLT 的缓冲区里,你花了钱但什么都没得到。
# 查看当前值
uci get sqm.eth1.upload
uci get sqm.eth1.download
# 修改(示例:150M 上行、2G 下行)
uci set sqm.eth1.upload='150000'
uci set sqm.eth1.download='2300000'
uci commit sqm && /etc/init.d/sqm restart
# 验证:确认 cake 实际生效的 bandwidth
tc qdisc show dev pppoe-wan | grep -o 'bandwidth [0-9]*[MG]bit'
我这台线实测:裸跑 4 线程能到 2337 Mbit/s(超过标称),设 2350000 时实测 2262 Mbit/s,设 2000000 时实测 1924 Mbit/s。两个值都合理,前者拿速度,后者让整形真正卡在瓶颈位。
overhead 和 mpu
这两个参数负责把"应用层看到的字节数"换算成"物理链路真正占用的时间"。
PPPoE 会在以太网帧上再套 8 字节 PPPoE 头,加上 14 字节以太网头、4 字节 FCS,一共 26 字节。上行链路如果还有 VLAN tag,要再加 4。
# 查看
uci get sqm.eth1.overhead
uci get sqm.eth1.mpu

# 修改(PPPoE 无 VLAN)
uci set sqm.eth1.linklayer='ethernet'
uci set sqm.eth1.overhead='26'
uci set sqm.eth1.mpu='64'
uci commit sqm && /etc/init.d/sqm restart

# 验证
tc qdisc show dev pppoe-wan | grep -o 'overhead [0-9]*'
overhead 设小了会怎样?CAKE 会低估每个包的实际占线时间,整形速率偏快,队列在上游形成——等于没整形。
严格的算法还要加上 8 字节 preamble 和 12 字节 IPG(帧间隙),那样是 46。差 20 字节约等于 1.3% 的带宽误差,日常可以忽略,但对低延迟整形有边际意义。
参考值:裸以太网 38(14+4+8+12)、PPPoE 26(14+8+4)、PPPoE over VLAN 30、DSL/ATM 用 linklayer='atm' 另算。
diffserv / besteffort
diffserv4 会把流量按 DSCP 分成 Bulk / Best Effort / Video / Voice 四个桶,各桶有独立阈值。听起来很美,但下行方向有个坑,第五节细说。
上行保留 diffserv4 是安全的,因为本地生成的流量的 DSCP 你自己可控。
# 查看实际生效的分类方式
tc qdisc show dev pppoe-wan | grep -oE 'diffserv[34]|besteffort|triple-isolate|dual-[sd][re][cs]host'
dual-srchost / dual-dsthost
CAKE 的流哈希方式。
- 上行用
dual-srchost:按内网源地址分桶,防止一台机器吃满上行 - 下行用
dual-dsthost:按内网目标地址分桶,防止一台机器吃满下行
家里多设备、有人挂下载器的时候,这两个参数决定了"公平"到底公不公平。
# 查看(在老版本 SQM 里这两个参数藏在 eqdisc_opts/iqdisc_opts)
uci get sqm.eth1.eqdisc_opts
uci get sqm.eth1.iqdisc_opts

# 修改
uci set sqm.eth1.eqdisc_opts='diffserv4 nat dual-srchost ack-filter'
uci set sqm.eth1.iqdisc_opts='besteffort nat dual-dsthost ingress'
uci commit sqm && /etc/init.d/sqm restart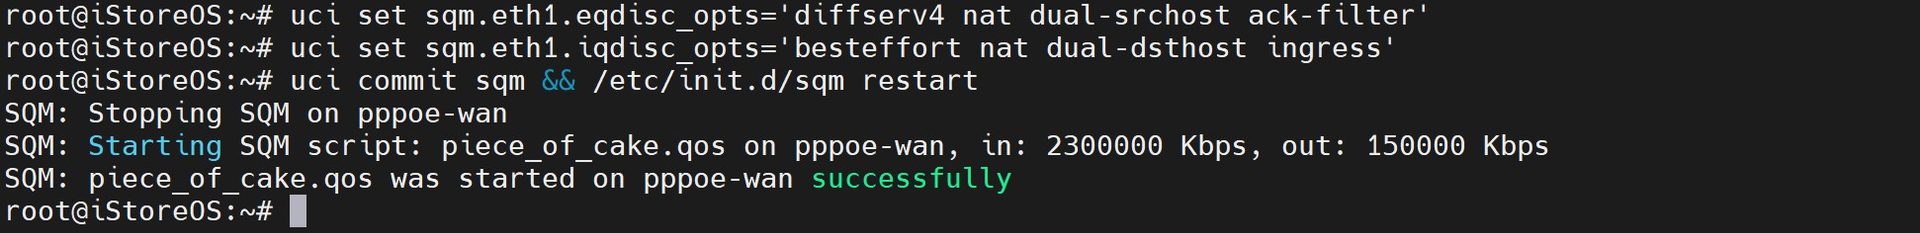
但这两个字段会被 LuCI 吃掉,别用这种方式。 正确做法见第五节。不过UI界面也可以改,在“高级设置”这里:
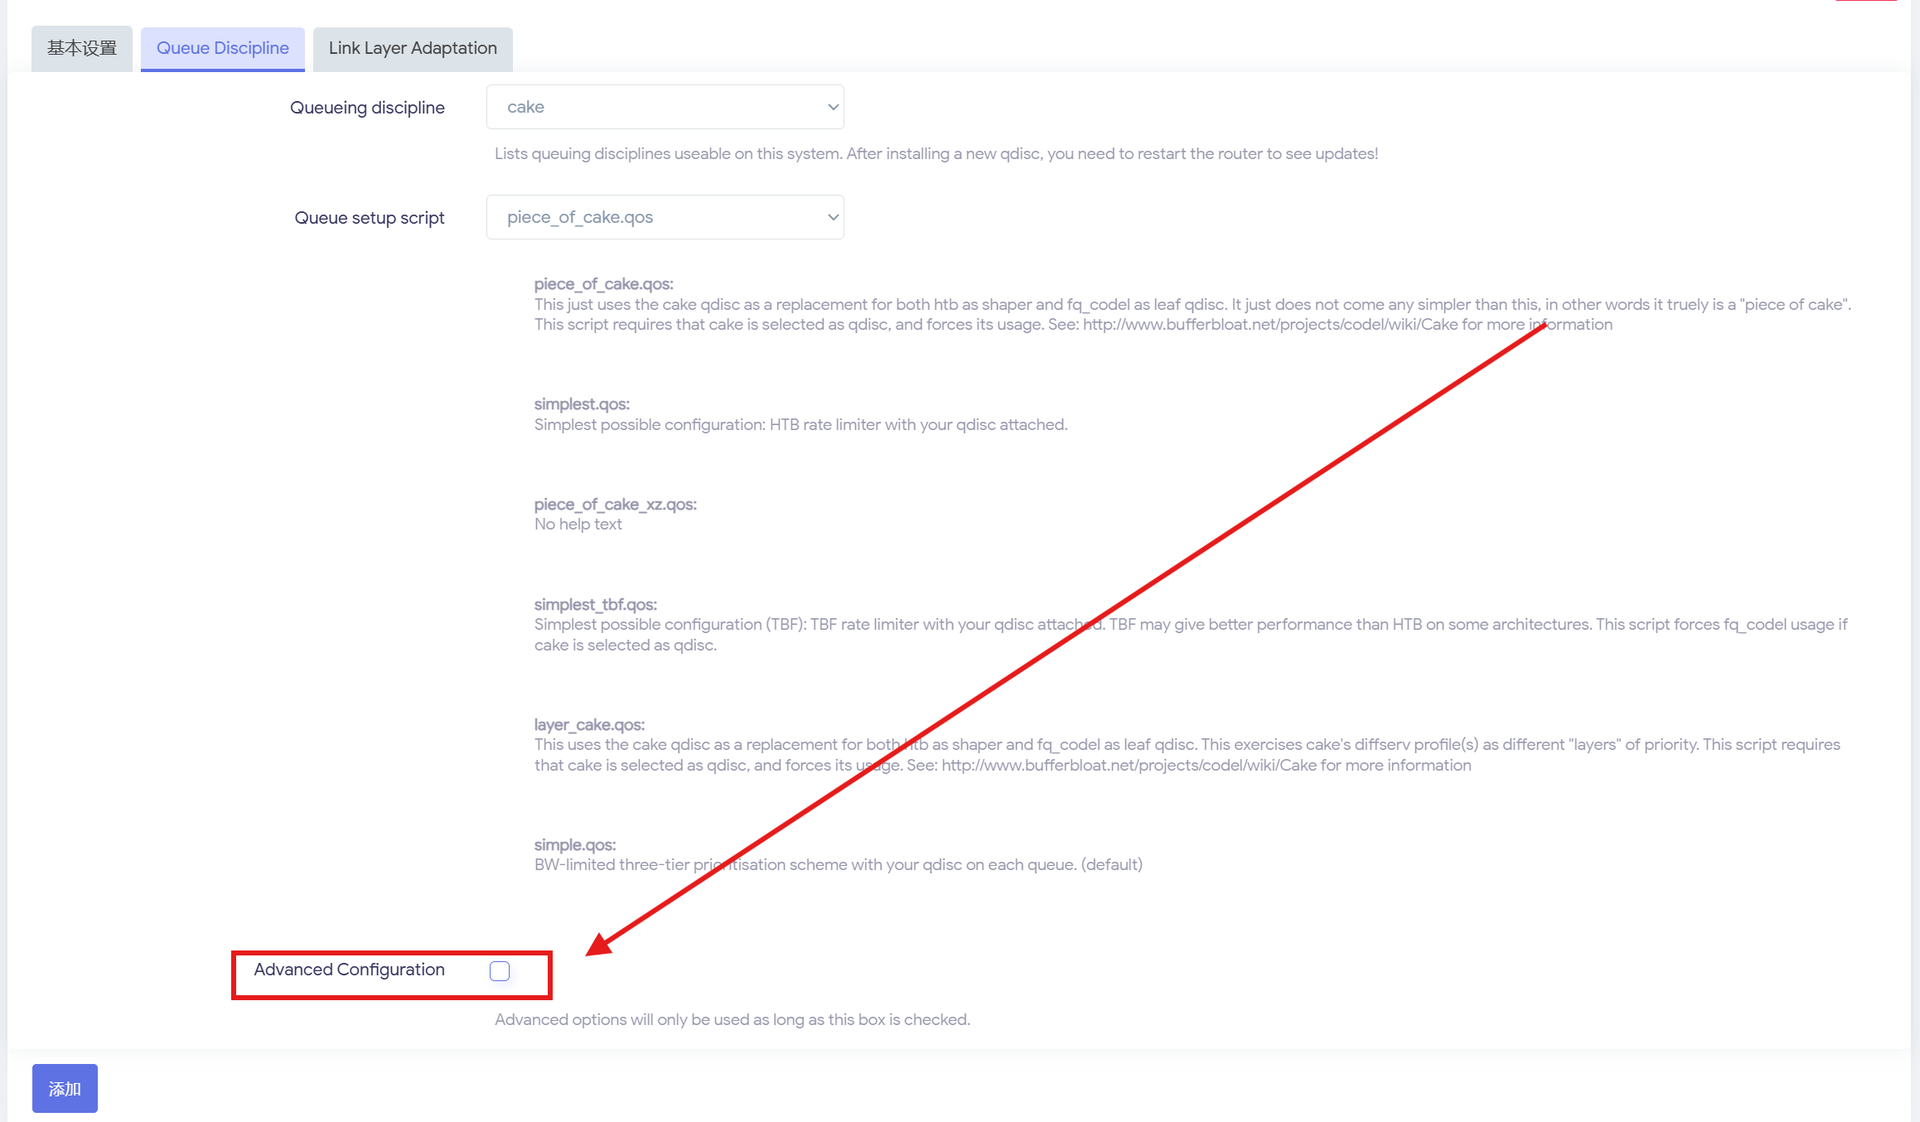
这里
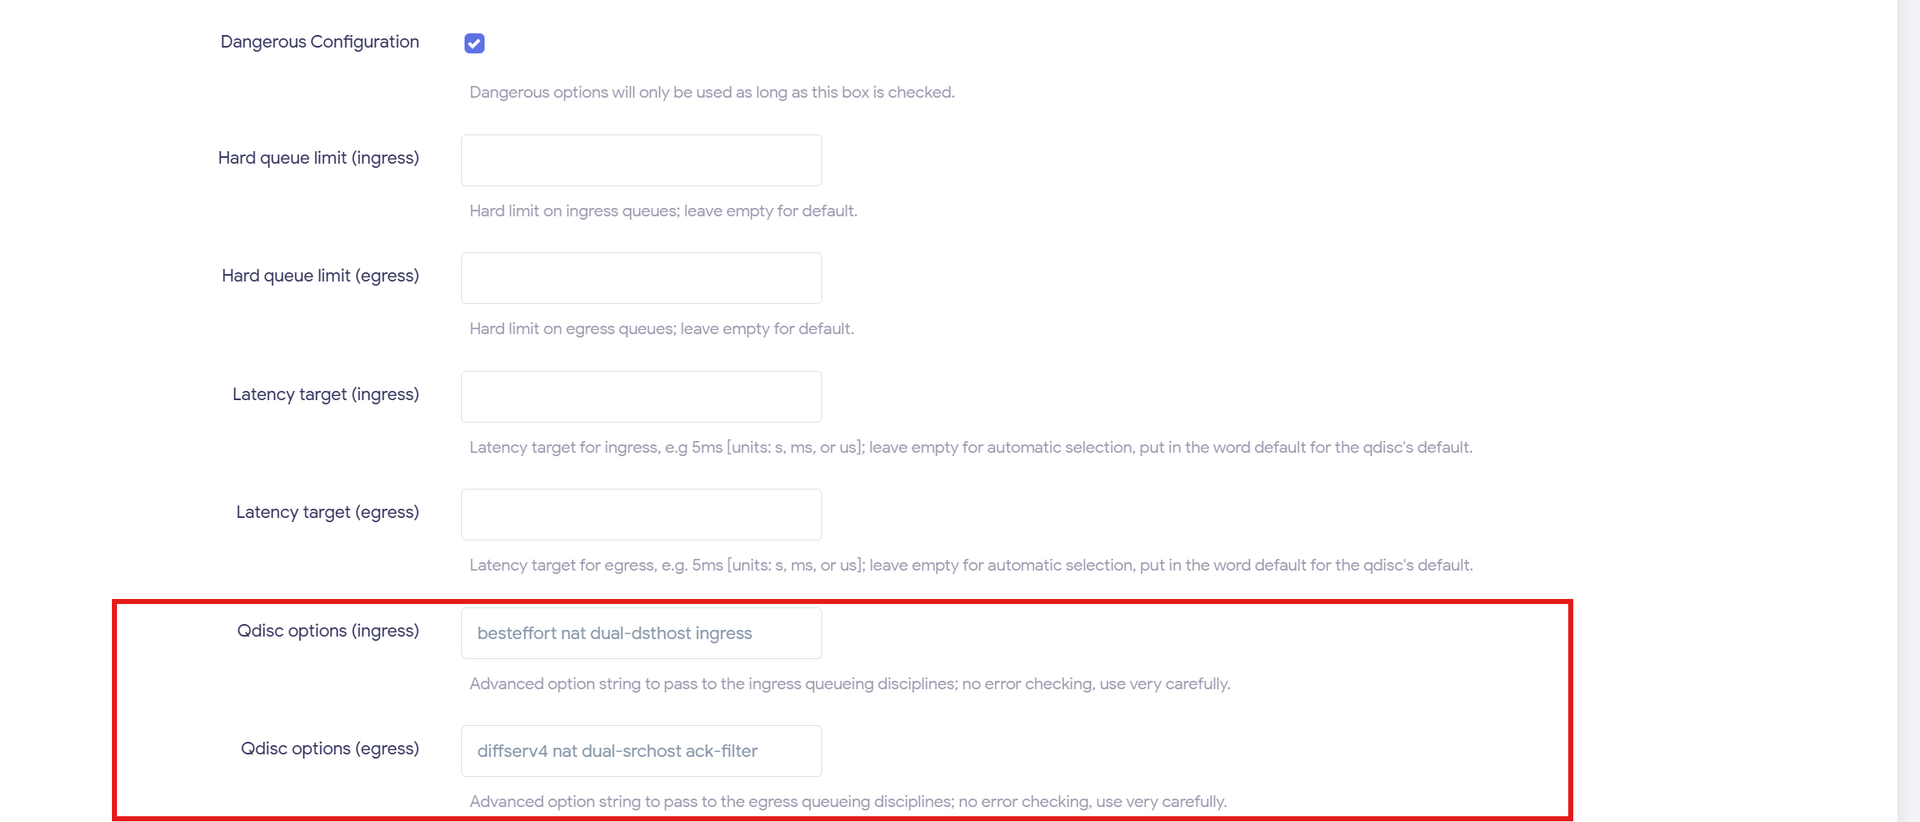
ack-filter
只在上行方向有意义。TCP 下载时本机要回 ACK 给对端,2Gbps 的下行会产生大量 ACK 小包往上走。
实测:纯下行 12 秒,上行队列里有 95.7 万个小包、平均 52 字节,合计约 33 Mbit/s 的 ACK 流量。
ack-filter 会把这些 ACK 合并压缩,省下来的上行带宽留给真正的上传。
# 验证 ack-filter 是否在压 ACK
tc -s qdisc show dev pppoe-wan | grep -E 'ack_drop|no-ack-filter'
# 看到 ack_drop 有计数 = 正在压缩
# 看到 no-ack-filter = 没开
ingress
下行方向必须加这个关键字。它告诉 CAKE "我知道自己是 ingress 侧的整形器",影响内部的时间计算和 ACK 处理逻辑。
ECN
# 查看
uci get sqm.eth1.ingress_ecn
uci get sqm.eth1.egress_ecn

# 开启(对端支持 ECN 时会标记而不是丢包,延迟更平滑)
uci set sqm.eth1.ingress_ecn='ECN'
uci set sqm.eth1.egress_ecn='ECN'
uci commit sqm && /etc/init.d/sqm restart

# 验证
tc qdisc show dev pppoe-wan | grep -o 'ecn'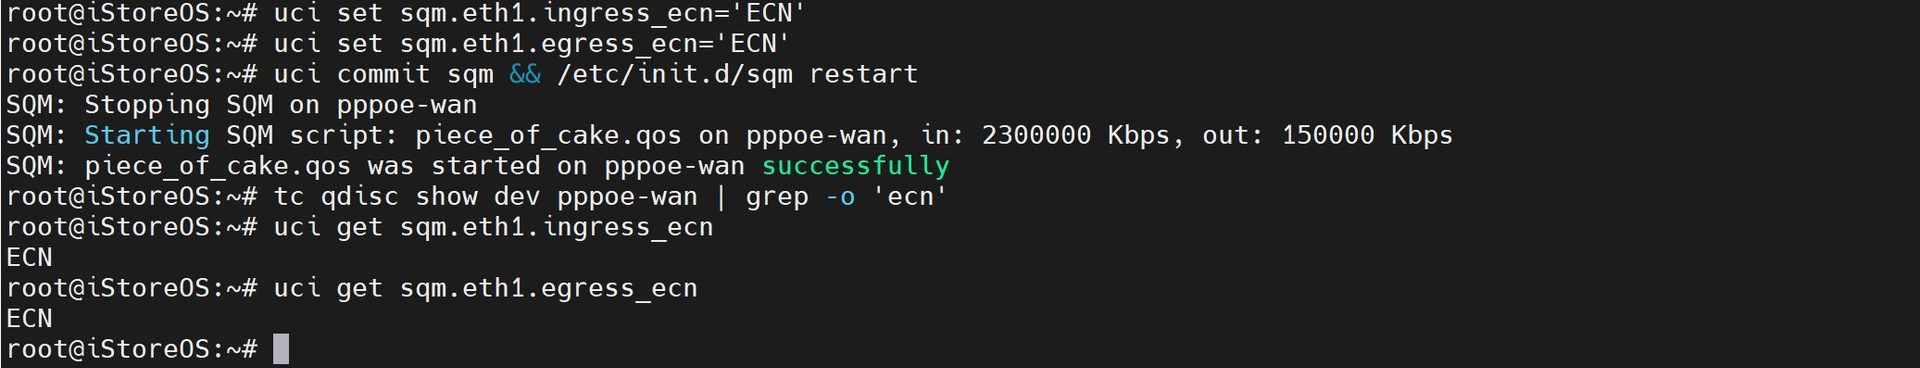
大多数公网服务端不支持 ECN,所以收益有限,但开了没有副作用。
四、下行方向:为什么必须补 ifb
下行流量走的是 pppoe-wan 的 ingress 方向,但 tc 只能在 egress 上挂 qdisc。所以标准做法是用 ifb(Intermediate Functional Block,一块虚拟网卡)把入向流量重定向过去,在 ifb 的 egress 上整形。
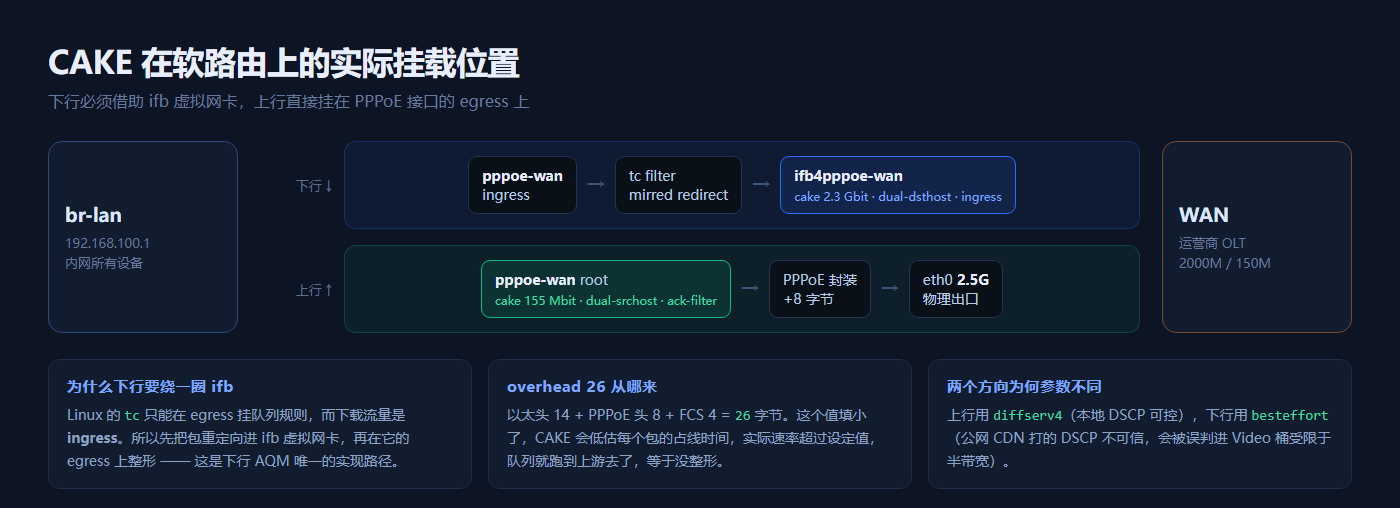
SQM 的 piece_of_cake.qos 脚本会自动做这件事,前提是 download 不为 0。
# 1. 确认内核模块在
lsmod | grep ifb
# 没加载的话:
opkg install kmod-ifb        # OpenWrt 24.10+ 用 apk add kmod-ifb
modprobe ifb

# 2. 设置下行带宽(关键一步)
uci set sqm.eth1.download='2350000'
uci commit sqm && /etc/init.d/sqm restart
sleep 3

# 3. 验证 ifb 被拉起、cake 挂在上面、重定向规则存在
ip -br link show ifb4pppoe-wan
# ifb4pppoe-wan  UNKNOWN  [MAC]   ← 只要不是 DOWN 就对了

tc qdisc show dev ifb4pppoe-wan
# qdisc cake ... bandwidth 2350Mbit besteffort dual-dsthost nat wash ingress

tc filter show dev pppoe-wan ingress | head -3
# filter parent ffff: protocol all pref 10 u32 ... action mirred egress redirect
三条都对上,下行整形才算真的生效。

如果 ifb4pppoe-wan 还是 DOWN,检查 /var/log/sqm-pppoe-wan-* 日志,最常见原因是 download 填了 0,或者 ifb 模块没加载。
五、三个把我坑过的细节
坑一:LuCI 保存会静默吃掉你的 cake 参数
SQM 的 uci 里,eqdisc_opts 和 iqdisc_opts 是 sqm-scripts 认的字段,但 LuCI 的 SQM 表单不认识它们。你在网页上点一次"保存并应用",这两个字段就被整个删掉,cake 参数静默回落到默认的 besteffort triple-isolate。
症状很迷惑:刚才明明验证过 diffserv4 ack-filter 生效了,改个带宽数值再一看,参数没了。
# 症状
tc qdisc show dev pppoe-wan
# 期望:... diffserv4 dual-srchost nat ack-filter ...
# 实际:... besteffort triple-isolate nat ...     ← 被覆盖

# 确认配置字段是否被删
uci show sqm | grep -E 'eqdisc|iqdisc'
# 无输出 = 已经被 LuCI 删了
解法是把参数写进自定义 qos 脚本——script 是标准字段,UI 不会动它:
# 1. 复制一份脚本
cp /usr/lib/sqm/piece_of_cake.qos /usr/lib/sqm/piece_of_cake_xz.qos

# 2. 改掉脚本里这两行(原脚本会强制追加 besteffort,覆盖 defaults.sh 的 diffserv 设置)
#    第 20 行附近:
#    INGRESS_CAKE_OPTS="besteffort nat dual-dsthost ingress"
#    第 21 行附近:
#    EGRESS_CAKE_OPTS="diffserv4 nat dual-srchost ack-filter"
sed -i 's|^INGRESS_CAKE_OPTS="\${INGRESS_CAKE_OPTS} besteffort"|INGRESS_CAKE_OPTS="besteffort nat dual-dsthost ingress"|' /usr/lib/sqm/piece_of_cake_xz.qos
sed -i 's|^EGRESS_CAKE_OPTS="\${EGRESS_CAKE_OPTS} besteffort"|EGRESS_CAKE_OPTS="diffserv4 nat dual-srchost ack-filter"|' /usr/lib/sqm/piece_of_cake_xz.qos

# 3. 确认改对了
grep -n 'CAKE_OPTS=' /usr/lib/sqm/piece_of_cake_xz.qos

# 4. 指向自定义脚本
uci set sqm.eth1.script='piece_of_cake_xz.qos'
uci commit sqm && /etc/init.d/sqm restart

# 5. 验证:模拟 LuCI 保存一次,看参数还在不在
uci set sqm.eth1.upload='155000'; uci commit sqm; /etc/init.d/sqm restart
tc qdisc show dev pppoe-wan | head -1
# 参数还在 = 持久化成功
这个文件不在 sqm-scripts 包里,包升级也不会被覆盖。

坑二:diffserv4 在公网下行方向不可用
下行一开始我配的是 diffserv4,结果下载速度从 1.13Gbps 掉到 431Mbit。查 tc -s 才发现:
Video tin:    thresh 450Mbit    pkts 1675744    ← 下载流量全被分到 Video 桶
Best Effort:  thresh 900Mbit    pkts 849003
原因:内容源(Google 等 CDN)会给部分流量打 DSCP 标记,CAKE 照单全收。diffserv4 的 Video 桶阈值是总带宽的一半,900Mbit 带宽下就是 450Mbit,下载被硬限死。
# 先确认当前是分桶还是单桶
tc qdisc show dev ifb4pppoe-wan | grep -oE 'diffserv[34]|besteffort'
# 分桶模式下,看每个 tin 的 pkts 分布
tc -s qdisc show dev ifb4pppoe-wan | sed -n '/Tin\|Bulk/,$p'
wash 参数能重写 DSCP,但只对出向有效,分类仍然按原始标记走。公网下行方向的 DSCP 完全不可信,下行老老实实用 besteffort 单桶。
坑三:tc -s 的 dropped 是累计值,不是本轮丢包率
我第一次测上行 125M 的设定,读到 dropped 184656,算出来 10% 丢包率,得出"设定太紧"的结论。实际上这个 qdisc 已经跑过好几轮测速了,dropped 是从 qdisc 创建以来的累计数。
重建 qdisc 后干净测:
| upload 设定 | 实测上行 | 丢包 | 丢包率 |
|---|---|---|---|
| 125000 | 114 Mbit/s | 69 / 127768 | 0.05% |
| 150000 | 134 Mbit/s | 20 / 147605 | 0.01% |
| 155000 | 146 Mbit/s | 47 / 316591 | 0.015% |
| 160000 | 148 Mbit/s | 21 / 163776 | 0.01% |
正确的判据:dropped / pkts < 0.1% 且 overlimits 在涨。overlimits 说明整形器的速率限制在起作用,dropped 占比高才说明设定值低于线路真实能力。
# 干净测量的做法:先重建 qdisc 归零计数
/etc/init.d/sqm restart && sleep 3
# 再跑测速
# 然后读
tc -s qdisc show dev pppoe-wan
顺带一提,设低了不只是丢包问题:125M 设定把本来能跑的 146M 砍到 114M,白丢 32M 上行。
六、内核层:SQM 之外还有六处该动
CAKE 只是软件层。包在到达 CAKE 之前,还要过网卡、软中断、协议栈。这几层配错了,再好的 AQM 也白搭。
1. 网卡 ring(环形描述符队列)
网卡里有一圈 DMA 描述符,收包时硬件把数据写进 ring 里的 buffer 并标记"已填"。ring 深度 = 网卡能瞬间吸收多少突发包。
# 查看
ethtool -g eth0

# 看驱动丢包计数
ethtool -S eth0 | grep -E 'rx_missed|rx_no_buffer'
# rx_missed_errors: 219069      ← 这些数字是 ring 太小导致的 DMA 溢出
# rx_no_buffer_count: 7410

# 修改(igc 驱动最大支持 4096),注意修改igc会导致5s左右的断网
ethtool -G eth0 rx 4096 tx 4096
ethtool -G eth1 rx 4096 tx 4096
ethtool -G eth2 rx 4096 tx 4096

# 验证
ethtool -g eth0 | tail -4
# RX: 4096   TX: 4096
igc(i225/i226)驱动默认 RX/TX 各 256。2.5G 口满速时约 384KB 就会填满,填满后硬件直接丢弃,TCP 靠重传恢复——表现为莫名其妙的卡顿。
注意 ethtool -G 会重置网卡,改的时候 LAN 口会瞬断几秒,别在家人上网时动手。实测 1024 已经够用(满速下增量 0),4096 只是留余量。
2. packet_steering(RPS 强制绑核)
OpenWrt 有个 packet_steering 服务,管的是 RPS(Receive Packet Steering)。RPS 本来是给"网卡只有单队列"的机器用的——靠软件把软中断分散到多核。
问题在于,它给每个接口的所有队列写同一个单核掩码:
# 查看现状
cat /sys/class/net/eth0/queues/rx-*/rps_cpus
# 1 1 1 1     ← 四个队列全绑 CPU0(掩码 1 = bit0)

cat /sys/class/net/eth2/queues/rx-*/rps_cpus
# 8 8 8 8     ← 四个队列全绑 CPU3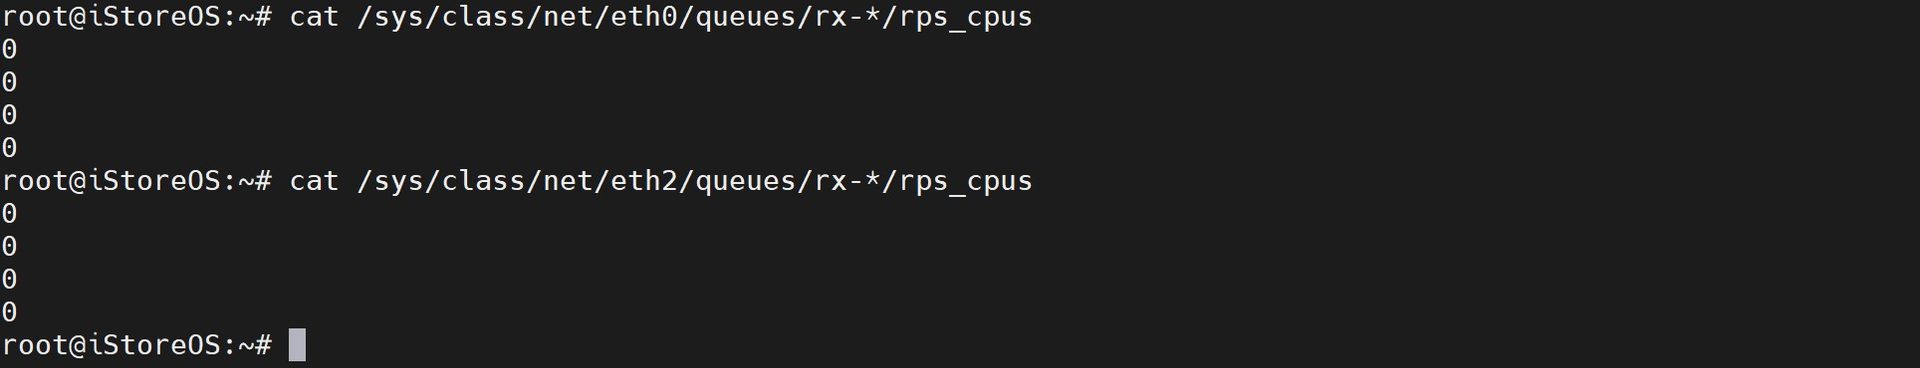
而 i225 有四个硬件队列 + 四条 MSI-X 中断,本来就分散在四个核上:
grep -E 'eth0' /proc/interrupts
# 每个 TxRx 队列的中断计数分散在不同 CPU 列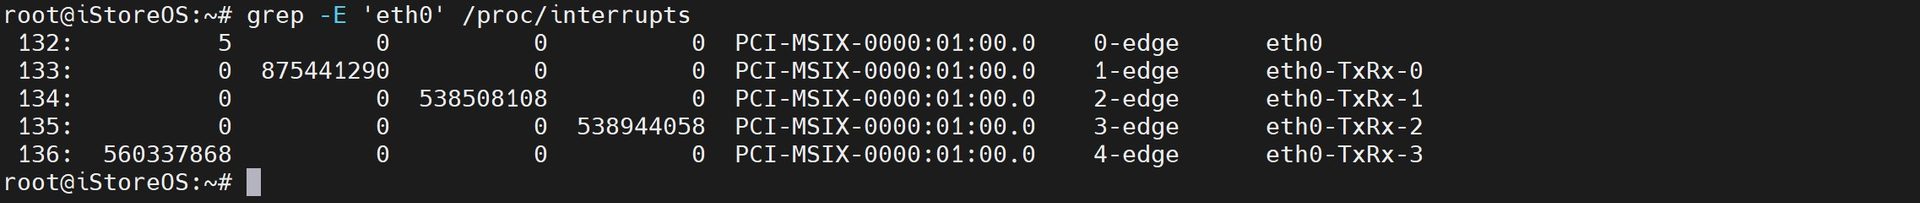
RPS 再叠一层,等于把已经分散的软中断又全部拽回单核。
# 关闭
uci set network.@globals[0].packet_steering='0'
uci commit network
/etc/init.d/packet_steering reload
/etc/init.d/packet_steering disable

# 验证:掩码应该变成全 0
cat /sys/class/net/eth0/queues/rx-0/rps_cpus
cat /sys/class/net/eth0/queues/rx-1/rps_cpus
cat /sys/class/net/eth0/queues/rx-2/rps_cpus
cat /sys/class/net/eth0/queues/rx-3/rps_cpus
# rx-0=0
# rx-1=0
# rx-2=0
# rx-3=0
掩码全 0 后,内核按"哪个核收到中断就在哪个核跑协议栈",四核均摊。
如果某台机器确实需要 RPS(单队列网卡),手动指定分散掩码:双核写 5(CPU0+CPU2)、四核写 f。
3. netdev_max_backlog
每个 CPU 的软件收包队列深度。NAPI 处理速度跟不上硬件收包时,包先入这个队列,超过上限就丢。
# 查看
sysctl net.core.netdev_max_backlog

# 看重历史丢包(第三列是 drop 次数,十六进制)
awk '{print "cpu"NR-1" drop="$2" squeezed="$3}' /proc/net/softnet_stat
# cpu2 drop=00000688 squeezed=00000021    ← 十进制 1672 次丢包

# 修改
sysctl -w net.core.netdev_max_backlog=16384
sysctl -w net.core.netdev_budget=600
sysctl -w net.core.netdev_budget_usecs=40000

# 持久化
cat <<'EOF' | tee /etc/sysctl.d/99-forward-tune.conf
net.core.netdev_max_backlog=16384
net.core.netdev_budget=600
net.core.netdev_budget_usecs=40000
net.netfilter.nf_conntrack_max=262144
EOF

# 验证
sysctl net.core.netdev_max_backlog
默认 1000 对 2.5G 口太浅。
4. nf_conntrack_max
这是整机连接跟踪表的总条目上限,不是单 IP 上限——这一点很多人搞混。
65535 是绝大多数发行版的默认值。表满了会打出 nf_conntrack: table full, dropping packet 并直接丢掉转发包,症状是"网突然全断几秒"。
单 IP 的 NAT 端口范围是另一回事,大约 28k 个(32768–60999 区间),由内核端口分配决定。
# 查看
sysctl net.netfilter.nf_conntrack_max
sysctl net.netfilter.nf_conntrack_count      # 当前用量

# 修改
sysctl -w net.netfilter.nf_conntrack_max=262144

# 验证
sysctl net.netfilter.nf_conntrack_max
成本只是哈希表内存,按需分配。P2P 下载、多设备同时开短连接会瞬间冲高。
5. CPU governor
# 查看当前策略和可选项
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_available_governors
# performance powersave        ← Intel 平台通常只有这两档

# 修改
echo performance | tee /sys/devices/system/cpu/cpu[0-3]/cpufreq/scaling_governor

# 验证
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor
powersave 是 intel_pstate 的调频策略——低负载时主动把频率压到最低(J6412 能降到 800MHz)。这不是"因为温度才降频",是策略本身。转发路径上的小包处理、CAKE 的时间戳计算都吃 CPU 频率。代价是待机功耗上升几瓦、温度高几度。夏天 fanless 机箱吃紧的话改回 powersave。
但是副作用也是有的,比如CPU核心进入低负载状态能降低功耗。现在满血打频率,功耗多出5W。所以在夏天使用要注意散热,以免出现过热死机的情况。
6. ifb 队列长度
# 查看
ip link show ifb4pppoe-wan | grep -o 'qlen [0-9]*'
# qlen 32      ← 默认值,偏小

# 修改,注意会断网
ip link set ifb4pppoe-wan txqueuelen 10000

# 验证
ip link show ifb4pppoe-wan | grep -o 'qlen [0-9]*'
这个值每次 SQM 重建 ifb 都会被打回 32,需要 hotplug 钩子纠正:
cat <<'EOF' | tee /etc/hotplug.d/iface/99-ifb-tune
#!/bin/sh
case "$ACTION" in ifup|ifupdate) ;; *) exit 0 ;; esac
for dev in /sys/class/net/ifb*; do
  [ -e "$dev" ] || continue
  ip link set dev "$(basename $dev)" txqueuelen 10000
done
exit 0
EOF
chmod +x /etc/hotplug.d/iface/99-ifb-tune
持久化:ring / RPS / governor 重启会丢
# /etc/rc.local 里加,放在 exit 0 之前
for n in eth0 eth1 eth2; do ethtool -G $n rx 4096 tx 4096; done
echo 0 | tee /sys/class/net/eth*/queues/rx-*/rps_cpus
echo performance | tee /sys/devices/system/cpu/cpu[0-3]/cpufreq/scaling_governor
ip link set ifb4pppoe-wan txqueuelen 10000
七、怎么把测速测准
这一节可能比参数更值得记。
用浏览器测速的问题:页面加载、JS 渲染、后台更新、其他设备在下载,都会污染结果。我第一次用 curl 直接拉 Google 的 Chrome 安装包,4 线程跑出 1.13Gbps,以为这就是线路上限——后来换成运营商本地节点,实际能到 2.3Gbps。差的 1.1Gbps 全是 CDN 单源限速造成的假象。
可靠做法是自己在路由器上跑,四个要点:
丢慢启动:TCP 慢启动阶段的速度不代表稳定吞吐,至少丢弃前 1.5–2 秒。
多线程:单条 TCP 流受窗口和源端限速约束,4 线程以上才能压出链路真实能力。
独立计量:不要用 curl -w %{speed_download},也不要用 /proc/net/dev 的总量(会被局域网其他设备污染)。用 nftables 给测速端口单独计数:
# 建一个独立的计数表,不影响 fw4
nft add table inet xzprobe
nft 'add chain inet xzprobe in  { type filter hook input  priority -150; policy accept; }'
nft 'add chain inet xzprobe out { type filter hook output priority -150; policy accept; }'
nft 'add rule inet xzprobe in  tcp sport 8299 counter'
nft 'add rule inet xzprobe out tcp dport 8299 counter'

# 读字节数
nft list chain inet xzprobe in | grep -o 'bytes [0-9]*'验证背景干净:测之前先看空载基线,pppoe-wan 的 RX 增量应该接近 0。
# 空载基线(4 秒,正常应小于几十 KB)
A=$(grep -m1 "pppoe-wan:" /proc/net/dev | awk '{print $2}'); sleep 4
B=$(grep -m1 "pppoe-wan:" /proc/net/dev | awk '{print $2}')
echo "idle_delta=$((B-A))B/4s"
如果这个数有几百 KB 以上,说明家里有设备在跑流量,测出来的数字不可信。
八、实测数据
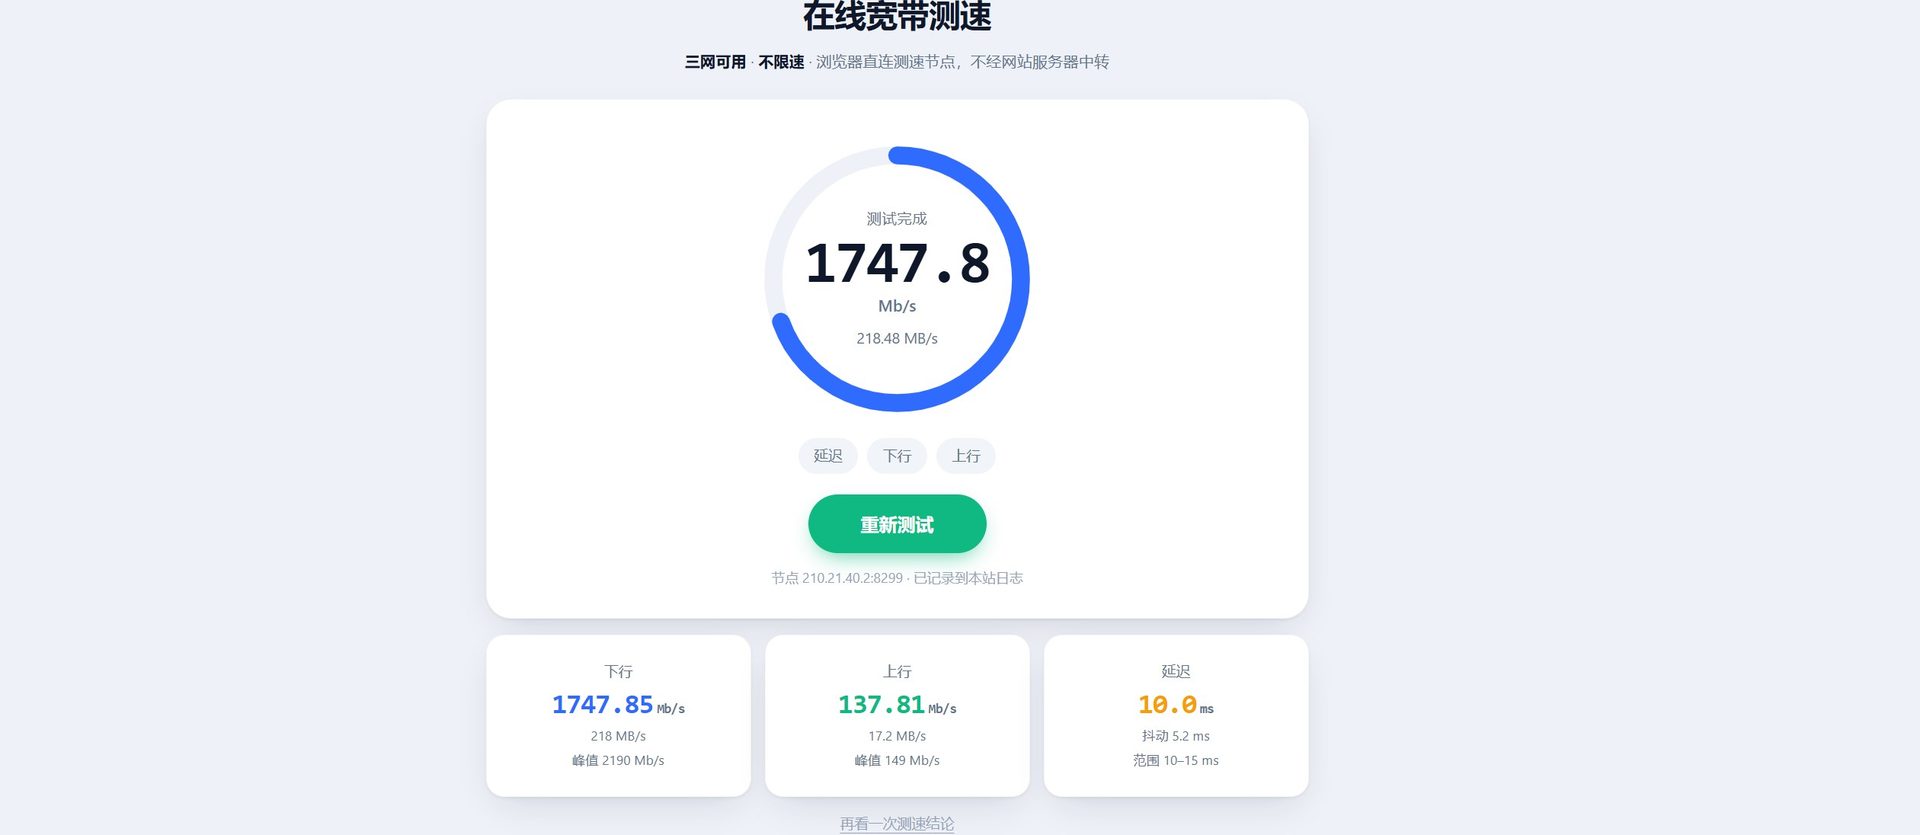
这台机器(J6412 四核 / 8GB / i225 三网口 / 联通 2000M 下行 150M 上行 PPPoE)。下表数字是在同一台设备、同一批运营商节点、不同时段反复测出来的范围——先看这个前提,再看数字:
| 项目 | 结果 |
|---|---|
| 下行(整形 2.3–2.35G) | 1729–2262 Mbit/s(216–282 MB/s) |
| 下行(裸线不限速) | 2337 Mbit/s |
| 上行(整形 150–155M) | 134–146 Mbit/s(标称 150M 的 90%–97%) |
| 上行(裸线不限速) | 157 Mbit/s |
| 空闲 RTT | 38.1 ms |
| 双向满载 RTT | 38.1 / 38.5 / 39.2 ms |
| 下行裸线满载 RTT | 42.5 / 51.7 / 59.9 ms |
同一套配置,不同时段能差 20% 以上。 晚上的 1729 和白天的 2262 都是真实数字,差别来自测速节点负载和运营商侧拥塞,不是配置变了。所以这类测试只有一个用法:改参数前后,在同一时段、同一节点、连续测两轮对比,绝对值本身没有意义。
最后两行是这次调优唯一但明确的价值:满载时下行延迟峰值从 59.9ms 压到 39.2ms,抖动少了 17ms。延迟这个数字比带宽稳定得多,也更能反映 AQM 是否真的在起作用——带宽受线路和节点影响,延迟只受你自己的队列影响。
CPU 占用方面,2.2Gbps 下行整形时 top 显示 sirq 37%、usr 15%、idle 45%——四核里大约两个核在干活,单个核心没有吃满。J6412 跑 2.3Gbps 的 CAKE 整形完全够,之前担心的"单核瓶颈"没有出现。
# 自己看 CPU 占用
top -b -n1 | head -4
# 关注 sirq(软中断)那一列,整形压力主要体现为它
九、复盘:什么有用,什么没用
有用,按收益排序:补齐下行整形(收益最大,之前等于没开)、ack-filter、dual-dsthost/srchost、禁用 packet_steering、ring 加大、把上行带宽从保守值调到实测水平。
没用:rtt 参数调整。试过把 rtt 100ms 降到 40ms,期望更浅的队列带来更低延迟,实测双向满载延迟从 38.4ms 变成 40.8ms、峰值 44.5ms,反而更差,上行还多丢 28 万包。这条线的延迟主要来自运营商侧,路由器队列不是瓶颈,改 rtt 没有意义。
用了但需要警惕:diffserv4 只在上行方向安全,下行会被上游 DSCP 标记污染。
已知无解:双向同时满载时上行丢包约 26 万。归因测清楚了——2.2Gbps 下行会产生约 33 Mbit/s 的 TCP ACK 回流,占掉 155M 上行里的 33M,剩下的空间容不下 4 条上传流的瞬时突发。这是 TCP 双向通信的物理开销,不是配置缺陷。日常场景(下载为主、上传零星)碰不到。
一句话总结:SQM 的价值不在"开了没有",而在"瓶颈是不是真的在路由器身上"。带宽设得比线路还高,界面显示一片绿,实际什么都没发生。
十、参数速查表
| 参数 | 位置 | 推荐值 | 作用 |
|---|---|---|---|
upload | uci set sqm.@queue[0].upload | 实测上行 × 0.95 | 上行整形速率(kbit/s) |
download | uci set sqm.@queue[0].download | 实测下行 × 0.95 | 下行整形速率,填 0 等于关闭 |
qdisc | uci set sqm.@queue[0].qdisc | cake | 队列算法 |
script | uci set sqm.@queue[0].script | piece_of_cake.qos | 整形脚本 |
linklayer | uci set sqm.@queue[0].linklayer | ethernet | 链路层类型 |
overhead | uci set sqm.@queue[0].overhead | PPPoE 用 26 | 每包额外开销字节 |
mpu | uci set sqm.@queue[0].mpu | 64 | 最小包尺寸 |
use_mq | uci set sqm.@queue[0].use_mq | 0 | 多队列(单 PPoE 接口用 0) |
| 内核参数 | 查看 | 修改 | 推荐值 |
|---|---|---|---|
| 网卡 ring | ethtool -g eth0 | ethtool -G eth0 rx 4096 tx 4096 | 1024–4096 |
| RPS 掩码 | cat /sys/class/net/eth0/queues/rx-0/rps_cpus | echo 0 > ... | 0(多队列网卡) |
| 收包队列 | sysctl net.core.netdev_max_backlog | sysctl -w ...=16384 | 16384 |
| 连接跟踪 | sysctl net.netfilter.nf_conntrack_max | sysctl -w ...=262144 | 262144 |
| 调频策略 | cat /sys/.../scaling_governor | echo performance > ... | performance |
| ifb 队列 | ip link show ifb4pppoe-wan | ip link set ... txqueuelen 10000 | 10000 |
修改后的标准动作序列:
# 1. 备份
cp /etc/config/sqm /root/sqm.bak
cp /etc/rc.local /root/rc.local.bak

# 2. 改
uci set sqm.@queue[0].upload='155000'
uci commit sqm

# 3. 生效
/etc/init.d/sqm restart
sleep 3

# 4. 验证
tc qdisc show dev pppoe-wan
tc qdisc show dev ifb4pppoe-wan
tc -s qdisc show dev pppoe-wan | head -3

# 5. 测速确认
# (跑你的测速,对比改动前后的数字)

# 6. 不对就回滚
cp /root/sqm.bak /etc/config/sqm && /etc/init.d/sqm restart改动只有一条安全原则:一次只改一个参数,改完测一轮,记住改之前的值。SQM 出问题最常见的症状是"网速变慢但不知道慢在哪",多点同时改就永远找不出真凶。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING