





前言
今天下午在这台 Redmi Book Pro 14 上做了一件很小的事:量两块 NVMe 盘的 4KB 随机读延迟,一块是出厂自带的 PC411,没有独立缓存,靠 HMB 和片内 SRAM 撑映射表,另一块是后插进 2280 位的 PM9A1,带 1GB DRAM。
结果是没有缓存的那块更快,69.8 µs 对 71.0 µs,队列深度压到 1,各跑 1500 次,交替采样,两轮方向一致,把这个结果丢到任何一个硬件群里,多半会有人回一句“不可能,带缓存的怎么会慢”。
问题恰好出在这句话上,关于 SSD 的常识里掺了太多二手结论:无缓存不能当系统盘、DRAM 越大越不容易掉速、主控自带 32MB 缓存、HMB 会抢系统内存,这些话有的过时了,有的是单位抄错,有的把两个不相干的机制硬绑在一起讲。
它们还有一个共同点,就是都能被某一次真实体验“验证”一遍,然后被当成普适规律传下去:有人换了带缓存的盘觉得开机快了,就总结成“有缓存才适合当系统盘”;有人看到主控照片上印着 32MB,就写成“主控集成 32MB 缓存”。体验是真的,归因是错的,这篇要做的就是把归因这一步拆开来看。
所以这里不推荐具体型号,只把原理讲透:一块盘由什么组成、写进去的数据为什么会越写越慢、映射表和缓存是什么关系、消费级与企业级的分界线画在哪,看完之后再回头看那些说法,哪条站得住、哪条是谣传,你自己就有判断了。
一块 SSD 由什么组成
拆开一块 M.2 固态硬盘,能看到的元件其实很少:一颗主控、一到四颗 NAND 颗粒、可选的独立 DRAM、以及跑在主控里的固件,2280 的 PCB 上还散着几颗小电容的焊位,那是给掉电保护留的位置,消费级盘上通常是空着的。
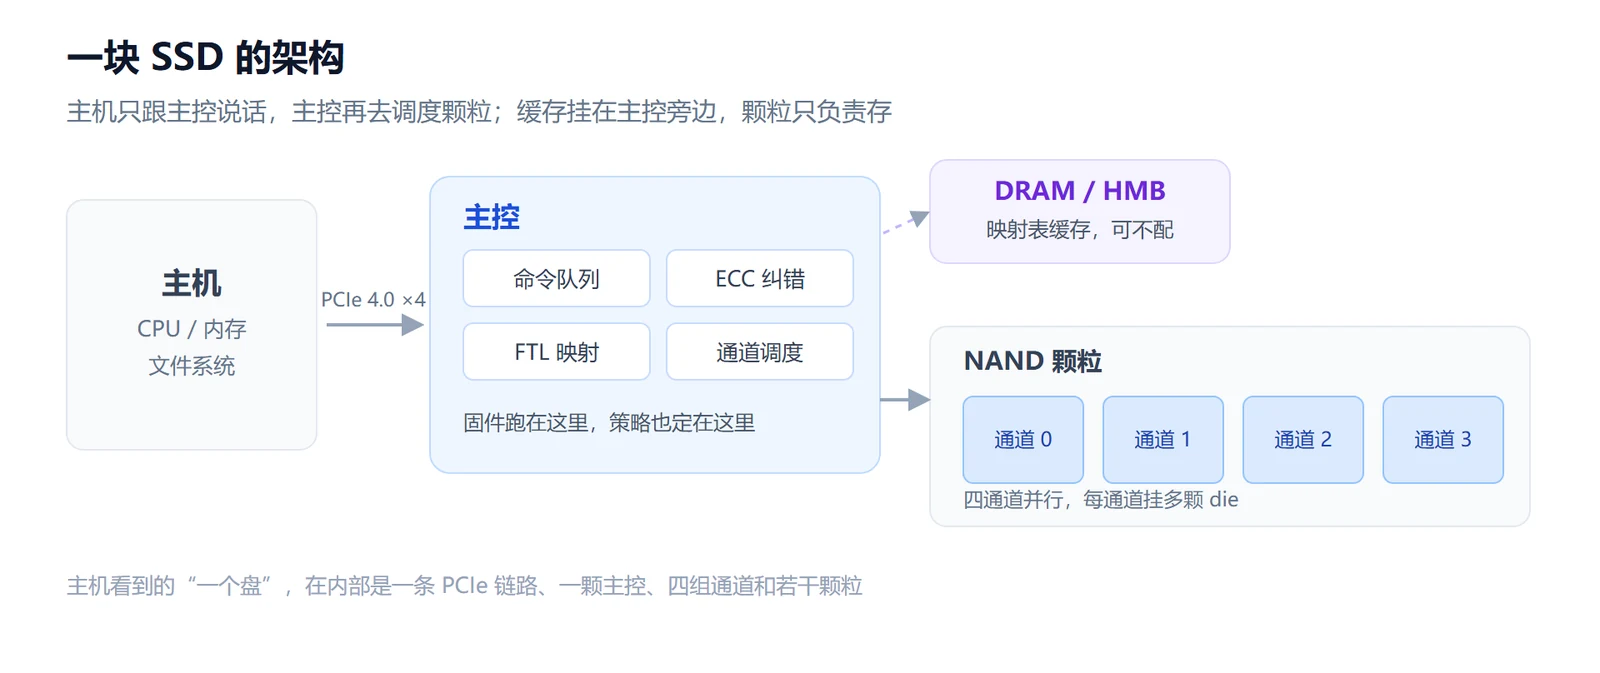
主控决定这块盘的性格,NAND 只负责提供容量和并行度,主控要做四件事:把主机的读写请求拆成对闪存的操作、算 ECC 纠错、维护逻辑地址到物理地址的映射、在后台搬数据做垃圾回收和磨损均衡;同一批颗粒配不同主控,做出来的盘能差出一倍的速度和完全不同的掉速曲线。
固件是看不见的那一半,它决定 SLC 缓存划多大、垃圾回收什么时候启动、温度到多少开始降频、掉电之后怎么恢复映射表,厂商之间真正拉开差距的地方,很多时候不在物料清单上,而在这些策略里,而策略是没法从照片上看出来的。
ECC 这一项值得单独拎出来说,消费级盘普遍用 LDPC 纠错,读的时候先按硬判读,错了再按软判重读,一次重读要多花几十微秒到几毫秒;盘用久了、温度高了,重读次数上升,表现出来的就是“用着用着变卡了”,而 SMART 里看不出任何异常,因为盘还在正常工作,只是慢了几档。
主控的规格里还有几项不显眼但影响手感的参数:支持几条 PCIe 通道、有没有独立的电源管理单元、温度传感器装在哪个位置。笔记本上的盘经常要在几毫瓦和几瓦之间来回切换,切换得快不快、退出低功耗状态要多久,直接决定了你敲下回车之后那一下的响应。
NAND 颗粒按每个存储单元存几位来分类,这是消费级和工业级分岔的起点,也是后面所有性能取舍的源头。
| 类型 | 每单元位数 | 写入速度 | 擦写寿命(量级) | 典型用途 |
|---|---|---|---|---|
| SLC | 1 | 最快 | 数万到十万次 | 企业级写缓存、工业盘、SLC 缓存区 |
| MLC | 2 | 快 | 三千到一万次 | 老款高端盘、部分工业盘 |
| TLC | 3 | 中等 | 一千到三千次 | 消费级主力 |
| QLC | 4 | 慢 | 几百到一千次 | 低价大容量、读取为主的场景 |
表格里的趋势比具体数字更重要:每单元塞的位越多,成本越低、写入越慢、寿命越短,所以厂商要提速,第一反应通常不是换颗粒,而是把 TLC 当 SLC 写,也就是后面要讲的 SLC 缓存,用三倍的空间换两三倍的速度。
容量和速度的关系也藏在这张表里,一颗 NAND 的接口速度是 2400MT/s,四通道拼起来才喂得饱 PCIe 4.0 ×4,同样主控下,1TB 用两颗颗粒、2TB 用四颗,并行度上去了写入才跟得上标称值,同型号不同容量的盘写入速度经常不是一个数,原因就在这儿。
颗粒的排布还有讲究,单面四颗和双面八颗,同样的容量,前者更薄更适合轻薄本,后者并行度更高、写入更快但发热更集中;这也是为什么同样标 2TB 的盘,有的能塞进 2230 的短卡里,有的必须占满 2280 还要带散热片。
写入不能原地改:页、块与垃圾回收
机械硬盘可以原地覆盖一个扇区,闪存不行,NAND 的最小写入单位是页,常见 4KB 到 16KB,最小擦除单位是块,一个块装几百页,要改一页,只能把新数据写到另一个空闲页,旧页标成无效,等着被回收。
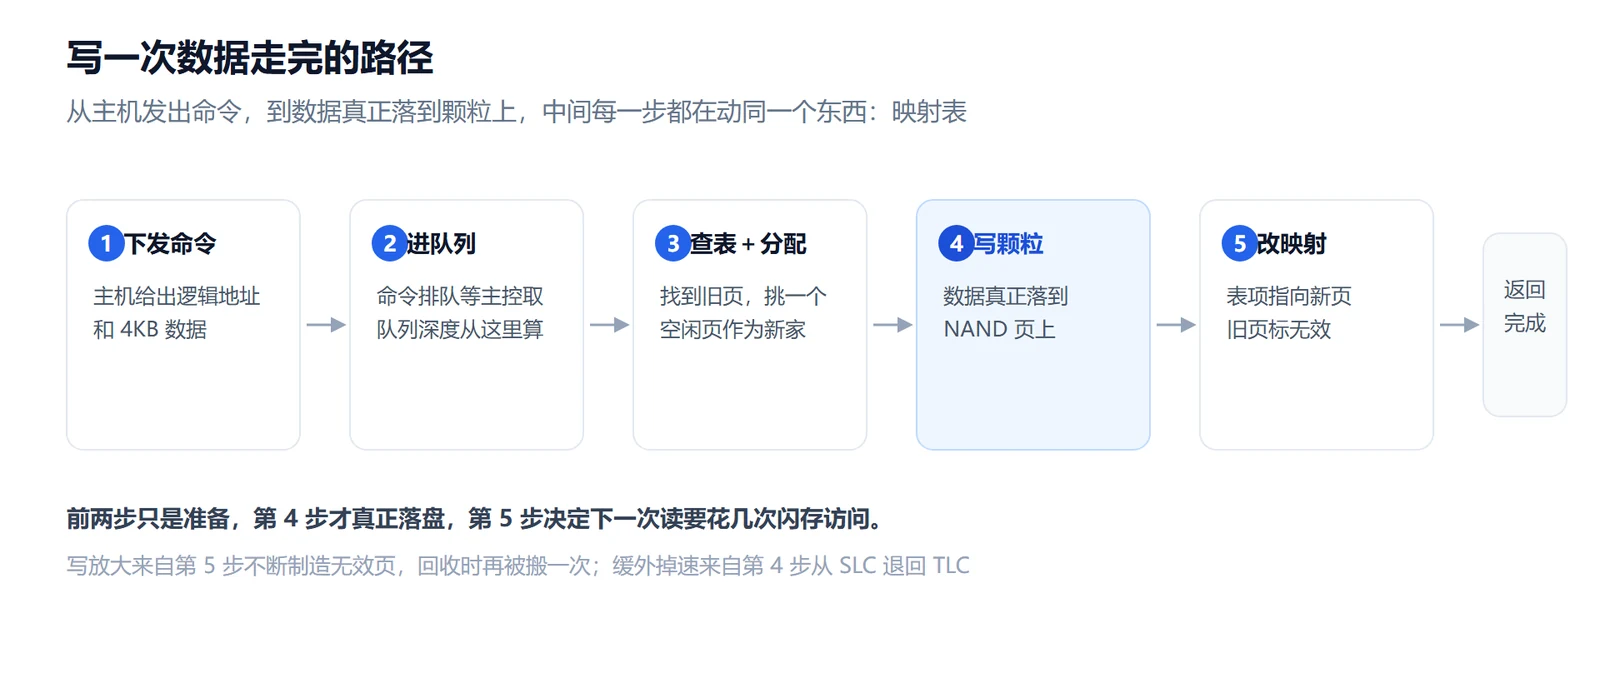
把这条链路走一遍就明白了:主机要改一个 4KB 的页,主控查映射表确认位置,把新数据写到一个空闲页,再把旧页标成无效、把表项改指过去,一次 4KB 的修改就是一次 4KB 的写入,代价记在后面的账上。
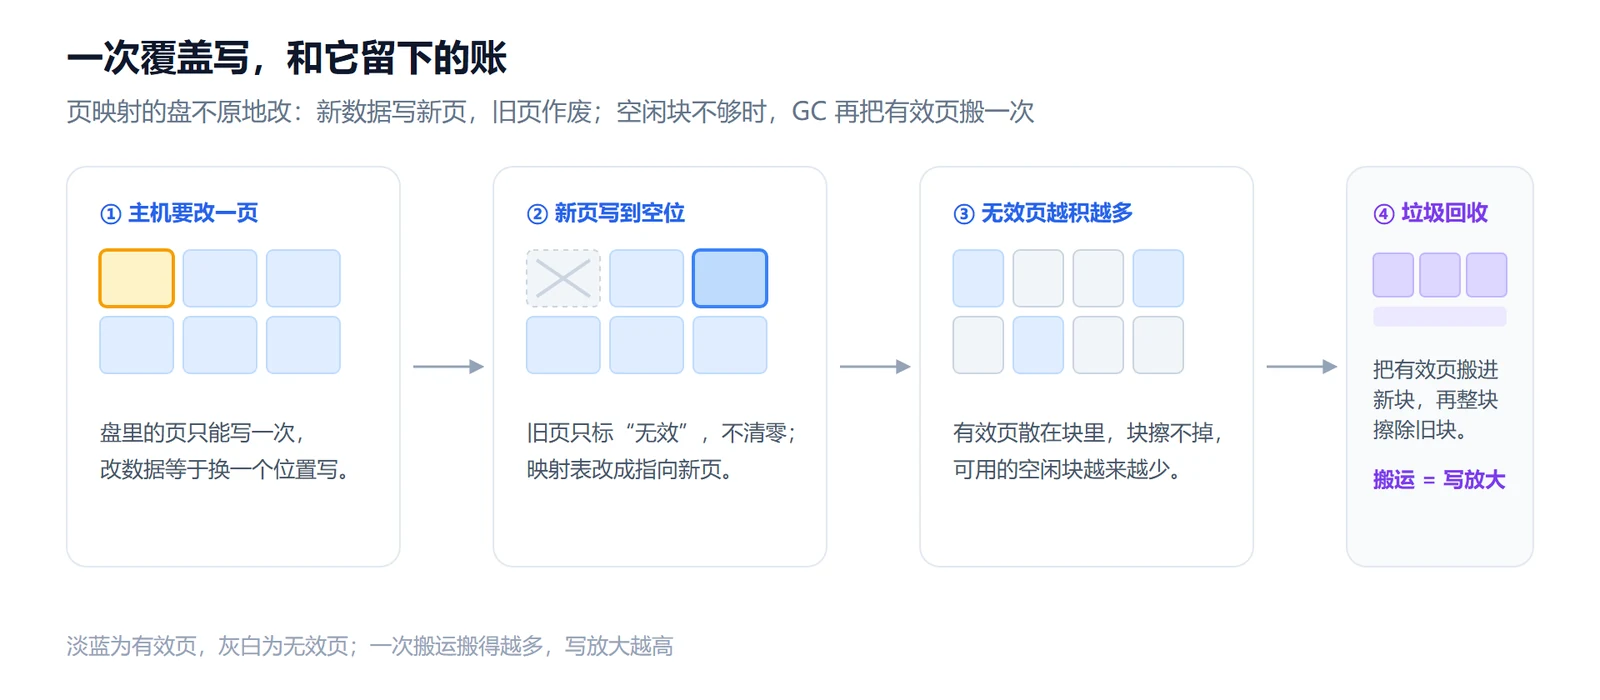
这个机制带来两个后果,一个是写放大,你写 1GB 数据、颗粒可能被写 2GB 甚至更多,另一个是垃圾回收,空闲块不够时主控得先把某个块里的有效页搬到别处、擦干净整块再用,搬的过程占着闪存带宽,前台写入只能排队。
写放大的数值跟使用方式强相关,这也是为什么同一块盘在不同人手里表现差很多。
| 场景 | 典型写放大 | 原因 |
|---|---|---|
| 连续拷大文件 | 1.0–1.2 | 顺序写,映射连续,几乎不触发搬家 |
| 日常办公、网页缓存 | 1.5–2.5 | 小文件多,覆盖写频繁 |
| 满盘随机写 | 3–5 以上 | 空闲块紧张,GC 反复搬有效页 |
这解释了为什么盘用到八成就开始变慢:不是颗粒老化,是空闲块少了,GC 被迫更频繁地搬家,前台写入被后台任务挤掉带宽,企业级盘留一块用户看不见的预留空间(OP),就是为了让 GC 始终有地方干活,把延迟曲线压平。
写放大还有一个隐蔽的来源是小文件,系统日志、浏览器缓存、聊天记录,每次都是几百字节到几 KB,落盘时被凑成一个页写下去,页里剩下的空间就浪费了,下一次改同一个文件又要整页重写,所以同一块盘装系统和当仓库盘,寿命消耗完全不是一个量级。
磨损均衡是同一套逻辑的另一面,闪存的每个块能擦的次数有限,主控要把写入均匀摊到全盘,不能让某几个块先写坏,冷数据也会被定期搬一次,防止长期不动的块电荷流失;这些动作都在后台发生,用户看不到,但它们决定了盘的寿命和长期一致性。
还有一个容易被忽略的指令是 TRIM,删除文件时操作系统告诉盘“这些页不要了”,主控才能把它们标成可回收,而不是当成有效数据一直搬来搬去;老系统或者外置硬盘盒不支持 TRIM 的时候,盘会越用越慢,原因就在这儿。
GC 和 TRIM 的关系可以这么理解:TRIM 告诉盘哪些页已经作废,GC 才知道该搬哪些、该丢哪些。没有 TRIM,盘会把大量已经删除的数据当成有效页搬来搬去,写放大凭空翻倍,这也是老系统上 SSD 越用越慢的主要原因,换盘之前先确认 TRIM 是开着的。
FTL 与三级缓存
主机给的是逻辑地址,颗粒要的是物理地址,中间这层翻译叫 FTL(Flash Translation Layer),它维护一张 L2P 表记录每个逻辑页当前落在哪个物理页上,每写一次就更新一条记录,这张表有多大,直接决定了这块盘需不需要外挂 DRAM。
映射表到底多大
拿 1TB 的盘、按 4KB 粒度做页映射算一遍:逻辑页数量是 256M 个,每条记录 4 字节,整张表 1GB,2TB 就是 2GB,比不少轻薄本的内存条还大。这就是 DRAM 存在的理由,把整张表放进去之后,查一次地址完全不用碰闪存。
早期有个经验配比,1GB 容量配 1MB DRAM,1TB 盘刚好给 1GB,正好装下全表,现在这个配比经常打折,1TB 给 512MB 的也不少,因为固件会做分层:热区常驻 DRAM,冷区回落闪存,用命中率换成本和功耗。
无缓存方案的选择是把映射粒度做粗,块映射一条记录管一整个块,表能缩到几十分之一,代价是随机写要先读出整块再改,一次 4KB 的修改背后可能就是几 MB 的读写,这是 DRAM-less 在随机写上最吃亏的地方;粗粒度换小表、小表换低成本和低功耗,这才是 DRAM-less 的底层逻辑,它不是把缓存“省掉”,而是换了一套记账方式。
表项的更新还有一层日志,映射表不能每次都原地改,否则掉电时整张表就废了,所以固件先把改动写成追加日志,攒够一批再合并成新的表块;日志合并的频率决定了掉电恢复要多久,也决定了随机写在后台要多花多少带宽,这部分开销在跑分里看不见,在日常使用里就是偶尔那一下卡顿。
主控里的 SRAM
不管有没有 DRAM,主控内部都有一块 SRAM,几百 KB 到几 MB,用来跑固件、放命令队列、缓存当前在用的表项。国内一份 SSD 厂商的专利(CN108021511B)写得很具体:传统无缓存方案的控制器内部约 1MB SRAM,其中约 512KB 专门留给映射表缓存。
网上流传的“主控自带 32MB 缓存”基本是单位抄错,32MB 等于 256Mbit,按 12nm 的高密度算要十几平方毫米,按 28nm 算要上百平方毫米,比主控本体大好几倍,成本和功耗都不成立;更可能是 32Mbit,也就是 4MB,转述的时候把 bit 丢了。东芝 TR200 那个“16MB SRAM”的说法同理,量级应该是 2MB。
SRAM 容量虽小,访问延迟却是纳秒级,比 DRAM 又快一个数量级,所以固件会把最热的表项、命令队列和正在处理的请求上下文全塞在里面。命中 SRAM 的查表几乎不花时间,miss 之后才往 DRAM、HMB、闪存三级走,这个层级关系决定了同一块盘在不同访问模式下能差出好几倍延迟。
HMB 借的是哪块内存
NVMe 1.2 引入了 HMB(Host Memory Buffer),允许盘向主机申请一块内存放映射表,主流盘申请 64MB 左右,这是规范给单控制器的上限档位,1TB 的表是 1GB,64MB 只够覆盖 6%,所以 HMB 是补充,替代不了 DRAM 的全表常驻。
这块内存的性质要说清楚:开机时由系统分配,物理连续、非分页、控制器独占,任务管理器里算在“为硬件预留的内存”那一栏,应用分配不到它,内存吃满也不影响它的大小。本机 32GiB 装机、系统可见 32304.5MB,差的 463.5MB 就落在这栏里。
要隔离的原因很简单,里面存的是地址映射,要是这块内存能被普通程序改写,改一条表项就能让逻辑地址指到别的物理页上,读回来的是别人的数据,写下去覆盖的也是别人的数据,这不是性能问题,是数据完整性问题,所以规范要求它非分页、运行中主机不得改写。
顺带说一句,HMB 不是所有平台都给得出来,盘要在识别阶段申报自己需要多大,主机按自己的能力分配,给不满时盘只能退回“只用 SRAM 加闪存二级表”的模式,性能掉一截;这也是为什么同一条无缓存盘换台机器跑分能差 10% 以上。
闪存里的二级表
全量表总得有地方放,答案是闪存里的固定区域,通常格式化成 SLC 保证读取速度,查表 miss 时,主控从这里读一段进来,确认物理地址之后再读用户数据,一次随机读变成两次闪存访问,延迟就是这么涨上去的。
这也是两级映射的由来:一级表小,常驻 SRAM,记录二级表各段在闪存里的位置;二级表大,按需加载,顺序读时映射连续,一次调入能覆盖很长一段,性能损失不明显,随机读时映射散落,命中率一掉差距立刻显形。
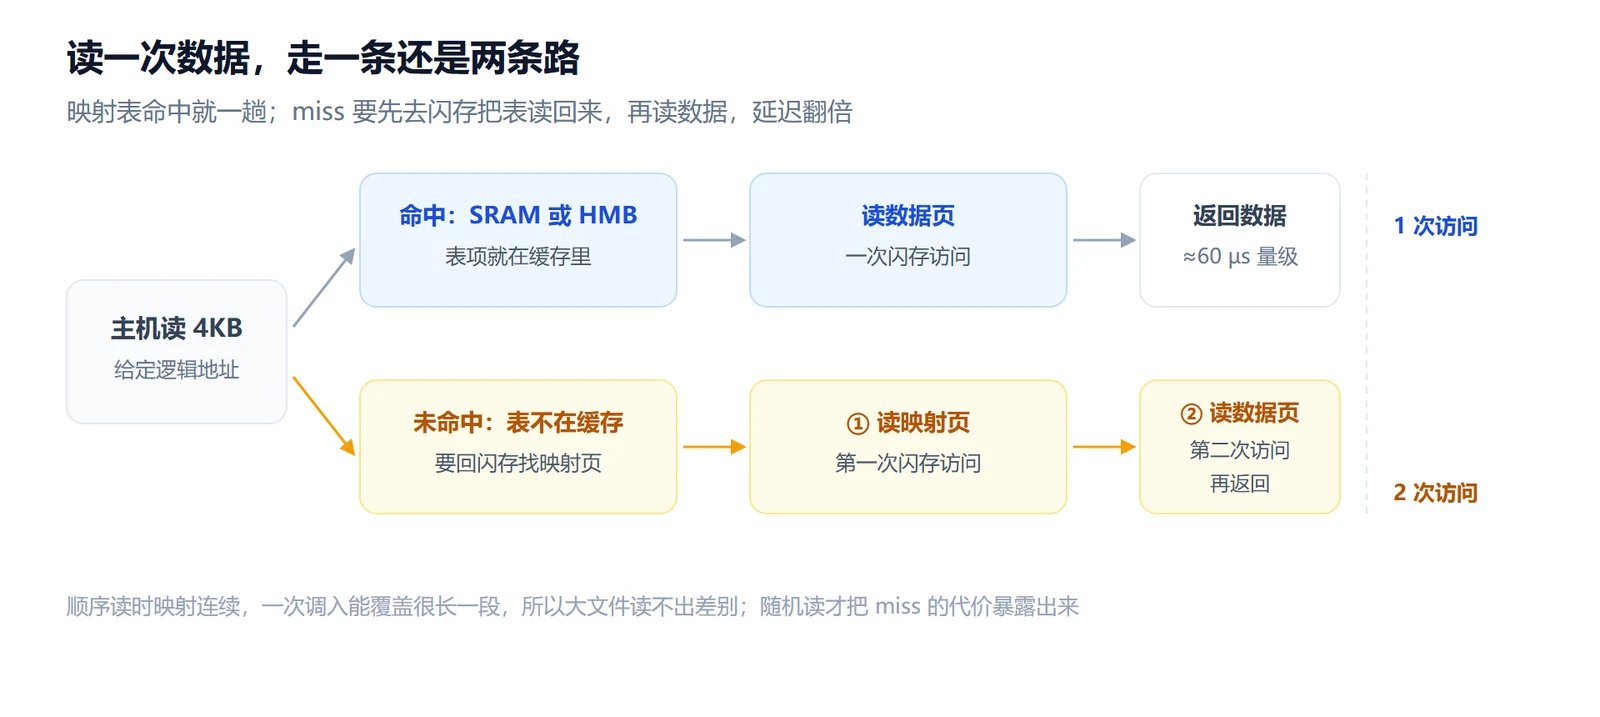
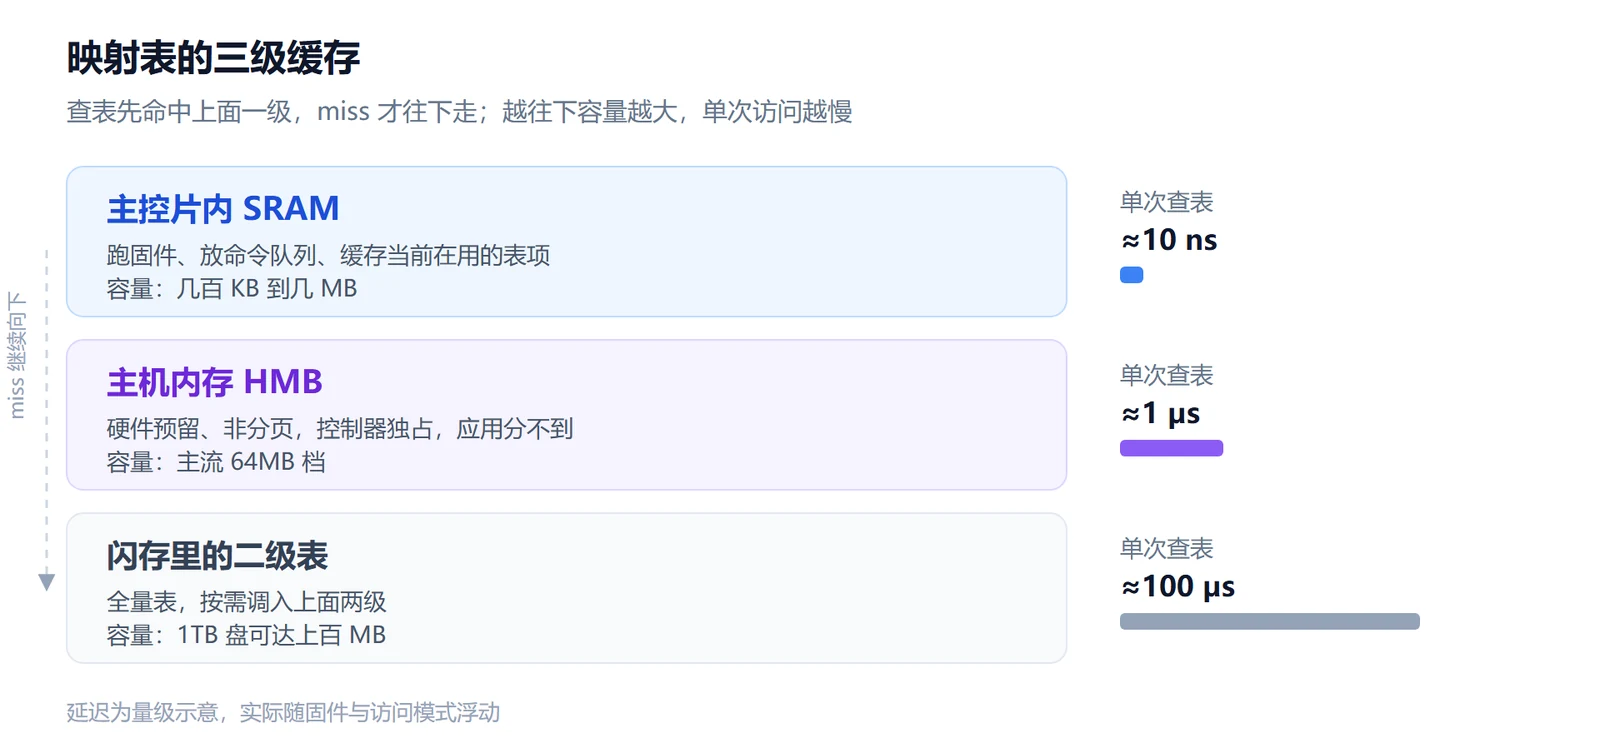
把这三级放在一起看,各自的定位就清楚了:热区、大块、全量,各管一段,不是简单的容量叠加。
把这套机制放回真实负载里,就能解释本机那组数据了,QD1 的时候,一次读要么命中 SRAM 和 HMB、要么去闪存取一回表,代价几十微秒;队列堆到 32,每次读都要排队,单次时间涨到 358 微秒,但总吞吐上去了。延迟和吞吐是两件事,厂商宣传的 IOPS 说的是后者,日常体验看的却是前者。
| 层级 | 位置 | 容量 | 作用 |
|---|---|---|---|
| SRAM | 主控 die 内 | 几百 KB 到几 MB | 固件运行、命令队列、映射表热区 |
| HMB | 主机内存,硬件预留 | 主流 64MB 档 | 映射表大块片段,PCIe DMA 读取 |
| 二级表 | 闪存 SLC 区 | 按容量算,1TB 可达上百 MB | 全量映射,按需调入前两级 |
SLC 缓存与掉速曲线
SLC 缓存是另一个被误解的名词,做法是把 TLC 颗粒按 SLC 方式写,一个单元只存一位,写入速度快两三倍,代价是同样数据占三倍空间;它是性能手段,不是数据保险,这一点后面还会单独说。
缓存的大小没有固定值,空盘时能占到总容量的三分之一到三分之二,具体看固件策略和容量档位,第三方评测里,PC411 1TB 空盘测出 640GB 的 SLC 缓存,PM9A1 2TB 在另一份评测里是 210GB 左右;盘用得越满,这部分越小,因为固件要把空间还给用户。
带 SLC 缓存的消费级盘,写入速度通常不是一条直线,而是三段,厂商标称的那个数字只对应第一段。这也是很多厂商营销的时候喜欢用的,真正决定好不好用的不是看那一长串的数值,而是延迟、队列、SLC Cache。
但三段不是所有盘的通用形态。没有 SLC 缓存的盘,从第一秒就是直写,曲线只有一段,企业级多半如此,部分消费级也这么做;还有些盘所有写入都先落 SLC、回写全放到空闲时做,前台能一直贴着高速跑,直到 SLC 区被写穿,你看到的是一段很长的平台加一次陡降,也不是三段。
| 阶段 | 状态 | 速度 | 什么时候出现 |
|---|---|---|---|
| 缓内 | 数据写进 SLC 区 | 接近标称,旗舰盘 5000-7000MB/s | 取决于剩余缓存,几十到几百 GB |
| 缓外 | SLC 写满,转 TLC 直写 | 几百到 2000MB/s | 取决于颗粒并行度和固件 |
| 稳态 | 盘被填满,GC 与写入形成固定节奏 | 不再波动,可能几百 MB/s,也可能几 GB/s | 128K 两遍 + 4K 两遍全盘写之后 |
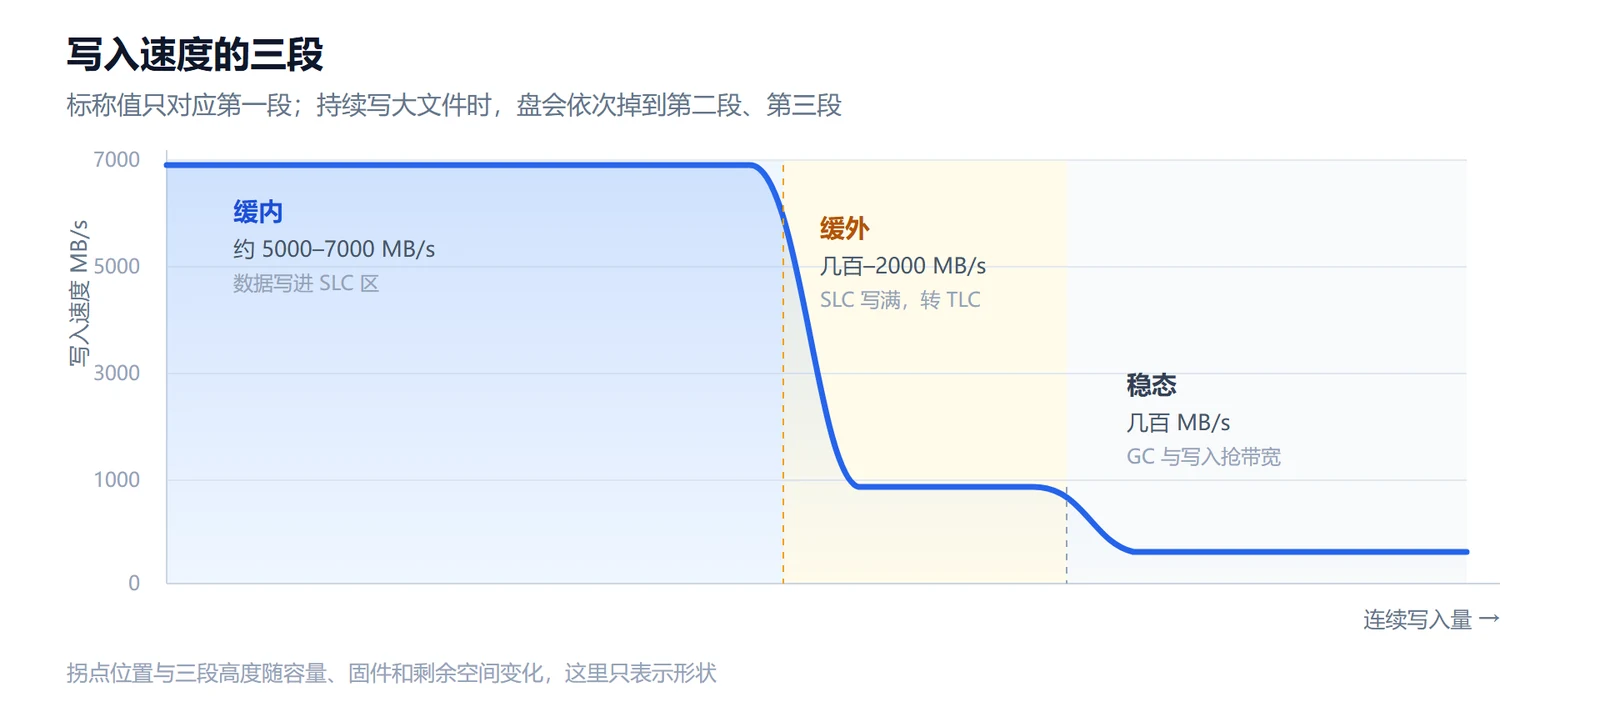
缓外掉速是物理规律:SLC 的加速靠多写几位换来,写满之后只能按 TLC 直写,这跟有没有 DRAM 完全无关,带缓存的盘写满一样掉,DRAM 管的是查表,不是存数据。
稳态这个词也常被用错,它不是“最慢的那一段”,而是盘被填满之后、性能不再随写入量变化的那一个工况:按惯例先做两遍全盘 128K 顺序写,再做两遍全盘 4K 随机写,之后测到的数值才算稳态。带 SLC 缓存的消费盘在这个过程里一路往下掉,最后停在一个平台上;企业级盘一开始就直写、OP 又大,掉不了多少就稳住,稳态可能是 3GB/s,不是 300MB/s。
掉到多低,由并行度和 OP 决定
缓外掉到几百 MB/s 还是 1GB/s,跟缓存多大没关系,跟这块盘能同时开几个写入口有关系。缓存的大小只决定第几分钟进入缓外,进去之后跑多快,是另一套东西。
写进闪存的单位是 Die,一颗 Die 在同一时刻只能执行一个编程操作。TLC 单 Die 的顺序写入大约 200-400MB/s,QLC 一个单元要分辨 16 个电平,只有 50-100MB/s,所以一块盘能同时铺开多少个 Die 在编程,直接决定缓外能跑多快。
这里有个容易数错的地方:PCB 上能看到的黑色方块是 NAND 封装,不是 Die。Die 封在环氧树脂里面,得磨开才数得清,一颗封装里叠 4 个 Die 是常见做法,西数尤其偏爱这么干,外观上只有一颗颗粒、里面其实是四个裸片;也有单 Die 封装的小容量方案,所以靠数颗粒是推不出并行度的。
消费级主控通常只有 4 个通道,能挂几个封装、每个封装里塞几个 Die 都有上限,写入口就这么宽。同样是 4 通道,1TB 的 TLC 盘缓外直写落在 1GB/s 上下,2TB 因为 Die 总数翻倍,常见到 2GB/s;QLC 受单 Die 速度拖累,同样容量只做到三分之一到四分之一。
企业级走的是加宽这条路:8 到 16 个通道、每通道挂满 Die、OP 留到 28%,写入被摊到更多块上,单块压力小了,GC 也有地方干活;更关键的是它基本不划 SLC 缓存,从第一秒就是直写,所以曲线没有断崖,是一条低但平直的线。SNIA 稳态测试要的就是这条线,不是峰值。
同一代颗粒能做出完全不同的曲线,差别在固件怎么用 SLC:
- 全局动态 SLC。西数几代消费盘走的都是这个思路,把大部分空闲空间都当缓存,爆发阶段能吃满 PCIe,代价是长程任务一开始回写,SLC 转 TLC 的搬运和前台写入抢同一批通道,速度掉得又深又快,“前 200GB 飞快、后面剩 300MB/s”就是这种策略。
- 保守 SLC。只划一小块,写完也不急着回写,前台一直走 TLC 直写。起跑不亮眼,全程 1GB/s 左右,长任务反而更稳。
- 激进回写。SLC 给得不少,但一写满就立刻搬,前台在直写、后台在搬 SLC,两件事同时吃通道,稳态比纯直写还低。有些盘的第三段比第二段更难看,原因就在这儿。
所以判断一块盘的长写表现,顺序是:先看缓外直写有多快(并行度),再看它多久进入缓外(SLC 策略),最后看 OP 和 GC 能不能把稳态托住。这条链上没有任何一环跟 DRAM 有关。
顺带说清楚缓内速度的意义,一块盘缓内能跑 7000MB/s,只代表你拷一个 20GB 的文件夹时前半段很快;装系统、开软件这些日常动作根本不走这条路,它们看的是 4K 随机读和写入延迟,两个指标跟缓内峰值没有关系,用峰值挑盘,等于拿最高时速挑一台只在市区开的车。
厂商还会用动态和静态两种 SLC 策略,动态 SLC 拿剩余空间当缓存,盘越满缓存越小;静态 SLC 固定划一块区域,满盘也保留,代价是可用容量少一截,企业级盘多数用后者,消费级看成本和定位,同一块颗粒能做出完全不同的曲线。
缓存回收的过程也值得说一句,SLC 区里的数据不是永远待在那儿,盘空闲的时候主控会在后台把它们读出来、合并成 TLC 写回主区,把 SLC 空间腾出来备用;这个动作发生在你不在用盘的时候,所以它会跟休眠抢时间,笔记本合盖一晚上、第二天开机发现盘热了一下,多半就是在干这个。
消费级与企业级的分界
企业级和消费级的区别不在峰值速度,同一代 NAND 做出来的企业级盘,顺序读写标称值经常比消费级旗舰还低,因为它的目标不是跑分好看,而是在任何负载下都不掉链子;要理解这条分界线,得看下面几个指标。
| 维度 | 消费级 | 企业级 |
|---|---|---|
| 不可修复错误率(JESD218) | ≤1E-15 | ≤1E-16 |
| 耐久度口径 | TBW,1TB 常见 600TBW,约 0.33 DWPD | 1-3 DWPD 起,部分读密集型号更高 |
| 预留空间(OP) | 约 7% | 常见 28% 左右 |
| 掉电保护(PLP) | 无 | 板载电容,掉电刷盘 |
| 稳态性能 | 不保证,长写会掉到十分之一 | 过 SNIA 稳态测试,延迟曲线压平 |
| 形态与接口 | M.2 为主 | U.2、E3.S、双端口、热插拔 |
UBER 这一项最容易被忽略,1E-15 和 1E-16 看着只差一个数量级,落到 1PB 的读取量上就是几十次和几次的差别,日常感觉不到,盘用旧了、温度高了、接近寿命末期的时候才会碰上;企业级靠更强的 ECC、更大的 OP 和更保守的读重试策略把这个数压下去。
把 TBW 和 DWPD 换算一下更直观,1TB 盘标 600TBW,按五年保修摊下来每天大约 0.33 次全盘写入;企业级 1 DWPD 是每天写满一次,三年下来超过 1000TB,这个差距不是厂商小气,是颗粒筛选和固件目标不同,消费级按低成本筛,企业级按耐久和一致性筛。
PLP 是另一道分水岭,企业级盘板上有电容,掉电瞬间把缓存里的数据和映射表刷进闪存,消费级没有,掉电时正在写的数据可能丢,映射表要靠日志恢复,恢复过程可能持续几十秒;台式机断电顶多重启,服务器断电是数据一致性问题,这条差别值不值那个价钱,看用在哪儿。
稳态测试是 SNIA 定的方法,先用全盘顺序写和全盘随机写把盘填满,再持续加压实测,看性能不再波动时那个平台期的数值,消费级盘在这个测试里通常撑不住,写到几十 TB 之后速度掉到标称值的十分之一以下,这也是为什么数据库和虚拟化平台不能拿消费级盘凑数,不是跑不动,是跑着跑着延迟曲线变成心电图。
形态上的差别也反映了定位,消费级是 M.2 单端口,插在主板上一颗螺丝固定;企业级是 U.2 或 E3.S,支持双端口、热插拔和更厚的散热结构,一块盘坏了可以在机箱不停机的情况下换掉,这些设计跟速度无关,跟“能不能在机房活下来”有关。
八个流传很广的说法
下面这些说法,我在论坛、视频和评论区都见过,有的只对一半,有的完全错,逐条拆一遍,顺手把前面的原理串起来。
- 无缓存的盘不能当系统盘。本机实测 QD1 下无缓存那块快 1.2 µs,QD32 差 3.6%,而日常负载到不了 QD32,系统盘看的是小队列随机读和低功耗,无缓存方案完全够用。
- DRAM 越大越不容易掉速。DRAM 存的是映射表,不碰用户数据;长写掉到多低,看的是 OP 留了多少、几条通道能并行、固件让 SLC 什么时候回写,这三项里没有 DRAM 的位置。
- 主控自带 32MB 缓存。单位错,实际是 32Mbit 也就是 4MB,按面积算 32MB SRAM 比主控本体还大几倍。
- HMB 会抢系统内存。它是开机时分配的硬件预留内存,非分页、控制器独占,应用分不到,内存吃满它也不变。
- 盘塞到八成掉速是缓存不够。是空闲块少了、GC 频繁搬家、SLC 缩小,跟 DRAM 无关,但“别塞太满”这个建议本身成立。
- 温度低说明传感器坏了。要看是否跟随负载,这块 PC411 空闲 27°C、峰值 40°C,PM9A1 空闲 31°C、峰值 61°C,都在正常范围,传感器也在动。
- SLC 缓存能保护数据。不能,SLC 缓存是性能手段,掉电时缓内数据照样丢,真正管这件事的是 PLP。
- TBW 写完盘就废。TBW 是保修线,不是死亡线,颗粒实际能写的量通常是标称的两三倍,但过了保修线厂商不担责,这才是要留余量的原因。
这八条里,前五条都指向同一个误区:把“缓存”当成一个笼统的好处,实际上 SSD 里的缓存至少分三层,各自解决不同的问题,容量数字大不代表用得上,用得上也不代表用得出差别;判断一块盘,要看它在你的负载下第几分钟开始掉速,而不是规格表第一行的数字。
还有一个更根本的偏差:跑分测的是极限,体验看的是常态,CrystalDiskMark 的 Q32T1 跑出来的数字,和你在 Word 里存一次文档、在浏览器里开十个标签产生的负载,量级差着两三个数量级,拿极限分数预测日常手感,本身就是错配。
还有一条没列进去,因为它不算谣传,只是被用错了地方:QLC 不能买,QLC 的写入确实慢、寿命确实短,但用来做影音库、装游戏、当备份盘,它的成本和容量优势是实打实的,问题不在颗粒,在把它当系统盘还天天写大文件。
按场景选盘
原理讲完,落到选择上其实不复杂:先定容量,再看这块盘在你的写入量下多久进入缓外、进去之后能跑多快,最后才轮到有没有 DRAM,前两步决定体验,第三步只影响查表。
| 场景 | 优先看什么 | 建议容量 | 长写时会发生什么 |
|---|---|---|---|
| 轻薄本系统盘 | QD1 延迟、功耗、温控 | 1TB | 负载到不了缓外,有缓无缓一个样 |
| 游戏本 | 顺序读、缓外直写 | 2TB | 装一次游戏几百 GB,会落进缓外,看的是直写那一段 |
| 视频剪辑 | 缓外直写、OP、TBW | 2TB 起 | 素材一导入就是几十上百 GB,全程在缓外 |
| NAS、软路由 | 功耗、温度、直写速度 | 按盘位 | 长期写入是常态,第一段再快也用不上 |
| 数据库、虚拟化 | 企业级、PLP、DWPD | 按容量规划 | 消费级盘缓存再大也进不了稳态 |
| 移动固态 | 桥接芯片、散热 | 1-2TB | 瓶颈在 USB 和盒子,盘还没到缓外 |
如果只想回答“无缓存能不能用”,答案是分场景的:轻薄本、游戏本、NAS 上能用,视频剪辑要看素材量和盘的空闲块,数据库和虚拟化不能用。但这四条判断的依据没有一条是缓存,它们分别对应“负载到不到缓外”“缓外直写够不够快”“稳态托不托得住”。
同一型号,不同批次可能不是同一块盘
还有一个前提得先说清楚:规格表上的型号只代表一个系列,不代表每一块都是同一个东西。原厂自己有晶圆、或者自研主控和固件,一颗主控配自家颗粒,固件跟着颗粒一起调,同一型号跨批次基本是一回事;第三方模组厂不走这条路,主控从这家买、颗粒从那家买,一批一个组合,固件也得跟着改,你买到的这批和评测里那批,SLC 策略可能完全相反。
具体到体感上:有人买到的盘 SLC 给得激进,前一两百 GB 能贴着标称跑,一旦超过就断崖;同一个型号的另一批可能只划一小块缓存,起跑只有 1GB/s,但全程不掉。评测作者测的是他手上那块的固件版本,你打开包装看到的是另一块盘,这不是翻车,是模组厂的常态。
所以选盘时除了看参数,还要看方案在谁手里。原厂的优势不在峰值高,在于同一型号的可预期性强,你按评测买,拿到的就是评测里那个东西;模组厂的核心技术在别人手上,稳定性天然差一档。数据不当命、只求便宜大碗,模组厂没问题;要长期稳定、要可预测,还是选方案自己说了算的厂商。
还有一个常被忽略的变量是剩余空间,同样一块 1TB 的盘,留 30% 空着和只剩 5%,SLC 缓存能差出好几倍,GC 的频率也完全不同;如果只能记住一条建议,那就是给系统盘留出四分之一的余量,这比换一块更贵的盘管用。
外置固态是另一个容易被数字骗的地方,盘本身标 2000MB/s,插到 USB 3.2 Gen2 的盒子里上限就是 1000MB/s,再遇上桥接芯片散热差、掉到 USB 2.0 的兼容模式,实际只剩几十 MB/s;移动固态的瓶颈几乎永远在盒子和接口上,不在盘上,买之前先看盒子支持什么协议。
最后补一个数字口径的问题,厂商标的顺序读写是缓内峰值,4K 随机是队列深度 256 的峰值,TBW 是按 JEDEC 负载模型算出来的,三个数字都不对应你日常的使用方式;看到“7000MB/s”的时候,正确的理解是“这块盘在理想条件下能跑这么快”,而不是“我拷文件就是这个速度”。
回到开篇那 1.2 微秒,这个差距在跑分软件里看得见,在打开文档、启动程序、切浏览器标签的时候看不见,它的意义不在“谁快”,而在于说明一件事:缓存不是衡量一块盘好坏的唯一尺子,甚至不是第一把。
真正决定日常体验的,是容量够不够、空闲块多不多、固件会不会在你写大文件的时候突然降频,这三件事跟 DRAM 的关系都不大,跟你怎么用这块盘关系很大。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING