



记录一次把 WorkBuddy 系统提示词定位、验证并打上补丁的全过程:模板目录、身份注入、trace 明文证据,以及只删 content_policy 的单文件工具。
AI
今天下午本来想让workbuddy帮我二次开发一下红色警戒2,结果直接罢工了。但是这次不是模型出的问题,而是workbuddy本身 …
语言模型做视频不是靠生成像素,而是写代码交给本地渲染器执行。这篇讲清矢量、数值、时序三条路径,两套可用的安装方案,以及 60 秒成片渲染 181 秒的实测数据,附 ffmpeg 下载和代理失效两个坑的绕法。
Skill 的物理形态是一个装着 SKILL.md 的文件夹。从三级渐进加载、脚本的作用,讲到它和 MCP 的分工,再加上一份技能生态的安全审计数据。
提示词写不好多数不是语气问题。模型每个词都在猜概率,形容词不改变选项,只有局面、判据、样例、边界能收窄选择。附写作、编程、润色、角色、询问五个场景可直接抄的指令。
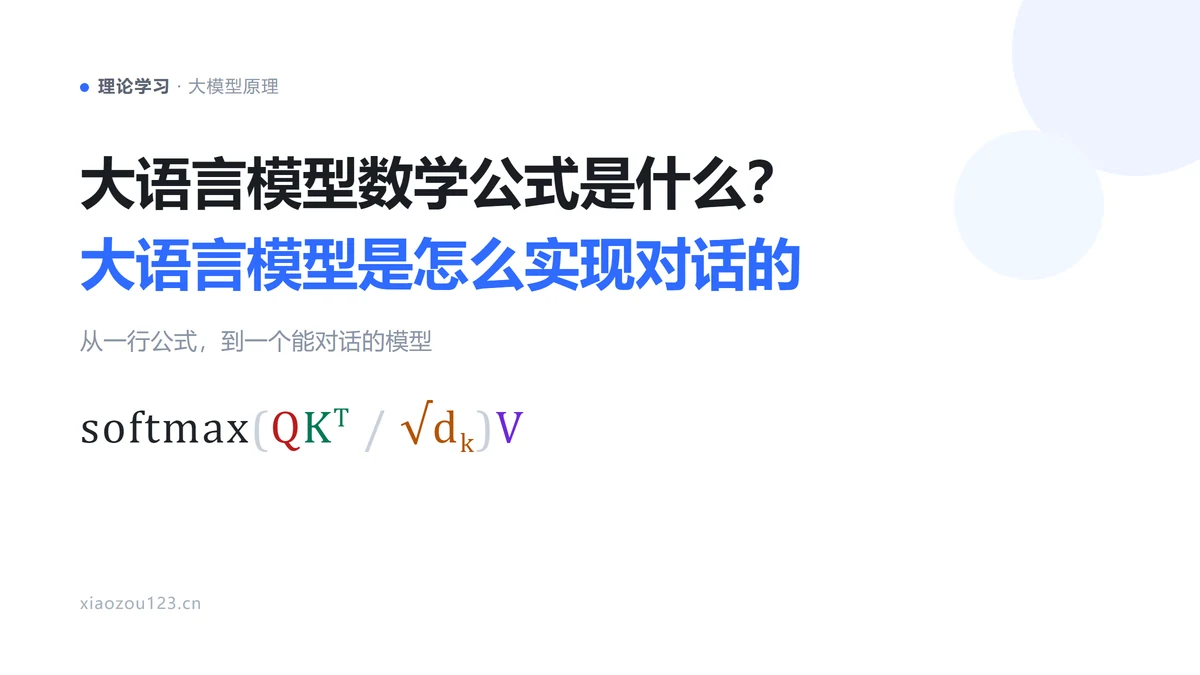
把大模型那几行公式逐个符号翻译成人话:Q、K、V 到底是谁,softmax 在算什么,根号 dk 为什么非除不可,交叉熵里的负号和 log 各干什么活。不推导,只解释每个字母指什么。
上周被人从公众号后台捞进了一个十个人的群。群里除了我,剩下九个全是懒猫微服的人——客服、工程师、还有一个专门负责拉人的。开场白大意 …
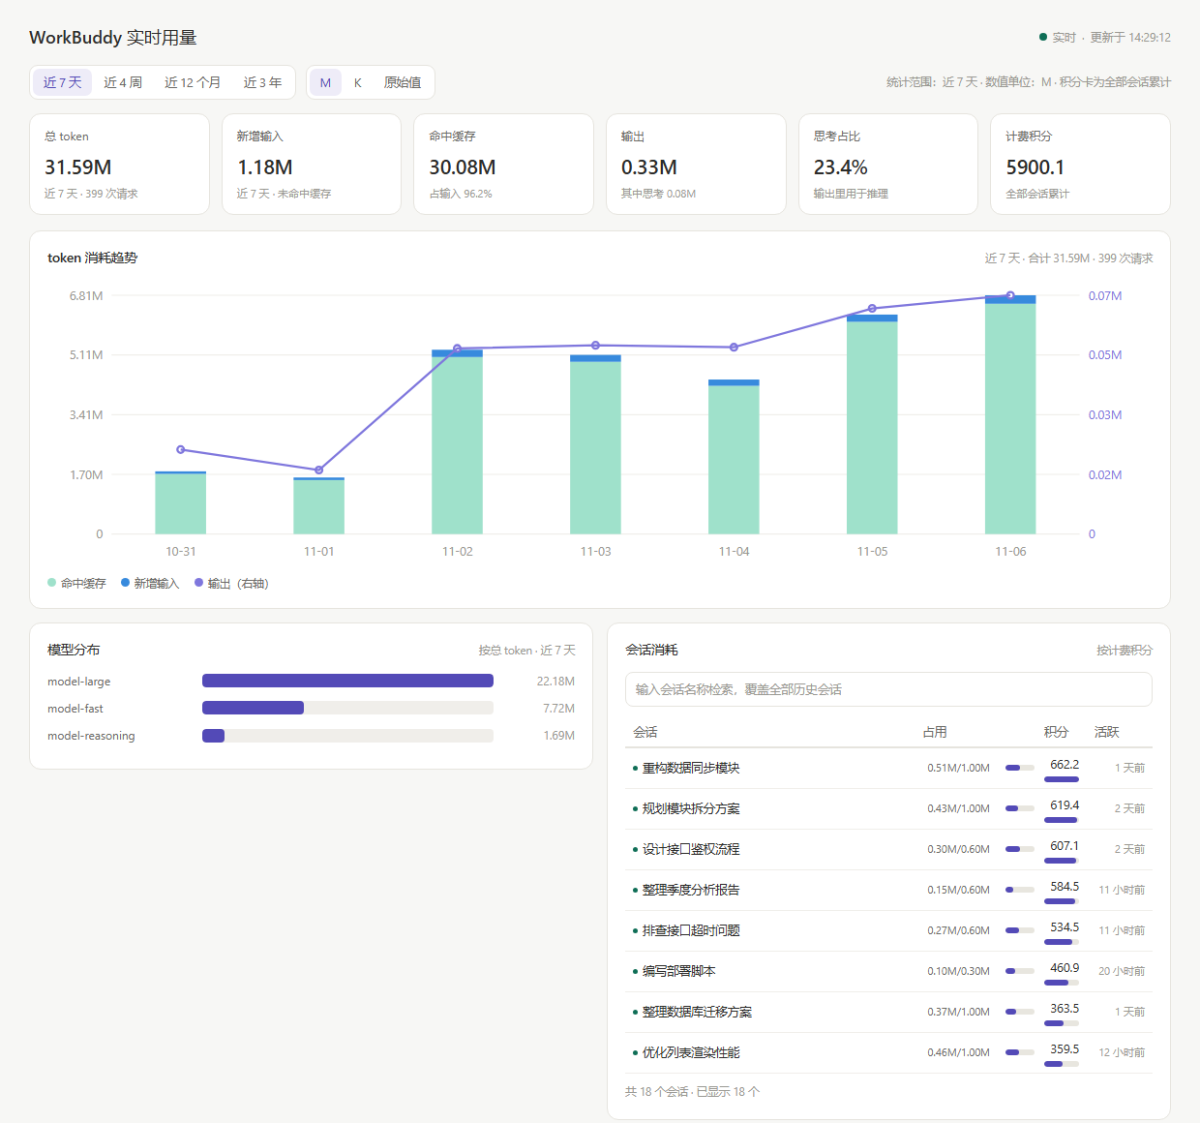
WorkBuddy 只给上下文占用和积分,没有 token 消耗也没有历史。试了三个现成方案都不适用后,我自己写了个本地看板:只读 trace 和数据库,单文件 exe 双击即用。
让它核一份操作手册,它补了一条界面上根本不存在的按钮,语气比原手册还笃定。这篇拆开幻觉的成因:为什么它错得越具体越难被发现、为什么让它“再想想”没用,以及我套在模型外面的四层——查证代替回忆、引用标出处、代码校验、允许它说不知道。
三十块一个月、官方一折的价格背后,是一套完整的成本压缩方案。从一份流出的站长内部文档,拆中转站怎么降智、怎么在账单上做账,以及为什么数据泄露比模型注水严重得多。