

有人丢给我一张海报,绿联办的第一届黑客松挑战赛,奖品是几台 NAS,标题底下一行小字写着总奖池 34,000。我从上往下划,参赛要求、评审团、赛程、奖项设置一路看过去,最后停在海报最下面那行大字上:带上你的 Skill,来绿联 AI NAS 跑起来。
一个做硬件的厂商办比赛,不收应用,不收插件,不收主题皮肤,收的是 Skill。这事放在两年前说不通,现在却顺理成章。
过去这一年,"Skill"这个词从 Anthropic 的一份工程文档,变成各家 AI 产品里的一个菜单项,又变成硬件厂商招人写东西的单位。密度高到这种程度,反而没人解释它到底是什么。
我见过两种典型的误解。一种把它当成"高级提示词",觉得无非是把话说得更细一点;另一种把它当成插件,以为装上了 AI 就多长了一只手。两种都只对了一半,而且错的那一半恰好是最关键的部分。
这篇想把四件事说清楚:Skill 在文件层面是什么,它解决的到底是哪一类问题,它和 MCP、和插件怎么分工,以及它对一个 Agent 的提升究竟有多大。包括哪些提升是实打实的,哪些是被吹出来的。
先说结论
- Skill 的物理形态是一个文件夹,里面至少有一份 SKILL.md。没有编译、没有运行时、没有服务进程,用记事本能打开,用 Git 能管版本。
- 它补的不是模型的能力,是模型的经验。模型本来就会读 PDF、会写 Python、会调接口,但它不知道你们公司填表要先填哪一栏、出错要找谁签字。
- 真正让它可用的设计叫渐进式披露。平时只把每个技能的名字和一句描述挂在系统提示里,等任务对上了才去读全文,需要细节了才去翻附件。这是"装一百个技能也不卡"的全部秘密。
- Skill 里可以放脚本,而且脚本不进上下文。模型只看到脚本打印出来的结果,看不到脚本本身。这一条同时解决了准确性和成本两个问题。
- Skill 和 MCP 不冲突,一个管"怎么做",一个管"连得上"。MCP 让 Agent 摸到你的数据库,Skill 告诉它摸到之后按什么规矩办事。
- 它的天花板是你自己的流程水平。你本来就没有稳定的做事方法,写成 Skill 也只是一份写得比较整齐的混乱。
一个 Skill 就是一个文件夹
先把神秘感去掉。2025 年 10 月 16 日 Anthropic 推出 Agent Skills 的时候,官方给的定义朴素到有点扫兴:一个目录,里面有一份 SKILL.md,开头是 YAML 格式的元数据,后面是给人也给机器看的正文。就这样。
我机器上装着十几个技能,随手挑一个出来看真实的样子。这个是用来在软路由上部署 AdGuard Home 的,帮我搞定过好几次 DNS 接管:
adguardhome-istoreos-safe-deploy/
├── SKILL.md
└── (这个技能没有别的文件)

--- SKILL.md 开头 ---
name: adguardhome-istoreos-safe-deploy
description: 在 iStoreOS/OpenWrt 上安全部署 AdGuard Home 并接管 53 端口的
  完整流程(含免图形界面 API 配置、加密上游、广告规则、恶意域名安全拦截、
  误杀控制、验证与回滚)。当用户要在软路由上安装 AdGuard Home、更换 DNS
  服务、配置 DoH/DoT 上游、给 DNS 加安全过滤或排查"接管家用 DNS 后断网"时使用。
正文第一行的小标题写着「最高优先级安全规则(血的教训)」,下面第一句话是:切换 DNS 端口必须"先立后破"。这句话不是模型想出来的,是我在把家里网络搞断过一次之后写进去的。
一份 Skill 的价值,往往就藏在这种"我踩过所以你不用踩"的句子里。
再看一个复杂点的。管博客发文的那个技能,目录里多了一个 scripts 文件夹,放着三个 Python 脚本:一个算文章的文风基线,一个批量修图片的 alt 属性,一个抓线上页面做校验。
wordpress-mcp-publishing/
├── SKILL.md                      ← 流程、坑、约定
└── scripts/
    ├── style_baseline.py         ← 统计段长、句长、加粗密度
    ├── fix_image_seo.py          ← 补 alt,默认 dry-run
└── verify_render.py ← 抓线上 HTML 做十几项检查所以一个技能可以很轻,一份 Markdown 就够了;也可以很重,带上脚本、模板、参考文档、示例数据。官方的规范把可选的目录定成三个:references 放参考资料,scripts 放可执行脚本,assets 放模板和素材。
名字不重要,重要的是这三类东西的加载时机完全不同,这一点后面单独讲。
这里有个细节值得单独拎出来:description 不是简介,是触发器。模型在决定要不要用某个技能时,唯一依据就是这句描述。
所以官方文档反复强调,描述里必须同时写清两件事:这个技能做什么,以及在什么情况下该用它。上面那份 AdGuard 的描述里,"配置 DoH/DoT 上游""排查接管家用 DNS 后断网"这些词不是给我看的,是给模型做匹配用的。写得含糊,技能就等于没装。
它补的不是能力,是经验
Anthropic 在那篇工程博客里用了一个我很喜欢的类比:给 Agent 写技能,就像给新来的同事写一份入职手册。手册不会让新人变聪明,但能让他知道打印机在哪、报销单找谁签、周五下午几点停止发版。
另一个类比更扎心。报税这件事,你想要一个数学天才从第一性原理推着算,还是一个报过几千份表的老会计?
多数人选择老会计。不是因为他更聪明,是因为他攒下了那些没法从公式里推出来的经验:哪一栏容易填反、哪种票据会被退回、哪个额度今年改了。
现在的模型就是那个数学天才。它推理能力很强,遇到没见过的问题也能现场想出办法,但它没有攒下来的经验,而且不会自动从重复劳动里学会什么。
你今天教它一遍"我们公司的周报要按项目分块、每块写三行、结尾带风险项",明天开新会话,它忘得干干净净,你还得再教一遍。
把这段要求写进系统提示词行不行?短期行,长期会撞上两道墙。一道是系统提示词常驻,你写二十条规矩,每一条都在消耗每一次对话的上下文预算。另一道是一个人的规矩好写,一个团队的规矩很快就写不下了,而且没人知道哪条还有效。
技能换了个思路:不常驻,按需取用,取用哪一份由任务内容决定。
为了把几样东西的边界划清楚,我列了张表。这张表建议存下来,以后看到有人把 Skill 和插件混着说,对着看一眼就明白了:
| 形态 | 本质是什么 | 什么时候进入上下文 | 能带脚本吗 | 能连外部系统吗 | 谁来维护 |
|---|---|---|---|---|---|
| 一次性提示词 | 对话里的一段话 | 你说的时候 | 不能 | 不能 | 说过就没了 |
| 系统提示词 / 自定义指令 | 常驻的行为约定 | 每一次对话 | 不能 | 不能 | 你自己,改一次全体生效 |
| Skill | 一个带说明书的文件夹 | 任务匹配上时按需读取 | 能,且脚本不进上下文 | 不能直接连,除非脚本自己去连 | 谁懂这套流程谁写 |
| 插件 / 扩展 | 装进宿主程序的功能模块 | 装好就生效 | 本身就是代码 | 能 | 开发者,用户只能等更新 |
| MCP | 一个跑着的服务,按协议暴露工具 | 会话开始就加载工具清单 | 服务端的事 | 能,这是它的全部意义 | 要部署、要凭证、要盯着 |
三级加载:为什么装一百个技能也不会撑爆
这是整个设计里最漂亮的一块,也是最容易被讲糊涂的一块。官方的说法叫渐进式披露,翻成人话就是:先给目录,再给章节,最后才翻附录。
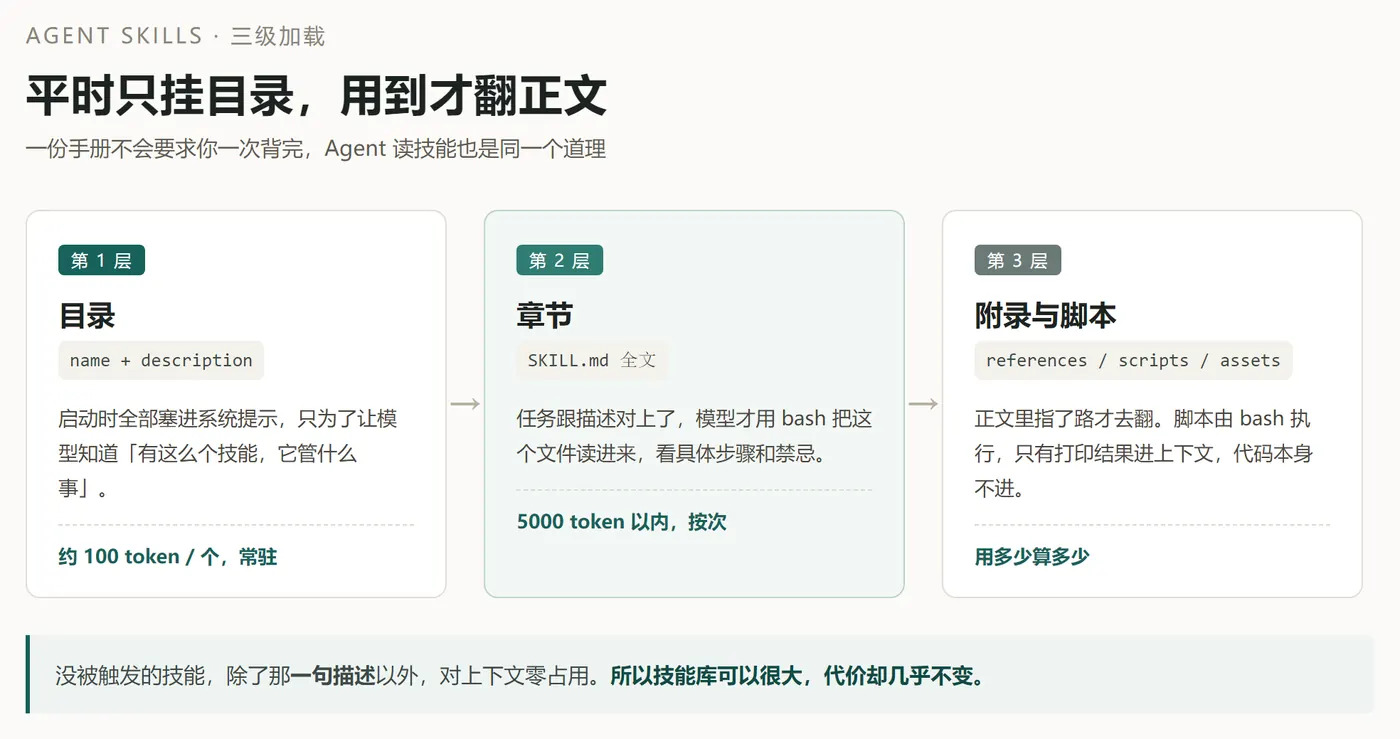
Agent 启动的时候,只把每个技能的名字和那句 description 塞进系统提示,官方给的量级是每个技能一百个 token 上下。这点开销小到可以忽略,所以你可以同时挂几十上百个技能而几乎不付出代价。
等你提了一个任务,模型扫一遍这些描述,判断哪个对得上,这时候才用 bash 去把对应的 SKILL.md 整个读进来,量级在五千 token 以内。
如果正文里写着"填表细节看 references/forms.md",模型会在真的要填表的时候再去读那一份,而那一份可能有两三千 token。三层下来的效果,跟"把十个技能的全文都塞进系统提示"完全不是一个东西,算笔账就清楚了:
方案 A:全量塞进系统提示
  100 个技能 × 5000 token = 500,000 token
  → 装不下。多数模型的窗口都到不了这个数

方案 B:渐进式披露
  常驻:100 × 100 token = 10,000 token   (占一个中等窗口的 5%)
  触发 1 个:+5000 token
  需要细节:再 +3000 token
→ 单次任务的实际开销一万八,其余 99 个技能一分钱不花关键在于这个数字不是省出来的,是设计出来的。同样一份知识,写成常驻提示就是固定资产,写成技能就是按次付费。
你可以往技能库里塞进几十万字的分层文档,只要模型不去读,它对上下文的占用就是零。官方文档里那句"技能能装的内容实际上是无限的",底气就在这里。
顺带说一个常被忽略的推论。这套机制能不能跑起来,前提是 Agent 手里有文件系统和 bash。技能不是被"注入"进模型的,是模型自己用 cat 或者 read 去读文件读进来的。
所以能跑技能的产品,本质上都是一个能执行代码的虚拟机加上一个会主动找资料的模型。反过来,那些只能传一段文本进去的聊天框,做不了这件事——它没有地方放那个文件夹。
技能里为什么要塞脚本
这一节讲的是我觉得最被低估的一点:技能不只能写"要求",还能附带"能跑的东西"。
举个最直白的例子。给一百个数字排序,让模型一个一个比大小,它也能排出来,但这个过程既慢又容易错,因为它是在用生成文字的方式模拟比较。而调一次 Python 的 sorted(),毫秒级,永远正确。
有些事就不该让语言模型硬算,这是常识。但落到 Agent 的工作流里,很多人还是习惯"让它想想办法",而不是"给它一个工具"。
Anthropic 讲过一个很真实的场景。他们发现 Claude 每次做 PPT 都要重新写一遍同样的样式脚本——改背景色、改配色、改版式,每次都是那几十行。与其每次重新生成,不如让 Claude 把这个脚本存下来,变成自己的工具。
于是技能目录里多了一个 apply_template.py,而 SKILL.md 里关于样式的部分简化成一句话:用 ./apply_template.py 就地更新这个 pptx。
这么做的收益有两层。第一层是省,脚本本身完全不需要进上下文,模型只要知道有这个东西、怎么调用、参数是什么,然后跑一下,把打印出来的结果读回来。进来的只有几行输出,而不是几百行代码。
第二层是稳。同一份脚本每次跑出来的结果一模一样,而让模型现场生成代码,今天对明天错是常态。凡是要求可重复、可审计的操作,都该做成脚本而不是写成叮嘱。
回到我那个博客发文的技能。里面有个脚本专门算文风指标:段落数、平均段长、平均句长、句长标准差、加粗密度、斜体数量,还有几个虚词的出现频率。
这些数字我自己数不清,但脚本一秒出结果。模型拿着这份报告去改稿,比让它"感觉一下像不像 AI 写的"靠谱一百倍。这就是脚本和文字说明的分工:文字负责判断,脚本负责计量。
Skill 和 MCP,一个管怎么做,一个管连得上
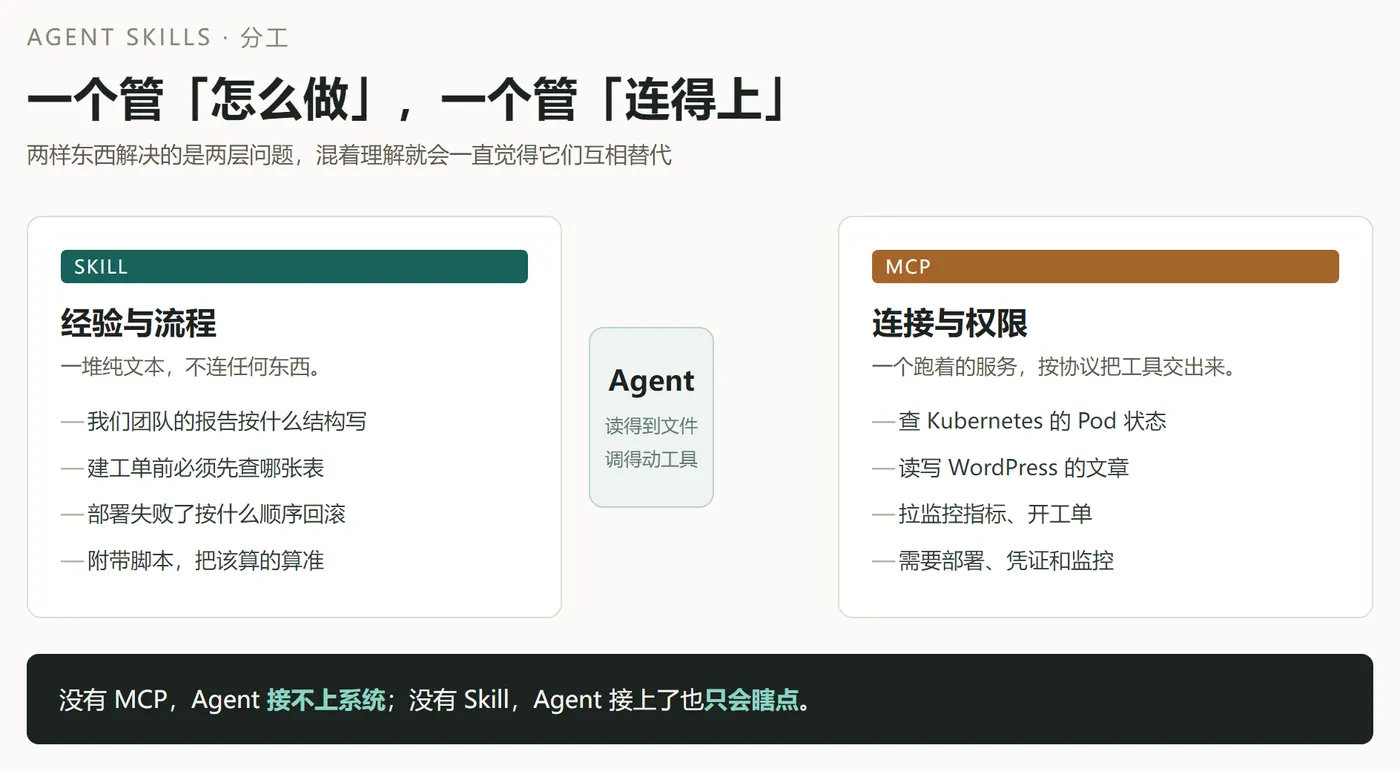
这是被问得最多的问题,也是最多人答错的问题。社区里有个流行的概括:技能教 Agent 怎么做,MCP 给 Agent 一个能碰到东西的手。我觉得这个说法不够准确,得再往里挖一层。
MCP(Model Context Protocol)是一套协议,服务端把一组工具暴露出来,Agent 通过协议调用它们。MCP 在真实插件里长什么样,我在这篇里拆过一个。它的价值在于"连接"——你的数据库、你的工单系统、你的云平台,模型本来碰不到,有了 MCP 服务就能查能改。
它的代价也在这儿。要部署、要凭证、要权限、要监控,而且工具清单在会话开始就占上下文,装十个 MCP 服务,光是工具定义就能吃掉一大块窗口。
技能走的是另一条路。它不连任何东西,只是把"遇到这种情况该怎么做"写成文件放在那儿。
Red Hat 的技术博客里有个运维场景的例子,说得很到位。MCP 把 Agent 接到 Kubernetes 集群和监控系统上,让它能查 Pod 状态、拉指标、开工单;技能则告诉它你们团队的故障响应手册——怎么分级、什么阈值要升级、事后报告按什么格式写、通知发到哪个群。
没有 MCP,Agent 接不上系统;没有技能,Agent 接上了也只会瞎点。
我自己的博客流程正好是个现成的例子,而且是别人写不出来的例子。MCP 那边提供的是工具:建文章、改文章、传图片、写 SEO 字段、生成预览链接。
但有几条规矩,工具本身永远不可能知道。文章作者必须署名 NingZou 不能是 admin,而创建接口里根本没有作者这个参数,所以每次建完草稿都得走服务器补一刀;SEO 标题默认跟文章标题一致,不要自作聪明另写一版;如果我在后台手改过稿子,发布时只准改状态,绝对不准把本地稿推上去覆盖。
这三条规矩全写在那个技能的 SKILL.md 里,一条比一条具体。它们不属于任何工具,也没法做成工具,它们是流程。工具解决"能不能",技能解决"该不该、按什么顺序、出了事怎么办"。
真要决策的时候,问自己两个问题就够了:
- 一个聪明人,给他一个终端、一个文本编辑器、正确的说明,能不能把这个活干完?能,那你需要的是技能。
- 这个活是不是必须实时读写一个外部系统、需要认证、数据每秒都在变?是,那你需要 MCP。
反过来说,很多人以为自己需要写一个 MCP 服务,其实只是需要一份把话说清楚的说明书。为一个二十行 Markdown 就能解决的问题去搭服务、配凭证、写监控,是典型的杀鸡用牛刀,而且顺手给自己找了个要长期养的牛。
三种用法:装、改、写
讲完原理,说操作。按投入从低到高排,正好对应三类人。
第一种是装。在 WorkBuddy 里,路径是左侧边栏的「专家·技能·连接器」,进去选技能页签,上半部分是已经装在本地的,下半部分是技能市场,看中哪个点加号就装上了。
也支持在对话里直接说需求,比如"帮我找一个能把网页转成 PDF 的技能",它会去市场里搜出来给你确认。装完不代表会被用上,这一点新手最容易误会——它是靠 description 匹配的,你提的任务跟描述对不上,装了也白装。
装的时候会过一道安全检测,非高风险的直接放行,高风险的必须你手动确认。那道提示不是走过场,后面讲风险的时候你会知道为什么。
另外"关闭"和"卸载"是两件事。关闭只是暂时停用、文件还在本机,卸载才是真的删掉,临时不用选关闭就行。
第二种是改。你装了一个技能,用得挺顺,但里面有三条规矩跟你们团队不一样。那就把 SKILL.md 打开,改那三条,别重写一份。
技能是纯文本,改它不需要任何工具,记事本足够。这也是它跟插件最大的体验差别:插件你只能等作者更新,技能你可以当场改。
第三种是写。把你自己反复交代的那件事写下来。有个取巧的路子,我推荐新手先走这条。
先别急着编文件,正常做一次这个任务,一边做一边让 AI 把步骤记下来,做完让它把步骤整理成一份 SKILL.md,你再删掉多余的、补上它不知道的。从零写一份技能很难,从一次真实的任务里榨出一份技能很容易。
写的时候记住三件事:description 要同时写清"做什么"和"什么时候用";正文按操作顺序排,别按知识体系排;把踩过的坑单独立一节,那是最值钱的部分。
想再进一步,可以去 github.com/anthropics/skills 看官方那份规范和一众示例技能。规范本身短得出奇,一份 SKILL.md 的格式要求几屏就能看完,剩下的全是取舍——什么该写进正文、什么该拆成附件、什么该做成脚本。这些没有标准答案,只有"跑几次之后就知道了"。
提升到底有多大,我说点实话
这一年关于技能的说法有点过热,动不动就是"装上之后效率翻十倍"。我把站得住的收益和站不住的期待分开说。
实打实的提升有三个来源,最直接的一条是省掉重复交代。同一件事你只要说清一次,之后每次只要说"按老规矩来",省下的是每次开头那几百字的铺垫。这个收益随任务重复次数线性增长,做一次的任务几乎为零,天天做的任务非常可观。
比这更值钱的是把隐性经验变成显性资产。老师傅脑子里的判断标准,写在技能里就变成了可以传阅、可以评审、可以版本管理的东西,团队换人不至于把手艺一起带走。
还有一条不太显眼,是脚本带来的确定性。该用代码算的地方不再让模型硬猜,错的概率直接掉一个数量级——这个影响在生产环境里最实在。
站不住的期待也得摆出来,我数出四条。
- 它不会让模型变聪明。只是让模型少犯"不知道你们规矩"这类错,遇到真要推理的难题,有没有技能差别不大。
- 写不好就不触发。描述含糊的技能等于没装,这是最高频的失败原因,而且没有任何报错提示你。
- 装多了会互相干扰。模型可能选错,或者在两个相似的描述之间反复横跳,所以工作台文档里建议只启用当前任务需要的那些。
- 它替代不了判断。保证的是流程一致,不是结果正确——模型分辨不出文件里的话是善意还是恶意,它编细节的时候也不知道自己在编——一份把错误流程写得很规范的技能,只会让错误发生得更稳定。
所以我给它的定位是:技能是杠杆,不是发动机。杠杆能把你的方法放大,但前提是你得有方法。这也解释了为什么同一个技能在不同人手里效果差很远,差的是那个人的流程水平,不是技能本身。
风险:一份能执行代码的说明书
这一段可能比前面所有内容都重要。技能是纯文本,看着人畜无害,但它有一个要命的特性:它继承 Agent 的全部权限,而社区里发一份技能几乎零门槛。
一个 SKILL.md 加一个注册了一周的 GitHub 账号就能发布,没有代码签名,没有安全审核,默认没有沙箱。
2026 年 2 月,安全公司 Snyk 做了一次迄今规模最大的技能生态审计,扫了 ClawHub 和 skills.sh 上 3,984 个公开技能。13.4% 的技能至少含有一个严重级别的安全问题;放宽到任意级别,受影响比例是 36.82%;人工复核确认的恶意载荷有 76 个,用途分别是偷凭证、装后门、往外传数据。
这个比例放在 npm 早期不算稀奇。但技能的特殊之处在于,它天生拿着你机器的 shell 权限、文件读写权限和环境变量。
更隐蔽的一类问题来自 frontmatter。安全公司 HiddenLayer 的研究指出,技能头部除了 name 和 description,还能写别的字段,而这些字段在技能市场的页面上根本不显示,只有你直接打开 SKILL.md 才看得到。
他们演示了两种玩法,两种都不用你点任何东西。一种是把真正的指令藏进一个界面上看不见的字段,模型照做,你毫不知情。另一种是在头部指定一个更贵的模型和更高的推理档位——同样一个"总结这个网页"的小任务,用便宜的模型是 0.0274 美元,被改成最贵的组合之后是 0.1451 美元,五倍多的成本,而任务的输入输出看起来完全正常。账单这事我有点执念,之前把本地日志翻出来做了个看板,就是为了看清 token 到底花在哪。
所以下面这几条不是形式主义,是真正能挡住大部分坑的。装之前打开 SKILL.md 从头读到尾,别只看市场页面上的介绍;扫一眼目录里有没有 scripts,有就点开看看它连了哪些地址、读了哪些文件;留意头部有没有 allowed-tools、model 这类你没要求的字段;只从能追到作者和提交记录的地方装;工作台弹出高风险提示的时候,别条件反射地点确认。
把它当成一个第三方依赖来对待,这是唯一正确的姿势。
回到那张海报
现在再想绿联那个比赛,为什么收的是 Skill 而不是应用,答案就清楚了。应用是给人在屏幕上点的,Skill 是给 Agent 直接读和执行的;应用绑死在一个平台上,Skill 是一堆纯文本,可以跟着 Git 走、可以在三十多个 Agent 之间搬来搬去;应用你只能看界面猜它干了什么,Skill 你打开就能逐行审。
对一个想让 AI 替用户操作自家硬件的厂商来说,收技能比收应用划算得多。
这件事的行业背景也提一句。2025 年 12 月 18 日,Anthropic 把 Agent Skills 发布成开放标准并放出了 SDK,之后 ChatGPT、Cursor、GitHub Copilot、VS Code 这些平台陆续跟进;2026 年 10 月 22 日,他们又把这个标准连同商标、GitHub 组织、agentskills.io 域名一起捐给了 Linux 基金会下面的 Agentic AI Foundation,MCP 此前也已经捐进去了。
一个格式能跨平台,才可能变成大家共同维护的东西,否则永远只是某家的功能。
至于怎么开始,我的建议是从最小的那个坑开始:挑一件你每周都要重复交代一遍的事,把交代的话写成一份 SKILL.md,description 里写清什么时候该用它,正文里先只写步骤和一条踩过的坑。别一上来就想着写一个包打天下的巨型技能,那玩意儿最后一定没人看,包括你自己。
写技能这事有个反直觉的地方:你写的时候以为是在教 AI,写完才发现被整理清楚的是自己的流程。那些"我大概是这么做的"的部分,落到纸面上就没法含糊了,哪一步先做、哪一步可以跳过、什么情况下要停下来问人,全得给个准话。
这大概是 Skill 这个格式带来的、最不像技术的那部分收益。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING