





2026 年 11 月,科技媒体 Chips and Cheese 在 AMD In-Depth 活动期间专访了 AMD 设计工程企业副总裁、服务器架构负责人马赫什·苏布拉莫尼,话题围绕新一代 EPYC Venice 的 SoC 设计:封装、I/O 裸片、计算芯粒(CCD)各自做了哪些取舍。
这场访谈价值不在参数表,而在解释「为什么」。Venice 是 AMD 首款采用 2.5D 封装的服务器 CPU,而推动这个选择的不是性能,是一笔能耗账:芯粒到 I/O 的数据传输量涨到上一代的两倍多,继续用常规封装,光搬数据就要吃掉 SoC 总功耗的 10% 到 15%。
封装一变,I/O 裸片怎么摆、CCD 放几颗核、缓存堆多大,这些原本独立的问题全被绑在一起。下面按访谈的顺序拆。
封装选择
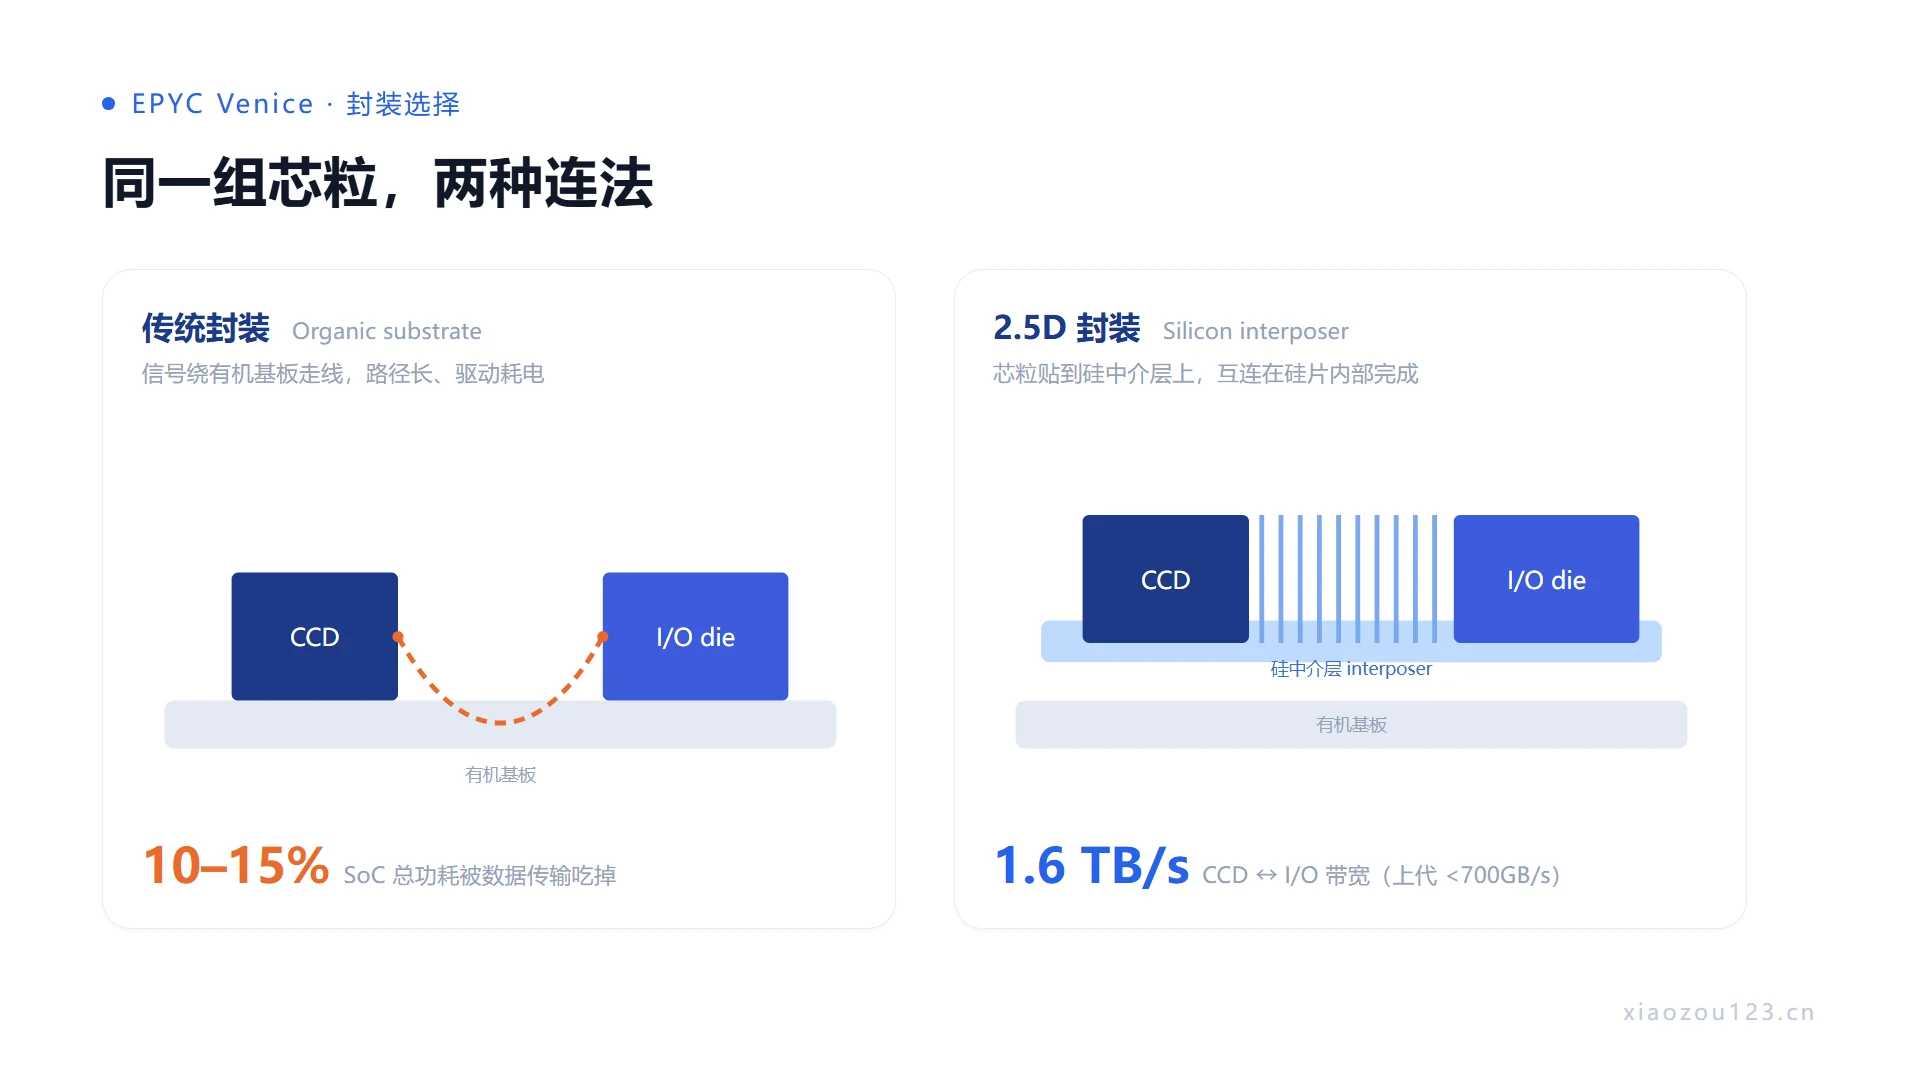
先解释一下 2.5D 封装是什么。传统封装里,所有裸片都贴在有机基板上,裸片之间的信号要绕基板走线,路径长、驱动电路费电。
2.5D 的做法是在裸片和基板之间垫一层硅中介层(interposer),裸片先贴到这块硅片上,互连在硅片内部完成,走线距离从厘米级压到毫米级以内。2.5D 的「2.5」就是指它介于平面封装和真正的 3D 堆叠之间。
苏布拉莫尼给了一组对照。上一代产品中,CPU 芯粒与 I/O 裸片之间的数据传输量略低于 700GB/s,传统封装加上既有的 GMI 互连还够用。
GMI 是 AMD 芯粒之间的互连总线,CCD 和 I/O 裸片之间的数据往来全靠它。
到了 Venice,这个数字涨到约 1.6TB/s,而且每个 CCD 往 I/O 裸片送数据时都还留着冗余带宽。如果继续用常规封装,仅数据传输这一项的能耗就可能占到 SoC 总功耗预算的 10% 至 15%——这是 2.5D 从「可选」变成「必选」的直接原因:它同时满足带宽和能效两个目标。
代价是布局自由度。2.5D 封装要求计算芯粒和 I/O 裸片通过极短的裸片间连接互连,接口宽度必须匹配,互连距离只有几毫米,两个裸片的边缘得紧挨着放。留给布线、供电和测试点的空间因此被压得很窄,裸片边缘那圈面积的用法变得斤斤计较。
正是这些物理约束,成了 AMD 把 I/O 拆成两颗裸片的原因之一。芯片面积不够用的时候,与其把一颗 I/O 做得更大,不如分成两颗摆在计算芯粒两侧,互连路径反而更短。而 2.5D 的互连本身就低功耗、高带宽、低延迟,多做一次拆分几乎不用付出额外代价——换在常规封装下,这个拆法会直接撞上能耗墙。
I/O 裸片拆分
拆是拆了,但 AMD 在 SP7 上没有开发两款不同的 I/O 裸片,而是复用同一套设计,把其中一颗旋转 180 度,做成镜像布局。
这么做是为了控制设计复杂度:一套图纸、一套验证、一套流片,成本比两款独立裸片低得多。代价跟着就来了——根信任、部分启动 I/O 这类只需要一份的 IP,在镜像的两颗裸片上各要配一遍,多花一份面积。这些模块不大,但省不掉。
更大的麻烦在互连拓扑。两颗 I/O 裸片各自是独立的域,可 NPS1 配置下,整颗 Venice SoC 必须当作一个统一域对外呈现。NPS1 指的是每个插座只划分一个 NUMA 域,操作系统看到一整块连续内存,不用自己处理跨节点调度。
要让镜像出来的两半在服务质量、带宽和延迟上都不吃亏,相当于把两个对称的子系统拼成一个看不出接缝的整体。
苏布拉莫尼提到,随着 SoC 核心数继续往上走,平铺式架构的优势会越来越明显,这类互连问题也得一点点啃下来。这句话听起来像展望,其实是在承认:现在的镜像方案是权衡的结果,不是终点。
SP7 与 SP8 的平台分工
面向企业级市场的 SP8 平台同样用双 I/O 裸片,但用了另一套 I/O 裸片方案,没有和 SP7 共用。苏布拉莫尼的解释很直接:两个平台要的东西不一样。
SP7 侧重计算能力与内存带宽,SP8 的计算需求更低,但要更多 I/O 通道。如果做一颗「超集」I/O 裸片同时覆盖两边,等于让 SP7 用户为用不上的 I/O 买单、让 SP8 用户为用不上的内存控制器买单,双方成本一起涨。分开设计,各自刚好。
| 项目 | SP7 | SP8 |
|---|---|---|
| I/O 裸片 | 双裸片,镜像复用同一设计 | 双裸片,独立设计 |
| 内存通道 | 16 条 | 8 条(SP7 的一半) |
| PCIe 通道 | 访谈未提及 | 每插槽 128 条 |
| 目标核心配置 | 访谈未提及 | 最高 96 核 Zen 6 或 128 核 Zen 6c |
| 设计侧重 | 算力与内存带宽 | I/O 通道数量 |
SP8 的内存通道数只有 SP7 的一半,每插槽却给满 128 条 PCIe,目标配置最高 96 核 Zen 6 或 128 核 Zen 6c。这个配比说明它服务的不是内存密集型负载,而是需要挂大量加速器、网卡和存储的设备——同样一颗芯片,插槽换了,面对的就是另一批客户。
CCD 设计取舍
Venice 的高密度 32 核 CCD 有个不寻常的地方:这颗裸片物理上集成了 33 颗核心和对应的 33 组 L3 缓存切片,但产品始终只启用 32 颗核心,不会有 33 核的型号上市。
多出来的那颗核是良率保险。CCD 面积越大,先进制程下随机缺陷落在它身上的概率越高,一颗坏点就可能废掉整片晶圆上的这颗裸片。多放一颗备份,任意一颗核心或其缓存切片出问题时屏蔽掉,剩下的 32 颗依然完整、网格拓扑不乱,这颗裸片照样按 32 核出货。
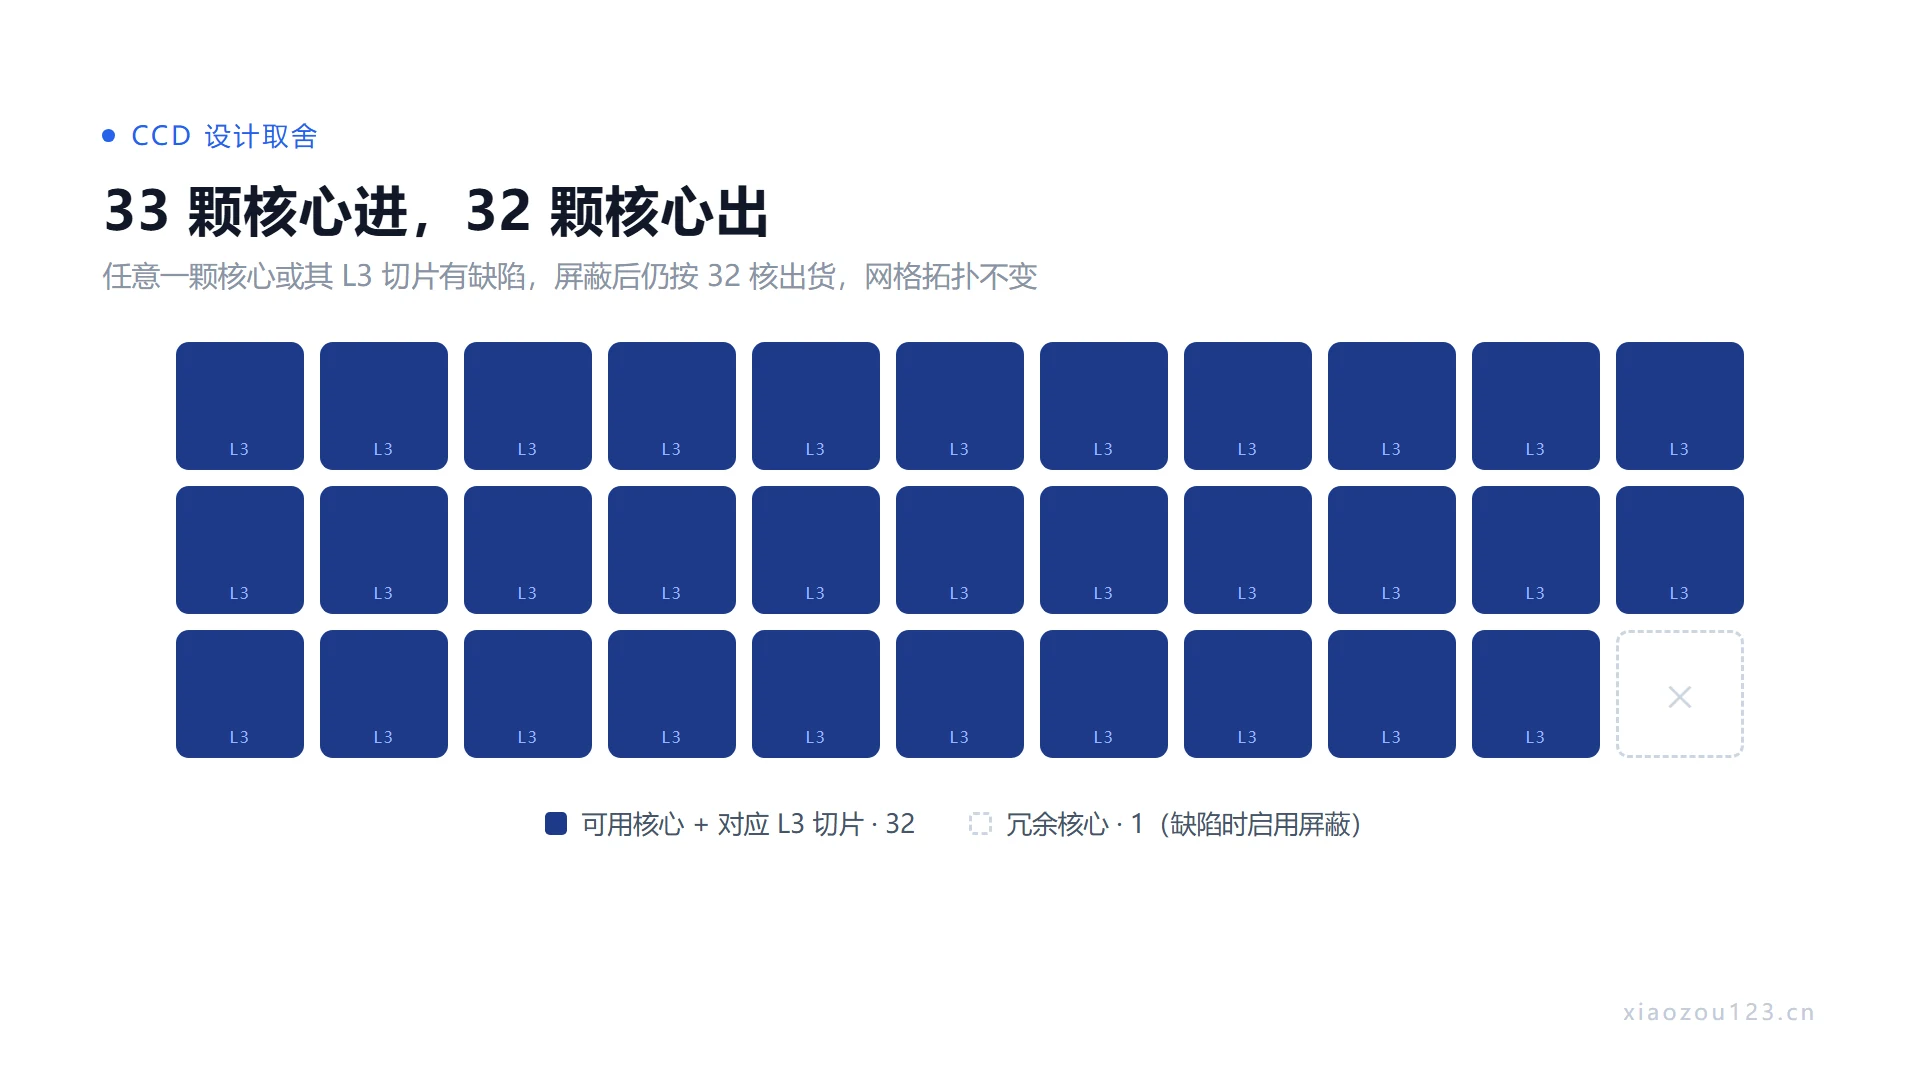
代价是每颗 CCD 少 3% 的可用核心,收益是大尺寸裸片在量产时的良率弹性。对便宜的小芯片不值得,对这种面积大、单价高的先进制程裸片,这笔账划得来。
两种 CCD 连到 I/O 裸片的端口数也不一样。SDP 是 CCD 通往 I/O 裸片的数据端口,32 核 CCD 配 4 个,大致按每 8 颗核心一个端口分配,够它跑满性能与 IPC 目标所需的带宽。
12 核 CCD 只配 3 个,但这个数字不是按核心数比例算出来的。12 核对应的平台是 16 通道、12800 MT/s 的 MRDIMM,3 个端口的用意是让多个 CCD 合起来刚好把整颗 SoC 的内存带宽吃干——端口多了浪费,少了喂不饱内存控制器。两个数字背后是两套完全不同的平衡点。
缓存性能权衡
32 核 CCD 的 L3 是 128MB,比 12 核 CCD 大得多,代价是查询延迟。苏布拉莫尼确认,缓存容量变大之后,命中判断本身要多花几个时钟周期——同样的地址送进去,大缓存要走的比对路径更长。在空闲状态下测 CPU 从 DRAM 读数据的延迟,32 核 CCD 就能量出这部分开销;从互连到内存那一段,两种 CCD 基本一致。
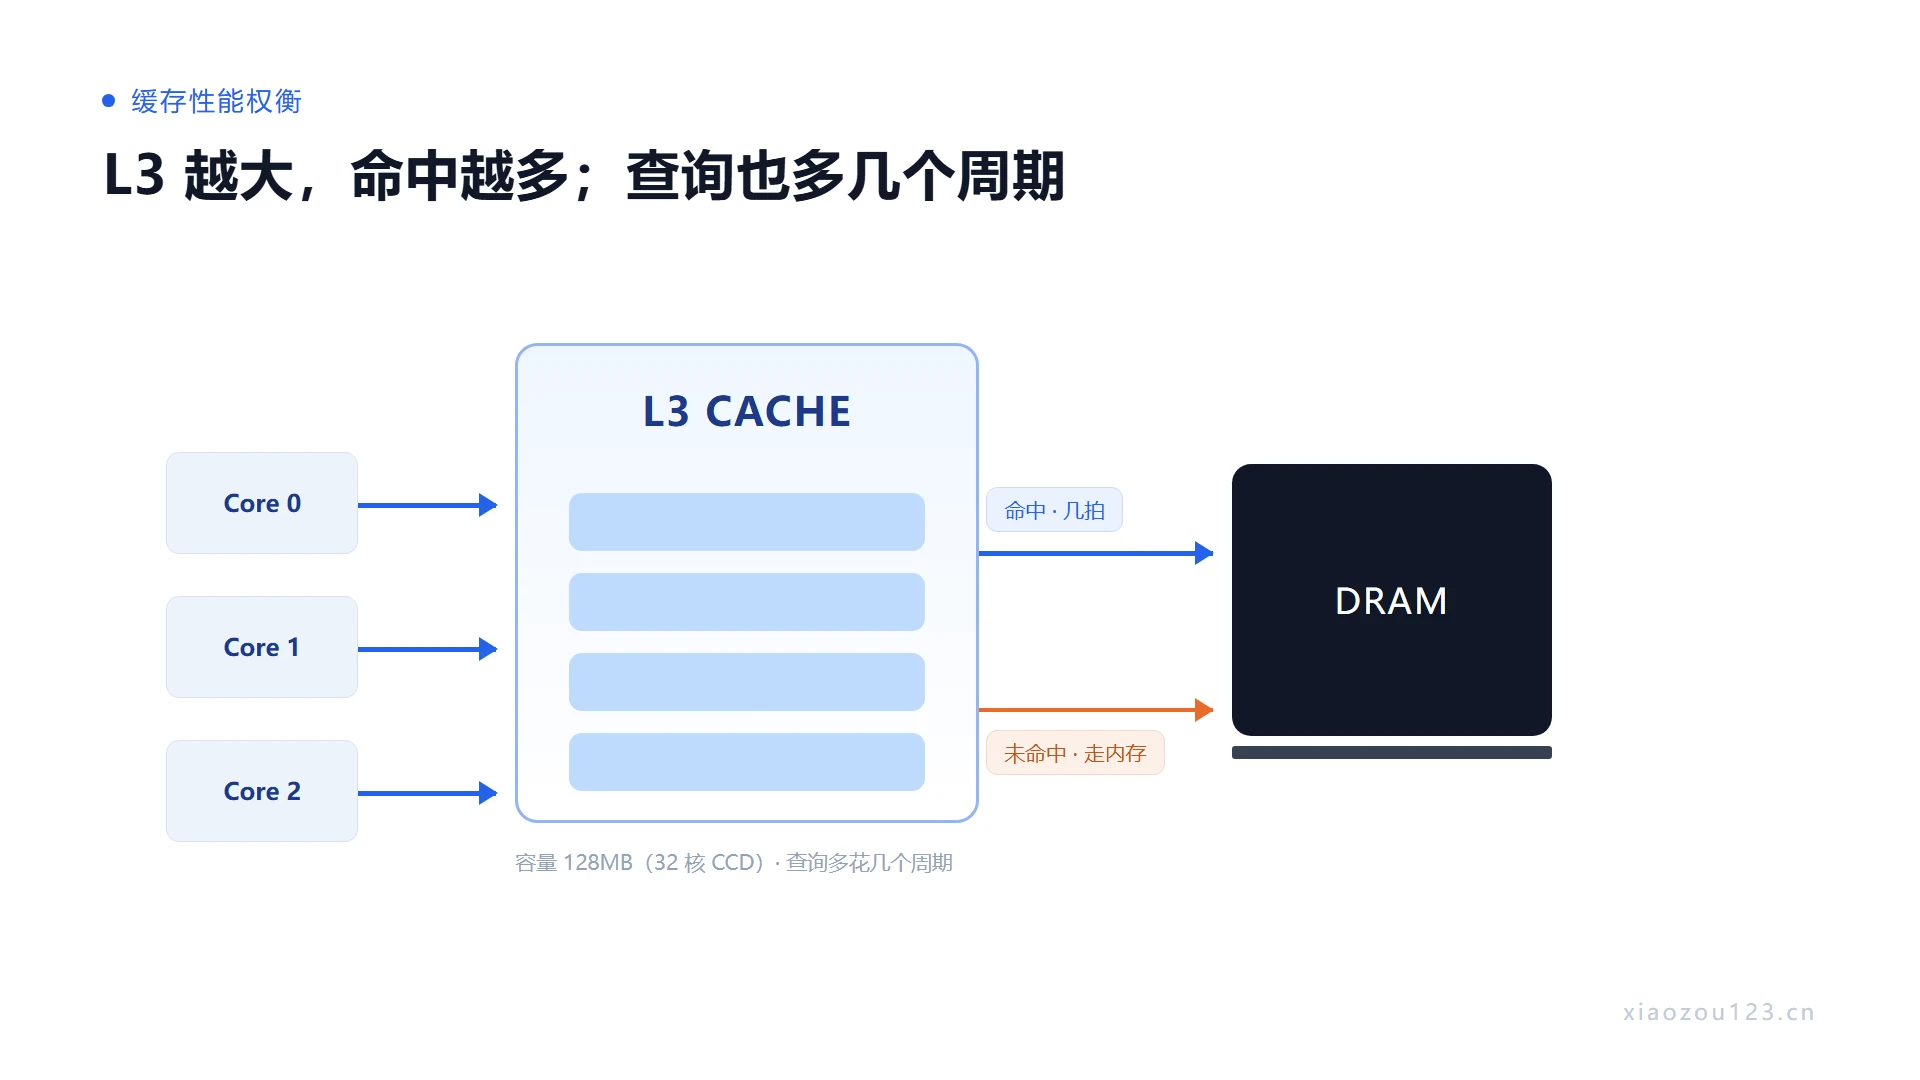
但他提醒别孤立看内存延迟这一个指标。真实负载里,缓存更大意味着更高的命中率,尤其当 CCD 内驻留的线程越多,请求越容易在片上被接住——一次 L3 命中比一次内存访问快一个数量级,这个收益通常盖得住多出来的几个周期。所以延迟表上难看的那几个 tick,在跑分和实际业务里未必兑现成劣势。
那能不能在 32 核 CCD 上再堆一层 3D V-Cache?3D V-Cache 是在 CCD 上方垂直堆叠缓存,等于不改核心、只加容量。苏布拉莫尼的回答是这不在当前重点里。
AMD 已经在 96 核产品上用搭载 X3D 技术的 12 核 CCD,单颗 CCD 的总 L3 约 144MB。至于面向均衡吞吐、单核功耗预算紧张的 256 核产品,AMD 更愿意把预算花在带宽和频率上,而不是成本更高的大规模堆叠缓存。换句话说,堆缓存这条路留给「核心不多、但每颗都要吃缓存」的产品,256 核那种靠规模取胜的型号不划算。
设计逻辑
回头看这场访谈,三个决策各自对应一笔账,没有一个白拿:
- 换 2.5D 封装:用布局自由度,换掉 10% 到 15% 的功耗开销。
- 把 I/O 拆成两颗镜像裸片:用重复的 IP 面积,换设计成本和边缘布线的余量。
- 在 32 核 CCD 里多放一颗核:用 3% 的核心面积,换大裸片的良率。
三笔账没有一个是纯技术的。
这也是高核心数服务器处理器现在的常态:性能早就不是单点突破的问题,封装、互连、良率、成本四件事互相拽着,动一处就得重新配平。
Venice 这代的答案是把钱花在「少走远路」上:缩短互连、拉高带宽、用冗余换良率,而不是继续往核心数和缓存容量上堆数字。
如果你觉得这篇文章不错,有用的话可以点击下面的“赞赏”支持作者,你的支持是我更新的动力(饿饿吃饭)。
Comments NOTHING